Skills statt Prompts: Wie meine Coding-Agenten einen Bug vom Report bis zum Pull Request bringen
Rund 20 Agent-Skills, ein zentraler Ordner, drei Coding-Agenten: die Workflows, mit denen meine Agenten Bugs mit echten Daten reproduzieren, die Ursache belegen, den Fix testen und den PR öffnen – und die Leitplanken, die sie ehrlich halten.
Balázs Csorba··7 Min. Lesezeit
- AI agents
- Claude Code
- MCP
- Playwright
- Developer workflow
Eine Zeit lang habe ich meinen Coding-Agenten immer wieder dasselbe erklärt. Reproduziere den Bug zuerst. Leg das Ticket an, bevor du den Code anfasst. Überspring den fehlschlagenden Test nicht. Sag mir nicht, die CI sei grün, wenn du nicht nachgesehen hast. Jede neue Sitzung fing bei null an.
Also habe ich aufgehört, Prompts zu schreiben, und angefangen, Skills zu schreiben. Inzwischen sind es rund zwanzig. Sie machen aus „behebe diesen Bug“ einen wiederholbaren Ablauf, der mit einem reviewten Pull Request endet. Dieser Artikel zeigt, wie sie organisiert sind, wie die Haupt-Pipeline aussieht und welche Leitplanken die Ergebnisse vertrauenswürdig machen.
Was ein Skill ist und wo meine liegen
Ein Skill ist eine Markdown-Datei mit einem Namen, einer kurzen Beschreibung, wann er gilt, den Schritten und den Regeln, die nicht gebrochen werden dürfen. Der Agent liest die Beschreibungen und lädt einen Skill, wenn die Aufgabe passt – so wie ein Entwickler zur Checkliste greift.
Meine liegen in einem zentralen Ordner, ~/.agents/skills. Von dort werden sie in Claude Code und opencode synchronisiert, und auch Codex greift darauf zu. Eine Kopie zum Bearbeiten, drei Agenten, die sich gleich verhalten.
Das Wertvollste sind nicht die Schritte, sondern die Lektionen. Geht etwas schief, landet die Lösung im Skill, damit es nie wieder schiefgeht. Zwei Beispiele:
- Die Jira-API lehnt Wiki-Markup in manchen Feldern mit einem nackten HTTP 400 ab, ohne Erklärung. Der Ticket-Skill sagt jetzt: Inhalt als ADF (Atlassians Dokumentformat) schicken und das Ticket danach per Suche prüfen.
- Mehrzeilige Commit-Nachrichten sind in zsh kaputtgegangen, und PRs gegen den Hauptbranch haben keine CI ausgelöst. Beides steht im Skill, also umgeht der Agent es, statt es neu zu entdecken.
Die Haupt-Pipeline: vom Bug-Report zum Pull Request
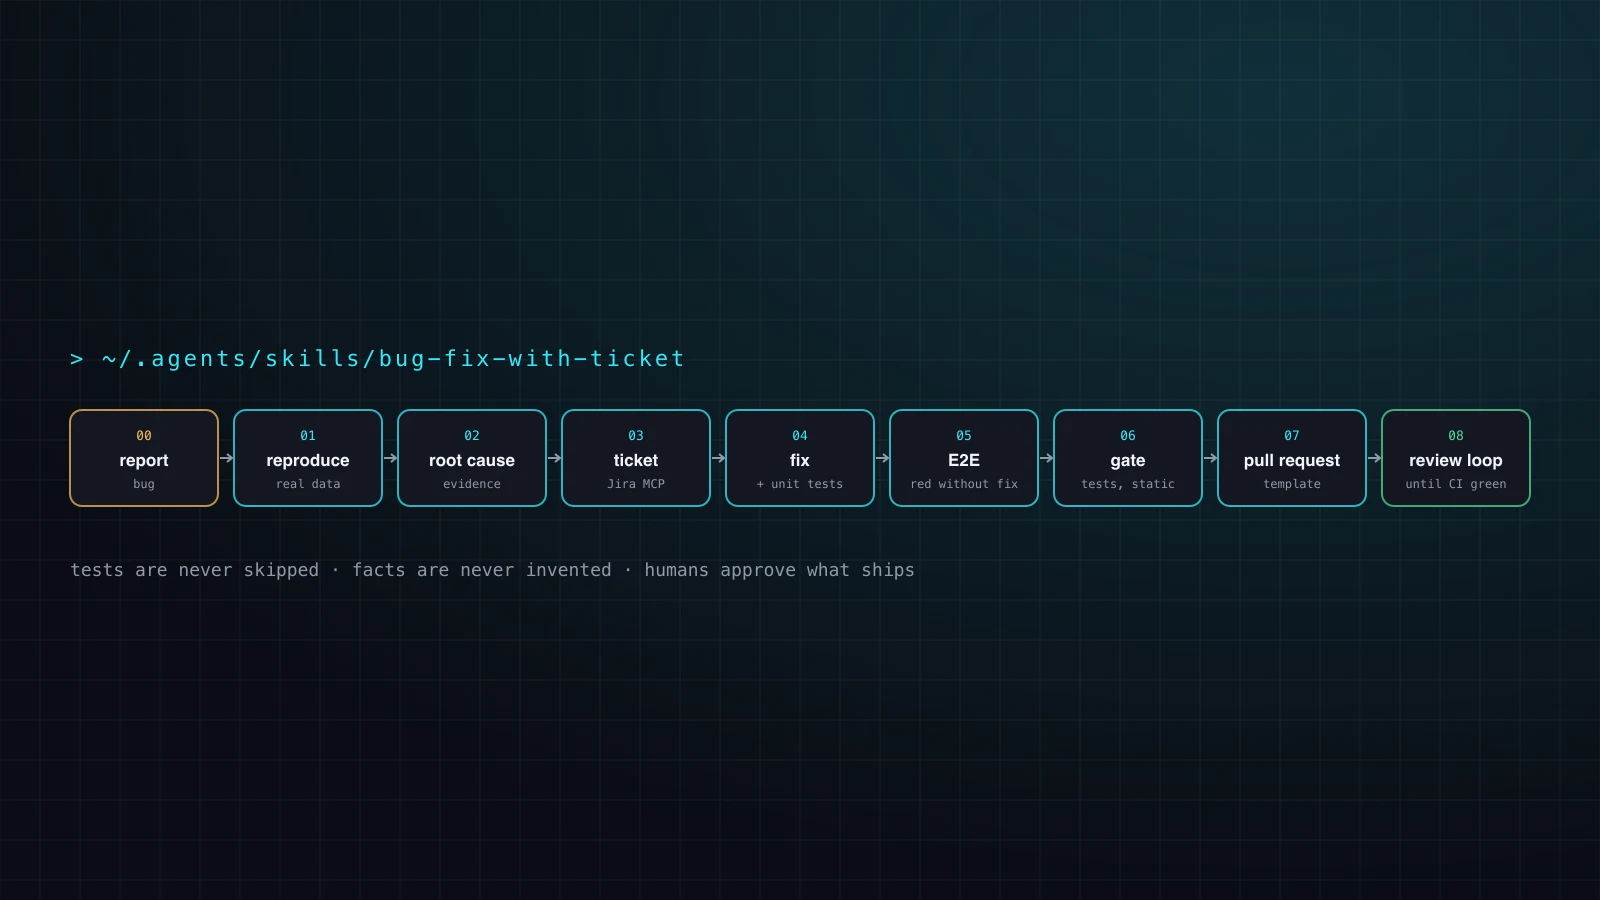
Der wichtigste Skill bringt einen Produktionsfehler in einem PHP-B2B-Shop vom ersten Report bis zum offenen Pull Request. Er läuft in Phasen, und der Agent aktualisiert nach jeder eine To-do-Liste, damit ich sehe, wo er steht.
- Mit echten Daten reproduzieren. Im Tracker nach Duplikaten suchen, die Hinweise des Projekts für Agenten lesen und den Bug lokal gegen eine synchronisierte Datenkopie reproduzieren. Als betroffener Benutzer einloggen und die Seite in einem echten Browser untersuchen. Die Phase endet mit einer Beweistabelle und der Ursache in einem Satz – bevor Code geändert wird.
- Zuerst das Ticket. Jira-Ticket im Format des Teams anlegen und durch den Workflow bewegen, damit die Arbeit von Anfang an sichtbar ist.
- Branch. Ein Hotfix-Branch pro Ticket, nach dem Ticket benannt.
- Kleinstmöglicher Fix an der Ursache, mit Unit-Tests für den Normalfall, den Fehler-Fallback und die Randfälle (fehlendes Produkt, leere Abfrage).
- Ein End-to-End-Regressionstest, der ohne den Fix scheitern muss. Der Playwright-Test läuft mit dem Fix grün. Dann nimmt der Agent nur den Fix zurück, und der Test muss scheitern und die falschen Daten zeigen. Dann kommt der Fix zurück und der Test ist wieder grün. Ein Test, der so oder so besteht, beweist nichts.
- Die Prüfung: vor jedem Commit laufen die komplette Unit-Test-Suite und die statische Analyse (PHPUnit und PHPStan). Dann Commit, Push und PR öffnen.
- Bericht: PR-Link und Beweise kommen als Kommentar ins Ticket, danach eine Zusammenfassung für mich.
Die Ursache mit Daten belegen, bevor der Fix geschrieben wird. Den Test mit einem Revert prüfen, bevor man ihm traut.
Kleine Skills, die sich kombinieren
Die Pipeline macht nicht alles selbst. Sie ruft kleinere Skills auf, die auch allein funktionieren:
- Ticket anlegen: zweisprachiges Format des Teams, Akzeptanzkriterien im richtigen Feld, danach geprüft.
- Browser-Bausteine: im Admin-Backend einloggen, als Shop-Benutzer agieren, ein Produkt in den Warenkorb legen, den Checkout durchlaufen. Jeder hält die Fallen fest, die beim Schreiben aufgefallen sind: welches von zwei gleichen Formularen das richtige ist und welche Klassenänderung „der Button ist bereit“ bedeutet.
- Die Prüfung vor dem Commit: Testdatenbanken aufsetzen, die komplette Suite und die statische Analyse laufen lassen und exakte Zahlen melden.
- Pull Request anlegen: eine feste Vorlage (Ticket-Link, Beschreibung, Tests, Testanleitung, Deployment-Hinweise), nur mit
gitundgh. Ohne Ticket-Nummer kein PR.
Nach dem PR: die Review-Schleife
Ein zweiter Ablauf übernimmt, wenn Reviewer kommentiert haben:
- Alle Review-Kommentare des PR über die GitHub-API einsammeln.
- Beheben, dann jeden Thread prüfen und als behoben, teilweise, offen oder nicht zutreffend markieren.
- Tests und statische Analyse erneut laufen lassen und wiederholen.
- Nach drei Runden ohne Fortschritt aufhören und an einen Menschen übergeben, statt sich im Kreis zu drehen.
- Commit, Push und die CI-Checks beobachten, bis sie grün sind.
- Auf jeden Thread antworten und den Commit nennen, der ihn erledigt hat.
Bevor etwas committet oder gepostet wird, sucht der Agent nach E-Mail-Adressen und anderen personenbezogenen Daten.
Mehr als Bugfixes
- Technische Planung: aus einem GitHub-Issue einen Backend-Umsetzungsplan machen, bevor programmiert wird. Die Regel lautet, nie nur eine Lösung vorzuschlagen. Der Agent bietet zwei oder drei Varianten mit Vor- und Nachteilen an, der Entwickler entscheidet, und das Ergebnis ist eine Plandatei. Committet wird nichts.
- Performance-Profiling: einen Backend-Pfad über mehrere Durchläufe messen (p50/p95/p99 Laufzeit, CPU, Spitzenspeicher, Anzahl und Dauer der SQL-Abfragen). Dann eine Änderung anwenden, erneut messen, zurücknehmen. Immer nur eine Änderung, und Benchmark-Skripte werden nie committet. Am Ende steht eine Vorher-nachher-Tabelle.
- Code-Review: lokale Änderungen vor dem Push oder den PR eines anderen prüfen, anhand einer Checkliste für Korrektheit, Sicherheit, Konventionen, Performance, Tests und Doku.
Die Leitplanken, die überall wiederkehren
Über alle Skills hinweg tauchen dieselben Regeln auf. Sie sind wichtiger als jeder einzelne Schritt:
- Nie Fakten erfinden. Keine ausgedachten CI-Ergebnisse, Testläufe, Ticket-Status oder Deployments. Lief etwas nicht, steht im Bericht „nicht ausgeführt“ und warum. Ein existierender PR heißt nicht, dass etwas deployt ist.
- Tests werden nie übersprungen, abgeschwächt oder gelöscht. Bestehende Fehler werden mit Belegen von neuen getrennt. Ein blockierter oder unvollständiger Lauf ist kein grüner Lauf.
- Alles Öffentliche oder Unumkehrbare gibt ein Mensch frei. Das gilt auch außerhalb der Arbeit: Meine Browser-Skills für Kleinanzeigen füllen das Formular aus, halten dann an und fragen, bevor sie auf „Veröffentlichen“ drücken.
- Zugangsdaten kommen nur aus der Umgebung (zum Beispiel
gh auth). Credential-Dateien werden nie gelesen, Tokens nie ausgegeben.
Die Werkzeuge darunter
- Ein selbst geschriebener Jira-MCP-Server mit 20 Tools: Issues suchen, anlegen, ändern und weiterschalten, Kommentare, Anhänge, Epics sowie Testfälle und Testläufe.
- Playwright MCP, das einen echten Browser steuert, um Bugs zu reproduzieren und Abläufe durchzugehen.
- Einfache CLIs, vor allem
gitundgh, und die Testwerkzeuge des Projekts.
Wenn du anfangen willst
- Fang mit dem Ablauf an, den du am häufigsten erklärst. Das ist dein erster Skill.
- Schreib Leitplanken als Regeln, nicht als Hoffnungen. „Nie Tests überspringen“ gehört in die Datei, nicht in deinen Kopf.
- Lass den Agenten Dinge beweisen. Beweistabellen, exakte Testzahlen, ein Test, der ohne den Fix scheitert.
- Jede Überraschung wird eine Zeile in einem Skill. So wird der Ablauf besser statt nur länger.
- Halte eine zentrale Kopie und synchronisiere sie in jeden Agenten, den du nutzt.
Wenn du an etwas Ähnlichem arbeitest oder so etwas im Team aufsetzen willst: Mehr dazu unter KI-Entwicklung & MCP-Server. Und wer lieber sehen will, was ich zum Spaß baue: Es gibt auch einen Artikel über das Multiplayer-Segelspiel auf dieser Seite.