Tools/LLMOps & Evals
LiteLLM: das OpenAI-kompatible Gateway, das die meisten Plattformteams betreiben
LiteLLM ist das MIT-lizenzierte OpenAI-kompatible Gateway, das die meisten Plattformteams vor ihre Anbieter setzen. Was es gut macht, was es kostet und wo es kippt.
- Art
- LLM gateway
- Preis
- MIT · Enterprise from $20 per seat
Balázs Csorba··10 Min. Lesezeit
- LLM gateway
- OpenAI-compatible
- Cost control
- Routing
- MCP
Das Wichtigste in Kürze
- LiteLLM ist ein MIT-lizenziertes Python-SDK und ein Proxy, die mehr als 140 Anbieter hinter einem OpenAI-kompatiblen Endpunkt bündeln, mit virtuellen Schlüsseln, Budgets pro Team und Fallback über Anbietergrenzen hinweg.
- Der Nutzen ist organisatorisch, nicht technisch: Ein Modellwechsel ist eine Konfigurationsänderung, und jede Anfrage erzeugt eine Kostenzeile.
- Die Zusatzlast ist messbar und veröffentlicht: Die Dokumentation nennt 8 ms p95 bei 1.000 Anfragen pro Sekunde und weist ungewöhnlich deutlich darauf hin, dass Latenz nur zusammen mit der Zahl der gleichzeitig offenen Anfragen etwas bedeutet.
- Die kostenlose Stufe ist das komplette Gateway. SSO ab mehr als fünf Nutzern, Audit-Logs, Schlüsselrotation und die eingebauten Moderations-Callbacks liegen hinter einer Lizenz, die nach jährlicher Anfragekapazität kalkuliert wird und keinen öffentlichen Preis hat.
- Der Release-Takt liegt bei etwa einer Minor-Linie pro Woche bei einem Support-Fenster von vier Linien, das Upgrade ist also wiederkehrende Betriebsarbeit.
LiteLLM ist das quelloffene LLM-Gateway, das die meisten Plattformteams betreiben, ob sie es vorhatten oder nicht. Es sind zwei Produkte in einem Paket: ein Python-SDK, das die großen Anbieter auf das Anfrage- und Antwortformat von OpenAI vereinheitlicht, und ein Proxy-Server, der virtuelle Schlüssel, Budgets, Routing und Kostentracking davorstellt. Nach Dokumentation und publizierten Zahlen ist es das vollständigste Bauteil dieser Kategorie und schwer genug, um eine bewusste Entscheidung zu verdienen.
Es sitzt einen Sprung vor den Modellanbietern, nicht vor den Anwendungsdaten. Retrieval, Prompt-Verwaltung und Agent-Orchestrierung leben woanders; ein OpenAI-Client, ein LangGraph-Workflow und ein LiteLLM-Proxy koexistieren problemlos. Was das Gateway besitzt, ist die Anfrage selbst: wer sie stellen darf, welches Deployment sie bedient, was sie kostet und wer die Rechnung trägt.
Was LiteLLM ist
Der Name deckt zwei lauffähige Dinge ab, die sich eine Konfigurationsdatei und eine Modellpreistabelle teilen. Das SDK ist eine Bibliothek, die man importiert. Der Proxy ist ein Server, der das OpenAI-Wire-Format spricht, sodass jeder Client, der bereits gegen OpenAI läuft, durch eine andere Basis-URL und einen anderen Schlüssel umgeleitet werden kann.
- MIT-lizenziert, mit einer Enterprise-Stufe, die Identitäts- und Governance-Funktionen ergänzt und keine Kapazität verkauft.
- Mehr als 140 Provider-Integrationen und rund 1.900 Modelle, geführt in einer öffentlichen Preis- und Kontextfenster-Datei, die mit dem Paket ausgeliefert wird.
- OpenAI-kompatible Endpunkte für Chat Completions, die Anthropic-Messages-Route, die Responses-API, Embeddings, Batches und Realtime.
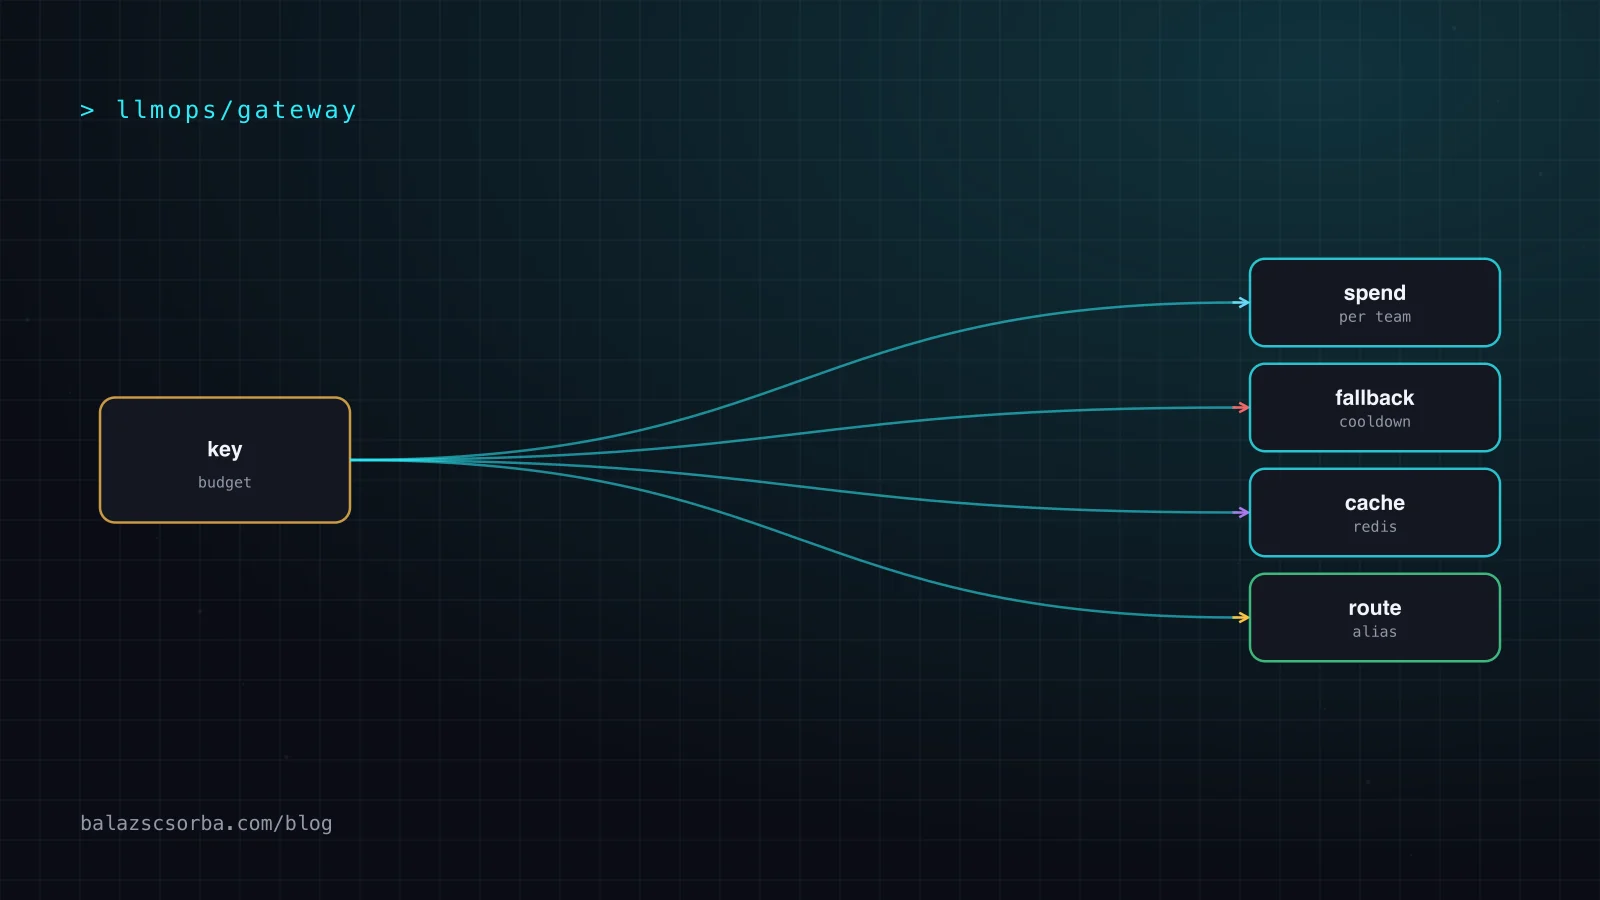
- Virtuelle Schlüssel mit Budgets, Ratelimits und Modellerlaubnissen je Schlüssel, Team und Nutzer, gesichert über Postgres.
- Ein Router mit mehreren Auswahlstrategien, Cooldowns je Deployment, gewichtetem Failover, Fallback über Modellgrenzen hinweg und Session-Affinität.
- Ein MCP-Gateway und ein A2A-Agent-Gateway auf demselben Endpunkt und derselben Schlüsselrichtlinie, damit Agenten geregelten Werkzeugzugriff bekommen statt eines zweiten.
- Callbacks nach Langfuse, MLflow, Helicone, LangSmith und OpenTelemetry sowie Prometheus-Metriken und eine Admin-Oberfläche.
Wie es funktioniert
Jede Anfrage durch den Proxy folgt derselben Reihenfolge: Schlüssel authentifizieren, Budget und Ratelimits prüfen, Tokens zählen, Deployment auswählen, Anbieter aufrufen, Antwort übersetzen, Kosten festhalten. Jeder Schritt kann für sich allein scheitern, und das Verhalten des Routers im Fehlerfall ist der Ort, an dem das meiste Betriebswissen entsteht.
Modellnamen sind die Abstraktion, auf der das Ganze beruht. Die Konfigurationsdatei listet Deployments unter einem gemeinsamen Alias, mehrere Deployments dürfen denselben Alias tragen, und eine Anfrage für diesen Alias beantwortet das Deployment, das die Routingstrategie wählt. Verschiebt man den Alias, wechseln alle Aufrufer den Anbieter ohne Codeänderung. In derselben Tabelle stehen die Fallbacks: Ein ausgefallenes Deployment wird entweder unter den Geschwistern neu gewählt oder an ein benanntes Fallback-Modell eskaliert.
Gemessene Zusatzlast
Die Benchmark-Seite nennt 8 ms p95 bei 1.000 Anfragen pro Sekunde auf vier Instanzen mit je 4 vCPU und 8 GB sowie für den Realtime-Endpunkt 59 ms Median, 67 ms p95 und 99 ms p99 bei 1.207 RPS. Dieselbe Seite veröffentlicht einen direkten Vergleich mit Portkey bei rund 1.170 RPS auf gleicher Hardware, dort meldet LiteLLM p95 150 ms und p99 240 ms gegenüber 230 ms und 500 ms.
Nützlicher ist der Vorbehalt, den die Dokumentation selbst liefert. Der Lastgenerator schläft zwischen Anfragen 0,5 bis 1 Sekunde, es sind also jederzeit rund 130 Anfragen offen; ein Closed-Loop-Client ohne Denkzeit hält 1.000 und meldet bei gleichem Durchsatz ungefähr achtmal so hohe Latenz. Eine veröffentlichte Latenzzahl ohne die zugehörige In-Flight-Tiefe bedeutet nichts, und das ist mehr Offenlegung als die meisten Anbieterbenchmarks mitbringen.
Erste Schritte
Das kleinste sinnvolle Deployment ist eine Konfigurationsdatei mit zwei Deployments unter einem Alias, einem Master-Schlüssel und einer Postgres-Verbindung. Caching, Guardrails, Callbacks und die Admin-Oberfläche kommen später.
# config.yaml: zwei Deployments unter einem Alias, plus ein verwalteter Fallback
model_list:
  - model_name: chat-fast
    litellm_params:
      model: openai/gpt-5.6-luna
      api_key: os.environ/OPENAI_API_KEY
      rpm: 900
  - model_name: chat-fast
    litellm_params:
      model: anthropic/claude-sonnet-5
      api_key: os.environ/ANTHROPIC_API_KEY
      rpm: 60
  - model_name: chat-cheap
    litellm_params:
      model: openai/gpt-5.6-luna
      api_key: os.environ/OPENAI_API_KEY

router_settings:
  routing_strategy: simple-shuffle
  num_retries: 2
  fallbacks:
    - chat-fast: [chat-cheap]

general_settings:
  master_key: os.environ/LITELLM_MASTER_KEY
  database_url: os.environ/DATABASE_URL

# docker run -p 4000:4000 -v $(pwd)/config.yaml:/app/config.yaml \
#   -e DATABASE_URL -e LITELLM_MASTER_KEY \
#   docker.litellm.ai/berriai/litellm:latest --config /app/config.yaml
Die Client-Änderung sind zwei Zeilen: das OpenAI-SDK auf den Proxy zeigen und einen virtuellen Schlüssel statt des Anbieterschlüssels übergeben. Jede Antwort trägt den Header x-litellm-overhead-duration-ms mit der selbst verursachten Zusatzlast, und genau darauf sollte ein Alarm feuern, wenn die Latenz steigt, ohne dass sich der Anbieter geändert hat.
Schlüssel, Budgets und Kosten
Das Schlüsselmodell ist der Grund, warum sich LiteLLM rechnet. Ein virtueller Schlüssel trägt eine Modellerlaubnis, ein Höchstbudget mit Zurücksetzintervall, TPM- und RPM-Limits, eine Parallelitätsgrenze und einen Besitzer. Schlüssel erben von ihrem Besitzer, was bequem ist und zugleich die schärfste Kante des Designs: Ein von einem Admin ohne Nutzer-ID erzeugter Schlüssel erbt gar nichts, und ein Schlüssel, dessen Besitzer Proxy-Admin ist, erreicht die Verwaltungsrouten, weil der Verwaltungszugriff der Rolle des Besitzers folgt und nicht den eigenen Berechtigungen des Schlüssels.
# einen Schlüssel für ein Team erzeugen: gedeckelt, ratenbegrenzt, zugeordnet
curl 'http://localhost:4000/key/generate' \
  -H "Authorization: Bearer $LITELLM_MASTER_KEY" \
  -H 'Content-Type: application/json' \
  -d '{
    "models": ["chat-fast"],
    "max_budget": 40,
    "budget_duration": "30d",
    "rpm_limit": 600,
    "tpm_limit": 400000,
    "metadata": {"team": "platform", "env": "prod"}
  }'

# was hat dieser Schlüssel ausgegeben, und gegen welches Limit
curl 'http://localhost:4000/key/info?key=sk-...' \
  -H "Authorization: Bearer $LITELLM_MASTER_KEY"
Die Kosten werden aus derselben öffentlichen Preistabelle berechnet, die das SDK mitliefert, bei jedem Completion-, Embedding- und Image-Aufruf geschrieben und je Schlüssel, Nutzer und Team abfragbar. Diese Zahlen sind also Schätzungen aus einer Tabelle, die der Abrechnung des Anbieters hinterherlaufen kann: nah genug für eine interne Kostenverrechnung, zu ungenau für den Abgleich einer Rechnung. Wenn eine Zahl vertraglich zählt, kommt sie aus der Anbieterrechnung.
Preis und Lizenzgrenzen
Das Gateway ist unter MIT dauerhaft kostenlos selbst zu hosten, ohne Sitzungs- und ohne Token-Gebühr. Die Preisseite führt zur Open-Source-Stufe mehr als 140 Provider-Integrationen, virtuelle Schlüssel, Nutzer und Teams, Kostentracking, Budgets und Ratelimits, LLM-Fallbacks, Request- und Response-Logging, Prometheus-Metriken und Guardrails. Die Beschaffung läuft direkt oder über den AWS Marketplace und Reseller.
Die Lizenz kauft Kontrolle, nicht Durchsatz. SSO ist bis zu fünf Nutzer inklusive und darüber hinaus lizenzpflichtig; SCIM, Audit-Logs, Schreibzugriff auf Secret Manager, IP-Allowlists, die Multi-Region-Steuerungsebene, virtuelle Schlüsselrotation und die eingebauten Moderations-Callbacks liegen alle dahinter, und die Dokumentation benennt sie einzeln, damit niemand die Grenze nach dem Rollout entdeckt. Der Enterprise-Preis wird nach jährlicher Anfragekapazität und Deployment-Form kalkuliert, nie pro Token, und es gibt keinen Listenpreis, also beginnt jeder echte Kostenvergleich mit einem Gespräch mit dem Vertrieb.
Wo es knirscht
Die Schwächen sind betrieblich, nicht funktional. Der Proxy braucht Postgres und ab mehr als einer Instanz Redis; das ist ein zustandsbehaftetes System mit Schema-Migrationen und Verbindungsarithmetik, und die Dokumentation hat eigene Seiten zur Dimensionierung genau weil dort Deployments scheitern. Das Python-SDK zieht einen großen Abhängigkeitsbaum in einen Dienst, der im Kern Anfragen formatiert. Und der Supply-Chain-Vorfall vom März 2026, bei dem mit LiteLLM präparierte Versionen über PyPI verbreitet wurden, erinnert daran, dass hier ein Paket mit sehr hohen Installationszahlen Produktionsschlüssel verarbeitet.
| LiteLLM | Portkey | Bifrost | |
|---|---|---|---|
| Deployment | Selbst gehostet, air-gap-fähig | Verwaltete Cloud und selbst gehostet | Selbst gehostet |
| Kostenbasis | OSS kostenlos, Lizenz nach Kapazität | Monatliches Abo | Kein öffentlicher Preis |
| Vom Anbieter genannte p99-Last | 0,66 ms | 2,29 ms | 4,54 ms |
| Passt am besten zu | Plattformteam mit Zugangskontrolle | Guardrails zuerst | Minimaler Hop-Overhead |
Diese Lastzahlen stammen aus dem Benchmark von LiteLLM selbst, gemessen mit allen Gateways auf demselben deterministischen Mock-Upstream und identischer Hardware, was den Vergleich fair und den Sieger vorhersehbar macht. Für alles, was kein LLM-Gateway ist, verdient die Kubernetes-native Variante einen Blick: Envoy AI Gateway stellt die OpenAI-Routing-Oberfläche bereit, ohne einen Python-Laufzeitprozess in den Anfragepfad zu bringen, und dieser strukturelle Unterschied wiegt schwerer als alle Zahlen oben.
Fazit
LiteLLM ist die richtige Voreinstellung für ein Plattformteam, das vielen Teams Zugang zu mehreren Anbietern geben muss und drei Fragen im Betrieb beantworten will: wer hat das ausgegeben, welches Deployment hat gearbeitet, und was passiert, wenn dieser Anbieter abbaut. Es beantwortet alle drei besser als die Alternativen und nimmt dabei nicht einmal die Anbieterschlüssel in Verwahrung.
- Nehmen, wenn mehr als ein Team über mehr als einen Anbieter Modelle aufruft. Budgets, Kostenverrechnung und Fallback über Anbietergrenzen hinweg rechtfertigen das zustandsbehaftete Deployment.
- Nehmen, wenn die Bündelung der Beschaffung das Ziel ist. Der Wechsel von einem Modell zum nächsten wird zur Konfigurationsänderung statt zur Sicherheitsprüfungs-Runde.
- Zuerst nur das SDK nehmen, wenn es einen einzigen Dienst gibt. Es vereinheitlicht Fehler und Antworten für einen Bruchteil der Betriebskosten und lässt die Tür zum Proxy später offen.
- Lass weg, wenn ein Team und ein Anbieter die ganze Geschichte sind. Anbieter-SDK und eine Kostenübersicht sind weniger Maschinerie für dasselbe Ergebnis.
- Lass weg, wenn auf dem heißen Pfad die letzte Millisekunde zählt. Das Gateway ist ein Python-Prozess im Anfragepfad, und die Rust-Neufassung ist noch als Beta gekennzeichnet.
Quellen
Häufige Fragen
Ist LiteLLM nur ein Wrapper um das OpenAI-SDK?
Nein. Das SDK vereinheitlicht Anfragen, Antworten und Fehlerklassen über die unterstützten Anbieter, der Proxy ergänzt virtuelle Schlüssel, Kostentracking, Budgets, Routing, Cooldowns, Fallbacks und Caching. Der übliche Weg ist, mit dem SDK in einem Service anzufangen und auf den Proxy umzusteigen, sobald mehr als ein Team Zugang braucht.
Wie viel Latenz fügt das Gateway hinzu?
Die Benchmark-Seite nennt 8 ms p95 bei 1.000 Anfragen pro Sekunde auf vier Instanzen mit je 4 vCPU und 8 GB. Diese Zahl enthält den Client: Die Dokumentation weist darauf hin, dass ein Closed-Loop-Client ohne Denkzeit rund 1.000 offene Anfragen hält statt etwa 130, was nach dem Little's Law bei gleichem Durchsatz ungefähr achtmal so hohe Latenz ausweist.
Setzt die kostenlose Version Budgets wirklich durch?
Ja. Virtuelle Schlüssel, Teams, Kostentracking, Budgets, Ratelimits und LLM-Fallbacks liegen alle in der Open-Source-Stufe. Lizenzpflichtig sind Identität und Governance: SSO ab mehr als fünf Nutzern, SCIM, Audit-Logs, Secret-Manager-Schreibzugriff, Schlüsselrotation und die eingebauten Moderations-Callbacks.
Wie ist die Enterprise-Version bepreist?
Es gibt keinen öffentlichen Listenpreis. Die Preisseite sagt, die Lizenz richte sich nach jährlicher Gateway-Anfragekapazität, Deployment-Architektur und Support-Bedarf, nie pro Token, und jedes Angebot kommt vom Vertrieb. Ein 30-Tage-Testschlüssel wird ohne Kreditkarte ausgestellt, die Beschaffung läuft auch über den AWS Marketplace und Reseller.