Tools/KI-Agenten
LlamaIndex im Test: das breiteste Daten-Toolkit, dessen Schwerpunkt schon gewandert ist
LlamaIndex 2026: ein MIT-lizenziertes Python-Framework für Daten und Agenten, mit über 300 Integrationen, ereignisgetriebenen Workflows und einem Unternehmen, dessen Fokus auf LlamaParse liegt.
- Art
- Agent framework
- Preis
- MIT · hosted platform paid
Balázs Csorba··10 Min. Lesezeit
- Agent framework
- RAG
- Python
- Document parsing
- Workflows
Das Wichtigste in Kürze
- LlamaIndex ist weiterhin das breiteste Open-Source-Daten-Toolkit für LLM-Anwendungen: über 300 Integrationspakete, jeweils ein dünner Adapter, auf einem kleinen Satz Kernabstraktionen.
- Workflows, die Orchestrierungsschicht, ist ereignisgetrieben: Ein Schritt nimmt ein Ereignis entgegen und gibt ein Ereignis zurück, der Graph wird aus Typannotationen abgeleitet und vor dem Lauf validiert.
- Persistenz ist optional und handgeschrieben. Ein Lauf ist standardmäßig efemer, Schnappschüsse entstehen aus `Context.to_dict()` plus einer Schleife, die das Team schreibt, und das Fortsetzen ist at-least-once, Schritte müssen also wiederholbar sein.
- Das README des Unternehmens nennt inzwischen Dokumentenparsing und Extraktion als Fokus. LlamaParse ist das kostenpflichtige Produkt, in Credits abgerechnet, LiteParse der lokale Open-Source-Parser.
- Das Urteil: den Open-Source-Kern nutzen, Workflows als kleine Bibliothek, den Wirkungsradius des Frameworks aber klein halten, weil die Wartungsrichtung sichtbar woanders liegt.
LlamaIndex ist ein MIT-lizenziertes Python-Framework, das LLM-Anwendungen mit Daten verbindet. Es begann als Sammlung von Konnektoren und Index-Abstraktionen für Retrieval und ist bis heute das breiteste solche Toolkit: Das Repository veröffentlicht über 300 Integrationspakete für Modellprovider, Embedding-Modelle, Vektorspeicher, Dokumenten-Loader und Reranker. Diese Breite ist der Grund, warum die meisten Teams dem Projekt zuerst begegnen, und der Grund, warum es nützlich bleibt, obwohl die Aufmerksamkeit des Unternehmens längst woanders liegt. Die Position dieses Textes ist einfach: den Open-Source-Kern nutzen und bewusst entscheiden, welche gehosteten Teile dazukommen.
Es sitzt zwischen dem Modellprovider und der Anwendung. Nichts im Kern spricht direkt mit einem Modellprovider; jedes Modell, jeder Embedder und jeder Vektortär kommt über ein Integrationspaket herein, das eine abstrakte Klasse aus dem Kern implementiert. Das ist eine saubere Grenze und zugleich die Quelle des Hauptkritikpunkts: Dieselbe Abstraktion muss OpenAI, einen lokalen Ollama-Prozess und ein Dutzend Embedding-Modelle abdecken, der gemeinsame Nenner ist also kleiner, als die Oberfläche vermuten lässt. Gegen LangGraph konkurriert es um dieselbe Orchestrierungsrolle, gegen LangChain um den Umgang mit Daten und gegen eine von Hand zusammengesetzte Kombination aus Vektorspeicher und Reranker um Bequemlichkeit statt um Fähigkeiten.
Was es ist
Das Paketlayout ist das Erste, was man prüfen sollte, und dort fängt die meiste Verwirrung an. llama-index-core enthält die Abstraktionen und liefert Workflows mit aus. llama-index ist das Starter-Paket, das den Kern plus eine Auswahl an Integrationen installiert. Workflows gibt es zusätzlich eigenständig als llama-index-workflows, und kommt es über den Kern herein, wird es als llama_index.core.workflow importiert. Alles andere ist eine eigene Installation, und nur deshalb bleibt der Abhängigkeitsbaum handhabbar.
- MIT-Lizenz. Die aktuelle Version von
llama-index-coreist 0.14.25, veröffentlicht am 21. September 2026. - Über 300 Integrationspakete auf PyPI, jedes ein dünner Adapter über einer abstrakten Klasse des Kerns.
- Workflows, die Orchestrierungsschicht, ist ereignisgetrieben: Ein Schritt nimmt ein Ereignis entgegen und gibt ein anderes zurück, und das Framework routet nach Typannotation, nicht nach einer deklarierten Kante.
- Der Ereignisgraph wird vor dem Start eines Laufs validiert. Workflows, in denen ein Ereignis keinen Produzenten, ein erzeugtes Ereignis keinen Konsumenten hat oder kein Endereignis erreichbar ist, werden abgelehnt.
- Läufe sind standardmäßig efemer. Persistenz ist optional über
Context.to_dict()-Snapshots oder über ein Laufzeit-Plugin wie DBOS, das Schrittübergänge in eine Datenbank protokolliert. - Python ist das praktische Ziel des Frameworks. Nur LiteParse, der neue lokale Parser des Unternehmens, liefert Bindings über Python hinaus.
Wie Workflows funktioniert
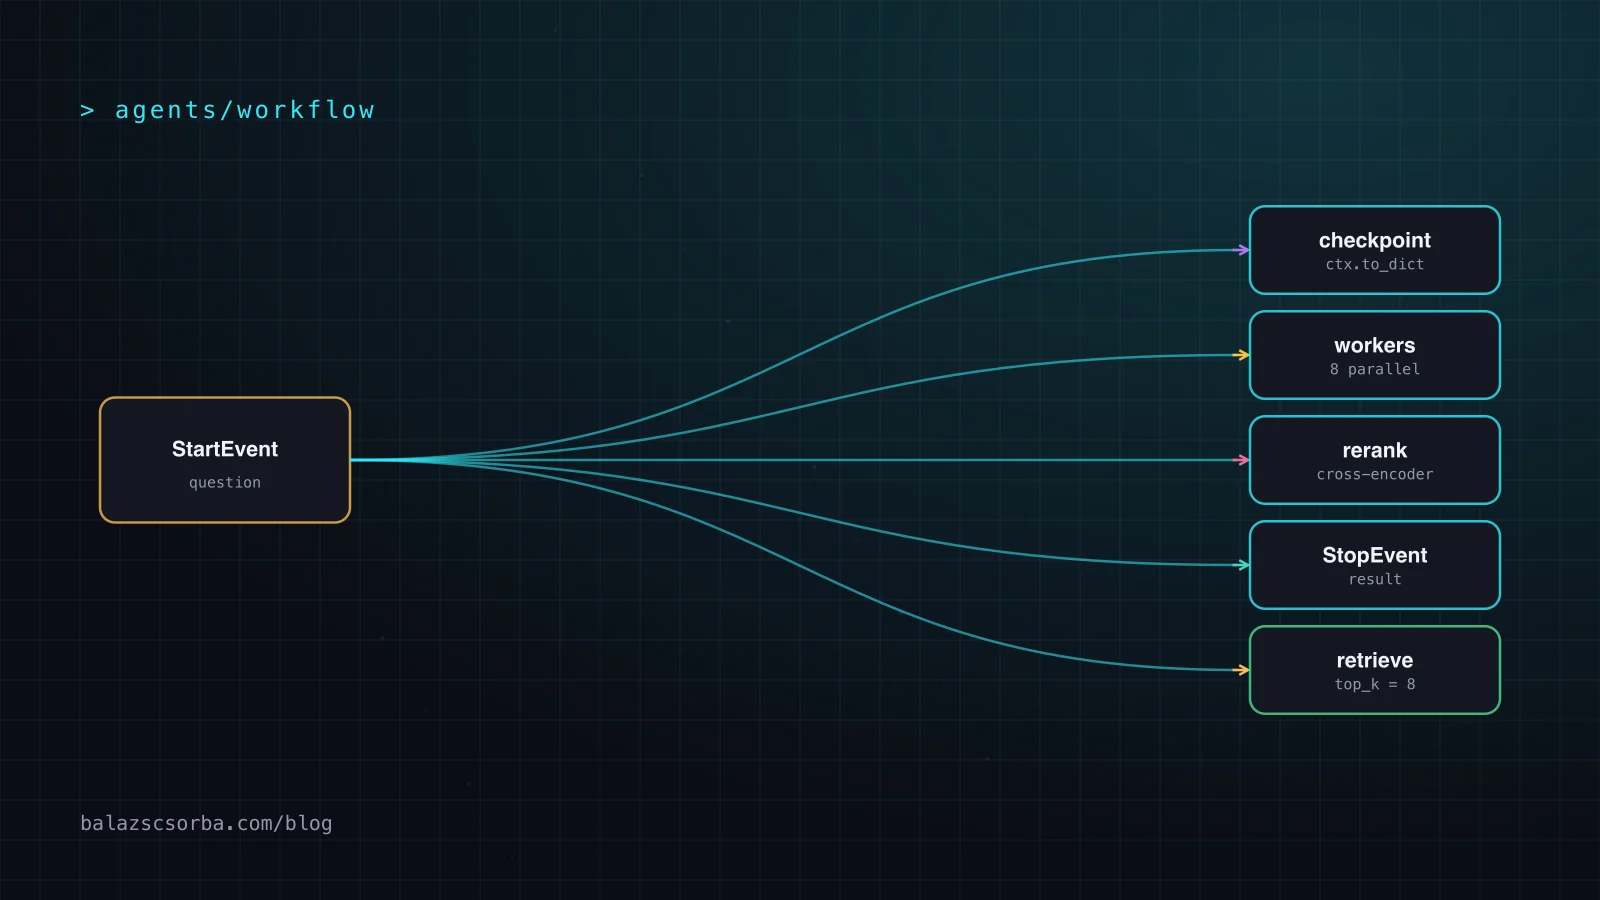
Workflows ist der Teil, den man verstehen sollte, weil er zugleich der Teil ist, der die RAG-Vergangenheit des Frameworks überdauert. Ein Workflow ist eine Unterklasse von Workflow, deren Methoden mit @step dekoriert sind. Jeder Schritt nimmt einen Ereignistyp entgegen und gibt einen anderen zurück; die Rückgabe des Startereignis-Typs beginnt einen Lauf, die Rückgabe von StopEvent beendet ihn. Verzweigungen sind gewöhnliche if-Anweisungen, die unterschiedliche Ereignistypen zurückgeben, und eine Schleife ist ein Schritt, der einen Ereignistyp zurückgibt, der früher im Graph behandelt wird. Nebenläufigkeit ist ein Schritt, der list[Event] zurückgibt, zusammen mit einem zweiten Schritt, der list[Event] entgegennimmt und als Sammelschritt fungiert.
- Zurückgeben von
list[Event], wenn ein Schritt eine endliche Menge hat und alle Arbeitspakete erzeugen kann, bevor die nachgelagerten Worker starten. - Entgegennehmen von
list[Event], wenn der Schritt die gesamte Ergebnismenge braucht, bevor er fortfahren kann. ctx.send_event(...)verwenden, wenn die Anzahl der Ereignisse vorab unbekannt ist oder ein Ereignis von außerhalb eines Schritts abgeschickt werden muss.ctx.storefür gemeinsamen Zustand pro Lauf undResource(...)für Clients, Modelle und Konfiguration, die nicht in einen Snapshot serialisiert werden dürfen.
Die Typannotationen sind nicht dekorativ, sondern tragend. Vor der Ausführung leitet das Framework den Ereignisgraphen aus den Schritt-Signaturen ab und verweigert den Start, wenn ein Ereignis nicht erzeugt, ein erzeugtes Ereignis nicht konsumiert wird oder kein StopEvent erreichbar ist. Damit fängt es eine Klasse von Verdrahtungsfehlern, die eine von Hand geschriebene Funktionskomposition überhaupt nicht fängt, und das ist das stärkste Argument für das Design. Der Preis ist, dass ein absichtlich dynamischer Workflow auf ctx.send_event ausweichen und angeben muss, welche statischen Prüfungen übersprungen werden, was praktisch bedeutet: Je fähiger ein Workflow wird, desto weniger lässt er sich statisch prüfen.
Erste Schritte
Der kleinste sinnvolle Workflow umfasst rund zwanzig Zeilen. Zwei Installationsformen werden unterstützt, und sie unterscheiden sich im Importpfad, woran es häufig scheitert:
import asyncio

from llama_index.core import VectorStoreIndex
from workflows import Workflow, step
from workflows.events import Event, StartEvent, StopEvent


class Answered(Event):
    question: str
    answer: str


class TriageFlow(Workflow):
    index: VectorStoreIndex

    @step
    async def retrieve(self, ev: StartEvent) -> Answered:
        retriever = self.index.as_retriever(similarity_top_k=8)
        nodes = await retriever.aretrieve(ev.question)
        best = max(nodes, key=lambda n: n.score or 0.0)
        return Answered(question=ev.question, answer=best.node.get_content())

    @step
    async def answer(self, ev: Answered) -> StopEvent:
        return StopEvent(result=ev.answer)


async def main():
    flow = TriageFlow(index=VectorStoreIndex.from_documents(documents), timeout=60)
    result = await flow.run(question="What is the refund window?")
    print(result.result)

asyncio.run(main())
run() liefert einen WorkflowHandler. Er ist awaitable, und wer das Handler-Objekt behält statt direkt zu awaiten, erhält zugleich Zugriff auf stream_events() für Fortschrittsmeldungen. Das Argument timeout wird in Sekunden angegeben und im Konstruktor gesetzt. Jeder Schritt ist bewusst asynchron, ein eigenständiges Skript braucht also einen einzigen asyncio.run-Einstiegspunkt; in FastAPI oder im Notebook ist das nicht nötig.
Persistenz und Retries
Workflows sind standardmäßig efemer: Sobald run() zurückkehrt, ist der Zustand weg, und der nächste Lauf beginnt bei null. Für eine Ausspielung über hunderte Dokumente, die nicht wieder bei null beginnen soll, sieht die Dokumentation einen Checkpoint-Loop vor. Context.to_dict() serialisiert die noch laufenden Ereignisse und den Zustandsspeicher, Context.from_dict() baut sie wieder auf, und run(ctx=...) setzt in einem anderen Prozess fort. Ein eingebauter Checkpointer gibt es nicht: Der Lauf emittiert bei jedem beendeten Schritt ein internes StepStateChanged-Ereignis, und genau das ist das Signal zum Speichern.
import json

from workflows.events import StepState, StepStateChanged

handler = flow.run(question=q)

async for ev in handler.stream_events(expose_internal=True):
    if isinstance(ev, StepStateChanged) and ev.step_state == StepState.NOT_RUNNING:
        json.dump(handler.ctx.to_dict(), open("run.json", "w"))

result = await handler

# after a restart: resume from the last snapshot
ctx = Context.from_dict(flow, json.load(open("run.json")))
result = await flow.run(ctx=ctx)
Zwei Eigenschaften dieses Designs zeigen sich im Betrieb. Das Fortsetzen ist at-least-once: Ein Schritt, der beim Speichern noch lief, wird zurückgesetzt und erneut ausgeführt, es werden also bis zu num_workers Elemente doppelt verarbeitet. Und der Snapshot ist JSON; ein Wert, den der Serialisierer nicht kodieren kann, lässt to_dict() scheitern und damit den gesamten Snapshot, nicht nur das betroffene Feld. Schwere Eingaben gehören deshalb in eine Resource, die beim Fortsetzen neu erzeugt wird, statt serialisiert zu werden. Wer den Loop nicht selbst verwalten will, nutzt das DBOS-Laufzeit-Plugin, das Schrittübergänge in eine Datenbank protokolliert und keinen Checkpoint-Code braucht.
Wo es schwächelt
Die Schwächen sind strukturell und keine Fehler. Breite ist eine Wartungsfläche: Bei Hunderten Integrationen kann ein Upgrade die Modell-Wrapper verschieben, die man gar nicht anfassen wollte, und eine Integration festzupinnen bedeutet oft, den Kern festzupinnen. Die High-Level-API versteht genug, dass ein Prototyp in die Produktion kommen kann, ohne dass jemand festhält, welche Chunkgröße, welches top-k und welche Prompt-Vorlage die Antwort erzeugt haben; die Voreinstellungen sind bequem und nicht als Voreinstellungen dokumentiert. Persistenz ist optional und handgeschrieben, also das Gegenteil dessen, was ein langlebiger Batch-Job braucht. Und das Unternehmen hinter dem Framework hat seinen Fokus öffentlich verengt, was 2026 unangenehm zu bewerten ist.
| Framework | Orchestrierungsmodell | Persistenz und Zustand | Wo es gewinnt |
|---|---|---|---|
| LlamaIndex Workflows | Ereignisgetriebene Schritte, Kontrollfluss in normalem Python | Kein eingebauter Checkpointer; Kontext-Snapshots vom Team oder das DBOS-Laufzeit-Plugin | Retrieval- und Dokumentenkomponenten liegen in derselben Bibliothek |
| LangGraph | Expliziter Zustandsgraph mit bedingten Kanten | Dauerhafte Ausführung und Checkpointer sind Standard | Zustandsübergänge sind das Artefakt und bleiben als Graph einsehbar |
| Haystack | Pipelines typisierter Komponenten | Fehlerzweige und Retries pro Komponente | Ein stabiler Komponentenkatalog für retrieval-lastige Anwendungen |
| DSPy | Deklarative Module, offline gegen eine Metrik optimiert | Keine; das ist keine Orchestrierungs-Laufzeitumgebung | Tuning von Prompts und Modulen, noch bevor es Servercode gibt |
Liest man die Spalte zur Persistenz durch, wird der praktische Zuschnitt lesbar. LangGraph macht Checkpointing zum Standard und bezahlt das mit einem expliziten Graphen, was Denkarbeit kostet und Lesbarkeit einkauft. Workflows behält die Kontrolle im normalen Python, das liest sich besser und lässt sich schlechter untersuchen: Ein Workflow, der über 500 Dokumente ausspielt, sind 500 parallele Aufrufe, deren Reihenfolge kein Werkzeug sichtbar macht. Für ein Team, dessen Arbeit das Nachdenken über Zustandsübergänge ist, ist das der falsche Handel. Für ein Team, das normales Python schreiben und sich darauf verlassen will, dass es sich vorhersehbar verhält, ist es der richtige.
Ein zweiter Vorbehalt gehört hierher. Ein dynamischer Workflow verliert die statische Analyse, und die Dokumentation sagt ausdrücklich, dass unerreichbare Schritte und einmalige Ereignisse genau das sind, was diese Prüfungen nicht sehen können. Wer einen von Hand gezeichneten Graphen in Workflows überführt, greift früh zu skip_graph_checks und schaltet damit genau die Prüfung still ab, die tote Zweige fände, also dieselbe Prüfung, die zuerst den Verdrahtungsfehler gefunden hätte.
Die Kehrtwende zur Dokumentenverarbeitung
Das README des Repositorys trägt inzwischen einen nicht zu übersehenden Hinweis: Der aktuelle Fokus von LlamaIndex liegt auf Dokumentenparsing und Extraktion, und LlamaParse ist die Unternehmensplattform dafür. Das ändert, was ein Wartungsbudget finanziert. Die Integrationspakete werden weiterhin ausgeliefert und funktionieren weiterhin; was nicht mehr garantiert ist, dass jedes einzelne erweitert wird, wenn ein neuer Anbieter erscheint.
- LlamaParse ist das kostenpflichtige Produkt: agentisches OCR, Parsing, Extraktion und Indexierung, verkauft in Credits statt in Sitzen.
- LiteParse ist das offene Gegenstück: ein Rust-Parser, der lokal ohne LLM, ohne Cloud-Abhängigkeit und ohne API-Schlüssel läuft, mit Bindings für TypeScript, Python, Rust und Browser-WASM.
- ParseBench und ExtractBench sind die eigenen öffentlichen Benchmarks des Unternehmens für Parsing und Extraktion.
- Das Framework bleibt MIT-lizenziert und auf PyPI veröffentlicht, mit
llama-index-corein Version 0.14.25 vom 21. September 2026. - Das Ergebnis ist eine geteilte Strategie: offene Werkzeuge für lokales Parsing, eine gehostete Plattform für schwierige Dokumente und dazwischen das Agent-Framework als Integrationsfläche.
Das ist eine vertretbare Geschäftsentscheidung und eine leichte Warnung für alle, die jetzt ein Framework wählen. Die Teile des Stacks, die am ehesten gepflegt werden, sind die Teile hinter der Bezahlschranke, und der MIT-Kern ist das, was als Bibliothek nützlich bleibt. Das liest sich als Plädoyer für einen kleinen Wirkungsradius des Frameworks: Workflows für die Orchestrierung nutzen, Laden und Parsing im eigenen Haus lassen, wo das möglich ist, und explizit sein, welche Aufrufe die eigene Infrastruktur verlassen.
Urteil
Das Urteil lautet: LlamaIndex bleibt die vollständigste Antwort auf eine enge Frage, nämlich wie Dokumente ohne selbst geschriebene Integrationsschicht in eine LLM-Anwendung gelangen, und eine mittelmäßige Antwort auf die breitere Frage, wie ein Agent orchestriert wird. Workflows ist wirklich gut darin, verzweigte Logik in typisiertes, validiertes Python zu übersetzen, und sein at-least-once-Checkpoint-Modell ist ehrlich über seine eigenen Fehlersemantiken. Was das Framework nicht liefert, ist eine Laufzeitumgebung, auf die man zeigen und schauen kann: kein Zustandsgraph zum Inspizieren, keine Persistenz als Standard und eine Wartungsrichtung, die sichtbar woanders liegt.
- Nimm es, wenn die meisten Daten Dokumente sind und die Abstraktionen für Konnektoren, Chunker, Embedder und Reranker bereits geschrieben vorliegen. Das ist eine echte Ersparnis und war der ursprüngliche Zweck.
- Nimm Workflows einzeln als kleine Bibliothek, wenn die Orchestrierung verzweigendes, schleifendes Python ist, das derzeit in asyncio verknotet steckt. Der typisierte Ereignisgraph und die Vorabvalidierung sind der Grund.
- Wähle es nicht für einen Graphen, über den man nachdenken muss. Wenn die Zustandsübergänge das Artefakt sind, das geprüft wird, schlägt ein expliziter Graph die Python-Kontrollstruktur.
- Wähle es nicht wegen der gehosteten Plattform. LlamaParse, Extract und der Index-Dienst sind ein separates kostenpflichtiges Produkt mit Credit-Preisen, und die eigene Ingest-Rechnung an ein Framework zu binden ist eine Entscheidung, keine Voreinstellung.
- Vermeide es für einen TypeScript- oder Go-Stack. Der Kern ist Python; nur der neue LiteParse-Parser liefert breitere Bindings.
- Bewerte in einem Jahr neu, wenn die Integrationsbreise tragend ist. Bei des Unternehmens Fokus auf Parsing und Extraktion ist der lange Riegel der Vektorspeicher- und Embedder-Integrationen der Teil, der am ehesten von langsamer Wartung betroffen ist.
The current focus of LlamaIndex is to build the best AI-powered engine for document parsing and extraction.
Dieser Satz steht im README des Projekts und nicht in einem Blogbeitrag, was ungewöhnlich ist und Beachtung verdient: Die Maintainer des Frameworks selbst benennen, wohin die Roadmap führt. Als technische Aussage gelesen heißt das: Die Orchestrierungsschicht wird gepflegt, ist aber nicht das Ziel, die kostenpflichtige Dokumentenpipeline schon.
Quellen
Häufige Fragen
Lohnt sich LlamaIndex 2026 noch?
Ja, mit eingegrenztem Anwendungsbereich. Der MIT-lizenzierte Kern wird gepflegt, `llama-index-core` stand am 21. September 2026 bei Version 0.14.25, und die Orchestrierungsschicht Workflows ist wirklich gut durchdacht für verzweigende und schleifende Logik. Geändert hat sich der erklärte Fokus des Unternehmens, den das README auf Dokumentenparsing und Extraktion statt auf das Framework legt.
Was sind LlamaIndex Workflows und wie funktionieren sie?
Ein Workflow ist eine Unterklasse von `Workflow` mit Methoden, die mit `@step` dekoriert sind. Jeder Schritt nimmt einen Ereignistyp entgegen und gibt einen anderen zurück, und das Framework routet nach Typannotation, sodass Verzweigungen gewöhnliche `if`-Anweisungen sind und Schleifen Schritte, die ein früher behandeltes Ereignis zurückgeben. Nebenläufigkeit ist ein Schritt, der `list[Event]` zurückgibt, gepaart mit einem Schritt, der `list[Event]` entgegennimmt. Der Ereignisgraph wird vor dem Lauf validiert.
Wie geht LlamaIndex mit Persistenz und Retries um?
Standardmäßig gar nicht. Sobald `run()` zurückkehrt, ist der Zustand weg. Der dokumentierte Mechanismus ist ein Checkpoint-Loop: den Kontext mit `Context.to_dict()` serialisieren, wenn ein `StepStateChanged`-Ereignis einen Schritt als beendet markiert, dann mit `Context.from_dict()` wieder aufbauen und `run(ctx=...)` aufrufen. Das Fortsetzen ist at-least-once, ein beim Speichern noch laufender Schritt läuft erneut. Das DBOS-Laufzeit-Plugin ist die Alternative, die die Schleife überflüssig macht.
Was kostet LlamaParse?
Die Preisseite verkauft Credits statt Sitze: 1.000 Credits für 1,25 $, 10.000 Credits kostenlos, 40.000 im Starter-Tarif für 50 $ und 400.000 im Pro-Tarif für 500 $, dazu Pay-as-you-go-Grenzen von 500 $ und 5.000 $ pro Monat. Gleichzeitige Parse-Jobs: 5 in Free und Starter, 20 in Pro, 100 in Enterprise. Parse, Extraktion, Klassifizierung und Indexierung ziehen alle vom selben Guthaben ab.