Tools/RAG & Retrieval
Weaviate: eine Vektordatenbank, die bei der Suche gewinnen muss, nicht nur bei der Ähnlichkeit
Weaviate im Test: hybride BM25- und Vektorsuche in einer Abfrage, HNSW und HFresh, Quantisierungsentscheidungen, eingebauter MCP-Server, Lizenzschlüssel.
- Art
- Vector database
- Preis
- BSD-3 · Cloud from $25 per month
Balázs Csorba··10 Min. Lesezeit
- Vector search
- Hybrid search
- HNSW
- Quantization
- Multi-tenancy
Das Wichtigste in Kürze
- Weaviate beantwortet eine Abfrage gleichzeitig mit BM25-Keyword-Suche, Vektorähnlichkeit und strukturierten Filtern, und genau das ist der Grund, es einer reinen Nearest-Neighbour-Engine vorzuziehen.
- HNSW ist speichergebunden: Laut Doku kostet ein Knoten 2 bis 12 kB, eine Million Vektoren mit 1536 Dimensionen also 2 bis 12 GB Index im RAM, eine hundert Millionen 200 bis 1200 GB.
- Index-Typ und Quantisierungsbreite sind praktisch Entscheidungen zum Anlegen der Collection. Die Bitebene der Rotationsquantisierung wird beim ersten Aktivieren von RQ festgeschrieben und lässt sich danach nicht migrieren.
- Der Hersteller-Benchmark für DBPedia mit OpenAI-ada002-Embeddings meldet 97,24 Prozent Recall@10 bei 5639 Queries pro Sekunde und 4,43 ms p99 auf einer einzelnen Maschine mit 16 vCPU und 128 GB, ungefiltert.
- Das Repository ist außerhalb des wl-Verzeichnisses BSD-3, und v1.40 legt Namespaces und deduplizierte Backups hinter einen Weaviate-Lizenzschlüssel im selben Binary.
Weaviate ist eine Vektordatenbank, die Objekte und ihre Embeddings nebeneinander speichert und eine Abfrage gleichzeitig mit BM25-Keyword-Suche, Vektorähnlichkeit und strukturierten Filtern beantwortet. Sie ist die vollständigste Suchmaschine in der Open-Source-Kategorie. Der Grund zur Skepsis ist nicht die Retrieval-Qualität, sondern die Speicherrechnung und die Zahl der Index- und Quantisierungsentscheidungen, die vor dem ersten Import fallen müssen.
Sie konkurriert mit Qdrant bei speichersparsamen Indizes, mit Pinecone beim Managed-Betrieb und mit pgvector mit dem Argument, ein Team, das bereits eine Datenbank betreibt, solle nicht eine zweite aufbauen. Weaviates Antwort ist, dass es zuerst eine vollwertige Datenbank ist, mit Replikation, Backups, Multi-Tenancy, RBAC und inkrementellen Schemaänderungen, und die Nahestvektorsuche danebensteht.
Was es ist
Das Projekt stammt von der niederländischen Firma Weaviate B.V., ist in Go geschrieben, und die aktuelle Version ist 1.40.0, getaggt am 7. Oktober 2026. Es gibt offizielle Clients für Python, JavaScript, Java, Go und C# sowie REST, gRPC und GraphQL. Die Kernfakten, die man vor einem Vergleich kennen sollte:
- Hybride Suche führt BM25- und Vektorergebnisse in einer Abfrage zusammen, ein Parameter alpha gewichtet die beiden Hälften.
- Vier Vektorindizes: flat, HNSW, dynamic (ein Flat-Index, der sich selbst zu HNSW hochschaltet) und HFresh, der plattenbasierte Index aus 1.36, seit 1.38 allgemein verfügbar.
- Quantisierung umfasst Skalar-, Produkt-, Binär- und Rotationsverfahren; 4-Bit-Rotationsquantisierung ist Preview, v1.40 ergänzt RQ-4 für HNSW-Indizes.
- Ein eingebauter MCP-Server, seit 1.38 allgemein verfügbar, stellt vier Tools unter /v1/mcp auf dem REST-Port bereit.
- Multi-Tenancy, Replikation, Backups, inkrementelle Backups, Objekt-TTL und Collection-Aliase sind alle im Open-Source-Build und nicht im kostenpflichtigen.
Wie es funktioniert
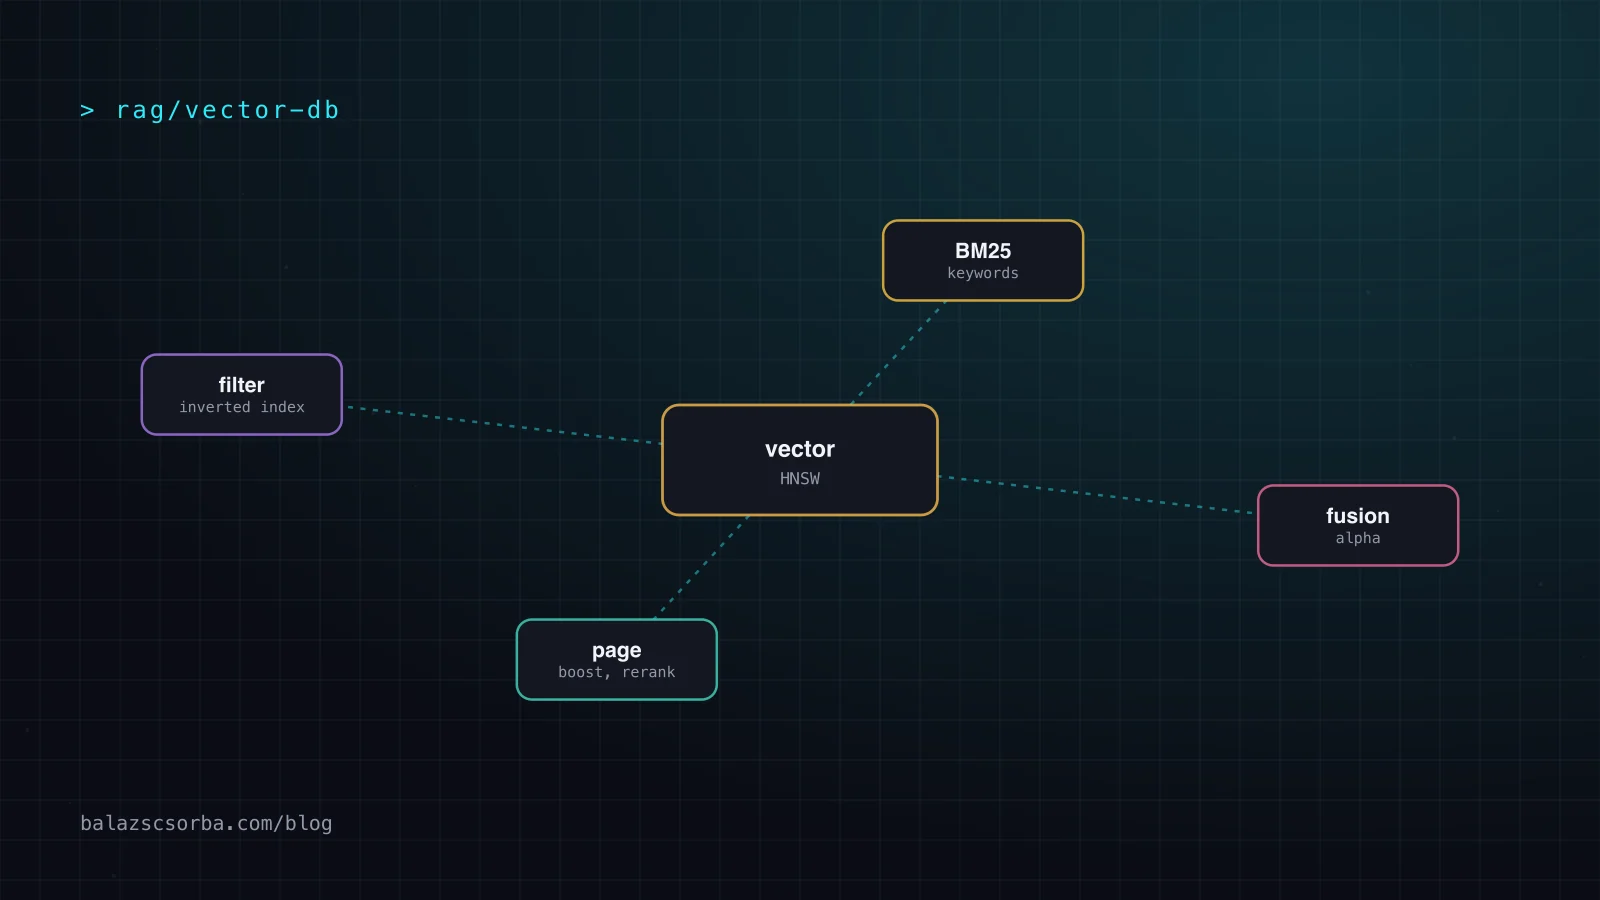
Eine Abfrage trifft auf zwei Indexfamilien. Objekteigenschaften liegen in invertierten Indizes, derselben BM25-Maschinerie, die auch eine Suchmaschine mit invertiertem Index nutzt, ein Filter grenzt also die Kandidatenmenge ein, bevor etwas Teures passiert. Vektoren liegen im Vektorindex, wo HNSW einen geschichteten Graphen im Speicher abläuft. Das Ergebnis wird fusioniert, optional geboostet und optional neu gerankt.
Daraus folgen zwei Dinge. Gefilterte Suche bleibt günstig, weil der Filter zuerst läuft. Und der teure Teil ist immer der Vektorindex, dort liegt die Betriebskosten. QUERY_HYBRID_MAXIMUM_RESULTS steht standardmäßig auf 200, jede Hälfte einer hybriden Abfrage holt also mindestens so viele Kandidaten vor der Fusion; das ist der erste Regler, den man dreht, wenn eine Abfrage langsamer ist als der Benchmark nahelegte.
Erste Schritte
Der Python-Client ist der richtige Einstieg. Eine Collection mit HNSW-Index, Quantisierung, hybrider Suche, Filter, Boost und Diversitätsauswahl in rund dreißig Zeilen:
from datetime import timedelta

import weaviate
from weaviate.classes.config import Configure, VectorDistances
from weaviate.classes.query import Boost, Diversity, Filter

client = weaviate.connect_to_local()  # or connect_to_cloud(cluster_url, auth)

client.collections.create(
    "Product",
    vector_config=Configure.Vectors.text2vec_openai(
        source_properties=["name", "description"],
        vector_index_config=Configure.VectorIndex.hnsw(
            distance_metric=VectorDistances.COSINE,
            quantizer=Configure.VectorIndex.Quantizer.rq(bits=8),
        ),
    ),
)

products = client.collections.get("Product")
products.data.insert_many([
    {"name": "Kestrel Wireless Headphones", "in_stock": True, "released": "2026-09-20"},
    {"name": "Aurora Wireless Headphones", "in_stock": False, "released": "2025-11-02"},
    {"name": "Nimbus Wireless Headphones", "in_stock": True, "released": "2026-10-05"},
])

boost = Boost.blend(
    [
        Boost.filter(Filter.by_property("in_stock").equal(True), weight=2.0),
        Boost.time_decay("released", scale=timedelta(days=30)),
    ],
    weight=0.3,   # 30 percent boost, 70 percent original relevance
    depth=200,    # re-score the top 200 candidates
)

hits = products.query.hybrid(
    query="wireless headphones",
    limit=4,
    filters=Filter.by_property("released").greater_than("2025-01-01"),
    boost=boost,
    diversity_selection=Diversity.mmr(limit=4, balance=0.3),
)
for hit in hits.objects:
    print(hit.properties["name"])
Vier Details in diesem Snippet entscheiden über die Zusammensetzung der Seite. Boost.blend entfernt nie ein Ergebnis, es sortiert nur neu, ein negatives Gewicht einer Bedingung demotiert also statt zu filtern. depth legt fest, wie viele Kandidaten neu bewertet werden, und das äußere weight bestimmt, wie viel des Endwerts der Boost hält. MMR braucht Client 4.23.0 oder neuer, und der Standardwert für balance ist 0.0, also reine Diversität und kein neutraler Mittelwert. Wer Boost und Rerank kombiniert, bekommt das Reranking zuletzt, es hat das letzte Wort.
Indizes, Speicher und die Rechnung
HNSW hält Knoten und Kanten im Speicher, und die Dokumentation ist ungewöhnlich direkt beim Kostenniveau: ein Knoten kostet je nach Dimensionalität 2 bis 12 kB, eine Million Vektoren also 2 bis 12 GB, eine hundert Millionen 200 bis 1200 GB, dazu rund 200 Byte Kanten pro Vektor. Das ist eine Zahl für die Kapazitätsplanung, kein Durchsatzziel.
| Index | Speicher | Suchverhalten | Wofür |
|---|---|---|---|
| Flat | Sehr gering | Exakt, linearer Scan | Kleine Collections und Daten pro Mandant in einer Multi-Tenancy-Umgebung |
| HNSW | Hoch, alles resident | Am schnellsten; logarithmisch im Graphen | Große Collections mit hohem Query-Durchsatz |
| HFresh | Gering, Postings auf der Platte | Liest wenige Posting-Listen, dann Rescoring | Der Speicher ist die harte Grenze; etwas höhere p99 akzeptabel |
HFresh ist das interessante Stück für große Korpora. Es gruppiert Vektoren in Postings auf der Platte, hält einen kleinen 8-Bit-quantisierten HNSW-Index über deren Schwerpunkte im Speicher und speichert die Postings selbst mit 1 Bit. Eine Suche liest nur die Postings, die der Schwerpunktindex auswählt, und bewertet die Kandidaten dann gegen unkomprimierte Vektoren neu. Die Doku ist präzise: unterstützt werden nur Cosine- und l2-squared-Distanz, das Skalarprodukt fehlt, und gegen HNSW beim rohen Durchsatz ist HFresh nicht gedacht. Die Recall-Parameter sind ein Latenzregler: searchProbe legt fest, wie viele Posting-Listen eine Abfrage besucht, replicas in wie viele Listen jeder Vektor aufgenommen wird und maxPostingSizeKB die Clustergröße.
Quantisierung ist der zweite Hebel. Rotationsquantisierung dreht einen Vektor so, dass sich seine Werte gleichmäßig auf die Dimensionen verteilen, und speichert jede Dimension dann als kleinen Ganzzahlwert. Bei 4 Bit und 1536 Dimensionen kostet ein Vektor 784 Byte gegenüber 6144 für rohes float32, ein Faktor 7,84 statt runder 8, weil der 16 Byte große Rotationsheader bleibt. Kompression senkt Speicher und Rechenaufwand, aber nicht die Zahl der Dimensionen, die die Cloud abrechnet: Weaviate Cloud rechnet ab 0,00465 US-Dollar pro Million Vektordimensionen und Monat auf Flex ab, Storage ab 0,12 US-Dollar pro GiB, bei einer Mindestsumme von 45 US-Dollar pro Monat, und aggressivere Kompression zeigt sich als niedrigerer Preis je Dimension, nicht als kleinere Rechnung.
Der Benchmark des Herstellers lohnt sich nur mit Methodik. Auf DBPedia mit OpenAI-ada002-Embeddings, eine Million Objekte bei 1536 Dimensionen und Cosine-Distanz, liefert die empfohlene Konfiguration mit efConstruction 256, maxConnections 16 und ef 96 97,24 Prozent Recall@10 bei 5639 Queries pro Sekunde, 2,80 ms mittlerer Latenz und 4,43 ms p99. Das sind 10.000 ungefilterte Suchen auf einer einzigen GCP-n4-highmem-16-Instanz mit 16 vCPU und 128 GB, gesteuert vom Go-Client aus demselben VPC, wobei jedes gefundene Objekt wieder von der Platte gelesen wird. Die Skripte sind Open Source, und das ist der wichtige Teil.
Wo es knirscht
Zuerst die Schwächen, weil sie entscheiden, ob das die richtige Datenbank ist. Das Wachstum auf HNSW ist eine Speicherkurve und keine horizontale: eine hundert Millionen Vektoren mit 1536 Dimensionen ist eine Planungsaufgabe im dreistelligen Gigabereich, und zusätzliche Knoten verkleinern den Index eines Shards nicht. Löschen ist asynchron, eine Suche direkt danach kann das Objekt noch liefern. Die API-Fläche ist so breit, dass GraphQL, gRPC, gRPC-Web und eine vierte, experimentelle REST-Such-API nebeneinander existieren, und die Release Notes zu 1.39 sagen, dass die Referenzauswahl in dieser neuen REST-API ersetzt wird, Code dagegen wird sich also noch ändern.
| Datenbank | Indexmodell | Selbstbetriebsaufwand | Wo es weh tut |
|---|---|---|---|
| Weaviate | HNSW, flat, dynamic, HFresh | Eine Datenbank: Replikation, Backups, RBAC, Multi-Tenancy | Speichergebundenes Wachstum; mehr Schemafläche zu lernen |
| Qdrant | HNSW mit Platten- und Skalarquantisierung | Eine fokussierte Vektor-Engine mit Filtern | Weniger der Datenbankfunktionen, die Weaviate liefert |
| pgvector | Postgres-Indizes: HNSW, IVFFlat | Keiner: es ist eine Extension auf einer vorhandenen Datenbank | Recall und Tuning sind jetzt Postgres-Tuning |
| Pinecone | Nur managed | Nichts zu betreiben | Kein Selbstbetrieb, und eine Rechnung nach Read Units |
Zwei Betriebsnotizen runden das Bild ab. Async Replication wurde in 1.38 clusterweit auf einen einzigen Scheduler umgebaut und läuft jetzt bei jeder replizierten Collection standardmäßig, ein Zugewinn an Zuverlässigkeit und zugleich eine Last im Hintergrund. Und in 1.40 liegt das neue Namespaces-Feature, das Control-Plane- und Datenisolierung zwischen Nutzern eines gemeinsam genutzten Clusters ergänzt, hinter einem Weaviate-Lizenzschlüssel.
MCP-Zugang und die Lizenzgrenze
Der MCP-Server ist das Erste, worauf die meisten Teams stoßen. Es ist ein Streamable-HTTP-Server unter /v1/mcp auf dem REST-Port, im Selbstbetrieb standardmäßig aus, in Weaviate Cloud immer aktiv und mit einem API-Key als Bearer-Token authentifiziert. Er stellt vier Tools bereit: weaviate-collections-get-config für Schemata, weaviate-tenants-list, weaviate-query-hybrid für eine hybride Suche mit einem alpha von standardmäßig 0,75 und weaviate-objects-upsert für Schreibzugriffe. Die Rechte sind die normalen RBAC-Rollen, geprüft beim Aufruf eines Tools.
BeLizenzierung ist die LICENSE im Repository eindeutig: Code außerhalb des wl-Verzeichnisses steht unter BSD-3-Clause, Code darin ist Copyright Weaviate B.V. und nur unter einer separaten Enterprise-Lizenz verfügbar, freigeschaltet über einen Lizenzschlüssel, und die BSD-Lizenz gibt kein Recht, diese Funktionen zu nutzen oder den Schlüssel zu umgehen. v1.40 legt Namespaces und deduplizierte Backups auf diese Seite. Die Datenbank selbst bleibt BSD-3 und ohne Nutzungslimit selbst hostbar, die einzige echte Frage ist, wie viel der Roadmap hinter dem Schlüssel landet.
Fazit
Weaviate ist die Vektordatenbank der Wahl, wenn Retrieval-Qualität und betriebliche Vollständigkeit wichtiger sind als der kleinstmögliche Speicherbedarf, und wenn ein Team Index-Typ, Quantisierungsbreite und ef als echte Parameter behandeln kann statt als Voreinstellungen. Sie ist falsch für ein Team, das bereits Postgres betreibt und Embeddings neben den Zeilen haben will, und falsch für einen Korpus von hundert Millionen Vektoren bei festem Speicherbudget.
- Nimm sie, wenn Abfragen Filter und Keywords ebenso brauchen wie Vektoren, und das in einem Rundgang statt in drei passieren soll.
- Nimm sie, wenn Multi-Tenancy, Replikation, Backups und RBAC nötig sind, ohne vier Dienste an einen nackten Vektorindex zu hängen.
- Nimm sie, wenn eine BSD-3-Datenbank selbst betrieben werden kann und dieselbe API als Managed-Option gewünscht ist.
- Lass sie, wenn der Korpus so groß ist, dass HNSW-Speicher die Rechnung dominiert und etwas höhere p99 akzeptabel wären; das ist die Aufgabe von HFresh oder einer eigens gebauten Engine.
- Lass sie, wenn du erwartest, dass die ganze Roadmap unter der BSD-Lizenz bleibt. Prüfe vor dem Design, welche Features deine Version hinter einen Lizenzschlüssel legt.
Quellen
Häufige Fragen
Ist Weaviate im Selbstbetrieb weiterhin kostenlos?
Die Datenbank steht unter BSD-3-Clause und lässt sich ohne Nutzungslimit selbst betreiben. Die LICENSE im Repository stellt klar, dass Code im wl-Verzeichnis proprietär ist und über eine Enterprise-Lizenz freigeschaltet wird, und v1.40 legt Namespaces sowie deduplizierte Backups hinter diesen Schlüssel. Die Cloud-Preise: eine kostenlose Stufe, Flex ab 45 US-Dollar pro Monat und Premium ab 400 US-Dollar.
HNSW oder HFresh für eine große Collection?
HNSW ist die schnellste Variante und der Standard, hält aber den gesamten Graphen im Speicher. HFresh behält nur einen komprimierten Zentroidadindex im RAM und liest Posting-Listen von der Platte, was laut Doku nicht darauf ausgelegt ist, HNSW beim Durchsatz zu schlagen. HFresh passt, wenn der Speicher die harte Grenze ist und etwas höhere p99 akzeptabel sind.
Senkt Quantisierung die Rechnung von Weaviate Cloud?
Nein. Die Abrechnung der Cloud basiert auf der Zahl der gespeicherten Vektordimensionen, zusätzlich Storage und Backups, und Kompression ändert diese Zahl nicht. Sie senkt den Speicher- und Rechenbedarf, was sich im Listenpreis je Dimension zeigt und nicht in der Zahl der berechneten Dimensionen.
Kann ein Agent Weaviate über MCP abfragen?
Ja, seit v1.38 bringt die Datenbank einen MCP-Server unter /v1/mcp auf dem REST-Port mit mit vier Tools: weaviate-collections-get-config, weaviate-tenants-list, weaviate-query-hybrid und weaviate-objects-upsert. Selbst gehostet ist er standardmäßig aus, in Weaviate Cloud immer aktiv, dort ist das Schreib-Tool aktiv, sofern nicht der Schalter Enable MCP Read-Only gesetzt ist.
Wie groß darf eine HNSW-Collection werden, bevor der Speicher limitiert?
Die Doku beziffert einen HNSW-Knoten je nach Dimensionalität auf 2 bis 12 kB, dazu rund 200 Byte Kanten pro Vektor. Das sind 2 bis 12 GB bei einer Million und 200 bis 1200 GB bei hundert Millionen Vektoren. Rotationsquantisierung oder HFresh sind die beiden Hebel; der Vektorcache ist mit 1e12 Objekten pro Collection separat begrenzt.