Blog/Web-Engineering
Generative Engine Optimization in der Praxis: ein vollständiges GEO-Audit meiner eigenen Site
Was Generative Engine Optimization ist, was die Forschung wirklich stützt, und das GEO-Audit dieser Site: 12 Prüfungen, 7 Fixes, samt Code.
Balázs Csorba··12 Min. Lesezeit
- GEO
- AI search
- Structured data
- nginx
Das Wichtigste in Kürze
- Generative Engine Optimization (GEO) heißt, Seiten so zu gestalten, dass KI-Antwortmaschinen sie leicht abrufen, zitieren und als Quelle nennen; der Begriff stammt aus einem Paper von Aggarwal et al. aus 2023, vorgestellt auf der KDD 2024.
- In diesem Paper steigerten Zitate, Statistiken und genannte Quellen die Sichtbarkeit einer Seite in generierten Antworten um bis zu 40 %, während Keyword-Stuffing schlechter abschnitt als gar keine Optimierung.
- Eine Übersichtsarbeit über 45 GEO-Studien vom Juli 2026 fand, dass diese Gewinne nur für Seiten gelten, die bereits abgerufen werden; keine Technik zeigte einen stabilen Effekt darauf, überhaupt gefunden zu werden.
- Laut Google brauchen AI Overviews und AI Mode keine speziellen Dateien oder Schemas: Eine Seite muss indexiert sein und als Snippet erscheinen dürfen, die SEO-Grundlagen sind also die Eintrittskarte.
- Mein Audit der 105 Seiten dieser Site lief über 12 Prüfungen und brachte 7 Fixes, vor allem Discovery-Links, ehrliche Datumsangaben und eine Möglichkeit, KI-Crawler-Traffic zu sehen; der Code dazu steht unten.
Generative Engine Optimization (GEO) ist die Praxis, Inhalte so zu gestalten, dass KI-Antwortmaschinen wie Google AI Overviews und AI Mode, die ChatGPT-Suche, Perplexity und Copilot sie leicht finden, abrufen, zitieren und als Quelle nennen. Wo SEO auf eine Position in einer Liste von Links optimiert, optimiert GEO darauf, eine der wenigen Quellen zu sein, aus denen eine Antwort gebaut wird. Der Begriff stammt aus einem Forschungspaper von 2023, das auf der KDD 2024 vorgestellt wurde.
Dieser Beitrag hat zwei Hälften: was die Belege stützen, und das ist weniger, als die meisten GEO-Ratgeber behaupten, und ein vollständiges GEO-Audit dieser Site, eines statischen Nuxt-Builds mit 105 Seiten in drei Sprachen. Das Audit lief über 12 Prüfungen und brachte 7 Fixes; der Code zu jedem steht unten, und die Checkliste am Ende ist die, die ich auf jeder Site laufen lassen würde.
Was ist Generative Engine Optimization?
Eine generative Suchmaschine sortiert keine zehn Links. Sie entscheidet, ob eine Frage überhaupt eine Websuche braucht, schickt eine oder mehrere Anfragen los (Google nennt das Query Fan-out), holt Kandidatenseiten aus einem Index, wählt Passagen für den Kontext des Modells aus, schreibt die Antwort und nennt einige ihrer Quellen. An jedem dieser Schritte kann eine Seite herausfallen, und jeder Schritt hat andere Hebel.
| SEO | GEO | |
|---|---|---|
| Ziel | Eine hohe Position in einer Liste von Links | Eine der wenigen Quellen sein, aus denen eine Antwort gebaut wird |
| Einheit | Die Seite | Die Passage oder Tatsache, die zitiert wird |
| Erfolgsmaß | Position, Klicks | Zitate, Erwähnungen, Referral-Besuche |
| Gemessen mit | Search Console, Analytics | Bing AI Performance, Server-Logs, wiederholte Prompts |
GEO ersetzt SEO nicht. Für die KI-Funktionen von Google setzt es darauf auf: Eine Seite, die nicht indexiert ist, kann nicht zitiert werden.
Was zeigt die Forschung wirklich?
Das Gründungspaper ist GEO: Generative Engine Optimization von Pranjal Aggarwal und Kollegen aus Princeton und weiteren Instituten, zuerst im November 2023 veröffentlicht und für die KDD 2024 angenommen. Sie bauten GEO-bench, einen Benchmark aus 10.000 Anfragen, schrieben Quellseiten mit neun verschiedenen Methoden um und maßen, wie sichtbar jede Quelle in der generierten Antwort wurde.
- Zitate, Statistiken und genannte Quellen wirken. Die besten Methoden lagen beim positionsgewichteten Wortanteil 41 % und bei einem subjektiven Eindruckswert 28 % über der nicht optimierten Basis; die Schlagzeilenzahl lautet „bis zu 40 %“.
- Keyword-Stuffing wirkt nicht. Mehr Suchbegriffe einzubauen, der klassische SEO-Griff, lag unter der Basis.
- Schlechter platzierte Seiten gewinnen am meisten. Quellenangaben steigerten die Sichtbarkeit von Seiten auf Platz fünf der Suchergebnisse um 115,1 %, während Seiten auf Platz eins im Schnitt 30,3 % verloren.
- Es trug auch auf einer echten Maschine. Auf Perplexity.ai steigerten dieselben Methoden die Sichtbarkeit um bis zu 37 %.
Dann kamen die Einschränkungen. Olivier Martinez argumentiert in seiner kritischen Übersicht über 45 GEO-Studien (Juli 2026), dass GEO keine einzelne Ranking-Aufgabe ist, sondern eine verrauschte Pipeline, und dass die Gewinne des Gründungspapers in dessen Versuchsaufbau gelten, aber voraussetzen, dass eine Quelle bereits in einem festen Kontext liegt. In den untersuchten Arbeiten waren thematische Relevanz und die Position im Kontext die am besten reproduzierbaren Hebel. Generische Umschreibheuristiken ließen sich schlecht übertragen, auf Zitate zielende Umschreibungen konnten sogar das Abrufen verschlechtern, und keine Technik zeigte einen stabilen, langfristigen, plattformübergreifenden Effekt darauf, überhaupt gefunden zu werden.
Ein Paper von Tian und Kollegen vom März 2026 zeigt von der anderen Seite in dieselbe Richtung. Statt auf jede Seite dieselbe Umschreibung anzuwenden, diagnostiziert ihr System AgentGEO, warum ein bestimmtes Dokument nicht zitiert wird, und repariert genau das. Es steigerte die Zitierrate relativ um über 40 %, bei rund 5 % geändertem Inhalt, und die Autoren fanden, dass generische Optimierung Long-Tail-Inhalten schaden kann.
Was sagen Google, OpenAI und Microsoft?
Die Dokumentation der Plattformen selbst ist kurz und stimmig.
- Google sagt, es gibt keine zusätzlichen Anforderungen für AI Overviews oder AI Mode: Eine Seite muss indexiert sein und mit Snippet angezeigt werden dürfen. Du brauchst keine neuen maschinenlesbaren Dateien, keine KI-Textdateien und kein spezielles schema.org-Markup; strukturierte Daten müssen zum sichtbaren Text passen; und
nosnippet,data-nosnippet,max-snippetundnoindexsteuern, was gezeigt wird. Beide Funktionen können Query Fan-out nutzen, und ihr Traffic zählt in der Search Console zum Suchtyp „Web“. - OpenAI nutzt OAI-SearchBot für die ChatGPT-Suche und GPTBot fürs Training, und beide Einstellungen sind unabhängig. Sites, die OAI-SearchBot sperren, erscheinen nicht in Antworten der ChatGPT-Suche, abgesehen von Navigationslinks, und eine Änderung an der robots.txt braucht rund 24 Stunden.
- Microsoft hat am 10. Februar 2026 AI Performance als Public Preview in die Bing Webmaster Tools eingebaut. Der Bericht zeigt die Zitate in Copilot und in den KI-Antworten von Bing, die durchschnittliche Zahl zitierter Seiten, die Grounding-Queries, mit denen die KI Inhalte abgerufen hat, und Zitate pro URL.
Bemerkenswert ist, was Google weglässt: llms.txt und Markdown-Kopien braucht man nicht, um in seinen KI-Funktionen zu erscheinen. Sie bedienen Agenten, die Seiten direkt abrufen, und das ist ein anderes Publikum; mein Beitrag zu llms.txt versus Markdown Content Negotiation hat die Log-Daten dazu. Auf einer statischen Site kosten sie wenig, also behalte ich sie, zähle sie aber nicht als Ranking-Hebel.
Wie ich das Audit durchgeführt habe
Ich habe das Audit auf dem Produktions-Build laufen lassen, nicht auf dem Quellcode: nuxt generate schreibt 105 statische HTML-Seiten (35 Seiten auf Englisch, Deutsch und Ungarisch), und ein Post-Build-Schritt schreibt eine Markdown-Kopie jeder Seite plus /llms.txt. Zwei kleine Node-Skripte gingen dann durch die Ausgabe.
- Technisches Audit über jede generierte HTML-Datei: Titel und Beschreibung, Canonical und hreflang, Robots-Direktiven, Markdown- und llms.txt-Links, der JSON-LD-Graph (Knotentypen und Datumsangaben), ein h1 pro Seite und ob die Markdown-Kopie existiert.
- Inhaltliches Audit über die 24 englischen Beiträge in der Blog-Datenbank: Definiert der erste Satz das Thema, wie viele Quellen und Inline-Zitate, wie viele Zahlen, gibt es Key Takeaways und ein FAQ, und wie viele h2-Überschriften sind Fragen.
// GEO audit over the generated site (excerpt): one pass over every HTML file
for (const file of htmlFiles) {
  const html = readFileSync(file, 'utf8')
  if (!/type="text\/markdown"/.test(html)) add('no rel=alternate text/markdown', page)
  if (!/rel="describedby"/.test(html)) add('no rel=describedby llms.txt', page)
  const robots = html.match(/<meta name="robots" content="([^"]*)"/)?.[1] ?? ''
  if (!robots.includes('max-snippet')) add('robots without max-snippet', page)
  for (const node of jsonLdGraph(html))
    if (/WebPage|CollectionPage|ProfilePage/.test(node['@type']) && !node.dateModified) add('page node without a date', page)
}
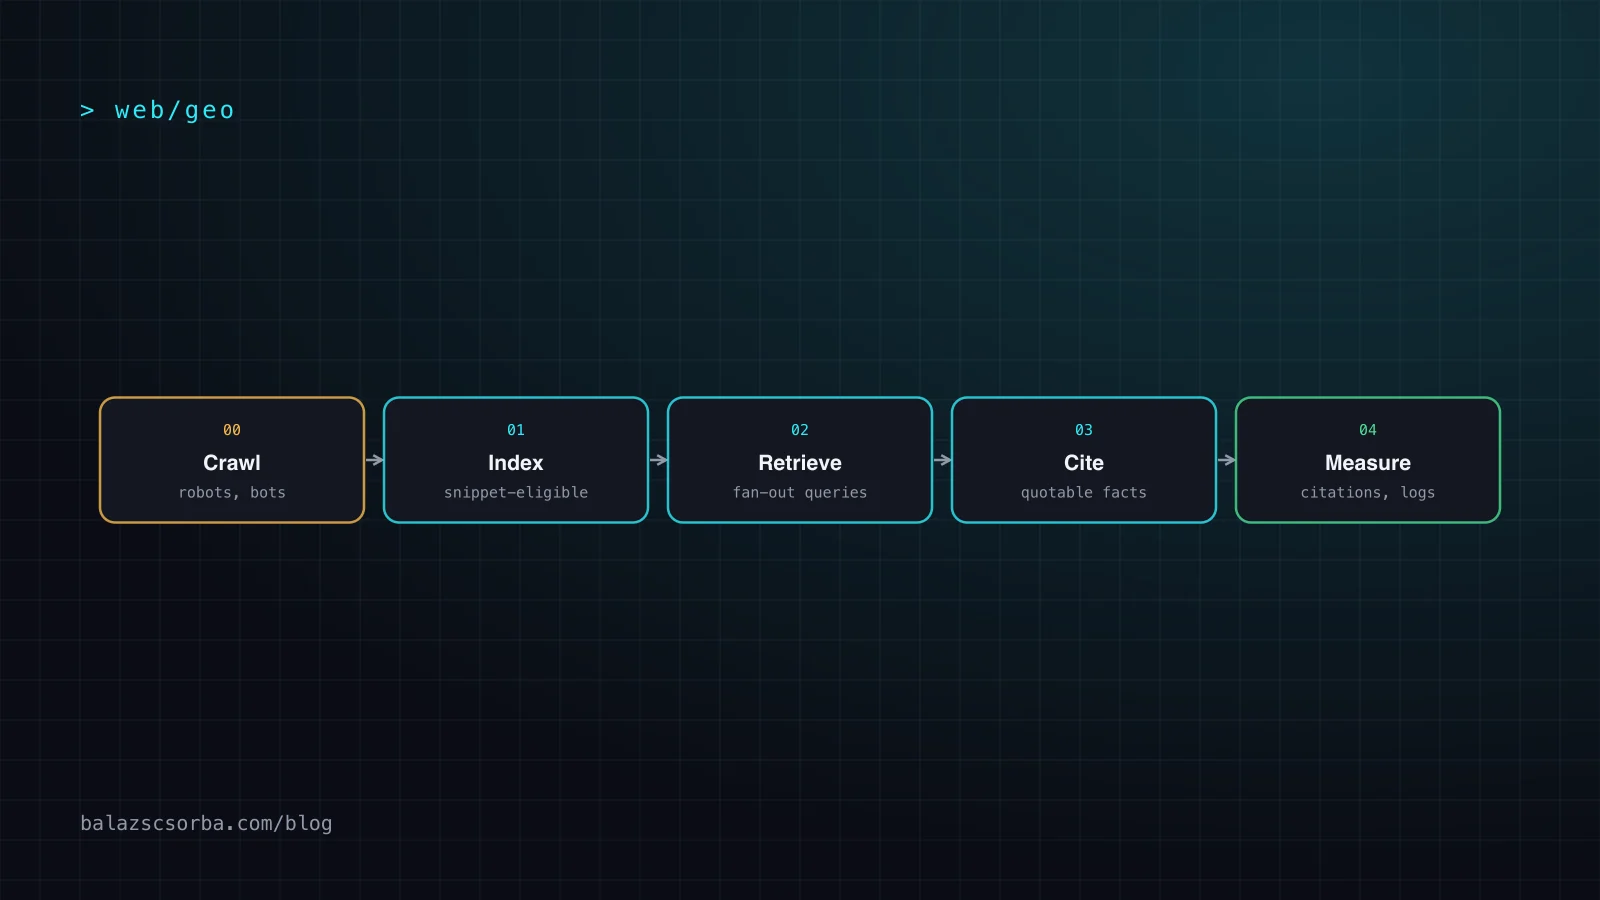
Die Prüfungen folgen der Pipeline im Diagramm: Zugang, Auffindbarkeit, Verständnis, Inhalt und Messung. Die Ergebnisse unten stehen in derselben Reihenfolge.
Was hat das Audit gefunden?
| Prüfung | Vorher | Nachher |
|---|---|---|
| KI-Crawler erlaubt | Bestanden: robots.txt erlaubt allen den Zugriff und nennt 16 KI-User-Agents; TDMRep erlaubt Text- und Data-Mining | Unverändert |
| Snippet-Berechtigung | Indexierbar, aber 33 von 105 Seiten setzten keine max-snippet-Direktive | max-snippet:-1 auf jeder indexierbaren Seite |
| Markdown-Kopie pro Seite | Bestanden: 105 von 105 | Unverändert |
Markdown-Discovery (rel="alternate") | 21 von 105 Seiten; kein Blogbeitrag und keine Expertise-Seite hatte ihn | Jede Seite, plus ein HTTP-Link-Header |
llms.txt-Discovery (rel="describedby") | 0 von 105; llms.txt war als rel="alternate" type="text/plain" verlinkt | Jede Seite, plus der Link-Header |
| Entitätsgraph (JSON-LD) | Bestanden: Person, WebSite, WebPage und BreadcrumbList auf jeder Seite; BlogPosting, FAQPage, Zitate und speakable bei Beiträgen | Unverändert |
| Datum an Seitenknoten | 0 von 105 WebPage-Knoten hatten ein Datum | Beiträge und der Blog-Index tragen datePublished und dateModified |
| Sitemap-lastmod | Jede statische Seite mit dem Build-Datum gestempelt | lastmod nur dort, wo es ein echtes Datum gibt |
| Zitierfähige Zusammenfassung | Key Takeaways als speakable markiert, aber nicht im Schema | abstract aus den Takeaways |
| Antwort zuerst | 21 von 24 Beiträgen beginnen mit einer Definition; 3 sind Erfahrungsberichte in der Ich-Form | So belassen |
| Quellen | Median von 6 Quellen pro Beitrag; 3 Beiträge nennen weniger als 4 | Für die nächste Überarbeitung notiert |
| Sichtbarkeit von KI-Crawlern | Keine: Analytics lädt erst nach Einwilligung, und Crawler führen kein JavaScript aus | Ein eigenes nginx-Log für KI-Agenten, mit dem Accept-Header |
Das Audit markierte außerdem rund 30 Seitentitel und Beschreibungen, die länger sind, als Suchergebnisse anzeigen. Das ist Snippet-Hygiene, kein GEO, und das hebe ich mir für einen eigenen Durchgang auf. Die inhaltliche Seite hielt, weil die Beiträge von Anfang an nach einer Vorlage mit Takeaways, FAQ und Quellenliste geschrieben wurden; die Lücken lagen fast alle in der Technik.
Die Fixes, Schritt für Schritt
Jede Seite verlinkt ihre Markdown-Kopie und llms.txt
Version 2 von llms.txt beantwortet die Frage, wie ein Agent die Markdown-Version einer Seite findet, mit zwei Standard-Link-Relationen: rel="alternate" type="text/markdown" für die Markdown-Kopie und rel="describedby" für die llms.txt, die die Seite abdeckt, entweder als HTML-Link-Elemente oder als HTTP-Link-Header. Die Site hatte ein Plugin für die erste Relation, beschränkt auf sieben Seiten der obersten Ebene. Jetzt deckt es jede Seite mit Kopie ab, Fehlerseiten ausgenommen:
// app/plugins/agent-links.ts (excerpt)
const PAGE = /^(\/(about|references|game|accessibility|privacy|imprint|blog)|\/(blog|expertise)\/[a-z0-9-]+)?$/

if (!m || error.value || !PAGE.test(page)) return {}
return {
  link: [
    { key: 'markdown', rel: 'alternate', type: 'text/markdown', href: page ? `${prefix}${page}.md` : `${prefix}/index.md` },
    { key: 'llms-txt', rel: 'describedby', href: '/llms.txt', title: 'llms.txt' },
  ],
}
Dasselbe Paar geht auch als HTTP-Header raus, damit ein Client, der nur einen HEAD-Request schickt, es ebenfalls sieht. Ein nginx-Detail brauchte einen zweiten Blick: try_files ändert $uri auf /about/index.html, bevor die Header geschrieben werden, also liefert eine Map auf $uri für die meisten Seiten nichts. Eine Map auf $request_uri umgeht das:
# Keyed on $request_uri: try_files changes $uri to /page/index.html before the headers go out
map $request_uri $bc_agent_links {
  default                                  "";
  "~^/(\?.*)?$"                            '</index.md>; rel="alternate"; type="text/markdown", </llms.txt>; rel="describedby"';
  "~^(?<p>/[a-z0-9/-]*[a-z0-9])(\?.*)?$"   '<$p.md>; rel="alternate"; type="text/markdown", </llms.txt>; rel="describedby"';
}

location / {
  add_header Link $bc_agent_links;   # an empty value sends no header
  # ...
}
Snippet-Direktiven und ehrliche Datumsangaben
Google verwendet eine Seite in AI Overviews nur, wenn es ein Snippet zeigen darf. Snippets sind standardmäßig erlaubt, also ändert max-snippet:-1 im Prinzip nichts, aber es macht die Absicht auf jeder Seite explizit und entspricht dem, was die Blogbeiträge schon gesendet haben.
Die Datumsangaben waren die interessantere Lücke. Die Sitemap gab jeder statischen Seite das Datum des Builds, und das ist ein falsches Aktualitätssignal: Google verwendet lastmod nach eigener Aussage nur, wenn der Wert durchgängig und überprüfbar korrekt ist. Statische Seiten haben jetzt gar kein lastmod mehr, und nur die Beiträge und der Blog-Index, die echte Datumsangaben haben, tragen datePublished und dateModified in ihren strukturierten Daten. Kein Datum ist besser als ein falsches.
Eine zitierfähige Zusammenfassung in den strukturierten Daten
Jeder Beitrag beginnt mit fünf Key Takeaways, geschrieben als Sätze, die für sich stehen. Sie waren schon als speakable markiert, und die Quellen des Beitrags standen schon als citation im Schema. Jetzt gehen die Takeaways auch in das abstract des BlogPosting, damit ein System, das das JSON-LD liest, die Zusammenfassung bekommt, ohne die Seite zu parsen:
{
  "@type": "BlogPosting",
  "headline": "Generative engine optimization in practice: …",
  "abstract": "Generative engine optimization (GEO) means … (the five key takeaways)",
  "datePublished": "2026-09-28",
  "dateModified": "2026-09-28",
  "citation": [{ "@type": "CreativeWork", "name": "GEO: Generative Engine Optimization", "url": "https://arxiv.org/abs/2311.09735" }],
  "speakable": { "@type": "SpeakableSpecification", "cssSelector": ["#takeaways"] }
}
Messen, was KI-Crawler abrufen
Was du nicht siehst, kannst du nicht verbessern, und diese Site konnte KI-Crawler überhaupt nicht sehen: Google Analytics lädt erst nach der Cookie-Einwilligung, und Crawler führen ohnehin kein JavaScript aus. Das Server-Log ist die einzige ehrliche Quelle. nginx schreibt Requests von 16 KI-User-Agent-Mustern jetzt in ein eigenes Log, mit dem Accept-Header, so dass es zeigt, welche Seiten sie abrufen und wer nach Markdown fragt:
# http context: which requests come from AI crawlers and agents
map $http_user_agent $bc_ai_agent {
  default 0;
  "~*(GPTBot|OAI-SearchBot|ChatGPT-User|ClaudeBot|Claude-SearchBot|Claude-User|PerplexityBot|Perplexity-User|…)" 1;
}
log_format bc_agents '$time_iso8601 $status $request_method $host$request_uri -> $uri $body_bytes_sent "$http_accept" "$http_user_agent"';

# server block: an access_log here replaces the inherited one, so the default is repeated
access_log /var/log/nginx/access.log;
access_log /var/log/nginx/balazscsorba-agents.log bc_agents if=$bc_ai_agent;
Für den Anfang reichen zwei Befehle:
# The pages AI agents fetch most (after negotiation, so /about.md means "asked for Markdown")
awk '{print $6}' /var/log/nginx/balazscsorba-agents.log | sort | uniq -c | sort -rn | head -20
# Requests per agent
grep -oE '(GPTBot|OAI-SearchBot|ChatGPT-User|ClaudeBot|Claude-SearchBot|Claude-User|PerplexityBot|Perplexity-User)' \
  /var/log/nginx/balazscsorba-agents.log | sort | uniq -c | sort -rn
Server-Logs zeigen das Crawlen, nicht das Zitieren. Für Zitate ist der AI-Performance-Bericht in den Bing Webmaster Tools die einzige Zahl aus erster Hand; die Search Console rechnet AI Overviews und AI Mode in ihre Web-Summen ein; und Referrals von chatgpt.com, perplexity.ai und copilot.microsoft.com tauchen in der Analyse auf wie jeder andere Referrer. Darüber hinaus gilt der Rat der Übersichtsarbeit: dieselben Prompts über die Zeit wiederholen, mit Umformulierungen, weil einzelne Antworten von Durchlauf zu Durchlauf schwanken.
Was ich bewusst nicht gemacht habe
- Kein Keyword-Stuffing. Es lag im ursprünglichen GEO-Paper unter dem Wert ohne jede Optimierung.
- Keine pauschale Überarbeitung aller 24 Beiträge. Generische Umschreibregeln lassen sich laut der Übersichtsarbeit schlecht übertragen und können das Abrufen verschlechtern. Die drei Beiträge mit wenigen Quellen bekommen mehr, wenn sie das nächste Mal überarbeitet werden, der Leserinnen und Leser wegen.
- Kein versteckter Text für Sprachmodelle. Text, der nur für KI-Systeme gedacht ist, ist Cloaking unter anderem Namen und nutzt denselben Trick wie Prompt Injection. Alles, was ein Modell auf dieser Site lesen kann, kann auch ein Mensch lesen.
- Keine strukturierten Daten, die nicht auf der Seite stehen. Google verlangt Markup, das zum sichtbaren Text passt; das FAQ im Schema ist das FAQ, das du siehst.
- Keine erfundenen Entitätsdaten. Der Person-Knoten nennt nur Profile, die es gibt. Weitere sameAs-Links stehen auf meiner Liste, aber nur für Konten, die ich wirklich nutze.
Checkliste für ein GEO-Audit
- Lass die Antwortmaschinen rein. Die robots.txt erlaubt OAI-SearchBot, Claude-SearchBot, PerplexityBot und die anderen, und kein Bot-Filter im CDN hebelt das aus.
- Sei indexiert und für Snippets zugelassen. Kein verirrtes noindex oder nosnippet; prüfe in der Search Console und in den Bing Webmaster Tools.
- Liefere den Inhalt als HTML. Crawler, die kein JavaScript ausführen, müssen den Text sehen; statisches oder serverseitiges Rendering sorgt dafür.
- Beginne mit der Antwort. Der erste Satz einer Seite definiert ihr Thema in den Worten, nach denen jemand suchen würde.
- Formuliere Aussagen konkret und mit Quelle. Zahlen, Daten, genannte Quellen und Links sind der Teil von GEO, den die Forschung am besten stützt.
- Halte strukturierte Daten wahr. Ein zusammenhängender Entitätsgraph, Markup, das zum sichtbaren Text passt, und Datumsangaben nur dort, wo sie echt sind.
- Biete eine saubere Kopie an. Eine Markdown-Version jeder Seite, verlinkt mit rel="alternate", und eine llms.txt, verlinkt mit rel="describedby".
- Logge KI-Crawler getrennt. Ein Server-Log mit User-Agent und Accept-Header, keine clientseitige Analyse.
- Verfolge Zitate, nicht nur Rankings. Bing AI Performance, Search Console und Referral-Traffic, über Wochen beobachtet.
- Lass das Audit nach jedem Build wieder laufen. Die Prüfungen sind Skripte, also fällt eine Regression noch am selben Tag auf.
Für die Agenten-Seite derselben Arbeit siehe llms.txt versus Markdown Content Negotiation und den Leitfaden zu WebMCP auf einer echten Site. Wenn du dieses Audit für deine eigene Site willst, melde dich.
Quellen
- Aggarwal et al.: GEO: Generative Engine Optimization (KDD 2024)
- Martinez: Optimizing Visibility in Generative Engines, a critical survey of GEO 2023–2026 (July 2026)
- Tian et al.: Diagnosing and Repairing Citation Failures in Generative Engine Optimization (March 2026)
- Google Search Central: AI features and your website
- Google Search Central: Build and submit a sitemap
- OpenAI: Overview of OpenAI crawlers
- Bing Webmaster Blog: Introducing AI Performance in Bing Webmaster Tools (10 February 2026)
- llmstxt.org: Changes from v1 to v2
Häufige Fragen
Was ist Generative Engine Optimization (GEO)?
Generative Engine Optimization ist die Praxis, Inhalte so zu gestalten, dass KI-Antwortmaschinen wie Google AI Overviews und AI Mode, die ChatGPT-Suche, Perplexity und Copilot sie leicht abrufen, zitieren und als Quelle nennen. Der Begriff stammt aus einem Paper von Aggarwal et al., zuerst im November 2023 veröffentlicht und auf der KDD 2024 vorgestellt. Es zeigte, dass Zitate, Statistiken und genannte Quellen die Sichtbarkeit einer Seite in generierten Antworten um bis zu 40 % steigern können.
Ist GEO etwas anderes als SEO?
Es baut auf SEO auf, statt es zu ersetzen. SEO zielt auf eine hohe Position in einer Liste von Links; GEO zielt darauf, eine der wenigen Quellen zu sein, aus denen eine Antwort gebaut wird, die Einheit ist also die zitierfähige Passage statt der Seite. Für die KI-Funktionen von Google gelten dieselben Eintrittsbedingungen wie für die Suche: Die Seite muss indexiert sein und als Snippet erscheinen dürfen.
Hilft llms.txt bei Generative Engine Optimization?
Nicht als Ranking-Signal. Google sagt, dass für AI Overviews und AI Mode keine KI-Textdateien oder spezielles Markup nötig sind, und Log-Studien zeigen, dass die meisten llms.txt-Dateien nie abgerufen werden. llms.txt und Markdown-Kopien helfen Agenten, die Seiten direkt abrufen, und das ist ein eigenes Publikum; auf einer statischen Site kosten sie wenig.
Welche inhaltlichen Änderungen bringen mehr KI-Zitate?
Am besten belegt sind konkrete, überprüfbare Aussagen: Statistiken, Zitate und Links auf glaubwürdige Quellen, in einem Text, der klar zur gestellten Frage passt. Keyword-Stuffing schnitt in der Originalstudie schlechter ab als gar keine Optimierung. Eine Übersichtsarbeit über 45 Studien aus 2026 warnt, dass diese Gewinne für bereits abgerufene Seiten gelten und generische Umschreibregeln schlecht übertragbar sind, also miss auf deinen eigenen Seiten.
Wie messe ich GEO-Ergebnisse?
Kombiniere drei Quellen. Der AI-Performance-Bericht in den Bing Webmaster Tools zeigt Zitate in Copilot und in den KI-Antworten von Bing pro Seite, samt den Grounding-Queries dahinter. Server-Logs zeigen, welche Seiten KI-Crawler abrufen. Referral-Traffic von chatgpt.com, perplexity.ai und ähnlichen Sites taucht in der Analyse auf. Generierte Antworten schwanken zwischen Durchläufen, also wiederhole dieselben Prompts über die Zeit, statt einer einzelnen Antwort zu trauen.