Blog/Web-Engineering
llms.txt versus Markdown Content Negotiation: was Agenten wirklich abrufen
llms.txt ist ein Vorschlag, Markdown Content Negotiation ein Header. Was KI-Agenten abrufen, was die Logs zeigen und wie man beides aus Nuxt und nginx ausliefert.
Balázs Csorba··9 Min. Lesezeit
- llms.txt
- Content negotiation
- AI agents
- Nuxt
Das Wichtigste in Kürze
- llms.txt ist ein handgeschriebener Markdown-Index im Wurzelverzeichnis einer Site; Version 2 des Formats kam im August 2026, und das Format selbst bleibt bewusst locker.
- Content Negotiation ist ein anderer Mechanismus: Der Client sendet Accept: text/markdown, der Server antwortet mit Content-Type: text/markdown und setzt Vary: Accept.
- Ahrefs fand, dass 97 % der veröffentlichten llms.txt-Dateien überhaupt keine Requests bekamen und 96 % der doch eingegangenen Requests von Bots kamen, angeführt von SEO-Audit-Tools.
- Eine zur Build-Zeit erzeugte Markdown-Kopie jeder Seite plus ein Rewrite der bevorzugten Requests im nginx reicht, um beides auszuliefern, und dieselben Dateien speisen /llms.txt und /llms-full.txt.
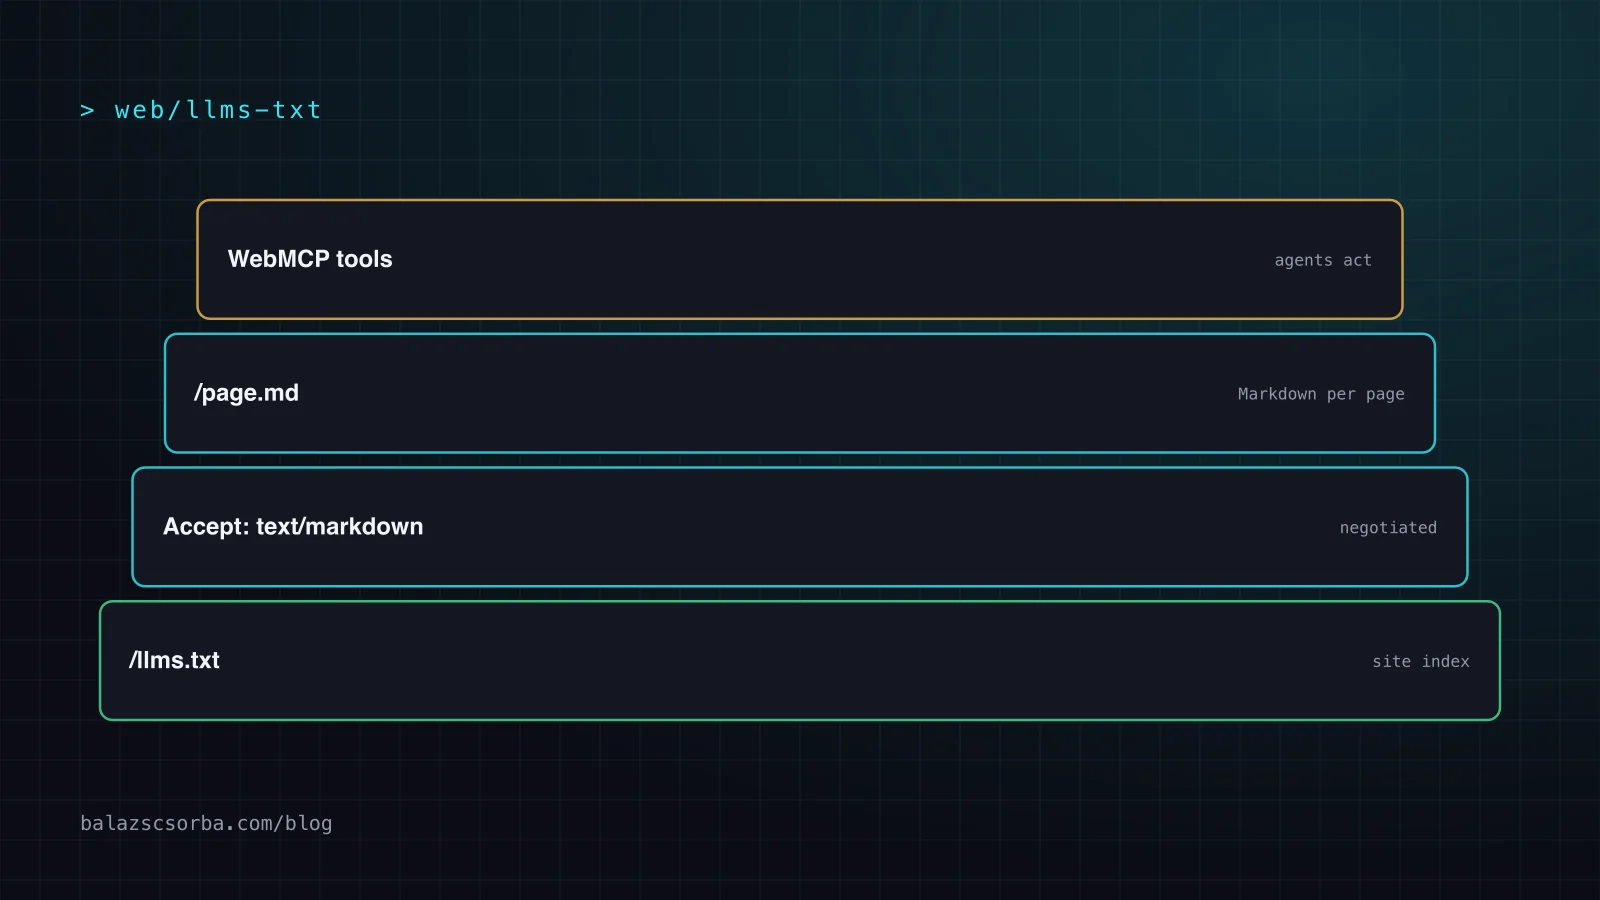
- llms.txt, Markdown-Antworten und WebMCP sind Schichten, keine Rivalen: ein Index, eine billige Repräsentation einer Seite und die Fähigkeit, auf der Site zu handeln.
llms.txt ist eine Markdown-Datei im Wurzelverzeichnis einer Website, die Sprachmodellen sagt, was die Seite enthält und wo die sauberen, rein textbasierten Versionen ihrer Unterseiten liegen. Markdown Content Negotiation ist ein anderer Mechanismus für ein ähnliches Ziel: Dieselbe URL antwortet mit Markdown statt HTML, wenn der Client Accept: text/markdown sendet. Beides wird oft als „SEO für KI" verkauft, und die Belege dafür, was Agenten tatsächlich abrufen, sind dünner als das Marketing.
Dieser Beitrag vergleicht die beiden, fasst die veröffentlichten Log-Studien zusammen und geht durch, wie diese Site beides in einem statischen Nuxt-Build hinter schlichtem nginx umsetzt, ganz ohne CDN-Feature. Du bekommst die nginx-Konfiguration, den Build-Schritt und eine Checkliste.
Was ist llms.txt, und was hat sich in Version 2 geändert?
llms.txt ist ein Vorschlag von Jeremy Howard für einen Markdown-Index einer Website, ausgeliefert unter /llms.txt, mit Links auf Markdown-Kopien der Seiten. Version 1 erschien am 3. September 2024, Version 2 folgte am 10. August 2026 (llmstxt.org).
Das Format ist bewusst locker. Ein H1 mit dem Namen der Seite ist der einzige verpflichtende Teil. Darauf folgt ein Blockquote mit einer kurzen Zusammenfassung, optionalem Freitext und beliebig vielen H2-Abschnitten, jeder eine Liste aus Markdown-Links. Ein Abschnitt namens „Optional" ist per Konvention die Liste, die ein Agent überspringen kann, wenn er einen kürzeren Kontext braucht. Der Vorschlag verlangt außerdem eine saubere Markdown-Kopie jeder Seite, entweder unter page.md oder page.html.md, und index.md für URLs ohne Dateinamen.
Die v2-Änderungen sind praktisch und nicht konzeptionell:
- Auffinden über Link-Relationen.
rel="alternate" type="text/markdown"zeigt von einer Seite auf ihre Markdown-Kopie,rel="describedby"auf die llms.txt, die sie abdeckt. - Beide URL-Stile sind erlaubt:
.mdangehängt oder die Endung ersetzt. - Unterpfade können ihre eigene Datei haben; „the most specific file applies".
- Ein einfacheres Modell für die Nutzung: Agenten sehen sich die llms.txt an oder durchsuchen sie und folgen dann den Links, die sie brauchen. Der Abschnitt „Optional" hat keine maschinelle Semantik mehr.
Bemerkenswert: Der Vorschlag nutzt HTTP Content Negotiation überhaupt nicht. Er setzt auf Dateien an bekannten Pfaden und auf Links.
Wie funktioniert Markdown Content Negotiation?
Der Client listet die Medientypen, die er will, im Request-Header Accept, und der Server wählt eine Repräsentation derselben Ressource aus. Steht text/markdown beim Client an erster Stelle, gibt ein Server, der das unterstützt, Markdown mit Content-Type: text/markdown zurück und setzt Vary: Accept, damit Caches die beiden Versionen auseinanderhalten.
Cloudflare hat das im Februar 2026 als Zone-Feature namens Markdown for Agents ausgeliefert (Changelog). Trägt ein Request Accept: text/markdown, holt Cloudflare das HTML vom Origin, konvertiert es und gibt Markdown zurück (Cloudflare-Doku). Die dokumentierten Details sind auch dann nützlich, wenn du Cloudflare nicht nutzt:
- Ein
x-markdown-tokens-Header schätzt die Größe des Markdowns in Tokens,x-original-tokensdie des HTML. Die Beispielseite aus der Dokumentation sinkt von 12.345 auf 725 Tokens. VarybekommtAccept;ETagundLast-Modifiedfallen weg, weil bedingte Requests bei konvertierten Antworten nicht bedient werden können.- Setzt der Origin kein
Content-Signal, gilt der Defaultai-train=yes, search=yes, ai-input=yes. - Die Origin-Antwort darf 2 MB nicht überschreiten, und das Feature braucht einen Pro-, Business- oder Enterprise-Tarif.
Token-Einsparungen dieser Größenordnung sind das eigentliche Argument für Markdown. Ein Agent, der deine Seite über ein Fetch-Tool liest, bezahlt bei jedem Aufruf für Navigation, Scripts, Inline-SVG und Klassennamen. Eine Markdown-Kopie ist der Inhalt und nichts sonst.
Was rufen KI-Agenten tatsächlich ab?
Die veröffentlichten Belege sagen: Coding-Agenten fragen zunehmend nach Markdown, und llms.txt liest fast niemand. Beide Befunde kommen mit Einschränkungen, aber sie zeigen in dieselbe Richtung.
llms.txt wird fast nicht gelesen. Ahrefs hat Server-Log-Daten von 137.210 Domains mit Traffic im Mai 2026 ausgewertet (Ahrefs, Juni 2026). Rund 38.000 davon, 28 %, hatten eine llms.txt veröffentlicht, doch 97 % dieser Dateien bekamen null Requests. Von den Requests, die ankamen, kamen 96 % von Bots, angeführt von SEO-Audit-Tools; KI-Retrieval-Bots machten 1,1 % aus. Und für llms.txt-Dateien, die es nicht gibt, kamen null Requests von KI-Bots: in den Worten von Ahrefs, „they never go looking".
Einige Agenten senden tatsächlich Accept: text/markdown. In einem Test von Februar 2026 mit sieben Coding-Agenten fand Checkly drei, die zuerst nach Markdown fragen: Claude Code (text/markdown, text/html, */*), Cursor und OpenCode. OpenAI Codex, Gemini CLI, GitHub Copilot und Windsurf schickten generische HTML- oder Wildcard-Header (Checkly). Agent-Versionen wechseln schnell, behandle das also als Schnappschuss.
Die Logs einer einzelnen Site. Eine Untersuchung von Cloudflares Feature auf einer einzigen Site zählte über 44 Tage 1.421 Markdown-Requests (7. März bis 19. April 2026), davon 500 aus Anthropics Infrastruktur und 639 aus headless Chrome (Suganthan). Der Autor sagt ausdrücklich, das belege nicht, dass „AI crawlers prefer markdown over HTML", und auch nicht, dass das Ausliefern mehr Zitate einbringt. Es ist eine Site; rechne das nicht hoch.
Meine Lesart: Crawler, die Such- und Trainingsindizes bauen, holen HTML, wie schon immer. Agenten, die in Echtzeit für einen Menschen handeln, besonders Coding-Agenten mit einem Fetch-Tool, sind der Ort, an dem Markdown sich auszahlt. Traffic-Zahlen für diese Site veröffentliche ich nicht, also stehen hier keine.
| Mechanismus | Wie ein Agent ihn findet | Was er zurückgibt | Belege für die Nutzung |
|---|---|---|---|
/llms.txt | Bekannter Pfad, oder rel="describedby" | Index der Seiten mit Kurzbeschreibungen | Schwach: 97 % der Dateien im Ahrefs-Sample ungelesen |
page.md-Kopie | Link aus der llms.txt, oder bekanntes Suffix | Eine Seite als Markdown | Nur wenn etwas darauf verlinkt |
Accept: text/markdown | Gleiche URL, Request-Header | Eine Seite als Markdown | Von manchen Coding-Agenten gesendet (Checkly, Februar 2026) |
rel="alternate"-Link | Im HTML-Head | Zeiger auf die .md-Kopie | Neu in llms.txt v2; noch keine Daten |
| WebMCP-Tools | Vom Browser aus von der Seite registriert | Typisierte Tool-Ergebnisse | Chrome Origin Trial; frühes Stadium |
Wie diese Site es mit Nuxt und nginx umsetzt
Diese Site erzeugt zur Build-Zeit eine Markdown-Kopie jeder Seite, liefert sie unter einer .md-URL aus und leitet im nginx Requests, die Markdown bevorzugen, auf diese Kopie um. Dieselben Dateien speisen /llms.txt und /llms-full.txt.
Der Build-Schritt: das erzeugte HTML konvertieren
Nachdem nuxt generate statisches HTML geschrieben hat, liest ein Post-Build-Skript (scripts/build-agent-files.mjs) das <main>-Element jeder Seite und konvertiert es mit der Turndown-Bibliothek. Das Konvertieren des fertigen HTML, statt separate Markdown-Quellen zu pflegen, heißt: Das Markdown sagt immer genau das, was die Seite sagt. Ein paar Regeln erledigen den eigentlichen Job:
- Scripts, Styles, SVG, canvas, Buttons und Formulare fallen weg. Deshalb trägt jedes Diagramm auf dieser Site in seiner Bildunterschrift eine vollständige Textbeschreibung: Die Markdown-Kopie behält nur Wörter.
- Links und Bilder werden zu absoluten URLs, damit eine in den Modellkontext kopierte Fassung noch auf etwas zeigt.
- Der Text folgt dem, was ein Screenreader vorliest: mit
aria-hiddenmarkierte Elemente fliegen raus, visuell versteckter Text bleibt. - Jede Datei beginnt mit einem kurzen Header: der Seitenbeschreibung, ihrer kanonischen Web-URL, ihrer Sprache und den anderen Sprachversionen, bei Blogbeiträgen zusätzlich Autor, Daten und Keywords.
Derselbe Durchlauf schreibt /llms.txt mit Abschnitten für Seiten, Blogbeiträge (mit Daten und Keywords), die deutsche und die ungarische Version sowie eine „Optional"-Liste, und /llms-full.txt mit jeder englischen Seite in voller Länge.
Der nginx-Teil: Content Negotiation ohne CDN
Zwei map-Blöcke entscheiden, ob ein Request Markdown möchte, und zu welcher HTML-Seite eine Markdown-Datei gehört:
# Accept: text/markdown listed first, or present without text/html
map $http_accept $bc_md {
  default                             "";
  "~*^\s*text/markdown"               1;
  "~*^(?!.*text/html).*text/markdown" 1;
}

# The HTML page a Markdown copy belongs to (sent as its canonical URL)
map $uri $bc_md_page {
  default                  "";
  "/index.md"              /;
  "~^(?<p>/.+)/index\.md$" $p;
  "~^(?<p>/.+)\.md$"       $p;
}
Die HTML-Location schreibt auf die .md-Datei um, wenn der Map gematcht hat, und beide Locations senden Vary: Accept:
location ~ \.md$ {
  default_type text/markdown;
  add_header Link "<https://balazscsorba.com$bc_md_page>; rel=\"canonical\"";
  add_header Vary "Accept";
  try_files $uri =404;
}

location / {
  if ($bc_md) {
    rewrite ^/$ /index.md last;
    rewrite ^/(de|hu)$ /$1/index.md last;
    rewrite ^(/[a-z0-9/-]*[a-z0-9])$ $1.md last;
  }
  add_header Vary "Accept";
  try_files $uri $uri/index.html $uri/ =404;
} Der Link: rel="canonical"-Header auf der Markdown-Antwort zeigt Suchmaschinen zurück auf die HTML-Seite, damit die Kopie nicht als Duplicate Content mit ihr konkurriert. Bei nginx gibt es eine Falle: Sobald eine Location eigene add_header setzt, erbt sie keine aus dem Server-Block. Die Site hält ihre Security-Header in einer Include-Datei und zieht sie in jede Location, die Header ergänzt.
Auffindbarkeit und Erlaubnissignale
- Der Head jeder Seite verlinkt
/llms.txt; ein kleines Plugin (app/plugins/agent-links.ts) ergänzt auf den Top-Level-Seiten einenrel="alternate" type="text/markdown"-Link auf die Markdown-Kopie. robots.txterlaubt alle Crawler, listet die KI-User-Agents explizit auf und verweist auf llms.txt. Die Content-Signals-Zeile (search=yes, ai-input=yes, ai-train=yes) bleibt als Kommentar stehen, weil Validatoren nach RFC 9309 wie Lighthouse unbekannte Direktiven ablehnen; die maschinenlesbare Erlaubnis ist/.well-known/tdmrep.json(W3C TDMRep).- Browser-Agenten mit WebMCP können ein
get_page_content-Tool aufrufen, das dieselbe Markdown-Kopie mitAccept: text/markdownholt. Diese Ebene behandelt der WebMCP-Leitfaden.
Der Stack einer agentenfertigen Website
Denk diese Mechanismen als Schichten mit unterschiedlichem Publikum, nicht als Konkurrenten. Jede ist auf einer statischen Site billig, und jede bedient eine andere Art von Client.
Abwägungen und Fallstricke
Die Kosten sind klein, aber real: Caching, Duplicate Content und ein Header-Parser, der eine Heuristik ist und keine vollständige Implementierung der HTTP-Negotiation.
- Caches müssen
Vary: Acceptrespektieren. Ohne das kann ein CDN oder Proxy einem Browser Markdown und einem Agenten HTML liefern. Prüfe jede Cache-Schicht zwischen Origin und Client. - Die nginx-Map ignoriert q-Werte. Sie matcht „Markdown zuerst" oder „Markdown ohne HTML". Das deckt die von Checkly aufgezeichneten Header ab, aber ein Client, der
text/html;q=0.1, text/markdownsendet, bekommt HTML. Ein vollständiger Parser gehört in den Anwendungscode, wenn du einen brauchst. - Doppelte URLs. Die
.md-Kopie ist eine zweite URL für denselben Inhalt. Für die Suchmaschinen genügt ein kanonischerLink-Header; die Kopien gehören nicht in die Sitemap. - Drift zwischen den Versionen. Von Hand gepflegtes Markdown wird alt. Aus dem gebauten HTML erzeugt ist das Problem weg, um den Preis eines Build-Schritts.
- Erwarte nicht, dass llms.txt Rankings bewegt. Die Ahrefs-Daten sagen, dass es fast niemand liest. Veröffentliche es, weil es billig ist und den Tools nützt, die es doch lesen, nicht als Ranking-Wette.
Checkliste: llms.txt und Markdown für Agenten
- Erzeuge Markdown aus dem gerenderten HTML, eine Datei pro Seite, mit absoluten Links.
- Beschreibe jedes Diagramm in Worten; Konverter werfen SVG und canvas weg.
- Liefere die Kopien als
text/markdownaus, mit einem kanonischenLink-Header auf das HTML. - Negotiere über
Acceptauf derselben URL und sendeVary: Acceptbei beiden Repräsentationen. - Veröffentliche
/llms.txtmit einem Zusammenfassungs-Blockquote, einem Link pro Seite und einer „Optional"-Liste. - Ergänze
rel="alternate" type="text/markdown"im HTML-Head, wie llms.txt v2 vorschlägt. - Halte die Berechtigungen fest in robots.txt und einer maschinenlesbaren Datei wie TDMRep.
- Miss deine eigenen Logs, bevor du irgendetwas über Agent-Traffic behauptest.
Die nächste Schicht darüber ist, Agenten handeln zu lassen, nicht nur lesen: siehe den Leitfaden zu WebMCP an einer echten Site und für Shops den Vergleich der agentischen Commerce-Protokolle. Wenn du das auf deiner eigenen Site aufsetzen willst, schau dir AI Engineering an.
Quellen
- llmstxt.org: The /llms.txt file (Vorschlag, Version 2)
- llmstxt.org: Changes from v1 to v2
- Cloudflare-Changelog: Markdown for Agents (12. Februar 2026)
- Cloudflare-Doku: Markdown for Agents
- Ahrefs: 137K Sites analysiert, 97 % der llms.txt-Dateien werden nie gelesen (Juni 2026)
- Checkly: The current state of content negotiation for AI agents (Februar 2026)
- Suganthan: Cloudflare Markdown for Agents auf einer Site verfolgen
Häufige Fragen
Brauche ich 2026 noch llms.txt?
Deutlich weniger als zu dem Zeitpunkt, als der Vorschlag kam. Ahrefs hat im Mai 2026 Server-Logs von 137,210 Domains mit Traffic ausgewertet und gefunden, dass rund 28 % eine llms.txt veröffentlicht hatten, 97 % dieser Dateien aber null Requests bekamen und 96 % der eingegangenen Requests von Bots kamen, angeführt von SEO-Audit-Tools. Ein kurzes llms.txt kostet wenig; messbarer Traffic ist bei der Markdown Content Negotiation.
Wie funktioniert die Markdown Content Negotiation?
Der Client listet im Accept-Request-Header die Medientypen, die er verarbeiten kann, und steht text/markdown vorn, gibt ein Server, der das unterstützt, für dieselbe URL Markdown statt HTML zurück. Zwei Header machen das korrekt: Content-Type: text/markdown in der Antwort und Vary: Accept, damit Caches HTML- und Markdown-Version getrennt halten. Alles darüber hinaus ist Heuristik, keine vollständige HTTP-Negotiation.
Was sollte eine agentenfreundliche Website ausliefern?
Drei Schichten. Eine Markdown-Repräsentation jeder Seite, damit ein Client, der text/markdown anfragt, sauberen Text statt Markup bekommt. Ein Index wie /llms.txt und /llms-full.txt, der sagt, was die Site enthält und wo die sauberen Versionen liegen. Und deklarierte Tools wie WebMCP, wenn ein Agent auf der Site handeln und nicht nur lesen soll. Jede ist auf einer statischen Site billig und bedient eine andere Art von Client.
Hilft llms.txt bei der Sichtbarkeit in der KI-Suche?
Als Ranking-Hebel ist das unbewiesen, und die Traffic-Daten sprechen gegen eine Wette darauf. Messbar sind Tokenkosten und Parse-Fehler: Die Cloudflare-Doku zeigt eine Beispielseite, die von 12,345 auf 725 Tokens fällt, wenn sie als Markdown ausgeliefert wird. Das ist ein Gewinn für den Agenten, der deine Seite liest, aber keine Garantie, zitiert zu werden.
Wie liefere ich Markdown aus einer Nuxt-Site?
Erzeuge zur Build-Zeit neben dem HTML eine Markdown-Kopie jeder Seite, leite dann im nginx Requests, deren Accept-Header text/markdown bevorzugt, auf diese Datei um, und antworte immer mit Vary: Accept. Diese Site macht genau das, und dieselben generierten Dateien speisen /llms.txt und /llms-full.txt. Das Konvertieren des fertigen HTML mit Turndown hält das Markdown deckungsgleich mit der Seite.