Blog/Web-Engineering
LLM-Features in Nuxt ausliefern: Streaming, strukturierte Ausgabe, Tool-Freigabe
Nuxt AI von vorn bis hinten: eine Server-Route, die den API-Key hält, Message-Parts, strenge strukturierte Ausgabe, Tools mit Freigabe, Fehler und Artikel 50.
Balázs Csorba··9 Min. Lesezeit
- Nuxt
- AI SDK
- Streaming
- Structured output
- Tool approval
- Nitro
Das Wichtigste in Kürze
- Nuxt AI-Features gehören in eine Nitro-Server-Route: Der API-Key des Modells bleibt in runtimeConfig, der Aufruf beim Provider läuft auf dem Server, und @ai-sdk/vue rendert nur das Ergebnis.
- Eine gestreamte Antwort ist eine geordnete Liste von Message-Parts, kein wachsender String, und ein Tool-Aufruf erzeugt einen Part mit dem Präfix tool-, der für sich genommen keinen Text enthält.
- Strukturierte Ausgabe wird über die output-Option konfiguriert, und die Provider unterstützen nur eine Teilmenge von JSON Schema: kein minimum, maximum, minLength oder maxLength, und keine rekursiven Schemata.
- Die Tool-Freigabe in AI SDK 7 ist eine toolApproval-Policy auf dem Aufruf, und Freigaben sollten mit experimental_toolApprovalSecret signiert werden, weil der Client den Nachrichtenverlauf kontrolliert.
- Artikel 50 der EU AI Act gilt seit 2. August 2026: Ein Chatbot muss den Menschen spätestens bei der ersten Interaktion sagen, dass sie mit einer KI sprechen.
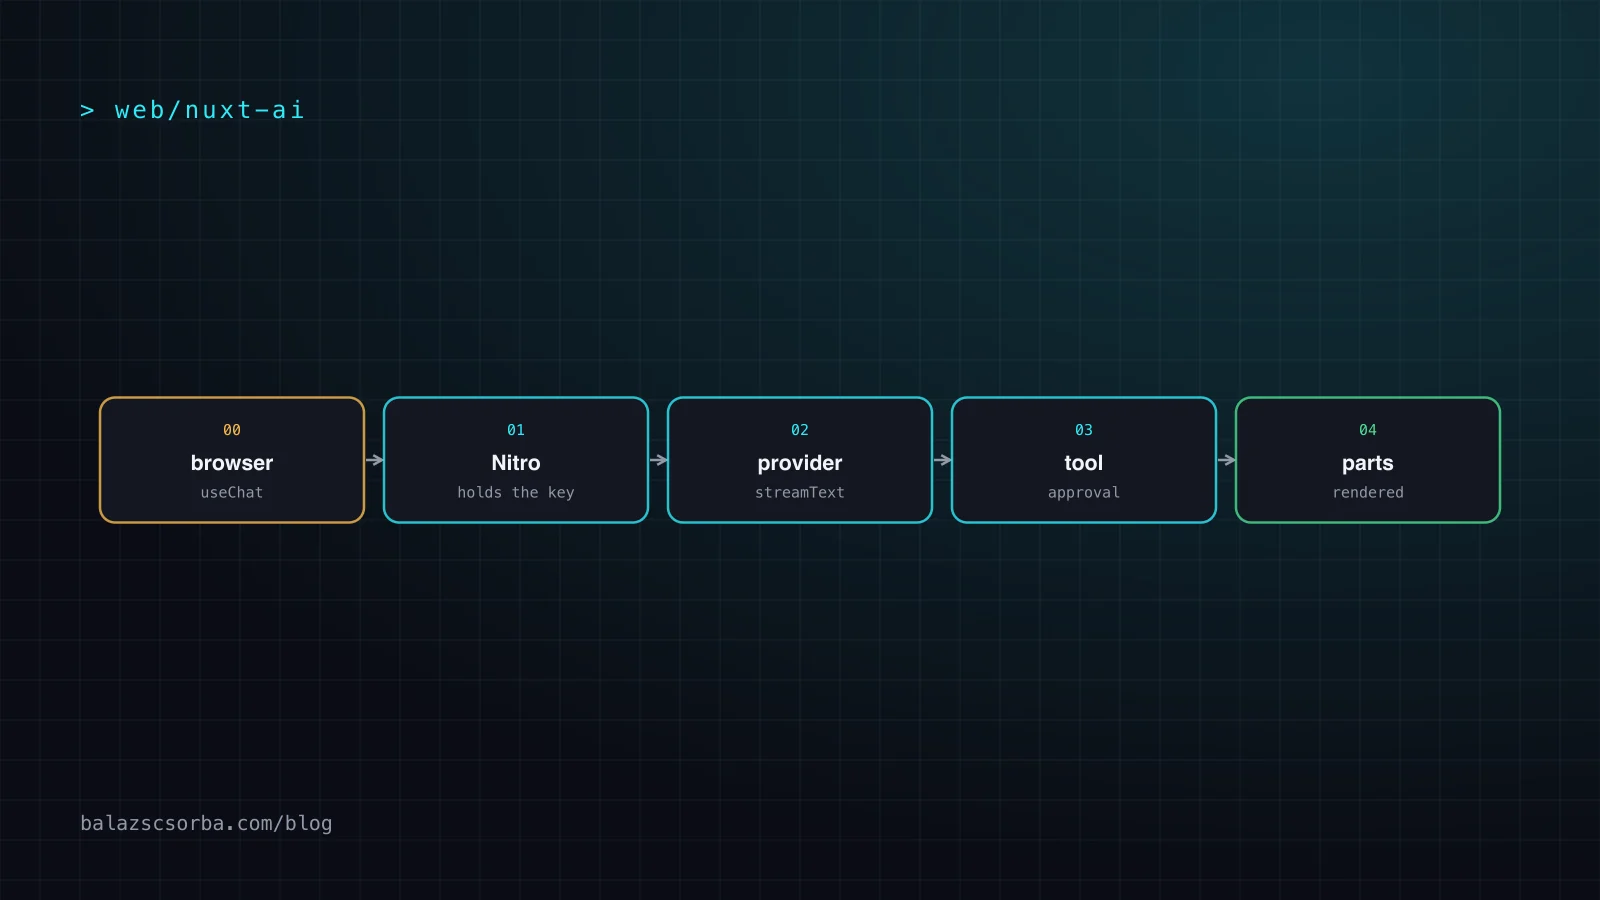
Nuxt AI-Features sind eine Nitro-Server-Route plus ein kleiner Vue-Client: Der API-Key liegt in runtimeConfig und erreicht den Browser nie, der Aufruf beim Provider läuft auf dem Server, und die Seite rendert die gestreamten Message-Parts im Takt des Eintreffens. Das ist die gesamte Architektur. Die schwierigen Teile sind die daneben: schema-gebundene Ausgabe, Tools, die ohne Menschen nicht laufen dürfen, Fehler, die du einem Nutzer erklären kannst, und die Offenlegung, die ein auf die EU ausgerichteter Chatbot nach Artikel 50 des AI Act schuldet.
Dieser Artikel baut diese Architektur mit der AI SDK in der September-2026-Fassung auf, Version 7, und jedes Snippet ist mit der Version gekennzeichnet, gegen die es geprüft wurde. Helper-Namen wandern zwischen den Hauptversionen, pinnen also die Hauptversion in der package.json und lies die Doku zu der gepinnten Version.
Wo sollte der Modellaufruf liegen?
Auf dem Server, immer. Ein Browser, der direkt eine Modell-API aufruft, liefert den Key an jeden aus, der die Devtools öffnet, und es gibt nirgends eine Stelle, an der du Rate-Limits erzwingen, personenbezogene Daten schwärzen oder den Ablauf protokollieren kannst. In Nuxt heißt das eine Datei in server/api, die Nitro zu einer HTTP-Route macht, plus @ai-sdk/vue im Client.
// nuxt.config.ts – runtime config is server-only
export default defineNuxtConfig({
  runtimeConfig: { aiGatewayApiKey: '' },   // filled from NUXT_AI_GATEWAY_API_KEY
})
// server/api/chat.ts – AI SDK 7
import { streamText, convertToModelMessages, toUIMessageStream,
createUIMessageStreamResponse, createGateway } from 'ai'
import type { UIMessage } from 'ai'
export default defineEventHandler(async (event) => {
const { messages }: { messages: UIMessage[] } = await readBody(event)
const gateway = createGateway({ apiKey: useRuntimeConfig().aiGatewayApiKey })
const result = streamText({
model: gateway('anthropic/claude-sonnet-5'),
messages: await convertToModelMessages(messages),
})
return createUIMessageStreamResponse({
stream: toUIMessageStream({ stream: result.stream }),
})
}) Hier arbeiten drei Typen. UIMessage ist, was der Client schickt: die ganze Konversation mit UI-Metadaten wie Zeitstempeln. convertToModelMessages() strippt diese Metadaten auf das ModelMessage[], das das Modell erwartet. Und toUIMessageStream() wandelt den rohen Antwortstream des Modells in das UI-Stream-Protokoll um, das der Nuxt-Quickstart dokumentiert. Wenn du statt der Vercel AI Gateway direkt einen Provider nutzt, bleibt die Form gleich und nur die Zeile model ändert sich.
Wie funktionieren die gestreamten Message-Parts?
Eine gestreamte Antwort ist kein String, der länger wird. Sie ist eine geordnete Liste von Parts an jeder Nachricht, und der Client hängt sie im Takt des Eintreffens an. Ein Part kann Text, ein Reasoning-Trace, eine Datei oder ein Tool-Aufruf sein, und ein Tool-Part heißt tool- plus der Key, unter dem du das Tool definiert hast. Deshalb renderst du mit einem v-for und einem switch über part.type, statt message.content zu interpolieren.
<script setup lang="ts">
import { useChat } from '@ai-sdk/vue'
const { messages, sendMessage } = useChat()      // posts to /api/chat
const input = ref('')
const submit = () => { sendMessage({ text: input.value }); input.value = '' }
</script>

<template>
  <div v-for="(message, index) in messages" :key="message.id ? message.id : index">
    <template v-for="(part, i) in message.parts" :key="`${message.id}-${part.type}-${i}`">
      <p v-if="part.type === 'text'">{{ part.text }}</p>
      <ToolCallCard v-else-if="part.type === 'tool-get_order'" :part="part" />
    </template>
  </div>
</template>
Zwei Konsequenzen. Erstens: Halte den Key pro Part stabil, sonst steckt Vue mitten im Stream den falschen DOM-Knoten wieder und der Text flackert. Zweitens erzeugt ein Tool-Aufruf einen Part, aber keinen Text, ein naives Chat-Protokoll zeigt also einen leeren Turn: Das Modell hat einen Schritt beendet, nicht das Gespräch. Dafür gibt es stopWhen. Der Standard ist isStepCount(1), was nach dem ersten Schritt stoppt, auch wenn Tool-Ergebnisse warten; erhöhst du den Wert, sieht das Modell seine eigene Tool-Ausgabe und beantwortet die ursprüngliche Frage.
// server/api/chat.ts – AI SDK 7
const result = streamText({
  model: gateway('anthropic/claude-sonnet-5'),
  messages: await convertToModelMessages(messages),
  stopWhen: isStepCount(5),                      // default: isStepCount(1)
  tools: {
    get_order: tool({
      description: 'Look up one order by its order number.',
      inputSchema: z.object({ orderNumber: z.string().describe('Order number, e.g. 4711') }),
      execute: async ({ orderNumber }) => db.findOrder(orderNumber),
    }),
  },
})
Begrenze diese Zahl. Ein Schrittlimit ist das Einzige zwischen einem verwirrten Modell und einer Tool-Schleife, und es ist dieselbe Abbruchbedingung, die du überall sonst auch schreiben würdest. Der Browser sollte außerdem zeigen, dass ein Tool läuft: ein Spinner auf dem tool--Part erklärt dem Nutzer, warum die Antwort vier Sekunden braucht, und das ist ein großer Teil der wahrgenommenen Qualität.
Wie komme ich an strukturierte Ausgabe, und wo sind die Grenzen?
Strukturierte Ausgabe ist eine Eigenschaft des Aufrufs von generateText und streamText, konfiguriert über die output-Option, und dasselbe Schema steuert das Modell und validiert das Ergebnis. Nimm die engste Form, die zur Aufgabe passt.
| Was du brauchst | Ausgabetyp | Was erzwungen wird |
|---|---|---|
| Fließtext | Output.text() | Nichts; du bekommst einen String |
| Ein Objekt | Output.object({ schema }) | Schema-validiertes Objekt |
| Eine feste Anzahl Zeilen | Output.array({ element, minItems, maxItems }) | Element-Schema und Grenzwerte |
| Ein Label aus einer festen Menge | Output.choice({ options }) | Muss einer der Optionen entsprechen |
| Freies JSON | Output.json() | Nur gültiges JSON, keine Form |
// server/api/triage.ts – AI SDK 7
const { output } = await generateText({
  model: gateway('anthropic/claude-sonnet-5'),
  output: Output.object({
    name: 'Triage',
    description: 'A routing decision for one support ticket.',
    schema: z.object({
      severity: z.number().describe('1 to 4, 4 is a total outage'),
      team: z.enum(['billing', 'shipping', 'platform']),
      summary: z.string().describe('One sentence, no customer name'),
    }),
  }),
  prompt: ticket.body,
})
Jetzt der Teil, der zubeißt. Strukturierte Ausgaben funktionieren über Constrained Decoding, das heißt, der Provider unterstützt eine Teilmenge von JSON Schema, nicht die ganze Spezifikation. Die Dokumentation zu Claude structured outputs listet die Teilmenge genau auf, und drei Einträge entscheiden, ob dein Design überlebt:
- Keine Zahlen- oder String-Grenzwerte.
minimum,maximum,multipleOf,minLengthundmaxLengthwerden nicht unterstützt. Validiere Bereiche in eigenem Code, wo du auch eine brauchbare Fehlermeldung erzeugen kannst. - Keine rekursiven Schemata. Ein Kommentarbaum oder ein verknüpfter Work Item muss zu einer Liste von Knoten mit Eltern-IDs abgeflacht oder als Text zurückgegeben werden.
- Sonst enge Regeln. Objekte brauchen
additionalProperties: false, Array-minItemsist nur 0 oder 1, Enums enthalten nur Strings, Zahlen, Booleans oder Nulls, und externes$reffällt weg.
Nimmst du ein nicht unterstütztes Feature, bekommst du schon bei der Anfrage einen 400 mit Details, und nicht etwa einen subtilen Generierungsfehler. Auf dem Draht ist der Vertrag output_config.format mit type: "json_schema"; der ältere Parameter output_format ist deprecated. Und vergiss die Buchhaltung: Das Erzeugen der strukturierten Ausgabe ist selbst ein Schritt, also muss stopWhen Platz für die Tool-Aufrufe plus die Ausgabe lassen.
Wie bekommen Tools einen Human in the Loop?
In AI SDK 7 ist die Freigabe eine Policy auf dem Aufruf, keine Eigenschaft des Tools. toolApproval bildet Tool-Namen auf einen Status ab, und die Dokumentation zu Tool Approvals definiert vier: keine Freigabe-Metadaten und normal ausführen, eine automatische Freigabe aufzeichnen, eine automatische Ablehnung mit Begründung aufzeichnen und user-approval, das eine Anfrage ausgibt und auf eine Antwort wartet. Weil es zugleich eine Funktion und eine Map ist, kann die Entscheidung von den geparsten Eingaben und der Rolle des Aufrufers abhängen.
// AI SDK 7
const result = await generateText({
  model: gateway('anthropic/claude-sonnet-5'),
  messages,
  tools: { issue_refund: tool({ inputSchema: refundSchema, execute: runRefund }) },
  toolApproval: {
    issue_refund: async ({ amountCents }, { runtimeContext }) => {
      if (runtimeContext.role !== 'support-lead') {
        return { type: 'denied', reason: 'Only a support lead can refund' }
      }
      return amountCents > 5000 ? 'user-approval' : undefined
    },
  },
})
Die Clientseite ist ein Part-Typ und ein Aufruf. Freigabeanfragen erscheinen als Tool-Parts mit state: 'approval-requested', und du antwortest mit addToolApprovalResponse(), optional mit sendAutomaticallyWhen: lastAssistantMessageIsCompleteWithApprovalResponses, damit das SDK die Anfrage nach der Antwort erneut schickt. Wird ein Tool abgelehnt, sag dem Modell, dass es das Tool nicht wiederholen soll, sonst hast du dir eine Freigabeschleife gebaut.
Ist ein Tool eine Aktion auf deiner eigenen Seite statt auf der Seite des Nutzers, kannst du das Modell auch in den Browser schieben und die Seite übernehmen lassen. Das ist der WebMCP-Weg, und er fügt sich gut zusammen: Die Nitro-Route hält den Key und die Freigaben, das Seiten-Tool hält die UI.
Wie verhalten sich Fehler, Timeouts und Fallbacks?
Die erste Überraschung: In einem Stream werden Fehler nicht geworfen. streamText startet sofort mit dem Streamen, und ein Fehler auf halbem Weg wird Teil des Streams statt einer Exception, die Verbindung bricht nicht ab, und der Nutzer hat den ersten Absatz. Das hilft nur, wenn du es behandelst, also mit einem onError-Callback auf dem Server und einem Fehler-Part in der UI.
Die zweite Überraschung: Eine fehlende Ausgabe ist nicht dasselbe wie eine kaputte. Aufrufe ohne Streaming melden eine nicht erfüllte Schemaprüfung als NoObjectGeneratedError, das den erzeugten text, die Response-Metadaten und den Tokenverbrauch erhält, sodass du protokollieren kannst, was schiefging, ohne zu raten. Endet der letzte Schritt auf Tool-Aufrufen statt auf einem Stoppgrund, wirft das Lesen von output stattdessen NoOutputGeneratedError. Beides ist normaler Kontrollfluss; behandle die beiden getrennt, denn nur eines davon ist ein Bug.
Für alles andere entscheide vor dem Start, was der Nutzer sieht. Ein Timeout braucht eine Obergrenze, die du aufgeschrieben hast, weil Proxy-Defaults keine Produktentscheidung sind. Ein Fallback auf ein günstigeres Modell braucht eine Schwelle, keine Vermutung, und Kosten- und Latenzbudgets misst man pro Feature, statt sie anzunehmen. Eine abgelehnte Anfrage ist kein Fehler, den man versteckt: Sag, was abgelehnt wurde. Und ein Offline-Pfad ist mehr wert, als er klingt, denn ein Feature, das nur mit Netzwerk funktioniert, ist ein Feature, das du nicht vorführen kannst.
<!-- Your own error surface, not SDK output -->
<p role="alert">The assistant is unavailable, so your message was not sent.</p>
Wenn du neben Menschen auch Agenten bedienst, ist nichts davon optional. Meine eigenen llms.txt- und Markdown-Darstellungen decken den Fall ab, dass es überhaupt keine Browser-Session gibt, worum es in llms.txt gegen Accept: text/markdown geht.
Was verlangt Artikel 50 von einem Chatbot?
Seit 2. August 2026 gelten die Transparenzpflichten aus Artikel 50 der EU AI Act, und die Pflicht, die Teams am ehesten überrascht, ist die einfachste: Wenn ein System direkt mit Menschen interagiert, müssen sie darüber informiert werden, dass sie mit einem KI-System interagieren. Der Text von Artikel 50 setzt die Offenlegung spätestens auf den Zeitpunkt der ersten Interaktion, was eine Zeile im Footer ausschließt, die niemand liest. Setz sie dorthin, wo das Gespräch beginnt, und setz sie dorthin, bevor das erste Token ankommt. Die finalen Leitlinien der Kommission zu den Transparenzpflichten erschienen im Juli 2026; die vollständige Checkliste für Entwickler steht in der Artikel-50-Checkliste für Entwickler. Das ist keine Rechtsberatung.
Die Telemetrie, die du vom ersten Tag an willst, ist klein und geht meist um Vertrauen. Pro Anfrage: Modell und Version, Tokens ein und aus, Zeit bis zum ersten Token und Gesamtdauer. Pro Tool: welches Tool, der Freigabestatus, wer sie freigegeben hat und wann. Pro Fehler: welche Fehlerklasse und ob ein Fallback gegriffen hat. Dazu eine Zahl, auf die nur die Produktverantwortung Wert legt: der Offenlegungszustand, der beim Start der Session galt. Die AI SDK bringt ein Telemetrie-Modul mit, aber das Freigabe-Protokoll schreibst du selbst, und genau danach fragen ein Auditor oder ein wütender Kunde.
Zwei Regeln halten das ehrlich. Protokolliere die Request-ID, das Modell und das Ergebnis, nicht den Prompt-Text: Prompts sind der schnellste Weg zu personenbezogenen Daten in einem Log-Speicher, den niemand geprüft hat. Und entscheide vor dem Ausliefern, welche Daten die Maschine verlassen, denn das nachträglich aufzubauen ist ein Rewrite. Wenn du das für ein Team durchgehst, geht es auf der Vue- und Nuxt-Seite im Kern um SSR, Streaming und darum, die Geheimnisse in runtimeConfig zu halten.
Nuxt AI Checkliste
- Halte den Key auf dem Server. Eine Nitro-Route in
server/api, Key inruntimeConfig, nur aus der Umgebung gelesen. - Streame und rendere Parts, keine Strings. Ein stabiler Key pro Part und ein sichtbarer Zustand für Tool-Parts.
- Begrenze die Schritte.
stopWhen: isStepCount(n)mit einer Zahl, die du selbst gewählt hast, plus ein Tool, das Unsinnseingaben ablehnt. - Nimm den engsten Ausgabetyp, der passt, und halte dich an die unterstützte Schema-Teilmenge: keine Grenzwerte, keine Rekursion, geschlossene Objekte.
- Validiere, was das Modell zurückgibt, an eigenen Regeln, denn das Schema kann nicht alle ausdrücken.
- Verlange eine Freigabe für folgenreiche Tools mit
toolApproval, und signiere Freigaben mitexperimental_toolApprovalSecret, damit ein manipulierter Client den Menschen nicht überspringen kann. - Behandle Stream-Fehler mit
onErrorund unterscheide ein fehlgeschlagenes von einem fehlenden Objekt. - Schreibe das Timeout und die Fallback-Schwelle vor dem Start auf, und zeige dem Nutzer, welches davon gegriffen hat.
- Leg die KI bei der ersten Interaktion offen und protokolliere den Offenlegungszustand mit der Anfrage.
Quellen
Häufige Fragen
Wie halte ich einen LLM-API-Key aus dem Browser einer Nuxt-App heraus?
Leg den Key in runtimeConfig in nuxt.config.ts, lass den Wert dort leer und fülle ihn aus einer Umgebungsvariable wie NUXT_AI_GATEWAY_API_KEY. Rufe das Modell dann aus einer Datei in server/api auf, die Nitro als HTTP-Route bereitstellt. Die Client-Komponente spricht mit dieser Route, nie mit dem Provider, also bleiben Key, Rate-Limits und Schwärzung auf dem Server.
Was ist ein UI Message Part in der AI SDK?
Jede Nachricht in einem gestreamten Chat ist eine geordnete Liste von Parts, und der Client hängt sie im Takt des Eintreffens an. Ein Part kann Text, ein Reasoning-Trace oder ein Tool-Aufruf sein, und Tool-Parts heißen tool- gefolgt von dem Key, unter dem du das Tool definiert hast. Deshalb renderst du mit einer Schleife über message.parts und einem switch über part.type, statt einen einzelnen Content-String zu interpolieren.
Warum zeigt mein Chatbot nach einem Tool-Aufruf einen leeren Turn?
Weil das Erzeugen eines Tool-Aufrufs einen Schritt beendet, nicht das Gespräch. In der AI SDK ist die Standard-Abbruchbedingung isStepCount(1), die Generierung stoppt also nach dem ersten Schritt, obwohl Tool-Ergebnisse noch an das Modell zurückgeschickt werden müssen. Erhöhe stopWhen, etwa auf isStepCount(5), damit das Modell seine eigene Tool-Ausgabe sieht und dann die ursprüngliche Frage beantwortet.
Welche JSON-Schema-Keywords unterstützen strukturierte Ausgaben nicht?
Provider erzwingen über Constrained Decoding eine Teilmenge von JSON Schema. Auf der Claude API fällt damit jede rekursive Schemadefinition weg, numerische Einschränkungen wie minimum, maximum und multipleOf, String-Einschränkungen wie minLength und maxLength, komplexe Typen in Enums, externe $ref-Verweise sowie Array-Einschränkungen über minItems von 0 oder 1 hinaus. Objekte müssen additionalProperties auf false setzen. Ein nicht unterstütztes Keyword liefert schon bei der Anfrage einen 400 mit Details.
Müssen EU-Nutzer erfahren, dass ein Website-Chatbot KI einsetzt?
Ja. Artikel 50 der EU AI Act gilt seit 2. August 2026 und verlangt, dass Menschen informiert werden, wenn ein System direkt mit ihnen interagiert. Der Text von Artikel 50 legt die Offenlegung spätestens auf die erste Interaktion, ein Chatbot sollte die Offenlegung also dorthin setzen, wo das Gespräch beginnt, und nicht versteckt in den Footer. Das ist eine Zusammenfassung für Entwickler, keine Rechtsberatung.