Blog/MI-ágensek
Kontexttervezés kódoló ügynökökhöz: AGENTS.md, skillek, MCP vagy CLI?
Mi van egy kódoló ügynök kontextusában: szabályok az AGENTS.md-ben, eljárások a skillekben, és mikor ver egy MCP eszköz egy shell parancsot.
Balázs Csorba··8 perc olvasás
- Context engineering
- AGENTS.md
- Agent skills
- MCP
A lényeg röviden
- A kontexttervezés figyelmi keret, nem tokenkeret: amit a modell elé teszel, versenyt folytat azzal a kóddal, amit az ügynöknek el kell olvasnia.
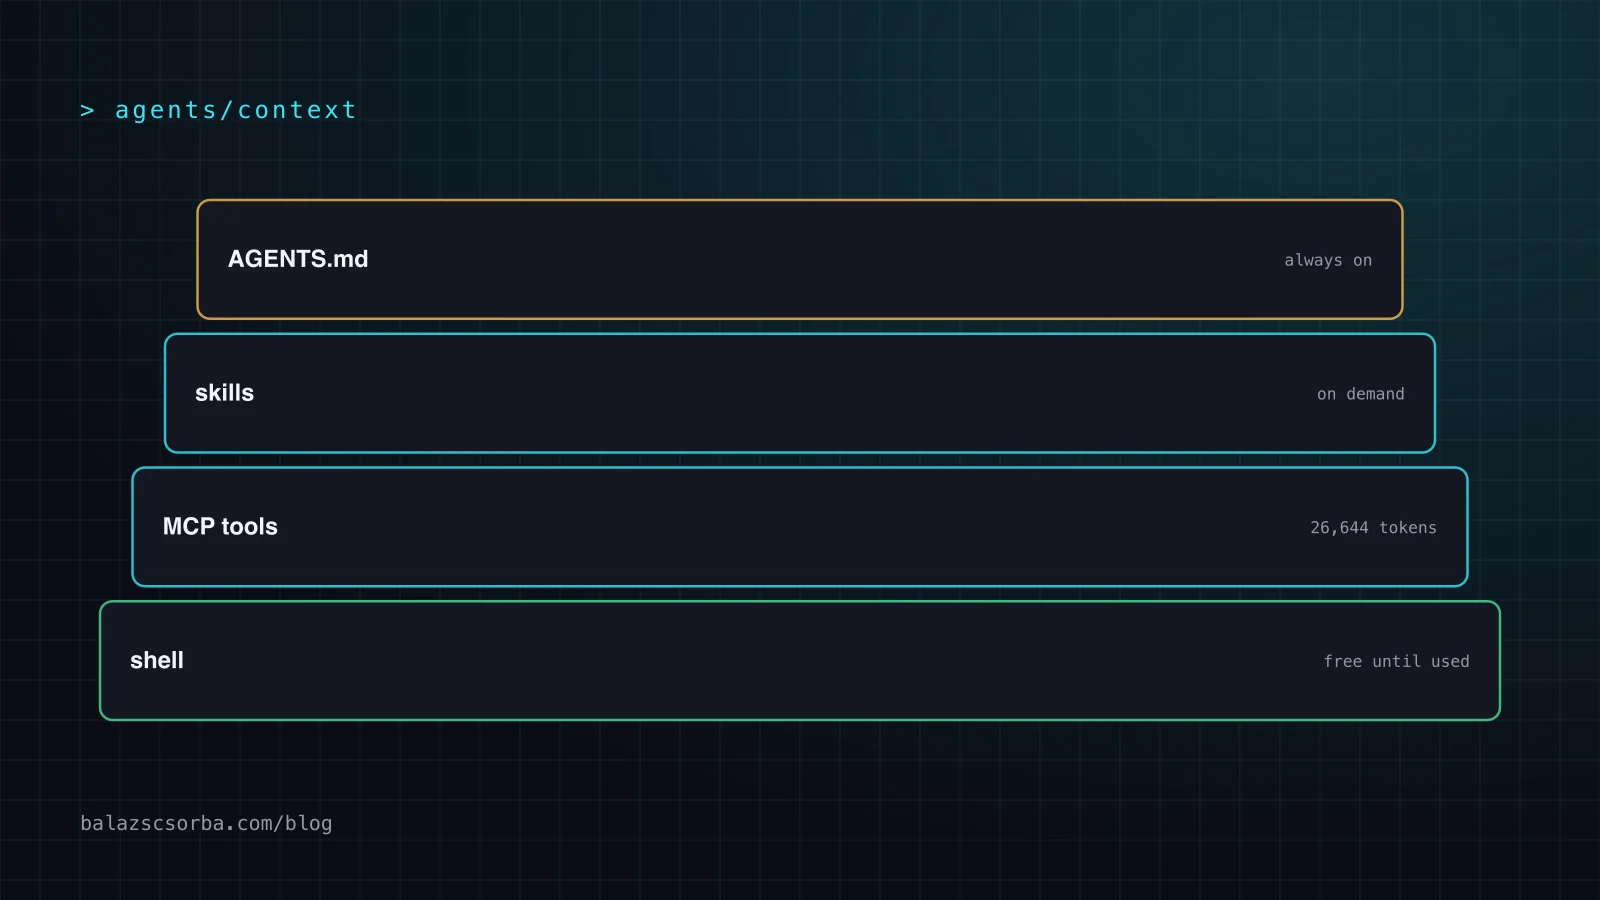
- Négy réteg végzi a munkát: a mindig aktív szabályok az AGENTS.md-ben, az on demand betöltött skillekben lévő eljárások, a rezidens MCP eszközsémák és a shell.
- Az eszközdefiníciók a drága réteg: a GitHub MCP szerver 85 eszköze 26,644 token, egy 15 eszközes szerverhez 3,185.
- A tool search 85 %-kal csökkentette a tokenfelhasználást, és közben növelte a pontosságot, az MCP-vel való code execution pedig egy 150,000 tokenes eszközfelületet körülbelül 2,000-re hozott.
- Amit már dokumentált parancsként létezik, az a shell mögé való, és a hitelesítő adatoknak csak a környezeten keresztül szabad eljutniuk az ügynökhöz.
A kontexttervezés arról szól, mi van egy kódoló ügynök kontextusablakában, mikor kerül bele, és milyen formában. Egy ügynök soha nem olvassa a repódat; egy ablakot olvas, amelyet az eszközeid állítanak össze utasításfájlokból, eszközdefiníciókból, skillekből és parancskimenetekből. Ha ezt az ablakot rosszul állítod össze, az ügynök egy elavult szabályjal, egy hiányzó eljárással, vagy 26 000 tokennyi eszközsémával és egyáltalán nem maradó hellyel dolgozik a módosítandó kód számára.
Ez a cikk négy rétegre bontja az ablakot, mindegyikre nagyjából tokenárat tesz, és kiszámolja, mikor éri meg egy MCP szerver, és mikor jobb egy sima shell parancs. A végén egy döntési mátrix, amelyet öt perc alatt alkalmazhatsz egy új eszközre, és egy ellenőrzőlista a már meglévő beállításod átvizsgálásához.
Mi a kontexttervezés?
A kontexttervezés annak a gyakorlata, hogy összeállítsuk azt a bemenetet, amelyből egy modell dolgozik. Az Anthropic „Effective context engineering for AI agents” (2025. szeptember) című útmutatója figyelmi keretként, nem tokenkeretként kezeli ezt: amit a modell elé teszel, az versenyt folytat a figyelméért, tehát a relevancia többet számít, mint a teljesség. Ugyanez a bejegyzés azt ajánlja, hogy a lehető legkisebb lépésszámhoz a lehető legkevesebb nagy jelzésű tokent írj.
A szó jóval gyorsabban került a mainstreambe, mint a gyakorlat. A Thoughtworks Technology Radar 2026. áprilisában Adopt státuszba tette a kontexttervezést, és ez elég pontos: a minta letsett, az implementációk még nem egységesek. Az érdekes mérnöki munka nem a promptolás. Az, hogy helyzetről helyzetre eldönteni, melyik réteg legyen rezidens, melyiket kelljen on demand betölteni, és melyik ne legyen egyáltalán az ablakban.
Miért romlik a hosszú kontextus: context rot
A context rot a pontosság megfigyelt romlása, ahogy a bemenet nő, és nem egyenletes görbe. A Chroma Context Rot tanulmánya (2025. július) 18 modellt futtatott needle-in-a-haystack jellegű feladatokon növekvő bemenethossz mellett, és azt találta, hogy a teljesítmény egyenletlenül esik: egyes modellek egy hosszú bemenet közepén érezhetően romlanak, mások sokkal tovább bírják, és a modellek sorrendje a hosszzal változik.
Két gyakorlati következmény. Az 1M tokenes ablak kapacitásszám, nem pontossági szám, és egy hosszú kontextus közepe a legrosszabb hely arra, hogy egy olyan utasítást tegyél, amit követni akarsz. És mert a romlás modellfüggő, a „belefer” nem indok: azzal a modellel kell tesztelned, amit tényleg futtatsz.
A négy réteg és az egyes rétegek költsége
Majdnem minden ügynök-beállítás, amit ismerek, a négy réteg egy változata, és a hasznos kérdés nem az, melyiket használjuk, hanem hogy mennyi maradjon rezidens belőle. A rétegek abban különböznek, hogy mikor töltődnek be, és erről szól az egész: egy rezidens réteg minden kérésben figyelmet fizet, azokban a sok kérésben is, amelyekben irreleváns.
| Réteg | Tartalmaz | Betöltés | Tipikus költség |
|---|---|---|---|
| Utasításfájl (AGENTS.md) | Mindig érvényes szabályok: build parancsok, konvenciók, elutasítások | Minden kérés | 200 és 1 000 token |
| Skillek | Egy adott feladathoz tartozó eljárások, mindegyik saját fájlban | Először csak a metaadat, majd a fájl | Skillenként kb. 100 token, a törzs on demand |
| MCP eszközök | Minden közzétett eszköz neve, leírása és JSON sémája | Minden kérésben, szerverenként | 85 eszköz: 26 644 token; 15 eszköz: 3 185 |
| Shell | Minden, ami már a gépen van | Csak amikor egy parancs fut | Nulla, amíg nem érkezik kimenet |
Az AGENTS.md a legközelebbi valami egy közös szabványzóhoz: egy nyílt fájlformátum, amelyet az Agentic AI Foundation gondoz, és amelyet több mint 60 000 projekt használ. Az értéke, hogy mindig betöltve van és mindig ugyanaz, így a futtatókörnyezet nem felejtheti el a benne lévő szabályt. Az ára, hogy minden turnben ki van számlálva, ezért szabályokat és nem tudást kell tartania.
A skillek a fokozatos kibontás rétege: egy könyvtár kis Markdown-eljárásokkal, ahol az ügynök először csak egy nevet és egy leírást lát, és akkor olvas el egy fájlt, amikor a feladat megkívánja. A specifikáció 64 karakterre korlátozza a nevet és 1 024-re a leírást, és a szokás az, hogy egy SKILL.md 500 sor alatt marad. A saját beállításom körülbelül húszat tart egy mester-mappában, ami három ügynökbe van szinkronizálva; a skillek munkafolyamata tárgyalja, hogyan van ez a mappa felépítve.
Az MCP eszközök a drága réteg
Az eszközdefiníciók tiszta többletráfordítás, amíg egy eszközt nem hívnak, és pont ezen a rétegen tesznek a legtöbb embert eszközt. A Blocks.ai egy mért összehasonlítása a GitHub MCP szerver 85 eszközét 26 644 tokenre, egy 15 eszközes szervert pedig 3 185 tokenre teszi. Mindkét szám minden turnben bekerül az adott session minden kérésébe, azokba a turnökbe is, amelyekben az ügynök csak egy fájlt olvas.
Két megközelítés csökkenti ezt anélkül, hogy képességeket törölne. A tool search az Anthropic „Advanced tool use” munkájában (2025. november) on demand tölti be az eszközdefiníciókat, és 85 %-kal mérsékelte a tokenfelhasználást, miközben a pontosság az egyik modellen 49 %-ról 74 %-ra, egy másikon 79,5 %-ról 88,1 %-ra nőtt. A code execution az MCP-vel, ugyanebből az évből, a másik irányt vette: ahelyett, hogy leírná az eszközöket, a modell kódot kap, amely meghívja őket, és az eszközfelület körülbelül 150 000 tokenről 2 000-re zsugorodik, 98,7 %-os csökkenés.
A gyakorlati szabály az, amit az eszköztervezési irodalom újra és újra elmond: egy képesség eszközönként, és olyan név, amely megmondja, mikor használd. Egy szerver, amely egy REST API-t egy az egyhez tükröz, 85 módot ad a modellnek négy dolgot megtenni. A 20 eszközes Jira szerver tanulságai megmutatják, hogyan konszolidáltam a sajátomat.
Mikor válassz CLI-t egy MCP szerver helyett
Egy shell parancs és egy MCP eszköz ugyanazt a munkát el tudja végezni, és a választott interfész megváltoztatja a kontextusszámlát és a biztonsági felületet. A CLI nyer, ha a képesség már létezik parancsként, ha az ügynöknek pipe-okkal kell összefűznie, és ha az eredmény nagy, de flag-ekkel szűrhető. Az MCP szerver nyer, ha az ügynöknek különben ki kellene találnia a parancsszintaxist, és ha a hitelesítő adatok egy helyen, nem pedig minden gépen éljenek.
A hitelesítő adatok őrzése az oka, hogy az MCP sok beállításban, az enyémben is, továbbra is nyer. A szabályom az, hogy a hitelesítő adatok csak a környezetből jönnek: az ügynök soha nem olvas ki hitelesítő adatfájlt, és soha nem ír ki tokent. Az MCP szerver a saját folyamatában tartja a tokent, így egy eszközhívás rövid életű jogosultságot hordoz egy hosszú életű titokhoz vezető út helyett. Egy shell parancs ugyanolyan biztonságos lehet, ha a környezet az egyetlen forrás, és kevésbé biztonságos, ha a parancs curl olyan tokenre mutat, amelyet az ügynöknek előbb olvasnia kellett.
| Helyzet | Ezt válaszd | Miért |
|---|---|---|
| A parancs már létezik és dokumentált | Shell | Nulla rezidens token, és a pipe-ok összeépülnek |
| Az ügynöknek találgatnia kellene a flag-eket vagy a kimenet alakját | MCP eszköz | A séma mindkettőt dokumentálja |
| A kimenet hatalmas, de van szűrője | Shell | Szűrés kiszolgálóoldalon, nem a kontextusban |
| Az ügynöknek titkot kell használnia | MCP eszköz, vagy shell parancs, amely csak a környezetet olvassa | Egyik sem igényeli a tokent az ablakban |
| Egy szerverhez több mint kb. 20 eszköz kellene | Először shellek, aztán tool search | A rezidens tokenek lineárisan nőnek az eszközszámmal |
| A feladat egyszeri vizsgálódás | Shell | Egy skill fájl állandó többletráfordítás lenne egy ritka esetre |
Tömörítés, jegyzetfájlok és alügynökök
A kontextusablak minden hosszú sessionben megtelik, és a megoldás nem egy nagyobb ablak. Három mechanizmus kezeli ezt: a tömörítés (a legrégebbi turnök összefoglalása), a lemezen lévő jegyzetek és az alügynökök. Mindhárom a rezidens tokeneket közvetlenségre cseréli, és mindhárom veszít részleteket, ezért azt érdemes megtartani, amit nem bánnád újra levezetni.
Az Anthropic kontexttervezési bejegyzése az alügynököket a drága keresések eszközeként írja le: az alügynök a saját kontextusát égeti a felderítésre, és a nyers oldalak helyett nagyjából 1 000 és 2 000 token közötti összefoglalót ad vissza. Ez jó csere, ha a közbenső kimenet nagy, a következtetés kicsi. Rossz csere az olyan feladathoz, ahol maga a részlet a szállítandó.
A jegyzetfájlok a harmadik mechanizmus, és a legkevésbé becsült. Az az állapot, amely a sessionök között számít, egy olyan fájlba való, amelyet az ügynök ír és újraolvas, nem egy olyan összefoglalóba, amelyet a futtatókörnyezet gyártott. Az ügynökhurok az, amiért ez számít: egy hosszú hurok, amely az állapotot az ablakban tartja, minden iterációban fizet érte.
A döntési mátrix
Ha a négy réteget egymás mellé teszed, a választás lényegében a betöltés időzítéséről szól. A szabályok, amelyeknek minden turnben érvényesnek kell lenniük, az AGENTS.md-be valók. Az eljárások, amelyek egy feladatosztályra vonatkoznak, egy skillbe valók, így a törzsük csak használatkor fizet. A futó rendszerrel szembeni képességek akkor valók egy MCP eszközbe, ha az ügynöknek különben találgatnia kellene az interfészt. Minden más shell parancsba való.
Az a mérleg, amit tudni kell: minden hozzáadott rétegnek karbantartási költsége van. A szabályok akkor avatnak el, ha ellentmondanak a kódnak. A skillek akkor avatnak el, ha az eljárás megváltozik. Az eszközsémák akkor avatnak el, ha az API mozdul, és egy elavult eszkölleírás rosszabb, mint a semmi, mert az ügynök bízik benne. Tartsd minden réteget olyan kicsire, hogy egy review alatt végig tudd olvasni, és inkább törölj egy réteget, mint hogy növekedjen.
Kontexttervezési checklist
- Egyszer sessionenként kiírni a rezidens token számot: szabályok, skill metaadatok, eszközsémák. Amit nem mértél meg, azt nem tudod kezelni.
- Az AGENTS.md-ben csak szabályokat tartani, amelyek minden turnben érvényesek, az eljárásokat pedig skillekbe mozgatni.
- Minden skillnek olyan nevet és leírást adni, amely megmondja, mikor használd, és a törzsöt néhány száz sor alatt tartani.
- Az eszközöket konszolidálni, hogy minden eszköz egy képesség legyen, ne egy végpont; messze 20 eszköz alatt járni szerverenként.
- Tool searchöt vagy code executiont használni, amikor egy szerver sémája átlépi a kb. 10 000 tokent.
- Először a shellhez nyúlni, ha egy dokumentált parancs már elvégzi a munkát.
- A hitelesítő adatokat csak a környezeten keresztül átadni, soha nem egy olyan fájlból, amelyet az ügynök olvas, és soha nem egy promptban.
- A hatalmas felderítési kimeneteket alügynökökhöz küldeni, és a következtetéseket a fő kontextusban tartani.
- Az állapotot jegyzetfájlokban tárolni, nem olyan összefoglalókban, amelyeket a futtatókörnyezet majd letömörít.
- A build bármilyen változásakor újra elolvasni a szabályokat. Az a szabály, amely ellentmond a kódnak, azt tanítja az ügynöknek, hogy hagyja figyelmen kívül a szabályokat.
Ha egy csapatnak állítod be ezt, a skillekről szóló bejegyzés a fájlrendszer felépítését tárgyalja, az eszköztervezési bejegyzés az eszközoldalt, az AI mérnöki oldal pedig azt, hogyan illeszkedik ez egy szállítási folyamatba.
Források
- Anthropic: Effective context engineering for AI agents (2025. szeptember)
- Chroma: Context Rot (2025. július)
- AGENTS.md: az ügynökutasítások nyílt formátuma
- Agent Skills specification
- Anthropic: Advanced tool use, tool search and programmatic tool calling (2025. november)
- Blocks.ai: MCP vs CLI, the context window cost
- Thoughtworks Technology Radar: Context engineering (Adopt, 2026. április)
Gyakori kérdések
Mi a kontexttervezés a kódoló ügynököknél?
Az, hogy eldöntjük, mi van egy modell kontextusablakában, mikor töltődik be az a tartalom, és milyen formában. Az Anthropic figyelmi keretnek, nem tokenkeretnek nevezi, mert azok a tokenek, amelyeket hozzáadsz, versenyeznek a figyelemért azzal a kóddal, amelyet az ügynöknek olvasnia kell. Gyakorlatban ez azt jelenti, hogy a mindig aktív szabályok kicsik maradjanak, az eljárások on demand betöltött skillekben legyenek, és tudatosan döntsünk arról, hány eszközdefiníció marad rezidens.
AGENTS.md vagy skillek?
AGENTS.md-be azok a szabályok valók, amelyeknek minden turnben érvényesnek kell lenniük, például a build parancs, a konvenciók és az, amit az ügynöknek el kell utasítania. Skillekbe azok az eljárások, amelyek egy feladatosztályra vonatkoznak, mert a skill törzse csak akkor olvasódik be, amikor a feladat kéri, előtte körülbelül 100 token metaadattal. Ha egy szabályhoz egy bekezdésnyi magyarázat kell, akkor az nem szabály, hanem egy szabályt játszó skill.
Mennyibe kerülnek az MCP eszközök a kontextusban?
Az eszközdefiníciók minden kérésben elküldésre kerülnek egy sessionben, így a költség az eszközök számával skálázódik. A Blocks.ai a GitHub MCP szerver 85 eszközét 26,644 tokenre, egy 15 eszközes szervert 3,185 tokenre mérte. Az Anthropic tool search-e on demand tölti be a definíciókat, és 85 %-kal csökkentette a tokenfelhasználást, miközben a pontosság nőtt, az MCP-vel való code execution pedig egy 150,000 tokenes eszközfelületet körülbelül 2,000-re redukált.
Mikor jobb a CLI, mint az MCP szerver?
Egy shell parancs jobb, ha a képesség már létezik dokumentált parancsként, ha az ügynöknek pipe-on keresztül kell irányítania a kimenetet, vagy ha a kimenet nagy, de szűrhető, mert a modellen kívüli szűrés kizárja a tokeneket az ablakból. Egy MCP szerver jobb, ha az ügynöknek találgatnia kellene egy parancs flag-jeiről vagy a kimenet alakjáról, és ha egy hitelesítő adat egy folyamaton belül maradjon, ne egy fájlból jöjjön.
Hogyan akadályozzam meg, hogy az ügynök kontextusa megteljen?
Három mechanizmus: a tömörítés összefoglalja a legrégebbi turnöket, a jegyzetfájlok sessionökön át tárolják az állapotot a lemezen, az alügynökök pedig a saját kontextusukat égetik a felderítésre, és rövid összefoglalót adnak vissza, jellemzően 1,000 és 2,000 token között. Mindhárom veszít részleteket, ezért azt tartsd meg, amit nem bánnád újra levezetni, és a futtatókörnyezet által gyártott összefoglaló helyett inkább az ügynök által írt fájlt válaszd.