Eszközök/RAG és keresés
Unstructured ismertető: dokumentumok feldolgozása RAG-hez
Az Unstructured PDF-eket, Word-fájlokat és képeket típusszintű elemekké alakít RAG-hez: Apache-2.0 könyvtár és platform 0,015 dollár oldalanként az első 10 000 ingyenes oldal után.
- Típus
- Document ingestion
- Ár
- Apache-2.0 · paid tiers
Balázs Csorba··11 perc olvasás
- Document parsing
- RAG ingestion
- PDF extraction
- Chunking
- ETL
A lényeg röviden
- Az Unstructured egy Apache-2.0 licencű Python-könyvtár, amely PDF-eket, Word-fájlokat és képeket cím, táblázat és lista típusú elemekké alakít, hostolt platformmal, csatlakozókkal és VLM stratégiával.
- A platform 0,015 dollárt számol oldalanként az első 10 000 ingyenes oldal után, a könyvtár helyben fut oldalszám nélkül.
- A szolgáltató saját, több mint 1 000 vállalati oldalas benchmarkján az open-source változat 0,426 táblázati cellatartalmat ér el 0,820-zal szemben a legjobb platform-pipelinenél.
- A táblázati szerkezet és az olvasási sorrend hiba nélkül bukik el, ezért a korpusz mintáját olvassa el, mielőtt embeddig modellt választana.
- A telemetria DO_NOT_TRACK és SCARF_NO_ANALYTICS kapcsolókkal kikapcsolható; a könyvtárral a dokumentumok nem hagyják el a gépet.
Az Unstructured az a dokumentumfeldolgozási réteg, amellyel a legtöbb lekérdező pipeline elkezdődik: egy Apache-2.0 licencű Python-könyvtár, amely PDF-eket, Word-fájlokat, HTML-t, képeket és táblázatokat típusszintű elemekké alakít, címekké, táblákká, listákká és szöveggé, emellett egy hostolt platform, amely csatlakozókat, módosításfelismerést és a könyvtárban nem meglévő stratégiákat ad hozzá. A könyvtár szinte mindenkinek a jó kiindulópont; a platformnak csak akkor éri meg az árát, ha a táblázatok vagy a beszkennelt archívumok döntik el, hogy egyáltalán működik-e a pipeline.
A réteg a stack elején ül, a chunking, az embeddig és a lekérdezés előtt, és a LlamaParse-szel, a Doclinggal, a Reductóval, az Azure Document Intelligence-nel, valamint a nagy felhőszolgáltatók parseoló végpontjaival versenyez. Előnye nem az, hogy minden benchmarkot megnyer, ezt a saját, közzétett számai cáfolják az open-source változatnál, hanem az, hogy a mag helyben, engedélyes licenc alatt fut: ezen a rétegen sem vektoradatbázis, sem chunker, sem hosting nem kényszerül rá.
Mi ez
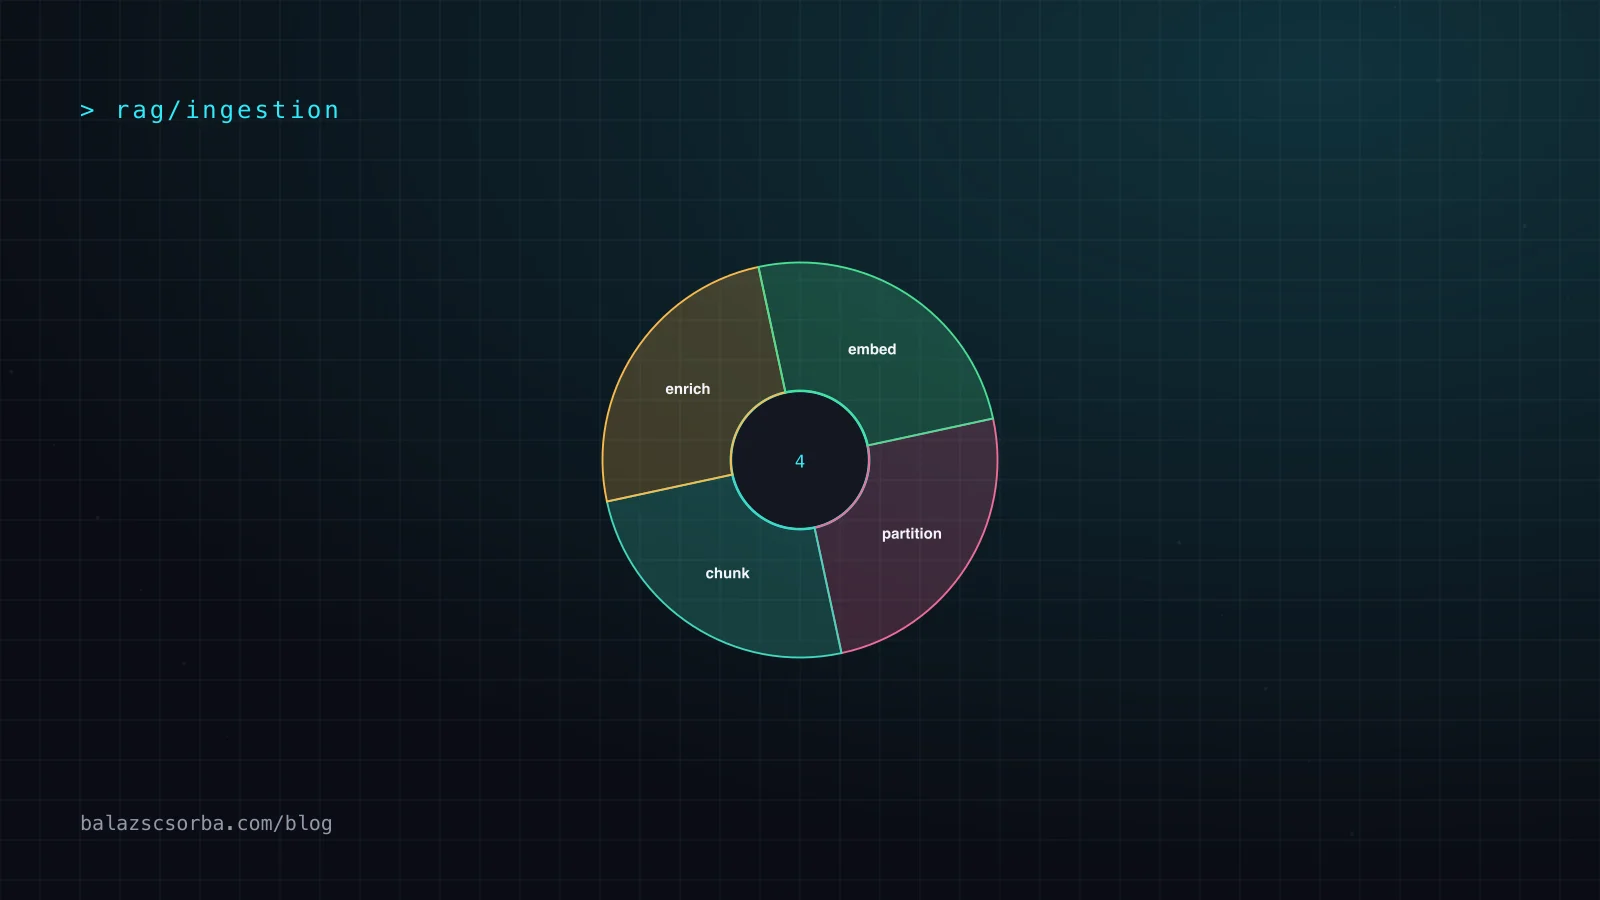
Telepítés pip install "unstructured[all-docs]" paranccsal, majd partition() hívás egy fájlra, és visszajön egy elemobjektum-lista, mindegyik típussal, szöveggel és metaadatokkal, például oldalszámmal és bounding boxszal. A strategy argumentum választja ki a folyamatot: auto, fast, hi_res és ocr_only a könyvtárban, vlm a platformtól, ami vizuális modellen küldi át az oldalakat. Eré épül a lánc, partition, chunk, enrich, embed és load, amit a platform jobként futtat, a könyvtár pedig szokásos függvényekként.
- Licenc és tulajdonos: Apache-2.0 a könyvtárhoz; a platform az Unstructured kereskedelmi terméke ingyenes tarifával, pay-as-you-go-val és egyedi tarifával.
- Lefedettség: az árlista több mint 45 támogatott fájltípust és több mint 40 csatlakozót sorol fel, több mint 20 forrásra és több mint 20 célra bontva.
- Kimenet: típusszintű elemek, mint Title, NarrativeText, Table, ListItem és Image, oldalszámmal, koordinátákkal és metaadatokkal a helyett, hogy egyetlen szövegfal jönne vissza.
- Stratégiák:
auto,fast,hi_resésocr_onlyhelyben, pluszvlmés a gazdagítási lépések a platformon. - Chunking: cím szerint, oldal szerint, karakter szerint és hasonlóság szerint, a kontextuális chunking a platform funkciója.
- Benchmarkok: az Unstructured több mint 1 000 vállalati oldalon közöl eredményeket a Reducto, a LlamaParse, a Docling, a Snowflake, a Databricks és az NVIDIA ellen.
- Telemetria: a könyvtár névtelen használati adatokat küld, hacsak nincs beállítva a
DO_NOT_TRACKvagy aSCARF_NO_ANALYTICS.
Hogyan működik
Egy futás beolvassa a fájlt, szükség esetén rendereli az oldalakat, majd a területeket elemekre osztja. A fast a beágyazott szöveget veszi és címkézi; a hi_res elrendezés-felismerést és OCR-t futtat az oldalképen, ezért lassabb, ezért kell hozzá telepített modellcsomag, és ez a stratégia adja a táblázatokat, amiket érdemes megtartani; az ocr_only a tartalék, amikor egy oldalon egyáltalán nincs szövegréteg. Ezután a chunking a elemeket karakterkeret alá gyűjti, igyekezve nem elválasztani a címet attól az abszolútól, amelyet bevezet.
A kimenetön áll vagy bukik az elemszél. Egy HTML-be, érintetlen fejlécsorral kijövő táblázat egy hasznos csomóponttá válik; ugyanaz a táblázat prózaként olvasva több chunkká szakad, amelyek mindegyike a szám felét hordozza. Ez az egész érv amellett, hogy számítson ez a réteg, és ez az egész ok arra, hogy az eredményt olvassuk, mielőtt az embeddig modellt cserélnénk.
Első lépések
A könyvtár quickstartje egyetlen függvényhívás. Az alábbi kódrészlet PDF-et dolgoz fel a felbontásnál precíz stratégiával, megtartja a táblázati szerkezetet, cím szerint chunkol, és JSON-ba írja az eredményt.
from unstructured.partition.auto import partition
from unstructured.chunking.title import chunk_by_title
from unstructured.staging.base import elements_to_json

# strategy: auto, fast, hi_res or ocr_only; hi_res is the one that keeps table structure
elements = partition(
    filename="report.pdf",
    strategy="hi_res",
    infer_table_structure=True,
)
chunks = chunk_by_title(elements, max_characters=1_200, combine_under=300)

elements_to_json(chunks, filename="report.elements.json")
print(len(elements), "elements,", len(chunks), "chunks")
A helyi kísérleten túl a platform a gondozott út: ugyanaz a partition lépés API vagy ütemezett job mögött, csatlakozók S3-hoz, SharePoint-hoz, Google Drive-hoz és a többihez, módosításfelismerés, hogy csak az új vagy módosított fájlok dolgozódjanak fel, valamint a vlm stratégia. A könyvtár marad az a hely, ahol a parseoló kód maga él, és a dokumentáció is köré épül.
Teljesítmény és költség
A platform oldalakat számláz: 10 000 ingyen az elején, utána 0,015 dollár oldalanként, így egy 400 oldalas beszkennelt archívum hat dollárnyi feldolgozás, még mielőtt bárki feltett volna egy kérdést. A könyvtár CPU-ban és valós időben számláz: a fast közel I/O-kötött, a hi_res oldalanként elrendezési modellt és OCR-t futtat, a vlm pedig a számlát a számításról a modell tokenjeire helyezi át.
| Pipeline | Adjusted CCT | Tokens added | Table cell content |
|---|---|---|---|
| Unstructured platform | 0.880 | 0.051 | 0.820 |
| Unstructured open source | 0.715 | 0.119 | 0.426 |
| LlamaParse VLM | 0.835 | 0.069 | 0.522 |
| Docling alapértelmezett | 0.716 | 0.135 | 0.657 |
A számok az Unstructured saját, több mint 1 000 vállalati oldalra végzett benchmarkjából származnak, beszkennelt számlákból, egymásba ágyazott táblázatokból és kézírásból, a szolgáltatói összehasonlítás pedig marketing, ezért a használható jel egyetlen terméken belüli rés: 0,426 szemben 0,820 táblázati cellatartalommal az open-source változat és a legjobb platform-pipeline között, és 0,715 szemben 0,880 a javított szövegpontosságon. Az element alignment, hogy területet címkéztek-e szövegként, táblázatként vagy bekezdésként, az a mutató, amelynél az összes eszköz 0,53 és 0,61 közé esik, és ez ennek a rétegnek a becsületes nehézsége.
- Egyszer parse-oljon, és tartsa meg az elem-JSON-t: ugyanazt a korpuszt chunkolási kísérlet közben újrapartitionálni ennek a rétegnek a leggyakoribb pénzégetése.
- A stratégiát dokumentumtípusonként válassza, nem korpuszonként:
fastdigitális szövegre,hi_resscannekre és minden táblázatot tartalmazó dokumentumra. - Oldalakat számoljon, ne fájlokat, mert az oldalankénti ár egy 400 oldalas PDF-et költségtétellé tesz, nem a dokumentumok számát.
Ebből semmi sem egyedi erre a szolgáltatóra: minden parseoló a recallt adja a számítási időért. Egyedi viszont, hogy a számok egyáltalán megjelennek, egy olyan táblázatban, amelyben a versenytársak nevei is szerepelnek, és ez több, mint amit a mező többi szereplője közöl.
Árazás
Két termék, egy név. A könyvtár Apache-2.0 és ingyenes: telepíti, a saját gépén futtatja, nincs fiók és nincs oldalszám. A platform ugyanez a feldolgozás kezelt jobokkal, csatlakozókkal és megfelelőséggel, oldalanként mérve.
- Könyvtár: Apache-2.0, telepítés PyPI-ről, korlátlan oldal, saját hardver.
- Ingyenes: 10 000 oldal induláskor, bankkártya nélkül, minden funkció benne van.
- Pay-as-you-go: 0,015 dollár oldalanként az első 10 000 oldal után, minden funkció benne van.
- Business: egyedi ár dedikált példányhoz, VPC-hez vagy bare metal környezethez, többfelhasználós fiókokkal, szerepalapú hozzáférés-vezérléssel és a szolgáltató megfelelőségi tanúsításaival.
Hol akad el
Kezdje a gyengeségekkel. Az open-source változat a gyengébb parseoló, és a szolgáltató saját táblázata ezt mondja: 0,426 táblázati cellatartalom szemben 0,820-zal a legjobb platform-pipelinenél, 0,119 kitalált token szemben 0,051-rel. Az ár oldalanként megy, ami a digitálisan született PDF-eket jutalmassa, a scanneket bünteti, és rossz egység az egyik oldal, amelyik egy bekezdést tartalmaz, a következő pedig egy 400 cellás táblázatot. Amiért a platformot éri meg bérelni, a VLM-particionálás, az inkrementális módosításfelismerés, a több mint 40 gondozott csatlakozó és a megfelelőség, éppen az, amit a licenc nem tartalmaz. És a kimenet továbbra is ellenőrzést kíván: az olvasási sorrend és a táblázati szerkezet a két mező, amely hiba nélkül bukik el.
| Eszköz | Mi az | Hol győz | Miről mond le |
|---|---|---|---|
| Unstructured | Könyvtár és hostolt platform | Helyi futás Apache-2.0 alatt, közzétett minőségi benchmarkkal | Oldalankénti számlázás, és az erős számokhoz a fizetős pipeline kell |
| LlamaParse | A LlamaIndex csapat hostolt parseolója | Gyors beállítás és szoros LlamaIndex-integráció | Csak hostolt, minden oldal elhagyja a hálózatot |
| Docling | Az IBM open-source parseolója | Egyetlen függőség, MIT-licenc, erős táblázati kimenet | Kevesebb fájltípus és nincs gondozott csatlakozóréteg |
| Reducto | Hostolt parsing API elrendezés-szabályozással | Táblázati pontosság és elrendezés-szabályozás szolgáltatásként | Csak API: nincs helyi futás és nincs bővíthető könyvtár |
A valódi döntés az, ki fizet a minőségért. Ha a korpusz digitálisan született szöveg, és az elfogadható kimenet elég, a strategy="fast" parancsot használó könyvtár oldalanként ingyenes, és a feladathoz megfelelő méret. Ha a táblázatok, a scannek vagy a szabályozott adatok döntik el, hogy működik-e a pipeline, akkor a platform vagy egy specializált parseoló a vásárlás, és az egyetlen számító teszt az a száz oldal a saját dokumentumokból, amelyet azokon a mezőkön pontoz, amelyeket ténylegesen olvas.
Ítélet
Az Unstructured a lekérdező pipeline elején a legbiztosabb alapértelmezés, mert unalmas, helyi és mérhető: egyetlen függvény, amely típusszintű elemeket ad vissza, egy benchmark, amellyel lehet vitatkozni, és egy fizetős szint, amelybe át lehet térni az ingestion újraírása nélkül. Valójában az dől el, hogy a terméknek mennyi parsing-minőség kell, a szolgáltató saját számai pedig azt mondják, hogy az ingyenes változat nem ugyanaz, mint a fizetős.
- Könyvtárat használjon, ha már létezik pipeline, és típusszintű elemek kellenek a nyers szöveg helyett; Apache-2.0, helyben fut, és a stack többi részének megérintése nélkül cserélhető.
- Platformot használjon, ha az oldalak S3-ból, SharePointból vagy Confluence-ből érkeznek, és csatlakozókra, módosításfelismerésre és audit trailre van szükség.
- Ne fogadja el a pénzügyi táblázatok hivatalos parseolójaként a saját dokumentumai kiértékelése nélkül; a stratégiák közti rés egy terméken belül nagyobb, mint a szolgáltatók közti.
- Ne válassza, ha a nehéz helyi függőségi fa elfogadhatatlan, mert az
unstructured[all-docs]magával húzza az OCR- és elrendezési csomagot, míg a Docling vagy egy hostolt API jóval könnyebb. - Már az elején oldalakban költségvetést készítsen; az oldalankénti ár könnyen modellezhető és beszkennelt archívumokkal könnyen túlléphető.
A dokumentumfeldolgozást mért lépésként kezelje, nem közműként: a stratégiát a saját oldalai mintáján válassza ki, tartsa meg az elem-JSON-t, és a parseolót csak akkor cserélje, amikor a táblázati számok elmozdulnak.
Források
- Unstructured dokumentáció: pipeline áttekintés
- Unstructured dokumentáció: transform quickstart
- Unstructured árazás: ingyenes oldalak, díj oldalanként és tarifák
- Unstructured benchmarkok: több mint 1 000 vállalati oldal más parseolók ellen
- Unstructured könyvtár a GitHubon
- Unstructured partition endpoint konténer
Gyakori kérdések
Az unstructured könyvtár ingyenesen használható?
Igen. A könyvtár Apache-2.0, PyPI-ról települ, és fiók vagy oldal korlát nélkül fut. A hostolt platformért kell fizetni: 10 000 ingyenes oldal induláskor, utána 0,015 dollár oldalanként.
Mi a különbség a könyvtár és a platform között?
A könyvtár a saját folyamatában partitionál, chunkol és rendez. A platform kezelt jobokat, több mint 40 gondozott csatlakozót, módosításfelismerést, hogy csak az új vagy módosított fájlok fussanak, VLM-particionálási stratégiát és megfelelőségi tanúsításokat ad hozzá. A szolgáltató benchmarkján ez 0,426 és 0,820 táblázati cellatartalomként jelenik meg.
Melyik particionálási stratégiát érdemes használni?
Az auto az alapértelmezett, fájlonként választ, a fast a beágyazott szöveget olvassa és a legolcsóbb, a hi_res elrendezés-felismerést és OCR-t futtat, ez a scannekhez és táblázatokhoz való, az ocr_only pedig a szövegréteg nélküli oldalakat kezeli. A VLM stratégia csak a platformon létezik.
Mennyibe kerül egy nagy dokumentumkészlet feldolgozása?
Az első 10 000 ingyenes oldal után 0,015 dollár oldalanként azt jelenti, hogy egy 500 oldalas scan 7,50 dollár a pay-as-you-go tarifán. A könyvtár saját üzemeltetése csak számítási időbe kerül, ezért a nagy archívumokat általában helyben dolgozzák fel, és csak a nehéz dokumentumok mennek a platformra.