Eszközök/RAG és keresés
Weaviate: egy vektordatabázis, amelynek a keresésben kell nyernie, nem csak a hasonlóságban
Weaviate teszt: hibrid BM25- és vektorkeresés egy lekérdezésben, HNSW és a lemezen futó HFresh index, kvantálási döntések, beépített MCP-kiszolgáló, és ami ma a licenckulcsok mögé kerül.
- Típus
- Vector database
- Ár
- BSD-3 · Cloud from $25 per month
Balázs Csorba··10 perc olvasás
- Vector search
- Hybrid search
- HNSW
- Quantization
- Multi-tenancy
A lényeg röviden
- A Weaviate egyetlen lekérdezésben BM25 kulcsszavas kereséssel, vektorhasonlósággal és strukturált szűrőkkel válaszol, és ez az ok, hogy egy puszta legközelebbi-szomszéd motortól meg kell előzzük.
- Az HNSW memóriakötött: a dokumentáció szerint egy csomópont 2 és 12 kB, így egymillió 1536 dimenziós vektor 2 és 12 GB index a RAM-ban, százmillió pedig 200 és 1200 GB.
- Az indextípus és a kvantálási szélesség gyakorlatilag létrehozáskori döntés. A rotációs kvantálás bitjei az RQ első bekapcsolásakor rögzülnek, utána nincs migráció.
- A gyártói benchmark a DBPedia OpenAI ada002 beágyazásokkal 97,24 százalék Recall@10 értéket, 5639 lekérdezést másodpercenként és 4,43 ms p99-et jelent egyetlen 16 vCPU-s, 128 GB-os gépen, szűrés nélkül.
- A repository a wl könyvtáron kívül BSD-3, az 1.40 pedig a Namespaces és a deduplikált mentéseket Weaviate-licenckulcs mögé teszi ugyanabban a binárisban.
A Weaviate olyan vektordatabázis, amely az objektumokat és az embeddingjeiket egymás mellett tárolja, és egyetlen lekérdezésre egyszerre válaszol BM25 kulcsszavas kereséssel, vektorhasonlósággal és strukturált szűrőkkel. Ez a nyílt forrású kategória legteljesebb keresőmotorja. A kételyem nem a visszakeresési minőségre vonatkozik, hanem a memóriaszámlára és arra, hány index- és kvantálási döntést kell meghozni az első import előtt.
Qdrant-tal a memóratakarékos indexeken, Pinecone-nal a menedzselt üzemeltetésen, pgvectorral azon érvvel verseng, hogy egy csapat, amely már adatbázist futtat, ne építsen másodikat. A Weaviate válasza az, hogy először is egy teljes adatbázis: replikáció, mentések, többértékűség, RBAC és inkrementális séma módosítás, és mellette a legközelebbi szomszéd keresés.
Mi ez
A projekt a holland Weaviate B.V.-től származik, Go nyelven írták, és a jelenlegi kiadás az 1.40.0, megjelölve 2026. október 7-én. Hivatalos kliensek vannak Pythonhoz, JavaScripthoz, Java-hoz, Go-hoz és C#-hez, és beszél REST, gRPC és GraphQL felületen. Az összehasonlítás előtt érdemes tudni alapvető tényeket:
- A hibrid keresés egy lekérdezésben fuzionálja a BM25 és a vektor eredményeket, az alpha paraméter súlyozza a két felet.
- Négy vektorindex: flat, HNSW, dynamic, amely magától áll át HNSW-re, és HFresh, az 1.36-ban bevezetett lemezes index, amely 1.38 óta általánosan elérhető.
- A kvantálás skálár, termék, bináris és rotációs eljárásokat ismer; a 4 bites rotációs kvantálás előnézet, az 1.40 pedig RQ-4 támogatást ad HNSW indexekhez.
- A beépített MCP-kiszolgáló 1.38 óta általánosan elérhető, és négy eszközt tesz elérhetővé a /v1/mcp útvonalon a REST porton.
- A többértékűség, a replikáció, a mentések, az inkrementális mentések, az objektum TTL és a collection aliasok mind az open source buildben vannak, nem csak a fizetősben.
Hogyan működik
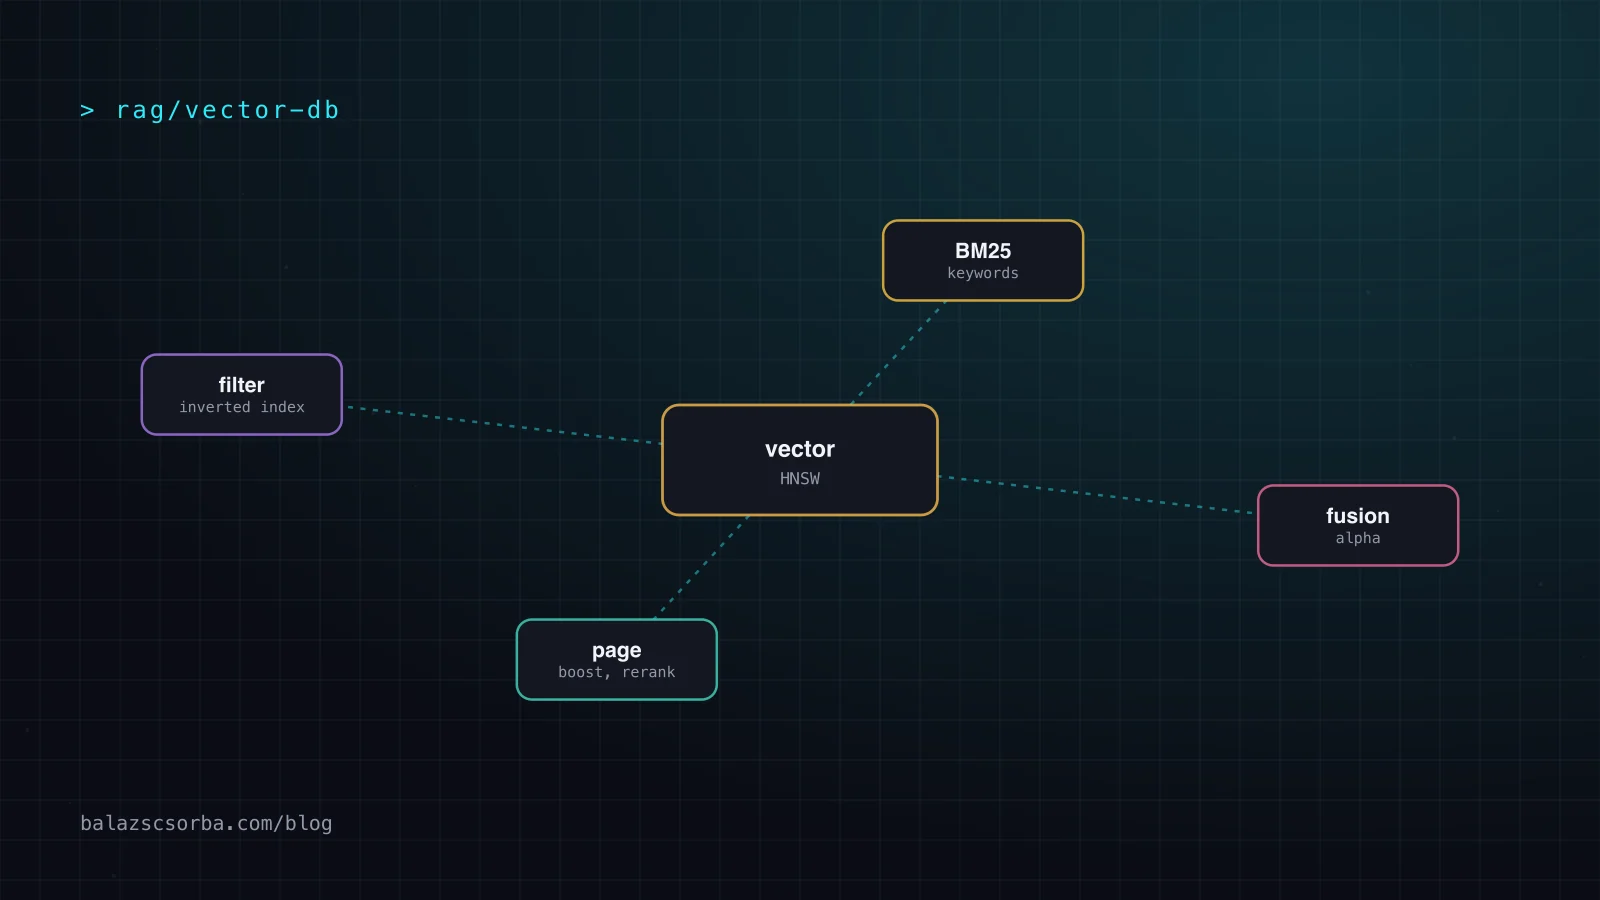
Egy lekérdezés két indexcsaláddal találkozik. Az objektumtulajdonságok fordított indexekben élnek, ugyanabban a BM25 gépezetben, amelyet egy fordított indexű keresőmotor is használ, így a szűrő még a drága művelet előtt szűkíti a jelöltek halmazát. A vektorok a vektorindexben vannak, ahol az HNSW egy memóriában tartott rétegzett gráfon halad végig. Az eredmény összefúzódik, opcionálisan boostolódik és opcionálisan újrarangsorolódik.
Két következmény adódik. A szűrt keresés olcsó marad, mert a szűrő először fut. Az drága rész mindig a vektorindex, és ott van az üzemeltetési költség. A QUERY_HYBRID_MAXIMUM_RESULTS alapértéke 200, vagyis a hibrid lekérdezés mindkét fele legalább ennyi jelöltet szed be a fúzió előtt; ez az első gomb, amit meg kell fordítani, ha egy lekérdezés lassabb a benchmarknál.
Első lépések
A Python kliens az, amivel érdemes kezdeni. Egy collection HNSW indexszel, kvantálással, hibrid kereséssel, szűrővel, boosttal és diverzitásválasztással, körülbelül harminc sorban:
from datetime import timedelta

import weaviate
from weaviate.classes.config import Configure, VectorDistances
from weaviate.classes.query import Boost, Diversity, Filter

client = weaviate.connect_to_local()  # or connect_to_cloud(cluster_url, auth)

client.collections.create(
    "Product",
    vector_config=Configure.Vectors.text2vec_openai(
        source_properties=["name", "description"],
        vector_index_config=Configure.VectorIndex.hnsw(
            distance_metric=VectorDistances.COSINE,
            quantizer=Configure.VectorIndex.Quantizer.rq(bits=8),
        ),
    ),
)

products = client.collections.get("Product")
products.data.insert_many([
    {"name": "Kestrel Wireless Headphones", "in_stock": True, "released": "2026-09-20"},
    {"name": "Aurora Wireless Headphones", "in_stock": False, "released": "2025-11-02"},
    {"name": "Nimbus Wireless Headphones", "in_stock": True, "released": "2026-10-05"},
])

boost = Boost.blend(
    [
        Boost.filter(Filter.by_property("in_stock").equal(True), weight=2.0),
        Boost.time_decay("released", scale=timedelta(days=30)),
    ],
    weight=0.3,   # 30 percent boost, 70 percent original relevance
    depth=200,    # re-score the top 200 candidates
)

hits = products.query.hybrid(
    query="wireless headphones",
    limit=4,
    filters=Filter.by_property("released").greater_than("2025-01-01"),
    boost=boost,
    diversity_selection=Diversity.mmr(limit=4, balance=0.3),
)
for hit in hits.objects:
    print(hit.properties["name"])
Négy részlet ebben a snippetben dönti el, milyen lesz az oldal. A Boost.blend soha nem töröl eredményt, csak újrarangsorol, tehát a feltétel negatív súlya süllyeszt és nem szűr. A depth megadja, hány jelöltet értékelünk újra, a külső weight pedig azt, hogy a boost hányadrészt birtokolja a végső pontszámból. Az MMR kliens 4.23.0 vagy újabb verziót igényel, és a balance alapértéke 0.0, ami tiszta diverzitást jelent, nem semleges középet. Ha a boostot és a reranket együtt használod, a reranker fut utolsóként, és az mondja ki a végső szót.
Indexek, memória és a számla
Az HNSW a csomópontokat és az éleket a memóriában tartja, és a dokumentáció szokatlanul nyílt a költséggel: egy csomópont dimenzionalitástól függően 2 és 12 kB, tehát egymillió vektor 2 és 12 GB, százmillió vektor 200 és 1200 GB, vektoronként körülbelül 200 bájttal élve. Ez a szám a kapacitástervezésbe megy, nem az átviteli célok közé.
| Index | Memória | Keresési viselkedés | Mire való |
|---|---|---|---|
| Flat | Nagyon alacsony | Pontos, lineáris átnézés | Kis collectionök és a bérlőnkénti adatok többértékűségnél |
| HNSW | Magas, minden a memóriában | Leggyorsabb; logaritmikus a gráfban | Nagy collectionök nagy lekérdezési átvitellel |
| HFresh | Alacsony, a postingok a lemezen | Néhány posting listát olvas, majd újraértékel | A memória a szűk keresztmetszet; a kissé magasabb p99 rendben van |
Nagy korpuszoknál az HFresh az érdekes. Csoportosítja a vektorokat lemezes postingokba, a memóriában pedig csak a centroidokon futó, 8 bites kvantálású HNSW indexet tartja, a postingokat magukat 1 bittel. A keresés csak a centroidindex által kiválasztott postingokat olvassa, majd a jelölteket tömörítetlen vektorokon értékeli újra. A dokumentáció pontos: csak koszinusz és l2-squared távolság támogatott, a skalárszorzat nem, és nyers átvitelben nem az HNSW legyőzésére készült. A recall paramétereket latenciaállítóként érdemes olvasni: a searchProbe az, hogy egy lekérdezés hány posting listát jár be, a replicas az, hogy egy vektor hány listába kerül, a maxPostingSizeKB pedig a fürtméret.
A kvantálás a másik emelő. A rotációs kvantálás úgy forgatja el a vektort, hogy az értékei egyenletesen oszoljanak a dimenziókra, majd minden dimenziót kis egész kódként tárol. 4 bitnél és 1536 dimenziónál egy vektor 784 bájt, szemben a nyers float32 6144 bájtjával, ami 7,84, nem kerek 8, mert a 16 bájtos rotációs fejléc megmarad. A tömörítés csökkenti a memóriát és a számítást, de nem a cloud által számlázott dimenziók számát: a Weaviate Cloud Flex csomagban havonta egymillió vektordimenzióonként 0,00465 dollártól számol, a tárolás GiB-nként 0,12 dollártól, havi 45 dolláros minimummal, és az erősebb tömörítés alacsonyabb dimenzióonkénti árban jelenik meg, nem kisebb számlában.
A gyártói benchmarkot csak a módszertannal együtt érdemes olvasni. A DBPedia OpenAI ada002 beágyazásokkal, egymillió objektum 1536 dimenzióval és koszinusz távolsággal az ajánlott efConstruction 256, maxConnections 16 és ef 96 konfiguráció 97,24 százalék Recall@10 értéket ad 5639 lekérdezés másodpercenként, 2,80 ms átlagos és 4,43 ms p99 latenciával. Ez 10 000 szűretlen keresés egyetlen GCP n4-highmem-16 példányon, 16 vCPU-val és 128 GB memóriával, a Go klienssel ugyanabban a VPC-ben, és minden találat objektuma visszaolvasásra kerül a lemezről. A scriptek open source-ok, és ez a legfontosabb részük.
Ahol nyiklik
Először a gyengeségek, mert ezek döntik el, hogy ez-e a megfelelő adatbázis. Az HNSW-en a növekedés memóriagörbe, nem vízszintes görbe: százmillió 1536 dimenziós vektor több száz gigabájtos tervezési feladat, és további csomópontok nem zsugorítják egy shard indexét. A törlés aszinkron, így a törlés utáni keresés még visszaadhatja az objektumot. Az API felület elég széles ahhoz, hogy a GraphQL, a gRPC, a gRPC-Web és egy negyedik, kísérleti REST keresési API egymás mellett létezzen, az 1.39 release note pedig kimondja, hogy az új REST API referenciaválasztása lecserélésre kerül, tehát az arra írt kód még változni fog.
| Adatbázis | Indexmodell | Önálló telepítés | Ahol fáj |
|---|---|---|---|
| Weaviate | HNSW, flat, dynamic, HFresh | Egy adatbázis: replikáció, mentések, RBAC, többértékűség | Memóriakötött növekedés; több sémafelület, amit tanulni kell |
| Qdrant | HNSW lemezes és skalár kvantálással | Fókuszált vektormotor szűréssel | A Weaviate által szállított adatbázisfunkciók egy része hiányzik |
| pgvector | Postgres indexek: HNSW, IVFFlat | Nincs: egy már futó adatbázis kiterjesztése | A recall és a hangolás mostantól Postgres hangolás |
| Pinecone | Csak menedzselt | Nincs mit futtatni | Nincs önálló telepítés, és a számla az olvasási egységekkel skálázódik |
Két üzemeltetési megjegyzés zárja a képet. Az aszinkron replikációt az 1.38-ban klaszterszinten egyetlen ütemezőre építették át, és mostantól minden replikált collectionben alapértelmezetten fut, ami megbízhatósági nyereség és egyben háttérterhelés. Az 1.40-ban pedig az új Namespaces funkció, amely control plane és adatizolációt ad a közös klasztert használó felhasználók között, Weaviate licenckulcs mögé került.
MCP hozzáférés és a licenchatár
Az MCP-kiszolgáló az, amivel a legtöbb csapat először találkozik. Streamable HTTP kiszolgáló a /v1/mcp útvonalon a REST porton, saját telepítésen alapból kikapcsolva, a Weaviate Cloudban mindig bekapcsolva, hitelesítve API kulcs bearer tokenként. Négy eszközt tesz elérhetővé: weaviate-collections-get-config a sémákhoz, weaviate-tenants-list, weaviate-query-hybrid hibrid kereséshez, alapértelmezett 0,75 alpha értékkel, és weaviate-objects-upsert az íráshoz. A jogosultságok a szokásos RBAC szerepek, és eszközhíváskor ellenőrzöttek.
A licencelésben a repository LICENSE egyértelmű: a wl könyvtáron kívüli kód BSD-3-Clause, a benne lévő kód Weaviate B.V. szerzői jogú, és csak külön enterprise licenc alatt érhető el, licenckulccsal feloldva, a BSD licenc pedig nem ad jogot ezeknek a funkcióknak a használatához vagy a kulcs megkerüléséhez. Az 1.40 a Namespaces és a deduplikált mentések funkciókat teszi e vonal másik oldalára. Az adatbázis maga BSD-3 marad és használati korlát nélkül telepíthető, így az egyetlen valódi kérdés az, hogy a roadmap mennyi része kerül a kulcs mögé.
Ítélet
A Weaviate akkor a választott vektordatabázis, ha a visszakeresési minőség és az üzemeltetési teljesség fontosabb a legkisebb memóriaköltségnél, és ha a csapat az indextípust, a kvantálási szélességet és az ef értéket valódi paraméternek tudja kezelni, nem alapértelmezésnek. Rossz válasz azoknak a csapatoknak, amelyek már futtatnak Postgrest, és az embeddingeket a sorok mellé akarják tenni, és azoknak is, akik százmilliós vektorkorpuszt néznek szigorú memória keret mellett.
- Válaszd, ha a lekérdezéseknek a vektorok mellett szűrő és kulcsszó is kell, és ezt egy menetben akarod megkapni három helyett.
- Válaszd, ha többértékűség, replikáció, mentések és RBAC kell anélkül, hogy négy szolgáltatást tennél egy meztelen vektorindexre.
- Válaszd, ha BSD-3 adatbázist tudsz magad üzemeltetni, és ugyanazt az API-t akarod menedzselt opcióként is.
- Kerüld, ha a korpusz akkora, hogy a HNSW memóriája uralja a számlát, és a kissé magasabb p99 elfogadható; ez az HFresh feladata, vagy egy célra épített motoré.
- Kerüld, ha azt várod, hogy a teljes roadmap a BSD licenc alatt marad. Nézd meg, mely funkciókat zárja licenckulcs mögé az adott verzió, mielőtt erre tervezel.
Források
Gyakori kérdések
Ingyenes marad a Weaviate önálló telepítése?
Az adatbázis BSD-3-Clause, és korlátozás nélkül telepíthető saját infrastruktúrára. A repository LICENSE egyértelmű: a wl könyvtárban lévő kód proprietáris, és enterprise licencoldal kapcsolja be, az 1.40 pedig a Namespaces funkciót és a deduplikált mentéseket e kulcs mögé teszi. A cloud csomagok: ingyenes szint, Flex havi 45 dollártól, Premium havi 400 dollártól.
HNSW vagy HFresh nagy kollekcióhoz?
Az HNSW a leggeschwinderebb és az alapértelmezett, de a teljes gráfot a memóriában tartja. A HFresh csak egy tömörített centroid-indexet tart a RAM-ban, a posting listákat lemezről olvassa, és a dokumentáció szerint nem a nyers átviteli sebesség legyőzésére készült. A HFresh akkor jó választás, ha a memória a szűk keresztmetszet, és a kissé magasabb p99 rendben van.
A kvantálás csökkenti a Weaviate Cloud számláját?
Nem. A cloud a tárolt vektordimenziók számával számol, plusz tárolás és mentések, a tömörítés pedig nem változtatja meg ezt a számot. Csökkenti a Weaviate memőzigényét és számítását, ami a dimenziónkénti listaárban jelenik meg, nem a számlán csökkenő dimenziókban.
Kérdezhet-e egy ügynök a Weaviate-ot MCP-n át?
Igen, az 1.38 óta a adatbázis saját MCP-kiszolgálót tartalmaz a /v1/mcp útvonalon a REST porton, négy eszközzel: weaviate-collections-get-config, weaviate-tenants-list, weaviate-query-hybrid és weaviate-objects-upsert. Saját telepítésen alapból ki van kapcsolva, a Weaviate Cloudban mindig fut, ott az író eszköz is elérhető, kivéve ha a fürt Enable MCP Read-Only kapcsolója be van állítva.
Mekkora lehet egy HNSW-kollekció, mielőtt a memória szűk keresztmetszet?
A dokumentáció az HNSW-csomópontot dimenzionalitástól függően 2 és 12 kB-ra becsüli, vektoronként körülbelül 200 bájt éllással. Ez 2 és 12 GB egymilliónál, 200 és 1200 GB százmilliónál. A két emelő a rotációs kvantálás és a HFresh; a vektortár alapértelmezett felső korlátja kollekciónként 1e12 objektum.