Blog/Web-Engineering
Headless B2B-Produktkonfigurator: Regeln, Preise und Nuxt auf einer Commerce-API
So baust du einen B2B-Produktkonfigurator headless: Regelwerk oder Solver, wo Regeln liegen, Preise auf dem Server, Nuxt auf Commerce-API, TYPO3, 100k+ Varianten.
Balázs Csorba··12 Min. Lesezeit
- Product configurator
- B2B e-commerce
- Nuxt
- Headless commerce
Das Wichtigste in Kürze
- Behandle den Konfigurator als kleinen Dienst mit drei Aufgaben (was erlaubt ist, was es kostet, was der Shop zum Verkauf braucht), nicht als Frontend-Widget mit eingebauten Regeln.
- Starte mit einem deklarativen Regelwerk; greife erst zu einem Constraint-Solver, wenn Regeln so stark zusammenhängen, dass du gültige Kombinationen nicht aufzählen oder einen Konflikt nicht erklären kannst.
- Regeln gehören dorthin, wo die Produktdaten gepflegt werden (meist das PIM), Preise dorthin, wo sie verantwortet werden (meist das ERP); der Shop erhält nur ein validiertes Ergebnis.
- Der Browser darf eine Vorschau zeigen, aber der Server muss beim Warenkorb und beim Angebot erneut validieren und bepreisen, denn clientseitige Validierung lässt sich trivial umgehen.
- Bei über 100.000 Varianten lieferst du nie die Variantenliste aus: Du fragst den Server nach den nächsten gültigen Optionen und machst diesen Dialog tastatur- und screenreader-tauglich.
Ein Produktkonfigurator sieht nach einem Frontend-Problem aus, bis der erste echte Katalog kommt. Dann zeigt sich: Es ist ein Datenproblem (woher kommen die Regeln?), ein Preisproblem (wer darf sagen, was das kostet?) und ein Vertrauensproblem (kann der Shop genau das verkaufen, was der Kunde konfiguriert hat?). Im B2B, wo eine falsche Kombination das falsche Teil in einer Maschine bedeutet, wiegt Letzteres am schwersten.
So würde ich 2026 einen B2B-Produktkonfigurator (ein „CPQ-lite": konfigurieren, bepreisen, anbieten, ohne die volle CPQ-Suite) headless bauen. Grundlage ist ein geführter Konfigurator für mehr als 100.000 Artikel der Präzisionstechnik mit automatisierter Preisberechnung, gebaut in Nuxt.js auf der Spryker Glue API (siehe die Meusburger-Referenz). Der Artikel bleibt bei Architektur und Abwägungen und beschreibt das Projekt darüber hinaus nicht.
Was ein B2B-Konfigurator wirklich leisten muss
Ohne Oberfläche macht ein Konfigurator vier Dinge. Er schränkt Auswahlmöglichkeiten ein, sodass nur gültige Kombinationen erreichbar sind. Er leitet Werte ab, die der Käufer nicht tippen soll (Artikelnummer, Gewicht, Lieferzeit). Er bepreist das Ergebnis, oft mit Staffel- oder Vertragspreisen. Und er übergibt eine Konfiguration, die der Rest des Unternehmens nutzen kann: eine Warenkorbposition, ein Angebot, eine Zeichnungsanfrage.
Der typische Fehler ist, alle vier im Frontend zu bauen, weil dort die Demo entsteht. Das Ergebnis sind Regeln, die sich ohne Browser nicht testen lassen, Preise, die der Client sehen und schlimmer noch beeinflussen kann, und ein Shop, der alles glauben muss, was ankommt. Ich würde das System in eine dünne Oberfläche und einen Konfigurationsdienst teilen, der die ersten drei Aufgaben besitzt, und die vierte der Commerce-Plattform überlassen.
Regelwerk oder Constraint-Solver
Historisch begannen Konfiguratoren mit Produktionsregeln; die danach entstandenen modellbasierten, constraint-basierten Ansätze trennen Produktwissen von der Lösungsstrategie, sodass Änderungen an dem einen das andere nicht beschädigen, wie der Wikipedia-Artikel zur wissensbasierten Konfiguration beschreibt. Das ist der praktische Punkt: Welche Technik du auch wählst, die Regeln sollten Daten sein, keine Codepfade.
Ein deklaratives Regelwerk wertet Bedingungen wie „wenn der Werkstoff X ist, sind Durchmesser über Y nicht erlaubt" gegen die aktuelle Auswahl aus. Es lässt sich dem Produktmanagement leicht erklären, gut unit-testen (Auswahl rein, erlaubte Optionen raus) und ist schnell. Ein Constraint-Solver wie OR-Tools CP-SAT behandelt das Produkt als Variablen und Constraints und sucht gültige Belegungen; er arbeitet über ganzen Zahlen, Dezimalmaße müssen also skaliert werden. Er glänzt, wenn Constraints so zusammenspielen, dass du sie nicht von Hand ordnen kannst, und wenn du „Was ist die nächstgelegene gültige Konfiguration?" beantworten willst.
Mein Standard ist das Regelwerk, mit Regeln in einem Format, das später auch ein Solver lesen könnte. Die meisten Katalogprodukte sind eigentlich Familien mit einigen Dutzend zusammenhängenden Parametern, und die Erklärbarkeit einer Regel („diese Option ist wegen Regel 42 gesperrt") ist dem Support mehr wert als die Allgemeinheit eines Solvers. Die Tabelle ist meine Entscheidungshilfe.
| Situation | Einsatz | Warum | Worauf achten |
|---|---|---|---|
| Produktfamilien mit Parameterbereichen und einigen Dutzend Abhängigkeiten | Regelwerk | Transparent, testbar, vom Produktmanagement pflegbar | Regelreihenfolge und überlappende Regeln; deklarativ halten und unit-testen |
| Viele zusammenhängende Optionen, keine klare Auswertungsreihenfolge | Constraint-Solver | Findet gültige Belegungen und Konflikte ohne handgeschriebene Reihenfolge | Ganzzahlige Modellierung, Antwortzeit, Fehler den Nutzern erklären |
| „Nichts ist gültig, was kommt am nächsten?" muss beantwortet werden | Constraint-Solver | Kann Constraints lockern und Alternativen suchen | Braucht ein klares Ziel, was „am nächsten" heißt |
| Überwiegend feste Varianten, Auswahl ist ein Filter | Facettensuche, keine Engine | Die Varianten existieren schon als Artikel; filtern und sortieren | Keinen Konfigurator bauen, wo eine Suchseite reicht |
| Regeln gehören Nicht-Entwicklern, die sie wöchentlich ändern | Regelwerk mit Editor | Regeln als Daten mit Versionierung und Review | Governance: Wer darf eine Regel veröffentlichen, wie wird sie getestet |
Prüfe vor dem Bauen, ob du überhaupt einen Konfigurator brauchst. Existieren die Varianten als verkaufbare Artikel, ist ein guter filterbarer Katalog billiger und robuster. Ein Konfigurator lohnt sich dort, wo der Kombinationsraum zu groß zum Aufzählen ist oder Werte abgeleitet statt gewählt werden.
Wo die Regeln liegen: PIM, ERP oder Shop
Die Frage, die im zweiten Jahr die Wartungskosten bestimmt, ist nicht die Engine, sondern wem welches Wissen gehört. Meine Faustregel: Regeln liegen bei den Produktdaten, die sie begründen (typischerweise im PIM), Preise dort, wo sie verantwortet werden (typischerweise im ERP, im Shop gecacht), und der Shop besitzt nie Konfigurationslogik. Ihm gehören Warenkorb, Checkout und Kundenbeziehung.
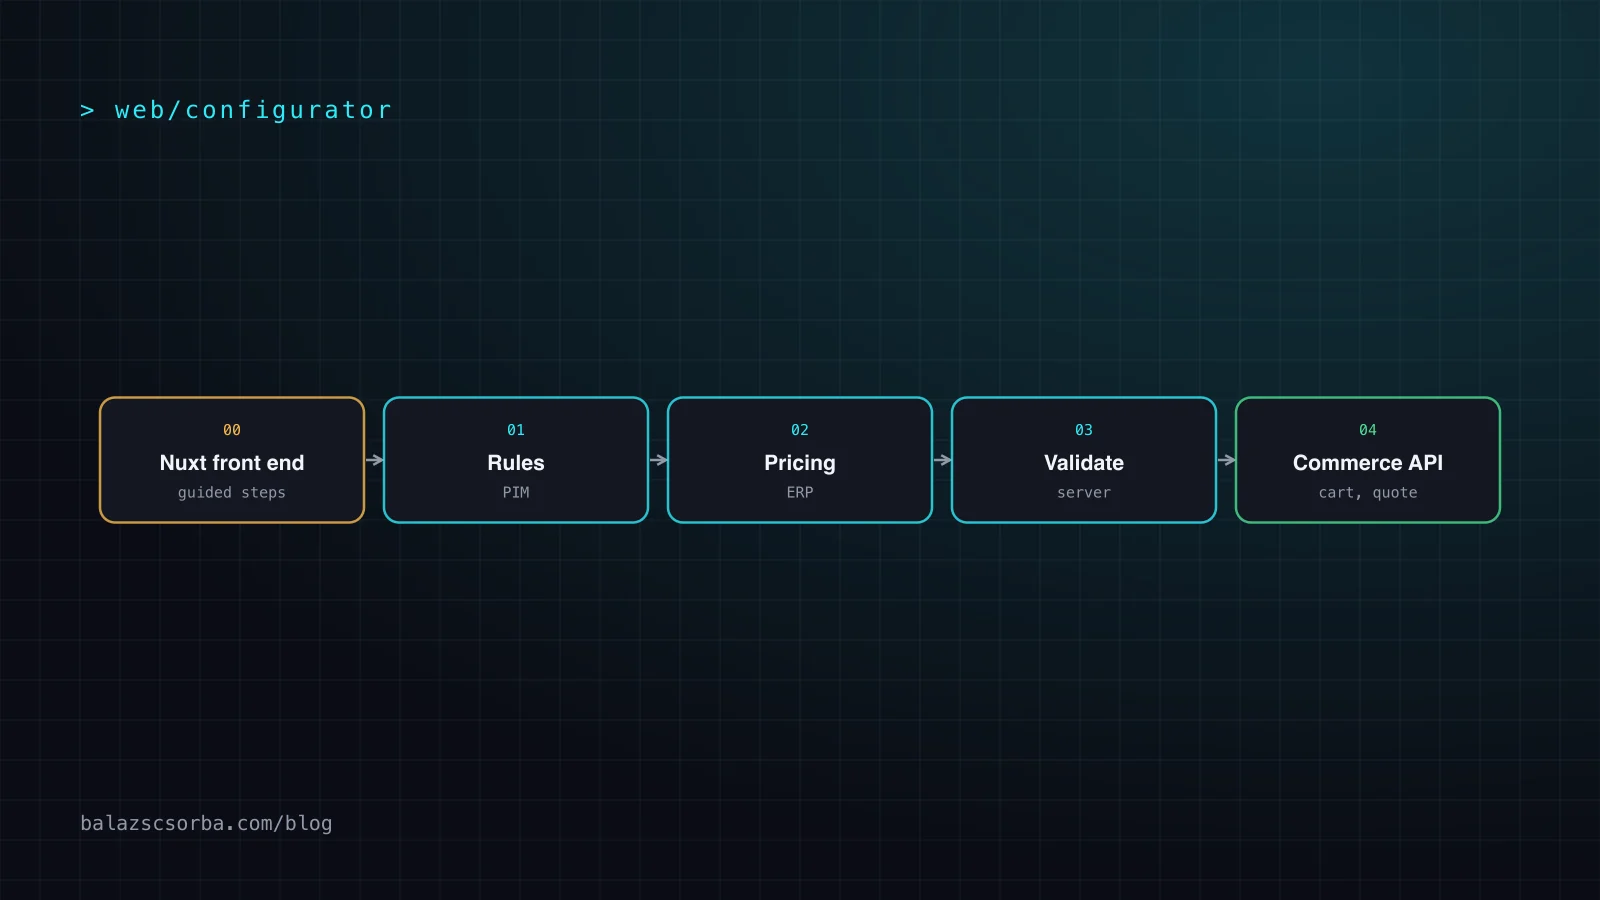
Die folgende Architektur stellt einen Konfigurationsdienst zwischen das Nuxt-Frontend und die Commerce-API. Der Dienst liest Attribute und Regeln aus dem PIM, Preise und Verfügbarkeit aus dem ERP und liefert Optionen, abgeleitete Werte, Preis und ein Validierungsergebnis. Die Commerce-API erhält nur Konfigurationen, die dieser Dienst validiert hat.
Aus dieser Trennung folgen drei Konsequenzen.
- Eine Quelle pro Fakt. Existiert eine Regel im PIM und noch einmal im Shop, ist eine davon binnen eines Quartals falsch. Veröffentliche Regeln aus dem PIM in den Dienst (etwa als versioniertes Artefakt), statt sie neu zu erfassen.
- Der Dienst ist zustandslos über einer Auswahl. Jeder Aufruf trägt die volle Auswahl und den Kontext (Kunde, Preisliste, Sprache). Das macht ihn cachebar, testbar und horizontal skalierbar.
- Der Shop sieht ein Ergebnis, keinen Prozess. Spryker dokumentiert zum Beispiel ein Product-Configuration-Feature mit Glue-API-Modulen, die Konfigurationsdaten an Warenkorbpositionen tragen (Spryker-Dokumentation). Welche Plattform du auch nutzt: Prüfe, wie sie eine Konfiguration an einer Warenkorbposition speichert und ob sie sie bepreisen kann, bevor du ein eigenes Format entwirfst.
Preislogik, ohne sie preiszugeben
B2B-Preise sind selten eine einzelne Zahl. Sie kombinieren Grundpreis, Optionsaufschläge, Mengenstaffeln, kundenspezifische Vereinbarungen und manchmal Bearbeitungs- oder Rüstkosten. Ich würde die Preisberechnung auf dem Server im Konfigurationsdienst halten, als reine Funktion von Auswahl, Menge und Kundenkontext, die das ERP oder die vom ERP gepflegte Preisliste aufruft.
Das Frontend zeigt dann einen Preis, den der Server geliefert hat, und kennzeichnet ihn so. Ändert der Käufer die Menge, frage erneut an. Berechne den Endpreis nie aus Zahlen, die an den Browser geschickt wurden; diese Zahlen sind Eingaben für die Anzeige, nicht für die Bestellung.
Zwei praktische Punkte. Erstens: Entscheide früh, ob der Konfigurator einen verbindlichen oder einen indikativen Preis zeigt; brauchen manche Positionen ein manuelles Angebot (Sondertoleranzen, große Mengen), bilde das als ausdrückliches Ergebnis ab („Angebot anfragen") statt als fehlenden Preis. Zweitens: Halte Rundung, Währung und Steuerregeln an einem Ort, sonst weichen Konfigurator, Warenkorb und Rechnung um Cent ab und du suchst tagelang nach dem Grund.
Das Nuxt-Frontend auf einer Commerce-API
Im Frontend würde ich den Konfigurator als geführten Dialog über den Server bauen, nicht als clientseitige Zustandsmaschine, die die Regeln kennt. Jeder Schritt sendet die aktuelle Auswahl an den Konfigurationsdienst und rendert die zurückkommenden Optionen, wobei gesperrte Optionen einen Grund tragen. Nuxt passt gut, weil Server-Routen (Nitro) als Backend-for-Frontend dienen können: Der Browser spricht mit deinen eigenen Endpunkten, die ihrerseits Konfigurationsdienst und Commerce-API mit Zugangsdaten aufrufen, die nie den Client erreichen.
- Auswahl in der URL. Kodiere die Auswahl im Query-String, damit sich eine Konfiguration teilen, merken und wiederherstellen lässt. Das macht auch Tests einfach: Eine URL ist ein Testfall.
- Servergesteuerte Schritte. Der Server liefert den nächsten Schritt, die gültigen Optionen und die Gründe für gesperrte. Einen Parameter hinzuzufügen wird zur Datenänderung, nicht zum Release.
- Optimistische Vorschau, maßgebliches Ergebnis. Zeige billiges lokales Feedback sofort, aber behandle die Serverantwort als Wahrheit und gleiche ab.
- Übergabe über die Commerce-API. Am Ende ruft das BFF auf, validiert noch einmal und schreibt die Konfiguration über die Plattform-API (bei Spryker die Glue API) in Warenkorb oder Angebot.
Willst du zusätzlich einen KI-Assistenten, der Käufern hilft zu beschreiben, was sie brauchen („eine Platte für ein Werkzeug, gehärtet, 300 mm"), lass ihn eine Auswahl vorschlagen und schicke diese durch denselben Dienst. Das Modell schlägt vor, die Regeln entscheiden. Zur Agentenseite siehe Agentic-Commerce-Protokolle, und um den Ablauf für Browser-Agenten bereitzustellen, WebMCP. Lieferst du einen Assistenten aus, bewerte ihn wie jedes andere Produktfeature, etwa wie in LLM-Evals für Produktfeatures.
Integration mit TYPO3 oder einem anderen CMS
Suchen nach „Produktkonfigurator TYPO3" kommen meist von Unternehmen, die TYPO3 schon für die Marketing-Site betreiben und den Konfigurator darin haben wollen. Das saubere Muster ist eine Arbeitsteilung: Das CMS besitzt Inhalte, Navigation, Landingpages und SEO; der Konfigurator besitzt die Konfiguration. TYPO3 rendert die Seite und bindet den Konfigurator ein, entweder als eingebettete Nuxt-App oder als Extension-Plugin, das denselben Konfigurationsdienst aufruft.
TYPO3 sollte nur Kontext übergeben: Sprache, Kundengruppe, Kennung der Produktfamilie. Es sollte keine Regeln oder Preise halten. Sobald eine Regel in einem Inhaltselement oder einer TypoScript-Bedingung steckt, kann sie das Produktmanagement nicht testen und finden Entwickler sie nicht mehr. Das gilt für jedes andere CMS und für die Wahl zwischen Einbettung und vollständig headless Frontend: Je mehr der Konfigurator von der Seite besitzt, desto konsistenter das Erlebnis, aber desto mehr gibst du den CMS-Vorschau-Workflow auf, den deine Redakteure mögen.
Performance mit über 100.000 Varianten
Ein Katalog mit über 100.000 Artikeln verändert, wie du über Performance denkst, weil es keine Liste zu rendern gibt. Das Prinzip ist einfach: Liefere die Variantenliste nie an den Browser aus; frage den Server, was als Nächstes gültig ist.
- Modelliere das Produkt, nicht die Varianten. Attribute plus Regeln beschreiben den Raum; Varianten werden nur bei Bedarf materialisiert (Artikelnummer, Preis).
- Indexiere für den Zugriff. Durchsuchbare Attribute kommen in eine Suchmaschine, sodass „welche Optionen bleiben?" eine Index-Abfrage ist, kein Table-Scan.
- Cache nach Auswahl. Options-Abfragen für dieselbe Auswahl und denselben Kontext sind identisch; cache sie am Edge oder im Dienst und schlüssele den Cache nach Regelwerk- und Preislisten-Version.
- Halte Payloads klein. Liefere nur den nächsten Schritt, nicht den ganzen Baum, und komprimiere ihn.
- Virtualisiere, was lang ist. Braucht ein Schritt wirklich eine lange Liste (etwa hunderte Durchmesser), rendere nur das sichtbare Fenster: Virtualisierung recycelt DOM-Knoten, die den Viewport verlassen, sodass die Zahl gerenderter Elemente dem Fenster folgt, nicht den Daten.
- Miss den ganzen Dialog. Die Kennzahl ist „Zeit vom Klick bis zu aktualisierten, gültigen Optionen", p95, einschließlich ERP-Preisabfrage. Budgetiere sie und teste sie mit echten Auswahlen.
Validierung auf dem Server, Speichern und Angebote
Alles, was der Browser durchsetzt, muss der Server noch einmal durchsetzen. Das OWASP Input Validation Cheat Sheet sagt klar, dass Eingabevalidierung serverseitig umgesetzt werden muss, weil clientseitige Validierung leicht umgangen wird, und bevorzugt Allow-Lists: genau definieren, was erlaubt ist. Für einen Konfigurator heißt das: Der Server akzeptiert nur Auswahlen, die unter dem aktuellen Regelwerk gültig sind, und berechnet abgeleitete Werte und Preis neu, statt empfangenen zu vertrauen.
Behandle eine Konfiguration als unveränderliches, versioniertes Dokument. Eine kompakte Form funktioniert gut:
- Identität: Konfigurations-ID, Produktfamilie, erstellender Kunde und Zeitstempel.
- Auswahl: die gewählten Parameterwerte, nichts Abgeleitetes.
- Versionen: Regelwerk- und Preislisten-Version zum Zeitpunkt der Erstellung.
- Ergebnis: abgeleitete Werte, Preisaufschlüsselung und die Artikelnummer oder ein Kennzeichen „manuelle Prüfung nötig".
Speichern heißt dann, dieses Dokument zu schreiben; Angebot heißt, es mit einer Gültigkeitsdauer einzufrieren und mit dem Angebot zu verknüpfen. Wird ein Angebot angenommen, validiere vor der Bestellung gegen die aktuellen Regeln neu: Hat sich zwischenzeitlich eine Regel geändert, sollte der Käufer es erfahren, bevor es die Produktion tut. Ob du das Dokument im Konfigurationsdienst oder auf der Commerce-Plattform hältst, ist zweitrangig gegenüber der Frage, ob es vollständig und wiederholbar ist.
Barrierefreiheit ist eine Konfigurator-Anforderung
Ein Konfigurator ist ein dichtes, dynamisches Formular, und genau dort bricht Barrierefreiheit meist. Der praktische Grund ist einfach: Ein Käufer, der deinen Konfigurator nicht bedienen kann, kann nicht bestellen. Das sind die Prüfungen, die ich anwende, zugeordnet zu WCAG 2.2:
- Sag in Text, was falsch ist. Erfolgskriterium 3.3.1 verlangt, dass ein Eingabefehler erkannt und in Text beschrieben wird. „Dieser Durchmesser ist mit gehärtetem Stahl nicht verfügbar" schlägt einen roten Rahmen.
- Kündige Änderungen an, ohne den Fokus zu stehlen. Wenn sich Preis oder Optionsliste aktualisieren, erwartet 4.1.3 Statusmeldungen, dass die Änderung programmatisch ermittelbar ist, etwa mit role="status" für Updates und role="alert" für Fehler, damit Screenreader sie ansagen, ohne den Fokus zu bewegen.
- Ausreichend große Ziele. 2.5.8 setzt für Zeigerziele ein Minimum von 24 mal 24 CSS-Pixeln, mit Ausnahmen; Farbfelder und kleine Stepper sind die Stellen, an denen Konfiguratoren scheitern.
- Nutze bewährte Muster. Bevorzuge native Radiobuttons, Selects und Zahlenfelder; wo du eine durchsuchbare Optionsliste brauchst, folge dem ARIA-Combobox-Muster samt Tastaturbedienung.
- Gesperrte Optionen brauchen Gründe. Eine nur ausgegraute Option ist für Screenreader-Nutzer eine Sackgasse; gib den Grund als Text aus.
Automatische Prüfwerkzeuge finden nur einen Teil davon. Spiele den kompletten Ablauf mit Tastatur und mindestens einem Screenreader durch, bevor du ihn für fertig erklärst.
Eine Checkliste vor dem Go-live
Bevor ein Konfigurator live geht, will ich zu jedem dieser Punkte ein Ja:
- Jede Regel ist Daten mit Verantwortlichem, Version und Unit-Test.
- Regeln kommen aus einer Quelle (meist dem PIM), und das Veröffentlichen eines Regelwerks ist ein geprüfter Schritt.
- Preise werden auf dem Server aus einer versionierten Preisliste berechnet; der Browser entscheidet nie über einen Preis.
- Warenkorb und Angebot validieren und bepreisen neu; eine manipulierte Anfrage wird abgelehnt.
- Jede gespeicherte Konfiguration hält Regelwerk-Version, Preislisten-Version und Eingaben fest und lässt sich neu berechnen.
- Fälle, die sich nicht automatisch bepreisen lassen, enden in einem ausdrücklichen „Angebot anfragen", nicht in einem Fehler.
- Die 95.-Perzentil-Zeit „Klick bis gültige Optionen" wird mit echten Auswahlen gemessen.
- Der ganze Ablauf funktioniert mit Tastatur und Screenreader, und Fehler und Statusänderungen werden in Text angesagt.
Wenn du zuerst nur drei Dinge tun kannst, nimm den ersten, dritten und vierten Punkt.
Was daraus folgt
Das wiederkehrende Thema ist Trennung. Regeln als Daten, an einem Ort verantwortet; Preise bei dem System, das dafür geradesteht; ein dünnes Frontend, das fragt statt zu wissen; eine Commerce-Plattform, die validierte Ergebnisse erhält. Genau das macht den Konfigurator stabil genug zum Erweitern, ob der nächste Schritt eine neue Produktfamilie, ein Angebotsworkflow oder ein Assistent obendrauf ist.
Der geführte Konfigurator, den ich in Nuxt.js auf der Spryker Glue API gebaut habe, steht in meinen Referenzen. Wenn du einen planst und die Entscheidung Regelwerk oder Solver oder die Aufteilung zwischen PIM und ERP durchsprechen willst, findest du auf meiner Seite B2B-E-Commerce-Entwickler die Details.
Quellen
- Wikipedia: Knowledge-based configuration (product configurator)
- Google OR-Tools: The CP-SAT solver
- Spryker documentation: Glue API, Product Configuration feature integration
- OWASP: Input Validation Cheat Sheet
- web.dev: Virtualize large lists
- W3C: Understanding SC 3.3.1 Error Identification (WCAG 2.2)
- W3C: Understanding SC 4.1.3 Status Messages (WCAG 2.2)
- W3C: Understanding SC 2.5.8 Target Size (Minimum) (WCAG 2.2)
- W3C WAI-ARIA Authoring Practices: Combobox pattern
Häufige Fragen
Was ist ein B2B-Produktkonfigurator?
Ein B2B-Produktkonfigurator führt Einkäufer durch die Wahl einer gültigen Kombination von Optionen für ein konfigurierbares Produkt, etwa Maße, Werkstoffe und Toleranzen, zeigt Preis und Lieferzeit und übergibt das Ergebnis an Warenkorb oder Angebot. Im Vergleich zu Konsumenten-Konfiguratoren sind die Regeln strenger, der Katalog größer und der Preis hängt oft von Vertragskonditionen ab.
Regelwerk oder Constraint-Solver für einen Produktkonfigurator?
Beginne mit einem deklarativen Regelwerk: Es ist leicht zu erklären, zu testen und vom Produktmanagement zu pflegen. Wechsle zu einem Constraint-Solver, wenn Regeln so stark zusammenspielen, dass sich gültige Kombinationen nicht mehr aufzählen oder von Hand ordnen lassen, oder wenn du erklären musst, warum eine Auswahl unmöglich ist, und die nächstgelegene gültige Alternative finden willst.
Wo sollen Konfigurator-Regeln liegen: PIM, ERP oder Shop?
Halte die Regeln bei den Produktdaten, die sie begründen, meist im PIM, und die Preise dort, wo sie verantwortet werden, meist im ERP. Der Shop sollte eine validierte Konfiguration konsumieren, nicht die Regeln besitzen, sonst stehen Regeln doppelt im Shop und im ERP und laufen auseinander.
Wie baut man einen Produktkonfigurator mit TYPO3?
Lass TYPO3 Inhalte, Landingpages und Navigation besitzen und binde den Konfigurator als Headless-App oder als Plugin ein, das mit einem separaten Konfigurationsdienst spricht. TYPO3 übergibt nur Kontext wie Sprache, Kundengruppe und Produktkennung; Regeln, Preise und Validierung bleiben außerhalb des CMS.
Wie geht man mit über 100.000 Varianten in einem Konfigurator um?
Lade und rendere nie alle Varianten. Modelliere das Produkt als Attribute und Regeln, lass den Server nur die Optionen zurückgeben, die für die aktuelle Auswahl noch gültig sind, indexiere durchsuchbare Attribute in einer Suchmaschine, cache die Options-Abfragen und virtualisiere jede lange Liste, die du anzeigen musst.
Wie macht man einen Konfigurator barrierefrei?
Nutze native Formularelemente oder gut getestete ARIA-Muster, kündige Preis- und Validierungsänderungen als Statusmeldungen an, ohne den Fokus zu verschieben, beschreibe Fehler als Text am Feld und halte Klickziele mindestens 24 mal 24 CSS-Pixel groß. Teste den ganzen Ablauf mit Tastatur und Screenreader, nicht nur mit einem automatischen Prüfwerkzeug.