Blog/Web-Engineering
Core Web Vitals für Nuxt-Sites und Shops: LCP, INP und CLS beheben
So behebst du LCP, INP und CLS in Nuxt-4-Sites und Shops: Bilder, Hydration, Fonts, Drittanbieter-Skripte, Prerender vs. SSR vs. ISR und Messung mit echten Nutzern.
Balázs Csorba··13 Min. Lesezeit
- Core Web Vitals
- Nuxt
- Performance
- E-commerce
Das Wichtigste in Kürze
- Core Web Vitals werden an Felddaten beim 75. Perzentil bewertet: LCP höchstens 2,5 Sekunden, INP höchstens 200 Millisekunden, CLS höchstens 0,1. Lighthouse kann INP nicht messen, ein grüner Lab-Score beweist also wenig.
- Die meisten LCP-Probleme in Nuxt sind Entdeckungsprobleme: Das Hero-Bild wird spät angefordert, per Lazy Loading verzögert oder ist zu groß. Bring die Reihenfolge der Requests in Ordnung, bevor du Kilobytes sparst.
- Hydration ist in einer servergerenderten Vue-App der wichtigste INP-Hebel. Liefere weniger JavaScript aus, hydriere Komponenten unterhalb des sichtbaren Bereichs verzögert und zerlege lange Tasks.
- CLS ist fast immer eine fehlende Platzreservierung: Bildmaße, Fallback-Metriken für Fonts, spät eingeblendete Banner und Consent-Leisten, Embeds ohne reservierte Box.
- Wähle den Rendering-Modus pro Route: Prerendere, was sich selten ändert, cache mit swr oder isr, wo die Plattform es unterstützt, und behalte volles SSR für alles, was wirklich pro Request entsteht.
Eine Nuxt-Site kann in Lighthouse 100 Punkte erreichen und sich trotzdem für die Menschen zäh anfühlen, die dein Geschäft bezahlen. Der Grund ist einfach: Core Web Vitals sind eine Feldmetrik. Sie beschreiben, was echte Nutzer auf echten Geräten erlebt haben, beim 75. Perzentil, und dazu gehört auch das Mittelklasse-Android-Handy im Zug, nicht nur dein Entwickler-Laptop.
Dieser Artikel ist die Checkliste, die ich für Nuxt-Sites und Shops verwende (Nuxt 4, aktuell in der 4.5-Linie). Sie ist nach Metrik gegliedert: woher LCP, INP und CLS in einer servergerenderten Vue-App kommen, welche Nuxt-Features jede Ursache adressieren und wo dir die Plattform nicht hilft. Am Ende stehen eine Tabelle „Fix je Metrik“ und eine kurze Rollout-Checkliste. Zum Kontext: Ich habe einen TYPO3-B2B-Shop refaktoriert und die Seitenladezeit um 65 % verkürzt (von 4,6 s auf 1,6 s), siehe Referenzen. Die Prinzipien unten gelten unabhängig davon, welcher Stack hinter der Seite steht.
Erst messen: Felddaten schlagen Labordaten
Die drei Core Web Vitals und ihre Ziele sind festgelegt: LCP (Laden) innerhalb von 2,5 Sekunden, INP (Reaktionsfähigkeit) höchstens 200 Millisekunden, CLS (visuelle Stabilität) höchstens 0,1. Eine Seite besteht, wenn sie alle drei beim 75. Perzentil erreicht, getrennt nach Gerätetyp. Google betont ausdrücklich, dass Labormessung kein Ersatz für Feldmessung ist, und Tools wie Lighthouse, die eine Seite ohne Nutzer laden, können INP gar nicht messen. Die Total Blocking Time ist nur ein Näherungswert.
Deshalb akzeptiere ich kein Performance-Ticket mit dem Satz „Lighthouse sagt 98“. Ich will zwei Feldquellen und ein Lab-Tool, jedes für das, was es gut kann:
| Quelle | Was sie dir sagt | Blinder Fleck |
|---|---|---|
| CrUX (über PageSpeed Insights, die CrUX-API, BigQuery) | Was Chrome-Nutzer auf deiner Origin oder URL erlebt haben; der Datensatz, den Google betrachtet. Gut für „bestehen wir?“ | Nur geeignete, ausreichend populäre Seiten; Chrome-Nutzer mit Opt-in; kein Chrome auf iOS, kein WebView; keine Details zu Ursachen |
| RUM (die web-vitals-Bibliothek, an deinen eigenen Endpunkt gesendet) | Alle drei Metriken pro Seitentemplate, Gerät, Land oder A/B-Variante; der Attribution-Build ergänzt das verantwortliche Element oder die Interaktion | Du baust und pflegst es selbst; Einwilligungs- und Datenschutzregeln gelten |
| Lighthouse / DevTools (Lab) | Reproduzierbare Läufe zur Fehlersuche bei LCP und CLS, Request-Wasserfälle, Bundle-Analyse | Keine echten Nutzer, kein INP; ein schneller Lab-Rechner versteckt die meisten Probleme |
Die Bibliothek web-vitals liefert onLCP, onINP und onCLS; ihr Attribution-Build, etwa 1,5 KB größer, ergänzt Diagnosedaten, etwa welches Element der LCP-Kandidat war. Sende die Werte mit navigator.sendBeacon an einen Endpunkt, den du kontrollierst, versieh sie mit dem Route-Template (Produktseite, Kategorie, Checkout), und du kannst endlich die Frage „welcher Seitentyp fällt durch?“ beantworten, statt über Durchschnittswerte zu streiten. Wenn dich auch interessiert, wie Agenten und Crawler diese Seiten sehen, behandelt das GEO-Audit die andere Seite derselben Seiten.
Woher jede Metrik in einem Nuxt-Seitenaufruf kommt
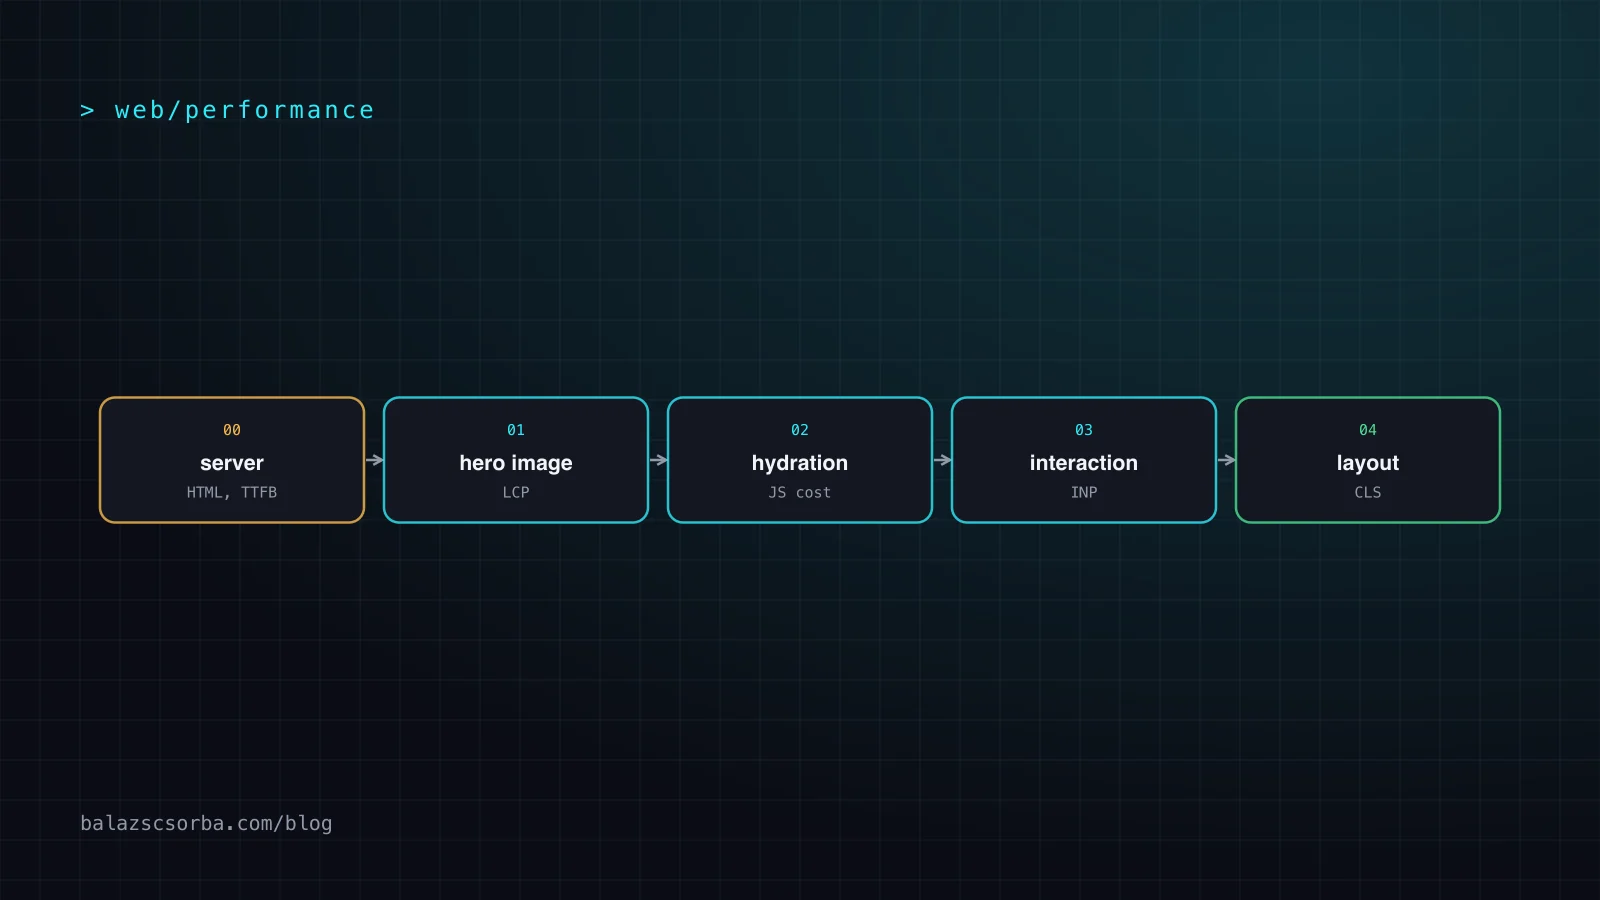
Nuxt rendert standardmäßig universell: Der Server sendet komplettes HTML, dann lädt der Browser das JavaScript und hydriert die Seite, um sie interaktiv zu machen. Dieses Zwei-Phasen-Modell erklärt die meisten Zahlen. Der LCP entscheidet sich in der ersten Hälfte (Serverantwort, Entdecken und Laden des größten Elements), der INP in der zweiten (JavaScript-Ausführung und Hydration konkurrieren mit den ersten Taps des Nutzers), und der CLS läuft durch die gesamte Lebensdauer der Seite.
Web.dev teilt den LCP in vier Teile: Time to First Byte, Resource Load Delay, Resource Load Duration und Element Render Delay. Bei einer gut optimierten Seite gilt als Richtwert etwa 40 % TTFB, unter 10 % Load Delay, 40 % Load Duration und unter 10 % Render Delay. Die beiden Delays sollten gegen null gehen; in meinen Audits verstecken sich dort die einfachen Gewinne, weil sich niemand dafür zuständig fühlt.
LCP: das größte Element auffindbar und leicht machen
Das LCP-Element ist meist ein Bild (ein img, ein Video-Poster oder ein CSS-Hintergrundbild) oder ein großer Textblock. Finde zuerst heraus, welches es pro Template ist, mit den DevTools oder dem Attribution-Build; auf Shop-Kategorieseiten ist es oft ein Banner, auf Produktseiten das Hauptfoto. Dann arbeitest du die Teilstücke ab.
Entdeckung. Die LCP-Ressource sollte im HTML-Quelltext auffindbar sein. Ein Hero, das per clientseitigem JavaScript eingefügt wird, ein CSS-Hintergrundbild oder ein Karussell, das erst nach der Hydration rendert, schieben die Anfrage hinter dein JavaScript-Bundle. Mit Nuxt Image hat die Komponente NuxtImg eine Prop preload, die ein Link-Tag in den Head setzt und eine fetchPriority von high akzeptiert. Setze nie loading="lazy" auf das LCP-Bild: web.dev nennt das als direkte Ursache für Resource Load Delay.
- Richtiges Format und richtige Größe. NuxtImg unterstützt format, quality und sizes, sodass aus einer Quelldatei responsive, moderne Varianten (webp oder avif) werden. Ich setze für jedes Hero- und Produktbild explizite sizes; ein Bild mit 2.000 Pixeln für einen 400-Pixel-Slot ist die häufigste einzelne Verschwendung, die ich sehe.
- Explizite Maße. Gib width und height (oder ein Seitenverhältnis) an, damit der Browser den Platz reserviert. Das hilft bei der LCP-Entdeckung und ist, wie unten gezeigt, auch der erste CLS-Fix.
- Serverantwortzeit. Die TTFB ist der größte Anteil des LCP-Budgets. Prerendere oder cache, was geht (siehe Abschnitt Rendering), und halte langsame Datenabrufe mit der Option lazy oder useLazyFetch für unkritische Daten aus dem kritischen Pfad heraus.
- Fonts. Ist das LCP-Element Text, verzögert eine spät geladene Webfont es. Lade die kritische Schrift vor und nutze einen Fallback mit passenden Metriken (nächster Abschnitt zum CLS).
- Keine Render-Blocker-Überraschungen. Ein Consent-Banner, ein A/B-Test-Snippet, das die Seite versteckt, oder ein synchrones Drittanbieter-Skript im Head kann das Rendering verzögern, selbst wenn alles andere perfekt ist.
Nuxt 4.5 hat außerdem experimentelles SSR-Streaming eingeführt, das die HTML-Hülle sofort sendet, statt die ganze Seite zu puffern, und direkt auf die TTFB zielt. Es ist experimentell, für Bots deaktiviert, und alles, was die Antwort nach Beginn des Renderings ändert (Header, Redirects), erreicht den Client nicht; ich würde es deshalb auf einer Route mit RUM testen, bevor ich es übernehme. Dasselbe Streaming-Denken für KI-Features steht in LLM-Features in Nuxt mit dem AI SDK.
INP: Hydration, lange Tasks und was du auslieferst
INP beobachtet die Latenz jedes Klicks, Taps und Tastendrucks während eines Besuchs, von der Eingabeverzögerung über die Event-Handler bis zum nächsten gezeichneten Frame. Gut sind höchstens 200 ms; über 500 ms ist schlecht. Er hat First Input Delay abgelöst, weil FID nur die erste Interaktion betrachtete. Scrollen und Hovern zählen nicht.
In einer servergerenderten Vue-App ist das Muster immer gleich: Die Seite wirkt fertig, der Nutzer tippt, und der Main Thread ist noch mit Hydration oder einem Drittanbieter-Tag beschäftigt. Das ist Eingabeverzögerung durch lange Tasks (alles über 50 ms blockiert den Main Thread). Kommen langsame Event-Handler (Verarbeitungsdauer) und teure Re-Renders oder Layout-Arbeit (Darstellungsverzögerung) hinzu, hast du die drei Stellen, an denen INP verloren geht.
Was ich dagegen tue, in der Reihenfolge des Nutzens:
- Weniger JavaScript ausliefern. Prüfe das Bundle mit einem Visualizer, bevor du Code anfasst. Jede schwere Bibliothek auf einer Seite braucht eine Begründung; eine Datums-Bibliothek oder ein Rich-Text-Editor auf einer Katalogseite hat selten eine.
- Verzögert hydrieren. Nuxt unterstützt verzögerte Hydration an Lazy-Komponenten: hydrate-on-visible, hydrate-on-idle, hydrate-on-interaction, hydrate-on-media-query, hydrate-after, hydrate-when und hydrate-never. Bewertungen, Empfehlungs-Karussells, Footer und Chat-Widgets müssen beim ersten Rendering nicht interaktiv sein. Die Einschränkung: Jede Prop-Änderung an einer verzögert hydrierten Komponente löst sofort die Hydration aus, und es funktioniert mit Single-File-Komponenten und Template-Props, nicht mit v-bind-Spreads.
- Einmal rendern, weniger State ausliefern. Nuxt serialisiert abgerufene Daten in den Payload. Nutze pick oder transform bei useFetch und useAsyncData, damit nur die Felder gesendet werden, die das Template braucht; laut Doku verhindern sie nicht, dass die Daten abgerufen werden, halten sie aber aus dem Payload. Payload-Extraktion ist standardmäßig aktiv, und das Experiment stripNeverHydratedData hält auch die Daten von hydrate-never-Komponenten heraus.
- Statisches statisch lassen. Komponenten, die sich nach dem Rendern nie ändern (Marketing-Blöcke, Footer), sind Kandidaten für hydrate-never oder einen reinen Server-Ansatz, damit Vue dafür keinen reaktiven State anlegt.
- Lange Tasks zerlegen. Wo du schwere Arbeit leisten musst (Filtern einer großen Produktliste, Parsing), gib den Main Thread frei. web.dev empfiehlt scheduler.yield() mit setTimeout als Fallback und etwa alle 50 ms Arbeit zu yielden statt nach jedem Element.
- Handler zähmen. Entprelle teure Eingabe-Handler, vermeide synchrone Layout-Reads in Schleifen und zeige sofort Feedback (gedrückter Zustand, Spinner), bevor langsame Arbeit beginnt, denn INP endet beim nächsten gezeichneten Frame.
CLS: Platz für alles reservieren, was später kommt
Layout-Verschiebung ist die mechanischste Metrik: Etwas ist erschienen oder hat die Größe geändert und hat bereits sichtbare Inhalte verschoben. In Nuxt-Shops finde ich immer wieder dieselben Verursacher:
- Bilder und Medien ohne Maße. Setze immer width und height; Browser leiten daraus das Seitenverhältnis ab. Bei responsiven Bildern leistet die CSS-Eigenschaft aspect-ratio dasselbe.
- Webfonts. Sowohl der Flash of Unstyled Text als auch der Flash of Invisible Text können das Layout verschieben. Das Modul Nuxt Fonts wendet eine automatische Optimierung der Font-Metriken an (über fontaine und capsize), sodass die Fallback-Schrift denselben Platz belegt wie die Webfont, unterstützt lokalen Download von Anbietern wie Google und beseitigt eine ganze Klasse von Font-Verschiebungen fast geschenkt. Kritische Fonts vorzuladen und font-display: optional sind die weiteren Empfehlungen von web.dev.
- Späte Banner. Cookie- und Consent-Leisten, Aktionsstreifen und „Gratisversand ab“-Hinweise, die nach der Hydration eingefügt werden, drücken die ganze Seite nach unten. Rendere sie serverseitig in reserviertem Platz oder lege sie mit fixer Position darüber, statt sie in den Fluss einzufügen.
- Embeds und Werbung. Reserviere eine Box mit min-height oder aspect-ratio, bevor ein Iframe, eine Karte oder ein Video lädt. Dasselbe gilt für verzögert hydrierte Komponenten, die beim Interaktivwerden ihre Höhe ändern.
- Nur-Client-Inhalte. Eine .client.vue-Komponente oder ein ClientOnly-Block rendert erst nach dem Mount; ohne Platzhalter in der richtigen Größe verschiebt sie die Seite. Nutze den Fallback-Slot, um ein Skeleton mit den endgültigen Maßen zu rendern.
- Animationen. Animiere mit transform statt top, left oder height; komponierte Animationen tragen nicht zum CLS bei.
Noch ein billiger Gewinn: Mach Seiten für den Back/Forward-Cache tauglich. Wiederhergestellte Seiten erscheinen sofort und verursachen keine neuen Layout-Verschiebungen, was in Shops wichtig ist, in denen Nutzer zwischen Listing und Detailseite hin- und herspringen.
Drittanbieter-Skripte: die Steuer, die du nicht kontrollierst
Analytics, Tag Manager, Chat-Widgets, Bewertungs-Badges und A/B-Test-Tools laufen auf demselben Main Thread wie deine Vue-App. Sie sind der übliche Grund, warum ein schlankes Nuxt-Bundle trotzdem einen schlechten INP erzeugt und warum der LCP regrediert, nachdem das Marketing „nur noch einen Tag“ ergänzt hat. Behandle jedes Skript als budgetierte Abhängigkeit mit einem Verantwortlichen.
Nuxt Scripts ist der offizielle Weg, das zu steuern. Die Composable useScript lädt Drittanbieter-Skripte mit SSR-Unterstützung, verzögertem Laden und typisierten APIs. Der Standard-Trigger onNuxtReady wartet auf die Hydration und plant das Laden dann in einer Leerlaufphase. Weitere Optionen sind manuelles Laden, useScriptTriggerIdleTimeout, useScriptTriggerInteraction (erstes Scrollen, Klicken oder Tippen), useScriptTriggerElement (wenn ein Element sichtbar wird) und einwilligungsbasierte Trigger. Es gibt Registry-Integrationen für gängige Dienste wie Google Analytics, Google Maps, YouTube und Stripe sowie Facade-Komponenten, die einen leichten Platzhalter zeigen, bis das echte Embed gebraucht wird.
Meine Regeln: nichts von Drittanbietern im kritischen Rendering-Pfad; Chat und Video hinter Interaktions- oder Sichtbarkeits-Triggern; Analytics nach Hydration und Einwilligung; jedes Skript vor und nach dem Release gegen seine INP-Kosten im RUM prüfen. Reserviere Layout-Platz für alles Visuelle (siehe CLS). Bei einem B2B-Shop mit eingeloggten Käufern würde ich außerdem fragen, ob ein Heatmap-Tool im Checkout überhaupt laufen muss.
Prerender, SSR oder ISR: pro Route entscheiden
Der Rendering-Modus legt deine TTFB-Untergrenze und damit deine LCP-Obergrenze fest. Das Hybrid-Rendering von Nuxt lässt dich pro Route mit Route-Rules entscheiden, statt eine globale Einstellung zu verwenden:
| Modus (Route-Rule) | Was er tut | Einsatz | Achtung |
|---|---|---|---|
| prerender: true | Erzeugt statisches HTML zur Build-Zeit | Landingpages, Doku, Blogartikel, Rechtstexte | Inhalte sind nur so aktuell wie der letzte Build |
| swr | Liefert eine gecachte Antwort und regeneriert sie im Hintergrund | Kategorie- und Listenseiten, die sich ein paarmal am Tag ändern | Der erste Besucher nach Ablauf kann veraltete Inhalte bekommen; braucht Server- oder Plattform-Cache |
| isr | CDN-gecachte Seiten mit Revalidierung; unterstützt auf Netlify und Vercel über native Integration | Große Kataloge, bei denen ein vollständiger Rebuild zu langsam ist | Plattformspezifisch; prüfe dein Hosting, bevor du darum herum planst |
| Universelles SSR (Standard) | Rendert HTML pro Request und hydriert dann | Personalisierte oder pro Request erzeugte Seiten: Warenkorb, Konto, Preislisten | Die TTFB hängt von deinem Backend und den Datenabrufen ab |
| ssr: false | Reines Client-Rendering für diese Route | Authentifizierte Dashboards hinter einem Login | Langsamerer Erstaufruf und schwächere SEO-Sichtbarkeit; halte es von Landingpages fern |
Bei einem B2B-Shop ist die Aufteilung meist klar: Marketing-, Content- und Kategorieseiten werden prerendert oder gecacht, Produktseiten nutzen swr oder isr, wobei Preis und Bestand nach der Hydration clientseitig (oder pro Kunde am Edge) geladen werden, und Warenkorb, Checkout und Konto bleiben bei SSR. Die Falle ist die Personalisierung: Ein einziger kundenspezifischer Preis im servergerenderten HTML macht jede gecachte Seite zu einer Seite pro Request. Halte die Hülle cachebar und lade den persönlichen Teil getrennt, mit reservierter Box, damit er keine Layout-Verschiebung verursacht. Dieselben Shop-Seiten rufen auch Agentic-Commerce-Protokolle und Agenten ab, eine schnelle, cachebare Hülle zahlt sich also doppelt aus.
Tabelle: Fix je Metrik
Die Kurzfassung zum Anpinnen neben dein RUM-Dashboard:
| Metrik | Typische Ursache in Vue/Nuxt | Erster Fix | Nuxt-Werkzeug |
|---|---|---|---|
| LCP | Hero-Bild spät gefunden, lazy geladen oder zu groß | Ins Server-HTML, vorladen, richtige Größe und Format, nie lazy laden | NuxtImg: preload mit fetchPriority high, sizes, format, quality |
| LCP | Hohe TTFB durch SSR und langsame Datenabrufe | Prerendern oder cachen; unkritische Daten aus dem kritischen Pfad nehmen | routeRules (prerender, swr, isr), useLazyFetch, experimentelles SSR-Streaming |
| LCP | Text-LCP wartet auf eine Webfont | Kritische Schrift vorladen, Fallback mit passenden Metriken | Modul Nuxt Fonts |
| INP | Main Thread hydriert die ganze Seite | Bereiche unterhalb des sichtbaren Bereichs und nicht interaktive Teile verzögert oder nie hydrieren | Lazy-Komponenten mit hydrate-on-visible, hydrate-on-idle, hydrate-on-interaction, hydrate-never |
| INP | Große Bundles und großer Payload | Schwere Bibliotheken entfernen oder splitten; nur genutzte Felder senden | Code-Splitting mit Lazy-Präfix, pick und transform, Payload-Extraktion |
| INP | Drittanbieter-Tags und lange Tasks | Tags verzögern, in schweren Schleifen yielden, Handler entprellen | Nuxt-Scripts-Trigger, scheduler.yield() mit Fallback |
| CLS | Bilder und Embeds ohne reservierten Platz | width und height oder aspect-ratio für alles, was später lädt | NuxtImg mit Maßen, CSS aspect-ratio |
| CLS | Font-Swap, späte Banner, Nur-Client-Blöcke | Fallbacks mit passenden Metriken; Banner-Platz reservieren; Skeleton-Fallbacks | Nuxt Fonts, Fallback-Slot von ClientOnly |
Shops sind anders: was ich bei B2B-Stores prüfe
Bei einem Refactoring eines TYPO3-B2B-Shops habe ich die Seitenladezeit um 65 % reduziert, von 4,6 s auf 1,6 s (Details in den Referenzen). Die Prinzipien dieses Artikels wende ich dort genauso an: erst messen, den kritischen Pfad kurz halten und jeden zusätzlichen Request und jedes Skript als etwas behandeln, das sich seinen Platz verdienen muss.
Shops bringen drei eigene Fallen mit. Produktlisten rendern Hunderte Bilder und Filter, also lade alles außer der ersten Reihe lazy und miss INP bei Filter-Interaktionen, nicht nur beim Laden. Preise, Bestand und kundenspezifische Kataloge verleiten dazu, das Caching für die ganze Seite abzuschalten. Und der Tag-Stack des Shops (Analytics, Remarketing, Bewertungen, Live-Chat) wächst jedes Quartal. Wenn du ein Nuxt-Storefront baust oder migrierst, zeigt meine Seite Vue- und Nuxt-Expertise, was ich übernehme.
Eine Rollout-Checkliste
- Richte RUM mit dem Attribution-Build von web-vitals ein, getaggt nach Route-Template, und halte die CrUX-Zahlen deiner Origin daneben.
- Wähle die drei schlechtesten Templates nach Traffic und durchfallender Metrik; ignoriere den Rest, bis diese bestehen.
- Identifiziere das LCP-Element jedes Templates und mach es im HTML auffindbar, vorgeladen, passend dimensioniert und nie lazy geladen.
- Weise jeder Route per Route-Rules einen Rendering-Modus zu; halte personalisierte Daten aus gecachtem HTML heraus.
- Füge das Modul Nuxt Fonts hinzu und prüfe die Fallback-Metriken; ergänze width, height oder aspect-ratio bei jedem Bild und Embed.
- Prüfe Bundle und Payload; wende pick oder transform an; splitte schwere Komponenten mit dem Lazy-Präfix.
- Ergänze Hydrationsstrategien für Komponenten unterhalb des sichtbaren Bereichs und nicht interaktive Komponenten; teste die ersten Taps erneut unter CPU-Drosselung.
- Verschiebe jedes Drittanbieter-Skript zu Nuxt Scripts mit Trigger, Verantwortlichem und gemessenen INP-Kosten.
- Füge ein Performance-Budget in die CI ein (Bundle-Größe, Lighthouse für LCP und CLS) und beobachte RUM über einige Wochen echten Traffic, bevor du den Sieg erklärst.
Quellen
- web.dev: Web Vitals
- web.dev: Largest Contentful Paint (LCP)
- web.dev: Optimize Largest Contentful Paint
- web.dev: Interaction to Next Paint (INP)
- web.dev: Optimize Cumulative Layout Shift
- web.dev: Optimize long tasks
- Chrome for Developers: Chrome UX Report (CrUX)
- Chrome for Developers: CrUX methodology
- GitHub: GoogleChrome/web-vitals
- Nuxt docs: Rendering modes
- Nuxt docs: Components (Lazy prefix, delayed hydration, client components)
- Nuxt docs: Experimental features (lazyHydration, payloadExtraction)
- Nuxt docs: Data fetching (pick, transform, lazy)
- Nuxt blog: Nuxt 4.5
- GitHub: Nuxt releases
- Nuxt Image: NuxtImg
- Nuxt Fonts module
- Nuxt Scripts: Getting started
- Nuxt Scripts: Script triggers
Häufige Fragen
Was sind gute Core-Web-Vitals-Werte?
Google empfiehlt einen LCP innerhalb von 2,5 Sekunden, einen INP von höchstens 200 Millisekunden und einen CLS von höchstens 0,1. Eine Seite besteht, wenn sie alle drei Werte beim 75. Perzentil echter Seitenaufrufe erreicht, getrennt nach Gerätetyp. Langsame Smartphones und schwache Netze zählen also genauso wie dein Laptop.
Wie verbessere ich den LCP in einer Nuxt-App?
Finde das LCP-Element, stelle sicher, dass es im servergerenderten HTML steckt, lade es mit hoher Fetch-Priorität vor und lade es niemals lazy. Mit Nuxt Image nutzt du die Prop preload mit fetchPriority high, lieferst ein modernes Format in passender Größe und hältst die Serverantwortzeit durch Prerendering oder Caching niedrig.
Warum ist der INP schlecht, obwohl Lighthouse grün ist?
Lighthouse lädt eine Seite in einer simulierten Umgebung ohne Nutzer und kann INP deshalb gar nicht messen; die Total Blocking Time ist nur ein Stellvertreter. INP misst jeden Klick, Tap und Tastendruck in echten Sessions, auch auf langsamen Geräten, mit schweren Drittanbieter-Skripten und mit Arbeit, die nach der Hydration anfällt.
Hilft Lazy Hydration bei den Core Web Vitals in Nuxt?
Ja, vor allem beim INP und manchmal beim LCP. Nuxt unterstützt Hydrationsstrategien wie hydrate-on-visible, hydrate-on-idle und hydrate-on-interaction an Lazy-Komponenten, sodass Widgets unterhalb des sichtbaren Bereichs nicht mit den ersten Interaktionen konkurrieren. Beachte: Jede Prop-Änderung an so einer Komponente löst sofort die Hydration aus.
Was ist für die Nuxt-Performance besser: SSR, Prerendering oder ISR?
Es gibt keinen Alleingewinner. Prerendering liefert die schnellste und stabilste TTFB für selten geänderte Inhalte, swr oder isr ergänzen gecachte Regenerierung für katalogartige Seiten, und volles SSR passt zu personalisierten oder pro Request erzeugten Seiten. Mit Nuxt-Route-Rules mischst du alle Varianten in einer App.
Wie messe ich Core Web Vitals bei meinen echten Nutzern?
Kombiniere zwei Quellen. CrUX, über PageSpeed Insights oder die API, zeigt, was Chrome-Nutzer erlebt haben, und ist das, was Google sieht. Für eigene Segmente und zur Fehlersuche bindest du die web-vitals-Bibliothek ein, nutzt den Attribution-Build und sendest die Metriken per sendBeacon an einen eigenen Endpunkt.