Blog/LLMOps & Evals
LLM-Evals für Produktfeatures: von handgelesenen Traces zum CI-Gate
LLM-Evals machen aus dem Bauchgefühl eine Testsuite: Fehleranalyse auf echten Traces, Grader-Wahl, ein validierter LLM-as-judge, pass^k und ein CI-Gate.
Balázs Csorba··8 Min. Lesezeit
- LLM evals
- LLM-as-judge
- Error analysis
- CI
Das Wichtigste in Kürze
- LLM-Evals sind Tests für das Modellverhalten: ein fester Inputsatz, ein Grader pro Ausgabe und ein Score, den du über jede Prompt-, Modell- und Codeänderung hinweg vergleichst.
- Fang mit der Fehleranalyse auf rund 100 echten Traces an, gruppiere die Notizen in einer gezählten Fehlertaxonomie und wähle erst danach Metriken oder schreibe Judges.
- Nimm den billigsten Grader, der den Fehler zuverlässig aufgreift: Code für alles, was sich per Regel prüfen lässt, einen LLM-as-judge für Urteilsfragen, Menschen zum Kalibrieren des Judges.
- Gib jedem Judge ein Fehlerbild und ein binäres Votum und validiere ihn an 100 bis 200 menschlich gelabelten Beispielen, bevor du irgendetwas daran gate.
- pass@k fragt, ob einer von k Versuchen gelingt, pass^k, ob alle gelingen; ein Feature, das jedes Mal funktionieren muss, wird mit pass^k gemessen.
LLM-Evals sind automatisierte Tests für Features, die auf Sprachmodellen aufbauen: ein fester Satz Inputs, ein Grader, der für jede Ausgabe Pass oder Fail entscheidet, und ein Score, den du über jede Prompt-, Modell- und Codeänderung hinweg trackst. Sie ersetzen das „sieht gut aus“-Urteil, das für die erste Demo funktioniert und aufhört zu funktionieren, sobald ein Feature echte Nutzer und einen zweiten Entwickler hat.
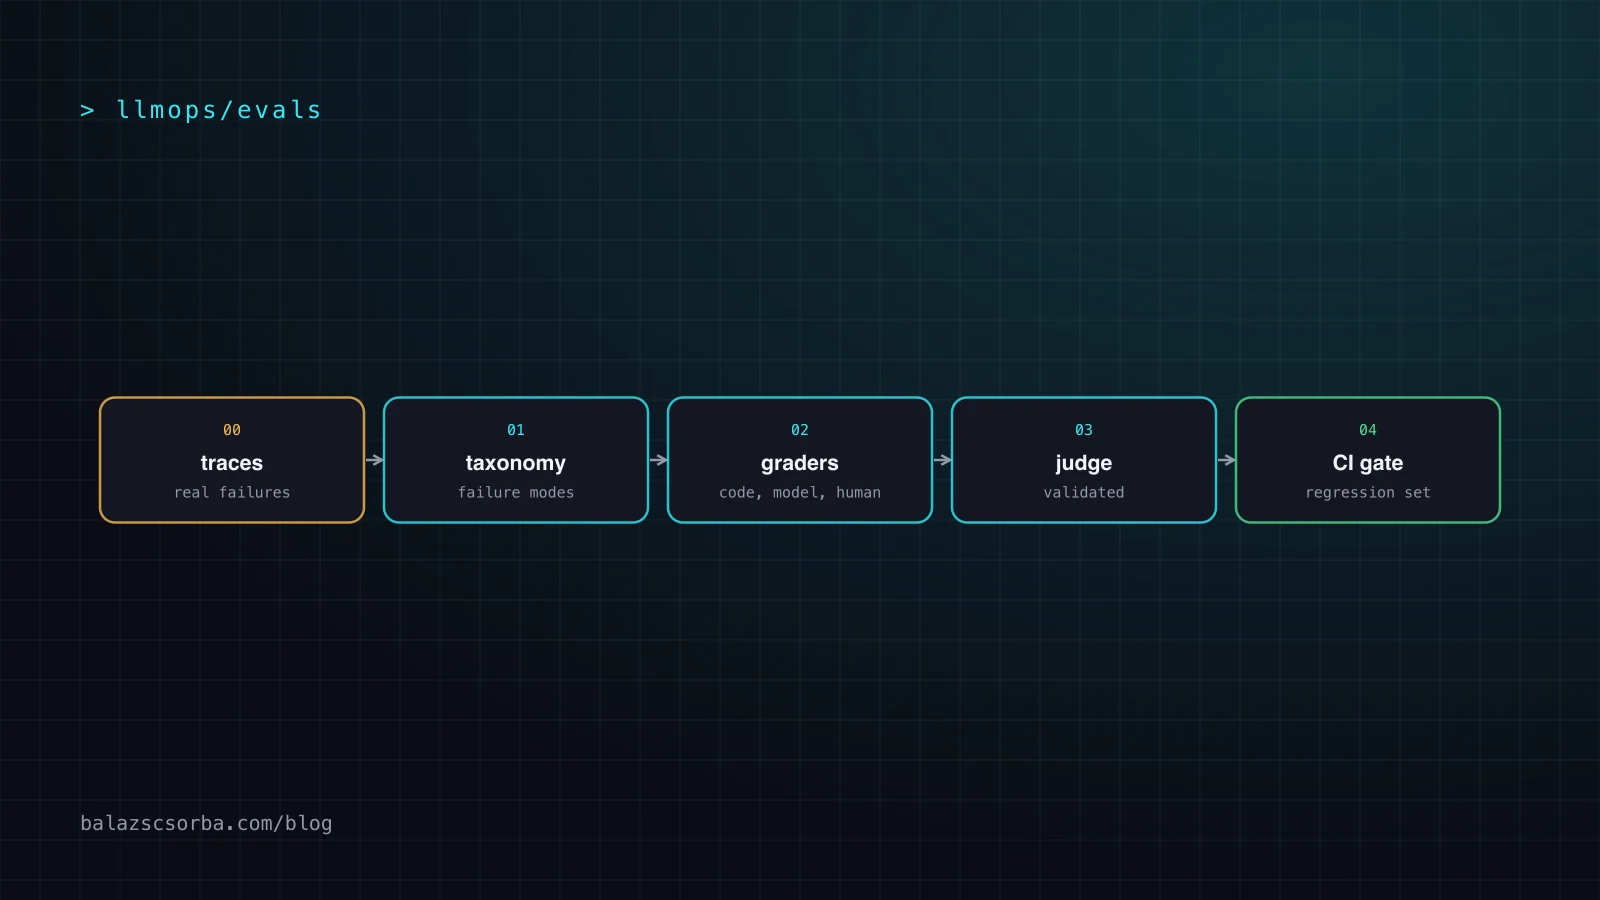
Dieser Artikel beschreibt einen Weg, der in der Praxis hält: echte Traces von Hand lesen, das Gefundene in eine Fehlertaxonomie übersetzen, für jeden Fehler den billigsten Grader wählen, der ihn erkennen kann, jeden LLM-as-judge gegen menschliche Labels validieren, Zuverlässigkeit mit pass^k ebenso wie mit pass@k messen und das Ergebnis als Regressionstest-Suite in der CI laufen lassen.
Warum brauchen LLM-Features Evals?
Weil Modellausgaben zwischen zwei Läufen schwanken und jede kleine Prompt-Änderung einen Fall reparieren kann, während sie drei andere kaputtmacht, auf die du nicht schaust. Ohne festen Testsatz findest du es erst durch die Nutzer heraus.
Unit-Tests nehmen an, dass eine Funktion für dieselbe Eingabe dieselbe Ausgabe liefert. Ein LLM-Feature tut das nicht, und seine Fehler sind selten Abstürze: eine Zusammenfassung, die genau den einen wichtigen Satz weglässt, eine Support-Antwort, die eine Rückerichtungsregel erfindet, ein Klassifikator, der nach einem Modell-Upgrade driftet. Evals machen daraus Zahlen, die du vergleichen kannst. Anthropics Demystifying evals for AI agents (Januar 2026) stellt den Einstieg absichtlich klein dar: „20–50 einfache Aufgaben aus echten Fehlern sind ein großer Anfang“. Du brauchst keinen Benchmark; du brauchst die Fälle, die schon schiefgegangen sind.
Wo fängt man an? Fehleranalyse auf echten Traces
Beginne damit, Traces zu lesen, nicht damit, Metriken auszuwählen. Sieh dir rund 100 echte Interaktionen an, schreibe zu jedem Problem eine Notiz in Freitext und gruppiere die Notizen dann in eine kleine Taxonomie von Fehlerbildern und zähle sie.
Hamel Husains Evals-FAQ (aktualisiert September 2026) beschreibt die Methode mit den Begriffen der qualitativen Forschung. Offenes Kodieren: Die Annotatoren schreiben Freitextnotizen darüber, was in jedem Trace schiefgegangen ist. Axiales Kodieren: Die Notizen werden zu einer Fehlertaxonomie gruppiert und gezählt. Er empfiehlt, mit rund 100 vielfältigen Traces zu starten und „mindestens 30 Traces selbst zu prüfen, bevor du den Agenten Fehler vorschlagen lässt“, und erwartet „60–80 % der Entwicklungszeit für Fehleranalyse und Evaluation“. Die Zahlen sind wichtig: Sie sagen dir, welcher Fehler zuerst einen Grader verdient.
Zwei organisatorische Punkte aus derselben FAQ. Bestimme einen „benevolent dictator“, einen Fachexperten, der endgültig entscheidet, was als gut gilt, damit die Labels konsistent bleiben. Und rechne damit, dass sich deine Kriterien verschieben: Shankar et al. nennen das criteria drift, die Beobachtung, dass „Nutzer Kriterien brauchen, um Ausgaben zu bewerten, aber das Bewerten von Ausgaben hilft den Nutzern, Kriterien zu definieren“. Lies die Traces erneut, sobald die Taxonomie existiert; sie wird sich ändern.
Welchen Grader sollst du nehmen: Code, Modell oder Mensch?
Nimm den billigsten Grader, der den Fehler zuverlässig erkennt: Code für alles, was sich per Regel prüfen lässt, einen LLM-as-judge für Urteilsfragen und Menschen, um den Judge zu kalibrieren und zu reviewen, was die automatischen Grader nicht entscheiden können.
| Grader | Stark bei | Schwach bei | Nimm ihn für |
|---|---|---|---|
| Code (Assertions, Schemas, Regex, SQL) | Schnell, billig, objektiv, reproduzierbar, gut zu debuggen | Brüchig bei gültigen Varianten; keine Nuancen | Format, Pflichtfelder, verbotene Zeichenketten, Tool-Aufruf-Argumente, exakte Antworten |
| LLM-as-judge | Flexibel, skalierbar, kommt mit Nuancen zurecht | Nicht deterministisch, teurer als Code, braucht Kalibrierung | Ton, Faktentreue zu den Quellen, ob eine Richtlinie eingehalten wurde |
| Mensch | Goldstandard-Qualität, trifft das Urteil von Experten | Teuer und langsam | Labels für Trainingsdaten des Judges, Stichproben, strittige Fälle |
Die Stärken und Schwächen in der Tabelle sind die, die Anthropic in seinem Evals-Artikel auflistet. Eine weitere Regel aus derselben Quelle verhindert eine ganze Klasse flaky Tests: Bewerte „was der Agent produziert hat, nicht den Weg, den er gegangen ist“. Ein Agent, der mit einer anderen Folge von Tool-Aufrufen zum richtigen Ergebnis kommt, sollte bestehen. Wenn die Ausgabe eine feste Wahl ist (eine Kategorie, eine Priorität, eine Route), kannst du auf Freitext ganz verzichten und einen exakten Treffer bewerten; dieses Muster beschreibt der Beitrag typisierte Entscheidungen statt Prosa.
Wie baust du einen LLM-as-judge, dem du trauen kannst?
Gib jedem Judge genau ein Fehlerbild und ein binäres Pass/Fail-Votum und miss ihn dann mit der true positive rate und der true negative rate anhand menschlicher Labels, bevor du seinen Zahlen traust.
Binäre Votums erzwingen Husain zufolge „klareres Denken und konsistenteres Labeling“ als Skalen von 1 bis 5, in denen benachbarte Punkte für verschiedene Menschen verschiedene Dinge bedeuten. Ein Judge pro Fehlerbild hält den Prompt kurz und das Votum debugbar:
You are grading one failure mode: UNSUPPORTED_POLICY_CLAIM.

FAIL if the answer states a refund, shipping or warranty rule
that does not appear in the provided policy excerpts.
PASS otherwise, including when the answer says the policy
does not cover the question.

Policy excerpts:
{excerpts}

Answer:
{answer}

Reply with JSON: {"reason": "one sentence", "verdict": "PASS" | "FAIL"}
Dann validierst du ihn. Husain empfiehlt, pro Fehlerbild 100 bis 200 Beispiele zu labeln und sie aufzuteilen: 10–20 % als Few-Shot-Beispiele im Judge-Prompt, 40–45 % als Entwicklungsset zum Verfeinern des Prompts und 40–45 % als zurückgehaltenes Testset. Miss die true positive rate (von den Ausgaben, die Menschen als Fehler markiert haben, wie viele der Judge ebenfalls als fehlgeschlagen bewertet) und die true negative rate (von den bestandenen Fällen, wie viele der Judge ebenfalls bestanden hat). Rohe Übereinstimmung verdeckt einen Judge, der alles bestehen lässt, wenn Fehler selten sind.
Bekannte Verzerrungen lohnen sich, auf die man testet. Die MT-Bench-Studie (Zheng et al., 2023) fand, dass starke LLM-Judges „über 80 % Übereinstimmung“ mit menschlichen Präferenzen erreichen, dokumentierte aber auch Positions-, Ausführlichkeits- und Selbstbegünstigungs-Verzerrungen. Wenn der Judge zwei Ausgaben vergleicht, tausche ihre Reihenfolge und prüfe, ob das Votum hält.
Was ist der Unterschied zwischen pass@k und pass^k?
pass@k ist die Wahrscheinlichkeit, dass mindestens einer von k Versuchen gelingt; pass^k ist die Wahrscheinlichkeit, dass alle k gelingen. pass@k passt zu Tools, bei denen der Nutzer erneut versuchen oder die beste Antwort wählen kann; pass^k passt zu Features, die jedes Mal funktionieren müssen.
Anthropic definiert pass@k als „die Wahrscheinlichkeit, dass ein Agent in k Versuchen mindestens eine richtige Lösung findet“, und pass^k als „die Wahrscheinlichkeit, dass alle k Versuche gelingen“. pass^k wurde von τ-bench (Yao et al., 2024) eingeführt, das fand, dass selbst starke Function-Calling-Agenten inkonsistent waren: gpt-4o löste weniger als die Hälfte der Aufgaben, mit pass^8 unter 25 % in der Retail-Domäne. Die beiden Metriken laufen schnell auseinander. Als Beispiel, bei unabhängigen Versuchen mit je 90 % Erfolgsrate: pass@5 ist 1 − 0.1⁵ ≈ 99.999 %, pass^5 ist 0.9⁵ ≈ 59 %. Ein Support-Bot, der dieselbe Frage neunmal von zehn richtig beantwortet, liegt bei einem spürbaren Anteil der Nutzer daneben. Führe jeden Eval-Fall mehrfach aus und berichte beide Werte.
Wie führt man Evals in der CI aus?
Teile die Suite in einen Regressionsset, der nahe 100 % bleiben muss, und einen Capability-Satz, der scheitern darf, führe den Regressionsset bei jeder Änderung aus und gate die Merges darauf.
- Regression-Evals halten die Fälle, die schon funktionieren. Anthropics Rat ist, sie sollten eine „nahezu 100-prozentige Pass-Rate“ haben; ein Einbruch ist ein Bug.
- Capability-Evals halten die Fälle, die du zum Funktionieren bringen willst. Sie „sollten mit einer niedrigen Pass-Rate starten“ und wandern in den Regressionsset, sobald sie zuverlässig bestehen.
- Jeder Produktionsfehler wird ein Fall. Der Trace wandert mit seinem erwarteten Verhalten in den Satz, bevor der Fix geschrieben wird, nach demselben Prinzip wie ein Regressionstest, der scheitern muss, wenn der Fix zurückgenommen wird; beschrieben ist das im Beitrag Harness Engineering für Coding-Agenten.
- Alles, was nicht unter Test steht, festpinnen: Modell-ID, Temperatur, wo die API es erlaubt, Judge-Prompt-Version und bei Agent-Evals die Ausführungsumgebung.
Dieser letzte Punkt ist keine Pedanterie. Anthropics Quantifying infrastructure noise in agentic coding evals (Februar 2026) fand, dass auf Terminal-Bench 2.0 der Unterschied zwischen der am besten und der am schlechtesten ausgestatteten Konfiguration 6 Prozentpunkte betrug, bei gleichem Modell und gleichem Harness. Wenn deine CI-Runner die Größe ändern, kann die Pass-Rate deines Agenten wandern, ohne dass sich Code ändert. Vergleiche Läufe auf identischer Infrastruktur und behandle kleine Unterschiede mit Misstrauen.
Wann Evals in die Irre führen
Evals führen in die Irre, wenn die Metrik generisch ist, der Judge nicht validiert wurde, der Satz veraltet ist oder das Rauschen größer ist als der Unterschied, den du liest.
- Generische Metriken. Fertige Scores für „Nützlichkeit“ oder „Kohärenz“ lassen sich selten auf deine Fehlerbilder abbilden. Husain: „Generische Evaluierungen verschwenden Zeit und erzeugen falsche Sicherheit, wenn du sie als Qualitätsmaß nutzt.“
- Ein nicht validierter Judge. Ein Judge, der mit sich selbst übereinstimmt, sagt dir nichts. Ohne TPR und TNR auf zurückgehaltenen Labels ist der Score die Meinung des Judges.
- Sättigung. Ein Capability-Satz bei 100 % misst keinen Fortschritt mehr. Verschiebe seine Fälle in die Regression und schreibe aus neuen Traces schwierigere.
- Zu wenige Versuche. Bei ein paar Dutzend Fällen und je einem Lauf kann ein Ausschlag von ein paar Prozentpunkten Rauschen sein. Wiederhole die Läufe und sieh dir die einzelnen Fälle an, die umgesprungen sind.
- Transkripte überspringen. Anthropics Rat ist deutlich: „Du wirst nicht wissen, ob deine Grader gut funktionieren, wenn du die Transkripte nicht liest.“
Checkliste für LLM-Evals
- Lies rund 100 echte Traces, mindestens 30 davon selbst, und schreibe zu jedem Problem eine Notiz in Freitext.
- Gruppiere die Notizen zu Fehlerbildern und zähle sie; baue zuerst Grader für die häufigsten.
- Benenne eine Qualitätsverantwortliche, die endgültig über die Labels entscheidet.
- Nutze Code-Grader, wo eine Regel trägt; reserviere LLM-as-judge für Urteilsfragen.
- Ein binärer Judge pro Fehlerbild, validiert mit TPR und TNR auf einem zurückgehaltenen, gelabelten Satz.
- Führe jeden Fall mehrfach aus und berichte pass^k für Features, die jedes Mal funktionieren müssen.
- Halte einen Regressionsset nahe bei 100 % und gate die Merges darauf; lass den Capability-Satz scheitern.
- Mach jeden Produktionsfehler zu einem Fall, bevor du den Fix schreibst.
- Pinne Modell, Prompts und Infrastruktur fest, damit eine Score-Änderung eine Verhaltensänderung bedeutet.
Wenn du einem LLM-Feature Evals hinzufügst und Hilfe beim Aufbau der ersten Suite willst, sieh dir AI Engineering an.
Quellen
- Anthropic: Demystifying evals for AI agents (2026)
- Hamel Husain: LLM evals FAQ (aktualisiert September 2026)
- Shankar et al., Who Validates the Validators? (2024)
- Zheng et al., Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena (2023)
- Yao et al., τ-bench: A Benchmark for Tool-Agent-User Interaction (2024)
- Anthropic: Quantifying infrastructure noise in agentic coding evals (2026)
Häufige Fragen
Wie fange ich an, LLM-Evals zu schreiben?
Lies zuerst rund 100 echte Traces und schreibe zu jedem Problem eine Notiz in Freitext, dann gruppiere die Notizen in eine kleine Taxonomie von Fehlerbildern und zähle sie. Anthropics Evals-Artikel formuliert dasselbe von der anderen Seite: 20 bis 50 einfache Aufgaben aus echten Fehlern sind ein großer Anfang. Metriken, die du wählst, bevor du die Fehlerbilder kennst, messen meist das Falsche.
Was ist ein LLM-as-judge und wie traue ich ihm?
Ein LLM-as-judge ist ein Modellaufruf, der die Ausgabe eines anderen Modells anhand einer Rubrik bewertet. Gib jedem Judge ein Fehlerbild und ein binäres Pass/Fail-Votum und validiere ihn dann: Labele pro Fehlerbild 100 bis 200 Beispiele, halte einen Teil davon als Few-Shot-Set zurück und miss die true positive rate und die true negative rate anhand deiner eigenen Labels, bevor du einen Merge daran gate.
Was ist der Unterschied zwischen pass@k und pass^k?
pass@k ist die Wahrscheinlichkeit, dass mindestens einer von k Versuchen gelingt, und passt zu Tools, bei denen der Nutzer neu versuchen oder auswählen kann. pass^k ist die Wahrscheinlichkeit, dass alle k Versuche gelingen, und passt zu Features, die jedes Mal funktionieren müssen. Die tau-bench-Arbeit hat pass^k eingeführt, nachdem sie festgestellt hatte, dass starke Function-Calling-Agenten über wiederholte Läufe hinweg inkonsistent waren.
Sollte ich LLM-Evals in der CI laufen lassen?
Ja, aber teile sie auf. Halte einen Regressionsset aus bereits verstandenen Fehlern nahe bei 100 %, denn ein Einbruch dort ist eine echte Regression, und halte einen separaten Capability-Satz, der scheitern darf. Kalkuliere außerdem das Rauschen ein: Anthropic hat auf Terminal-Bench 2.0 zwischen der am besten und der am schlechtesten ausgestatteten Runner-Konfiguration 6 Prozentpunkte Spread gemessen, mit gleichem Modell und gleichem Harness.
Wann führen LLM-Evals in die Irre?
Wenn die Metrik generisch ist, der Judge nie gegen menschliche Labels validiert wurde, der Aufgabensatz veraltet ist oder das Rauschen zwischen zwei Läufen größer ist als der Unterschied, den du liest. Zwei Prozentpunkte auf einem flaky Runner sind kein Signal. Repariere zuerst die Messung, bevor du auf die Zahl reagierst, und bewerte, was der Agent produziert hat, nicht den Weg, den er gegangen ist.