Blog/RAG & Retrieval
RAG-Pipeline in Produktion, Schritt für Schritt: Chunking, hybride Suche und Reranking
Eine RAG-Pipeline Schritt für Schritt bauen: Parsing, Chunking, pgvector, BM25 plus Vektoren mit RRF, Reranking, Quellenangaben und Evals.
Balázs Csorba··10 Min. Lesezeit
- RAG
- Hybrid search
- Chunking
- Reranking
- pgvector
Das Wichtigste in Kürze
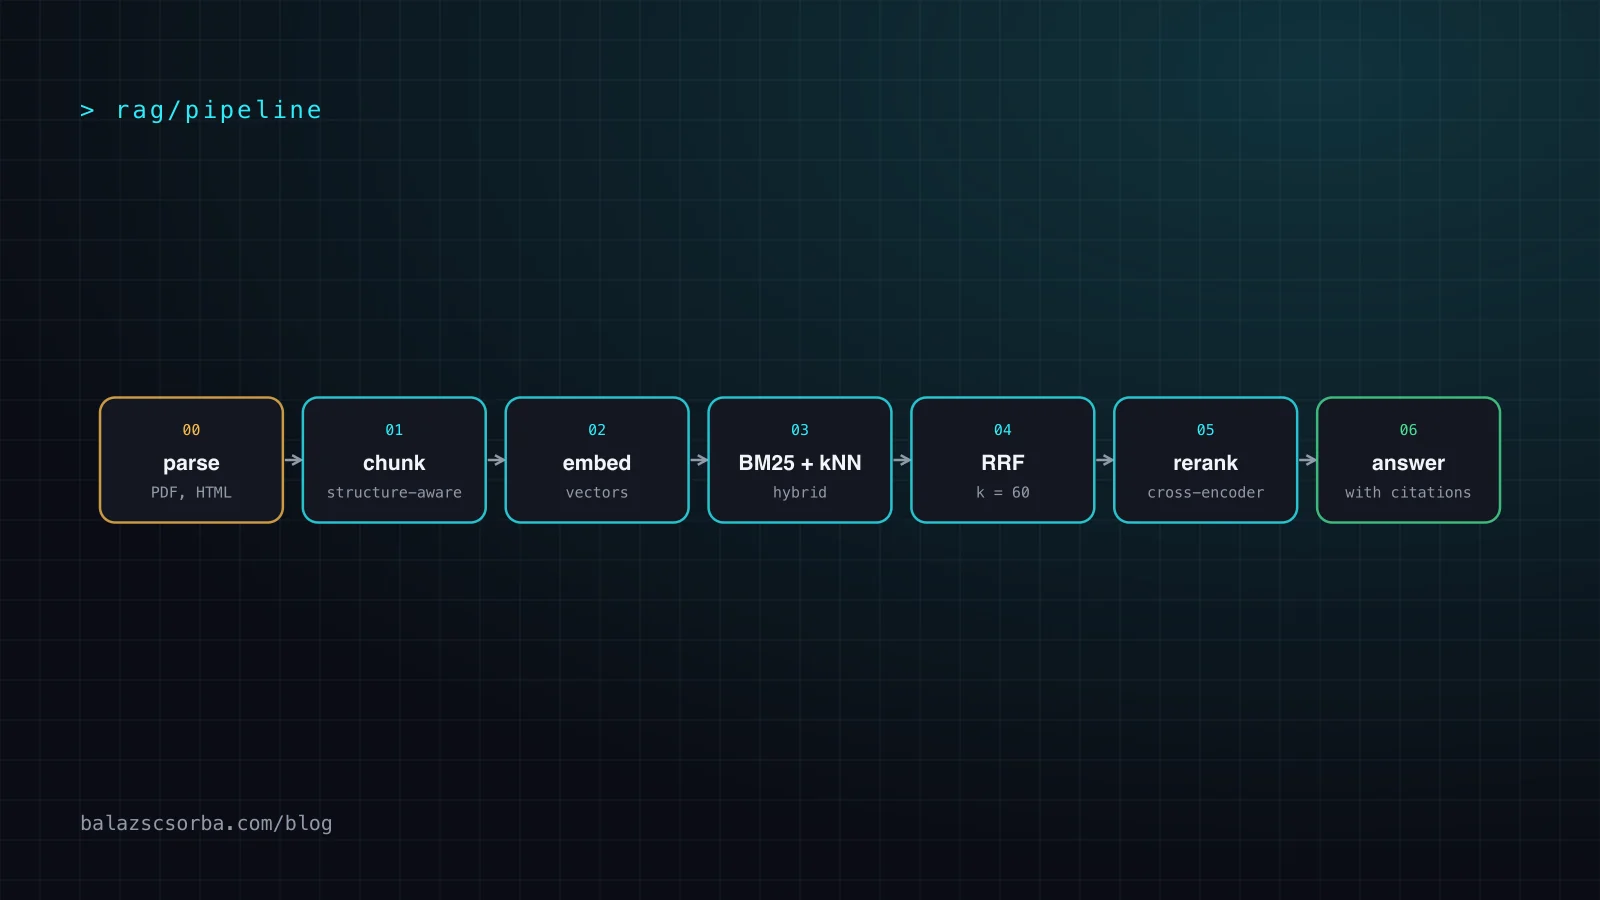
- Eine RAG-Pipeline hat eine Offline-Hälfte (parsen, chunken, embedden, indizieren) und eine Online-Hälfte (abrufen, fusionieren, reranken, generieren), die sich einen Index teilen.
- Strukturbewusste Chunks von ein paar hundert Tokens mit Titel- und Heading-Pfad-Header sind ein starker Default; Chroma fand, dass die 800/400-Token-Voreinstellung am schlechtesten abschnitt.
- Die hybride Suche führt BM25 und Vektorsuche parallel aus und führt sie mit Reciprocal Rank Fusion zusammen: score = Summe aus 1 / (60 + rank).
- Ein Cross-Encoder-Reranker obendrauf auf kontextuelle Embeddings und BM25 senkte Anthropics Top-20-Retrieval-Fehlerrate von 5.7% auf 1.9%.
- Miss Retrieval (recall@k, MRR, nDCG) getrennt von der Generierung (Faktentreue) und erzwinge Berechtigungen in der Retrieval-Query.
Eine RAG-Pipeline ist die Kette von Schritten, die deine Dokumente in durchsuchbare Chunks verwandelt und bei einer eingehenden Frage die wenigen Passagen findet, die ein Sprachmodell braucht, um mit Belegen zu antworten. Retrieval-Augmented Generation (RAG) wurde von Lewis et al. im Jahr 2020 eingeführt – als Modelle, die „vortrainiertes parametrisches und nicht-parametrisches Gedächtnis kombinieren“: ein Generator plus ein neuronaler Retriever über einem dichten Vektorindex.
Dieser Artikel geht eine Pipeline aus der Produktion Stufe für Stufe durch: Parsing, Chunking, Embeddings und ein HNSW-Index, hybrides BM25 plus Vektorsuche, zusammengeführt mit Reciprocal Rank Fusion (mit lauffähigem Code), Reranking mit einem Cross-Encoder, Generierung mit Quellenangaben und die Metriken, die dir sagen, welche Stufe ausfällt. Wenn du noch entscheidest, ob du überhaupt Retrieval brauchst, lies zuerst RAG im Jahr 2026: hybrides Retrieval, agentisches Suchen oder Long Context.
Was ist eine RAG-Pipeline?
Eine RAG-Pipeline hat zwei Hälften, die sich einen Index teilen: einen Offline-Pfad, der Dokumente parst, chunkt, einbettet und speichert, und einen Online-Pfad, der abruft, fusioniert, rerankt und generiert. Die meisten Qualitätsprobleme entstehen in der Offline-Hälfte, obwohl sie sich erst in den Antworten zeigen.
Jede Stufe hat eine Aufgabe, und jede lässt sich einzeln messen. Diese Trennung zählt, wenn eine Antwort falsch ist, denn die Ursache kann an vier verschiedenen Stellen liegen: ein Chunk, der nie erzeugt wurde (Parsing), ein Chunk, den es gibt, der aber nicht abgerufen wurde (Retrieval), ein Chunk, der abgerufen, aber unterhalb des Cutoffs eingereiht wurde (Fusion oder Reranking) oder ein korrekter Chunk, den das Modell ignoriert hat (Generierung). Wenn du nur die Endantwort misst, kannst du diese Fälle nicht unterscheiden.
Wie sollte man Dokumente parsen und chunken?
Wandle Dokumente in sauberen Text um, mit intakter Struktur und Metadaten, und zerlege sie dann entlang ihrer eigenen Struktur in Chunks von ein paar hundert Tokens, die für sich allein Sinn ergeben. Chunking ist die billigste Stufe zum Ändern und eine der einflussreichsten.
Parsing: Struktur und Metadaten erhalten
- PDFs verlieren in mehrspaltigen Layouts die Lesereihenfolge und wiederholen Kopf- und Fußzeilen auf jeder Seite. Entferne die Wiederholungen und sieh dir eine Stichprobe der extrahierten Seiten mit den Augen an, bevor du irgendetwas Weiterem nachjustierst.
- Tabellen zerlegen naive Splitter. Eine Zelle mit „4.2“ sagt ohne ihre Zeilen- und Spaltenköpfe nichts aus, also behalte kleine Tabellen entweder ganz als Markdown oder schreibe eine Zeile pro Tabellenzeile, die die Spaltennamen wiederholt.
- Metadaten gehören an jeden Chunk: Dokument-ID, Titel, Heading-Pfad, Quell-URL, Datum der letzten Änderung, Sprache und die Gruppen, die ihn lesen dürfen. Die beim Indizieren gespeicherten Zugriffsregeln machen das spätere Filtern nach Berechtigungen überhaupt erst möglich.
- Ein Content-Hash pro Dokument erlaubt es, nur das Geänderte neu zu indizieren.
Chunking-Strategien im Vergleich
| Strategie | Wie sie teilt | Stärke | Schwäche |
|---|---|---|---|
| Feste Token-Zahl | Alle N Tokens, oft mit Überlappung | Trivial, planbare Größe | Zerreißt Sätze und Tabellen mitten drin; die Überlappung dupliziert Text |
| Rekursiv / strukturbewusst | Überschriften, dann Absätze, dann Sätze, bis zu einer Größengrenze | Chunks folgen der Struktur des Autors | Braucht sauberes Parsing; ungleichmäßige Chunk-Größen |
| Semantisch | Bricht dort, wo die Embedding-Ähnlichkeit zwischen Sätzen abfällt | Thematisch kohärente Chunks | Zusätzliche Embedding-Kosten beim Indizieren; schwerer zu debuggen |
| Kontextuelle Header | Eine der obigen, plus ein vorangestellter Titel, Heading-Pfad oder eine modellgeschriebene Zusammenfassung | Chunks sind für die Suche eigenständig | Modellgeschriebener Kontext kostet einen Call pro Chunk |
Der beste öffentliche Vergleich, den ich kenne, ist Chromas Evaluating Chunking Strategies for Retrieval (Smith und Troynikov, Juli 2024). Gemessen wurden Recall, Precision und IoU auf Token-Ebene; ein rekursiver Zeichensplitter mit 200 Tokens ohne Überlappung schnitt durchgehend gut ab, während die damalige OpenAI-Assistants-Voreinstellung mit 800-Token-Chunks und 400 Tokens Überlappung einen leicht unterdurchschnittlichen Recall und die niedrigsten Werte bei den anderen Metriken hatte. Der brauchbare Teil ist ihre Schlussfolgerung: „Die Wahl der Chunking-Strategie kann die Retrieval-Leistung deutlich beeinflussen.“ Nimm die Zahlen als Ausgangspunkt und miss auf deinen eigenen Dokumenten.
Anthropics Contextual Retrieval ist die stärkste Variante kontextueller Header: Ein Modell schreibt 50–100 Tokens, die jeden Chunk in seinem Dokument verorten, und dieser Text wird sowohl vor dem Embedding als auch vor dem BM25-Index vorangestellt. In ihren Tests senkte das die Top-20-Retrieval-Fehlerrate von 5.7% auf 3.7% und mit BM25 auf 2.9%, bei einmaligen Kosten von rund $1.02 pro Million Dokument-Tokens mit Prompt-Caching. Mein Default ist billiger: strukturbewusstes Splitting bei ein paar hundert Tokens mit einem deterministischen Header (Titel plus Heading-Pfad) und modellgeschriebener Kontext nur dann, wenn die Retrieval-Evals zeigen, dass Chunks genau daran scheitern.
Welchen Vektorindex solltest du nehmen?
Für die meisten Teams reicht ein HNSW-Index in einer Datenbank, die sie ohnehin betreiben. pgvector ergänzt PostgreSQL um HNSW- und IVFFlat-Indizes, sodass Vektoren, Volltext- und Zugriffskontrollspalten in einer Tabelle und einer Transaktion liegen.
HNSW (Malkov und Yashunin, 2016) baut einen mehrschichtigen Nähegraphen und durchsucht ihn von groben zu feinen Schichten, was ungefähr logarithmisch skaliert. Er ist approximativ: Er tauscht etwas Recall gegen viel Geschwindigkeit. In pgvector hat HNSW eine bessere Query-Performance als IVFFlat, aber langsamere Builds; die Build-Parameter stehen standardmäßig auf m = 16 und ef_construction = 64, und die Kandidatenliste zur Query-Zeit, hnsw.ef_search, steht auf 40.
-- One table for vectors, full-text and permissions (pgvector + Postgres FTS)
CREATE EXTENSION IF NOT EXISTS vector;

CREATE TABLE chunks (
  id           bigserial PRIMARY KEY,
  doc_id       text NOT NULL,
  allowed      text[] NOT NULL,          -- groups that may read this chunk
  heading_path text,
  content      text NOT NULL,
  embedding    vector(1024),             -- match your embedding model
  tsv          tsvector GENERATED ALWAYS AS (to_tsvector('english', content)) STORED
);

CREATE INDEX ON chunks USING hnsw (embedding vector_cosine_ops);
CREATE INDEX ON chunks USING gin (tsv);
CREATE INDEX ON chunks USING gin (allowed);

-- Vector leg of the hybrid query, filtered by the user's groups
SET hnsw.iterative_scan = relaxed_order;
SELECT id FROM chunks
WHERE allowed && $1::text[]
ORDER BY embedding <=> $2
LIMIT 50;
Die Zeile iterative_scan ist für Berechtigungen wichtig. Das pgvector README warnt, dass bei approximativen Indizes „der Filter nach dem Indexscan angewendet wird“: Trifft eine Bedingung 10% der Zeilen, liefert HNSW mit dem Standard-ef_search von 40 nur rund 4 passende Zeilen zurück. Iterative Indexscans (seit 0.8.0) suchen weiter, bis genug Zeilen passen. Beim Embedding-Modell selbst haben Anthropics Tests gezeigt, dass die Embeddings von Voyage und Gemini am besten abschneiden, aber mach deinen eigenen Vergleich – und bedenke, dass ein Modellwechsel heißt, den gesamten Korpus neu einzubetten.
Wie funktioniert die hybride Suche mit BM25 und Vektoren?
Die hybride Suche führt eine lexikalische BM25-Query und eine Vektorquery parallel aus und führt die beiden Ranglisten zusammen. Reciprocal Rank Fusion (RRF) ist die einfachste robuste Zusammenführung, weil sie Ränge nutzt und die Rohscores ignoriert, die nicht vergleichbar sind.
Vektoren treffen die Bedeutung, finden also Paraphrasen, sind aber bei exakten Tokens schwach: Fehlercodes, SKUs, Teilenummer, Namen und Versionsstrings. BM25 trifft exakte Begriffe, gewichtet seltene Begriffe höher und sättigt wiederholte. Elasticsearch verwendet BM25 als Standardähnlichkeit, mit k1 = 1.2 und b = 0.75. Ein Hinweis für Postgres-Nutzer: Die eingebauten Funktionen ts_rank und ts_rank_cd sind nicht BM25. Die PostgreSQL-Dokumentation schreibt, sie „nutzen keine globalen Informationen“, es gibt also keine inverse Dokumentfrequenz. Für den Anfang reicht das; wenn dir die lexikalische Qualität wichtig ist, nimm für den lexikalischen Teil eine Suchmaschine oder eine BM25-Erweiterung.
RRF stammt von Cormack, Clarke und Büttcher (SIGIR 2009). Jedes Dokument bekommt die Summe aus 1 / (k + rank) über alle Listen, in denen es vorkommt, mit k = 60 – einem Wert, den die Autoren „in einer Pilotuntersuchung festgelegt und bei der anschließenden Validierung nicht verändert“ haben. In ihren Experimenten schlug RRF durchgehend jedes einzelne System und die Standardmethode Condorcet Fuse.
// Reciprocal Rank Fusion (Cormack et al., 2009) – TypeScript
type Hit = { id: string }

export function reciprocalRankFusion(lists: Hit[][], k = 60, limit = 50) {
  const scores = new Map<string, number>()
  for (const list of lists) {
    list.forEach((hit, index) => {
      const rank = index + 1 // ranks start at 1
      scores.set(hit.id, (scores.get(hit.id) ?? 0) + 1 / (k + rank))
    })
  }
  return [...scores.entries()]
    .sort((a, b) => b[1] - a[1])
    .slice(0, limit)
    .map(([id, score]) => ({ id, score }))
}

// const fused = reciprocalRankFusion([bm25Top50, vectorTop50])Hol dir von jedem der beiden Zweige mehr Kandidaten, als du behalten willst, etwa je 50, damit ein Dokument, das von dem einen Retriever auf Rang 30 und vom anderen auf Rang 5 steht, noch auftaucht. Das pgvector README verweist auf dieselben zwei Zusammenführungsoptionen wie dieser Artikel: RRF oder ein Cross-Encoder über den kombinierten Kandidaten.
Wie funktionieren Reranking und die Generierung mit Quellenangaben?
Reranke die zusammengeführten Kandidaten mit einem Cross-Encoder, gib dem Modell nur die besten Chunks und verlange Quellenangaben plus eine explizite Antwort „die Quellen sagen dazu nichts“. Reranking kauft Präzision; Quellenangaben machen die Antwort überprüfbar.
Reranking mit einem Cross-Encoder
Ein Embedding-Modell ist ein Bi-Encoder: Es kodiert die Query und jeden Chunk getrennt. Ein Cross-Encoder liest die Query und einen Chunk zusammen und gibt einen Relevanzscore aus. Die Sentence-Transformers-Dokumentation fasst den Handel so zusammen: „Cross-Encoders erzielen bessere Ergebnisse als Bi-Encoders“ – sie erzeugen aber keine Embeddings und können deshalb keinen Korpus durchsuchen. Die Standardantwort lautet retrieve-then-rerank: Hole günstig rund 100 Kandidaten und bewerte dann jedes Paar mit dem Cross-Encoder. Anthropics Contextual-Retrieval-Tests haben einen Reranker obendrauf auf kontextuelle Embeddings und BM25 gesetzt und die Top-20-Fehlerrate auf 1.9% gesenkt. Reranking kostet eine Modellausführung pro Kandidat, also begrenzte die Kandidatenzahl und beobachte die Latenz.
Generierung mit Quellenangaben und einem „Ich weiß es nicht“
Gib jedem Chunk eine ID und einen Titel, halte die Anzahl klein und lege die stärksten Chunks nach vorn. Die „Lost in the Middle“-Studie (Liu et al., 2023) fand, dass die Leistung „am höchsten ist, wenn die relevanten Informationen am Anfang oder am Ende stehen“ und in der Mitte abfällt. Sag dem Modell, es solle nur aus den Quellen antworten und das auch sagen, wenn sie die Antwort nicht enthalten, und teste dieses Verhalten dann mit unbeantwortbaren Fragen.
Wenn du Claude nutzt, übernimmt die Citations-Funktion die Buchführung: Aktiviere Citations auf den Dokument-Blöcken, und die Antwort verweist auf genau die Passagen, die sie verwendet hat; das zurückgegebene cited_text zählt nicht zu den Output-Tokens. Zwei Details aus der Doku: Um bestimmte Sätze aus RAG-Chunks zu zitieren, lege jeden Chunk in ein eigenes Plain-Text-Dokument; und Citations lassen sich nicht mit strukturierten Ausgaben kombinieren (die API gibt einen 400-Fehler zurück).
Wie bewertet man eine RAG-Pipeline?
Bewerte Retrieval und Generierung getrennt. Das Retrieval bekommt Ranking-Metriken gegen einen gelabelten Satz relevanter Chunks; die Generierung bekommt Prüfungen auf Faktentreue und Richtigkeit gegen den abgerufenen Kontext und eine Referenzantwort.
| Metrik | Stufe | Was sie misst | Was sie braucht |
|---|---|---|---|
| Recall@k | Retrieval | Anteil der relevanten Chunks, die in den Top k auftauchen | Relevante Chunk-IDs pro Frage |
| MRR | Retrieval | Mittelwert aus 1 / Rang des ersten relevanten Chunks | Relevante Chunk-IDs pro Frage |
| nDCG@k | Retrieval | Abgestufte Relevanz, nach Position abgewogen, auf die ideale Reihenfolge normiert | Labels für abgestufte Relevanz |
| Faktentreue | Generierung | Behauptungen in der Antwort, die vom abgerufenen Kontext gedeckt sind | Ein LLM-Grader, keine Referenz |
| Context Recall | Retrieval, bewertet | Ob der abgerufene Kontext die Referenzantwort stützt | Eine Referenzantwort |
Anthropics „failure rate“ ist einfach 1 minus recall@20. Für die Generierung definiert RAGAS Faktentreue als „Anzahl der Behauptungen in der Antwort, die vom abgerufenen Kontext gedeckt sind / Gesamtzahl der Behauptungen in der Antwort“, von 0 bis 1. Baue einen Golden Set aus echten Nutzerfragen, labelle die Chunk-IDs, die sie beantworten, und nimm Fragen auf, auf die es im Korpus keine Antwort gibt, sowie Fragen, die der Testnutzer nicht sehen darf. Lass die Retrieval-Metriken bei jeder Änderung an Chunking, Embeddings oder Fusion neu laufen; sie sind billig und deterministisch. Modellbewertete Metriken müssen gegen menschliche Labels validiert werden, worum es in Evals für LLM-Produktfeatures geht.
Die Pipeline betreiben, und wann sich der Aufbau nicht lohnt
Eine RAG-Pipeline ist ein Datensystem: Sie braucht inkrementelle Neuindizierung, Löschungen, Berechtigungsfilter und versionierte Indizes. Bei einem kleinen Korpus lohnt sich der Aufbau vielleicht gar nicht.
- Inkrementell neu indizieren. Vergleiche Content-Hashes, chunke nur geänderte Dokumente neu und lösche die Chunks entfernter Dokumente. Veraltete Chunks gelöschter Seiten sind eine häufige Quelle für selbstsicher falsche Antworten.
- Den Index versionieren. Ein neues Embedding-Modell oder eine neue Chunking-Strategie bedeutet einen kompletten Neuaufbau. Baue den neuen Index neben den alten, führe die Retrieval-Evals auf beiden aus und schalte dann um.
- Berechtigungen im Retrieval filtern. Wende die Gruppen des Nutzers sowohl in der BM25- als auch in der Vektorquery an. Filtern nach der Generierung ist zu spät: Das Modell hat den Text schon gelesen.
- Frische nachverfolgen. Speichere das Datum der letzten Änderung, zeige es zusammen mit den Quellenangaben an und alarmiere bei Quellen, deren Synchronisierung aufgehört hat.
Wann du keinen bauen solltest: Anthropics Rat ist, dass du bei einer Wissensbasis unter 200.000 Tokens (rund 500 Seiten) „einfach die gesamte Wissensbasis“ in den Prompt aufnehmen kannst, mit Prompt-Caching hältst du die Kosten unten. Bei Codebasen kommen Agenten, die mit grep und Datei-Reads suchen, oft ohne Index aus. Und Fragen, die über alles aggregieren („wie viele Verträge dieses Jahr ablaufen“), sind Datenbankabfragen, keine Top-k-Retrieval. Die Abwägung zwischen diesen Optionen ist das Thema von dem Strategie-Artikel zu RAG im Jahr 2026, und die Kostenseite langer Prompts steht in Prompt-Caching, Routing und Batching.
RAG-Pipeline-Checkliste
- Sieh dir das geparste Ergebnis mit den Augen an, an einer Stichprobe von PDFs und Tabellen, bevor du irgendetwas anderes einstellst.
- Speichere Metadaten auf jedem Chunk: Dokument-ID, Heading-Pfad, Quell-URL, Datum der letzten Änderung, erlaubte Gruppen.
- Fang mit strukturbewussten Chunks von ein paar hundert Tokens plus einem Header aus Titel und Heading-Pfad an.
- Führe BM25 und Vektorsuche parallel aus, je etwa 50 Kandidaten, und führe sie mit RRF zusammen (k = 60).
- Reranke mit einem Cross-Encoder und gib nur die besten Chunks weiter, die stärksten zuerst.
- Verlange Quellenangaben und eine explizite Antwort für „steht nicht in den Quellen“, und teste beides.
- Miss recall@k und MRR bei jeder Retrieval-Änderung an einem gelabelten Golden Set; prüfe die Faktentreue getrennt.
- Erzwinge Berechtigungen in der Retrieval-Query, mit iterativen Indexscans, wenn du einen HNSW-Index filterst.
- Versioniere den Index und baue ihn neu nebeneinander, wenn sich Embedding-Modell oder Chunking ändern.
Wenn du Retrieval in ein Produkt baust und jemand soll die Pipeline oder die Evals unabhängig ansehen, findest du mehr unter KI-Engineering.
Quellen
- Lewis et al., Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks (2020)
- Cormack, Clarke and Büttcher, Reciprocal Rank Fusion outperforms Condorcet and individual Rank Learning Methods (SIGIR 2009)
- Malkov and Yashunin, Efficient and robust approximate nearest neighbor search using HNSW graphs
- pgvector README
- Elasticsearch: similarity settings (BM25 default)
- PostgreSQL: controlling text search (ranking)
- Chroma: Evaluating Chunking Strategies for Retrieval (2024)
- Anthropic: Introducing Contextual Retrieval (2024)
- Sentence Transformers: Cross-Encoders
- Liu et al., Lost in the Middle: How Language Models Use Long Contexts (2023)
- Claude docs: Citations
- RAGAS: Faithfulness metric
Häufige Fragen
Welche Chunk-Größe soll ich für RAG nehmen?
Fang mit strukturbewussten Chunks von ein paar hundert Tokens an, geschnitten an Überschriften und Absätzen, mit Dokumenttitel und Heading-Pfad davor. Chromas Chunking-Studie von 2024 fand, dass ein rekursiver Splitter mit 200 Tokens ohne Überlappung durchgehend gut abschnitt, während 800-Token-Chunks mit 400 Tokens Überlappung am schlechtesten bewertet wurden. Miss dann recall@k auf deinen eigenen Dokumenten, bevor du etwas änderst.
Warum Reciprocal Rank Fusion statt BM25- und Vektorscores zu addieren?
BM25-Scores sind unbeschränkt und hängen vom Korpus ab, Vektorähnlichkeiten liegen auf einer anderen Skala – addiert man sie, dominiert ein Retriever den anderen. Reciprocal Rank Fusion ignoriert die Rohscores und summiert 1 / (k + rank) über die Listen hinweg, mit k = 60 aus Cormack et al. (2009). Dokumente, die beide Retriever hoch einstufen, rücken nach oben, und eine Kalibrierung der Scores ist nicht nötig.
Ist die Volltextsuche von PostgreSQL dasselbe wie BM25?
Nein. Die Funktionen ts_rank und ts_rank_cd berücksichtigen Termhäufigkeit, Nähe und Dokumentstruktur, aber die Dokumentation schreibt, sie nutzten keine globalen Informationen, es gibt also keine inverse Dokumentfrequenz wie bei BM25. Für den lexikalischen Teil der hybriden Suche ist das ein brauchbarer Ausgangspunkt; wenn dir die Qualität der lexikalischen Rangfolge wichtig ist, nimm eine Suchmaschine oder eine BM25-Erweiterung.
Wie filtere ich RAG-Ergebnisse mit pgvector nach Benutzerberechtigungen?
Speichere die erlaubten Gruppen auf jedem Chunk und wende sie in der WHERE-Klausel sowohl der Vektor- als auch der Volltextquery an. Bei HNSW wendet pgvector Filter nach dem Indexscan an, ein selektiver Filter kann also zu wenige Zeilen zurückgeben; aktiviere iterative Indexscans (hnsw.iterative_scan, pgvector 0.8.0 und neuer), damit der Index weitersucht, bis genug Zeilen passen.