Blog/LLMOps & Evals
Prompt-Caching und Modell-Routing: LLM-Kosten und Latenz senken
Prompt-Caching, Routing auf das kleinere Modell und Batch-APIs sind die Hebel, die LLM-Kosten und Latenz im Produktivbetrieb senken. So nutzt du jeden davon.
Balázs Csorba··9 Min. Lesezeit
- Prompt caching
- Model routing
- LLM cost
- Latency
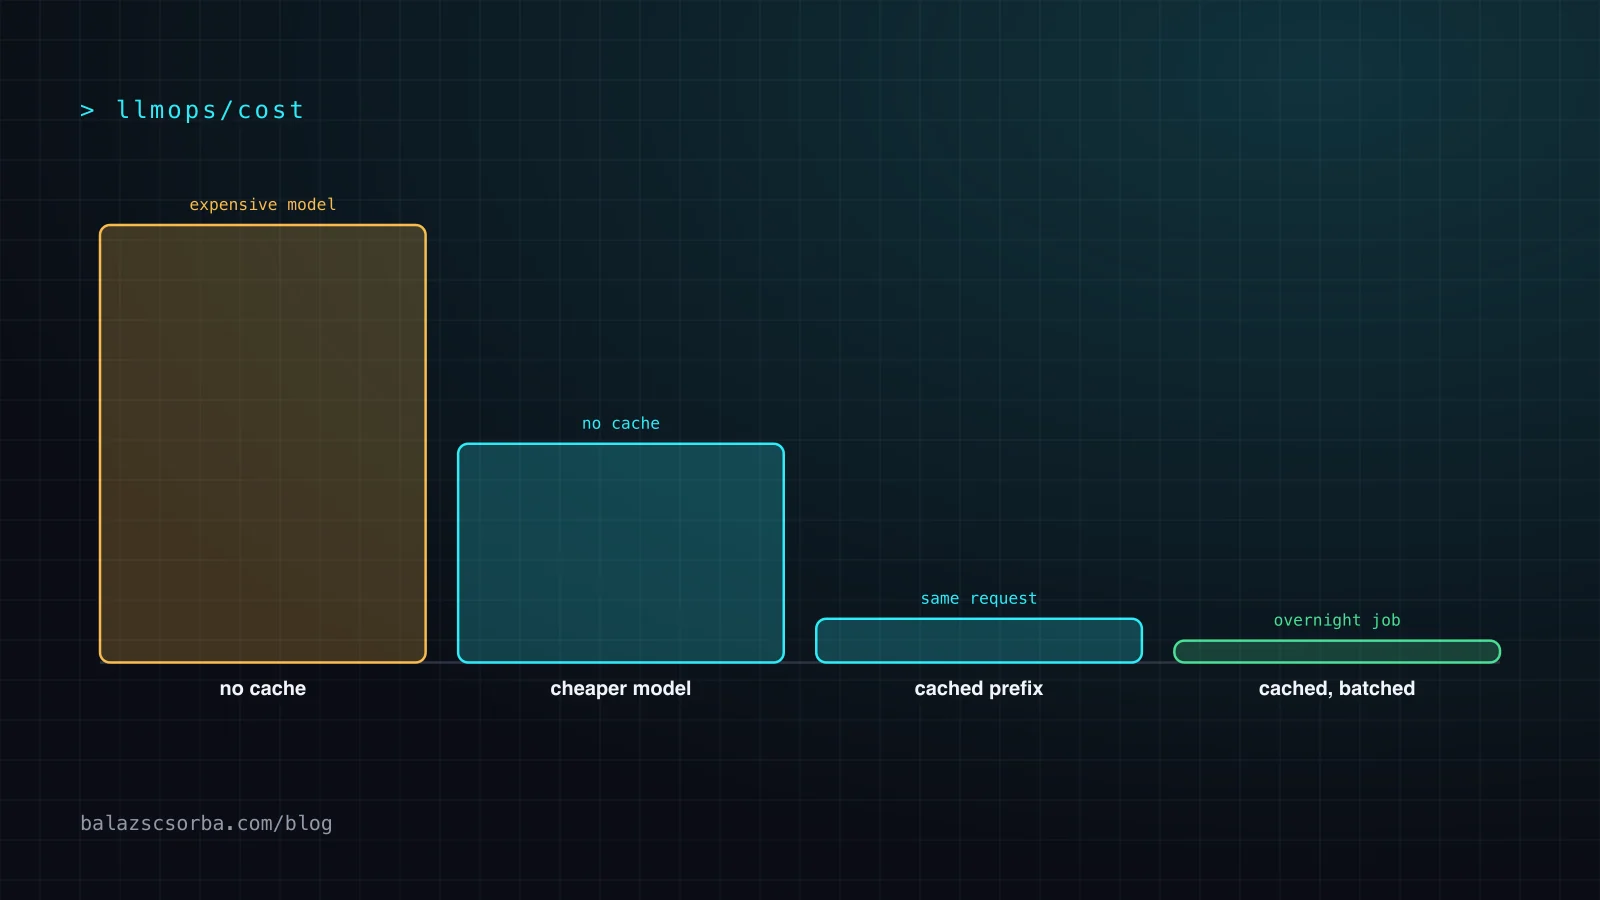
Das Wichtigste in Kürze
- Prompt-Caching ist Prefix-Caching: Der Anbieter speichert eine exakte Bytesequenz und bedient spätere Requests, die damit beginnen, zum 0,1-Fachen des Input-Preises, auf Opus 5.5 zum 0,05-Fachen.
- Ordne den Prompt als Tools, dann System-Prompt, dann Verlauf, dann Request. Alles Variable oberhalb des Verlaufs schiebt die gesamte Konversation aus dem Cache.
- Schreibvorgänge werden mit Aufschlag abgerechnet: das 1,25-Fache des Input-Preises für den Fünf-Minuten-Cache und das 2-Fache für den Ein-Stunden-Cache, mit bis zu vier Breakpoints.
- Die Modellwahl ist der zweite Hebel: Stand September 2026 kostet Opus 5.5 $4 und $20 pro Million Token, Sonnet 5 dagegen $2 und $10.
- Batch-APIs kosten ungefähr die Hälfte, das lohnt sich für alles, was keinen Nutzer blockiert, und jede Kostenänderung sollte immer wieder gegen die Eval-Suite geprüft werden.
Prompt-Caching ist der mit Abstand größte Kostenhebel in einem LLM-Feature im Produktivbetrieb, und er wird in Anwendungen verschenkt, die bei jedem Request denselben großen Prefix mitschicken. Routing, Batching und ein Kosten-Dashboard pro Feature ergänzen das Bild. Dieser Artikel erklärt den Mechanismus, die Zahlen, die man Stand September 2026 prüfen sollte, und die Reihenfolge, in der man sie anwendet.
Die Kurzfassung: Ein langer, stabiler Prefix vor deinem Prompt wird zu einem Bruchteil des Preises abgerechnet; über den Rest der Kosten entscheidet, welches Modell läuft und wie oft am Tag. Mach den Prefix stabil, nimm das kleinere Modell, miss das Ergebnis pro Feature, und die meisten Kostenprobleme hören auf, interessant zu sein.
Wohin fließt das Geld tatsächlich?
In fast jeder Anwendung, die ich kalkuliert habe, dominieren die Input-Tokens, und innerhalb der Input-Tokens wiederholen sich System-Prompt plus Tool-Definitionen plus Gesprächsverlauf bei jedem Aufruf. Ein Support-Assistent mit 12.000 Tokens Anweisungen und Tools, dem 2.000 Fragen am Tag gestellt werden, schickt 24 Millionen identische Tokens am Tag. An dieser Zahl steckt keine Arbeit.
Der zweite Kostentreiber ist die Modellwahl, und sie ist ein größerer Hebel, als die meisten erwarten. Stand September 2026 liegen die veröffentlichten Preise pro Million Input- und Output-Token bei Claude Opus 5.5 mit $4 und $20, Claude Fable 5.1 mit $10 und $50, Claude Sonnet 5 mit $2 und $10 und Claude Haiku 4.5 mit $1 und $5 bei einem Kontextfenster von 200K. Ein Feature, das auf Opus 5.5 läuft und seine Evals auf Sonnet 5 besteht, hat gerade die Hälfte der Input-Kosten und die Hälfte der Output-Kosten gespart, ohne eine einzige Änderung am Prompt.
Wie Prompt-Caching funktioniert
Prompt-Caching ist Prefix-Caching. Der Anbieter speichert eine exakte Bytesequenz deines Prompt-Prefix und liefert, wenn ein späterer Request mit derselben Sequenz beginnt, diesen Teil aus dem Speicher, statt ihn neu zu verarbeiten. Der Prefix muss identisch sein, und genau das ist die gesamte Ingenieursaufgabe: Die meisten „Cache-Fehlschläge“ in der Produktion sind Requests, die sich um einen Zeitstempel, eine User-ID, einen zufälligen Seed oder eine umsortierte Tool-Liste unterscheiden.
Claudes Prompt-Caching-Dokumentation beschreibt bis zu vier Cache-Breakpoints, einen Rückblick über die letzten 20 Blöcke und ein Minimum von 512 Tokens auf den 5.x-Modellen. Schreibvorgänge werden mit Aufschlag abgerechnet: das 1,25-Fache des Input-Preises für den Fünf-Minuten-Cache, das 2-Fache für den Ein-Stunden-Cache. Lesevorgänge kommen mit dem 0,1-Fachen des Input-Preises zurück, auf Opus 5.5 mit dem 0,05-Fachen. Ein gecachter Prefix auf Sonnet 5 kostet also $0.20 pro Million Tokens statt $2.
Zwei Invalidierungsregeln verursachen den meisten Schmerz. Ein einziges geändertes Zeichen in der Mitte des Prefix invalidiert alles danach, Prefix sind in der Praxis also append-only. Und eine Änderung an den Tool-Definitionen invalidiert den gesamten Cache, weshalb eine nächtliche Änderung am Tool-Schema die Kosten eines Features still verdoppeln kann, bis es jemand bemerkt.
Die Ordnungsregel, die daraus folgt, ist die, die man sich merken muss: Tools, dann System-Prompt, dann Verlauf, dann der Request. Setzt du einen Wert pro Request wie den aktuellen Zeitstempel über den Verlauf, schiebst du die gesamte Konversation bei jedem Aufruf aus dem Cache.
Die TTL wählen: fünf Minuten oder eine Stunde
Der Fünf-Minuten-Cache wird mit dem 1,25-Fachen des Input-Preises geschrieben, der Ein-Stunden-Cache mit dem 2-Fachen, gelesen wird mit dem 0,1-Fachen (auf Opus 5.5 mit dem 0,05-Fachen). Die Rechnung entscheidet die Wahl. Wird dein Prefix im Zeitfenster mehr als etwa fünfmal erneut gelesen, gewinnt der Fünf-Minuten-Cache, weil sich der Schreibaufschlag nach dem fünften Lesen bezahlt hat. Für ein interaktives Feature mit einem Burst von Fragen zum selben Dokument ist das der Normalfall.
Der Ein-Stunden-Cache ist für eine andere Form von Workload da: ein stabiler, aber selten genutzter Prefix, etwa eine große Dokumentation hinter einem Feature mit einer Handvoll Nutzern am Tag oder ein nächtlicher Batch-Job. Einmal das 2-Fache zu zahlen, um nicht jede Stunde 512 Tokens neu zu verarbeiten, lohnt sich; es für einen Token-Stream zu zahlen, der alle zehn Sekunden erneut gelesen wird, nicht.
OpenAIs Prompt-Caching-Guide ist die andere Seite derselben Münze: Dort wird ab 1.024 Tokens automatisch gecacht, Lesevorgänge sind ab GPT-5.6 mit dem 0,1-Fachen abgerechnet, und gecachte Inhalte bleiben 30 Minuten erhalten. Du bekommst keine Breakpoints, die Reihenfolge ist also der einzige Hebel, den du dort hast, und das 30-Minuten-Fenster macht langlebige Caches konstruktionsbedingt unmöglich.
| Caching-Option | Schreibpreis | Lesepreis | Am besten für |
|---|---|---|---|
| Claude 5-Minuten-Cache | 1,25x des Input-Preises | 0,1x, 0,05x auf Opus 5.5 | Interaktive Features, Fragenbursts auf einem Prefix |
| Claude 1-Stunden-Cache | 2x des Input-Preises | 0,1x, 0,05x auf Opus 5.5 | Große stabile Prefix, die selten genutzt werden, oder nächtliche Jobs |
| OpenAI automatisches Caching | Kein Aufschlag, automatisch ab 1.024 Tokens | 0,1x ab GPT-5.6, 30 Minuten Aufbewahrung | Sessions auf OpenAI, wo die Prompt-Reihenfolge der einzige Hebel ist |
| Kein Caching | Nicht zutreffend | Voller Input-Preis | Prefix unter der Mindestlänge oder vollständig dynamische Prompts |
Routing auf das kleinste Modell, das funktioniert
Der zweite Hebel ist, nicht bei jedem Request für das größte Modell zu zahlen. Das Muster lautet: Führe das billigste Modell aus, das die Aufgabe schafft, und eskaliere nur, wenn es nicht sicher genug ist. Dafür brauchst du ein Konfidenzsignal, und für alles, was keine einfache Klassifikation ist, bekommst du es leichter von einem separaten, kleinen, typisierten Entscheidungsmodell als durch das Parseln von Prosa auf Abschwächungen. Das ist der Ansatz, den ich im Produktivbetrieb einsetze und den ich in typisierten Entscheidungen für Routing und Triage beschreibe: Ein kleines kalibriertes Modell beantwortet, ob der billige Weg gut genug ist, und das teure Modell läuft, wenn es Nein sagt.
Die Regeln, die Routing funktionieren lassen, sind unspektakulär. Definiere die Eskalationsbedingung, bevor du irgendetwas misst, damit du die Schwelle hinterher nicht rationalisieren kannst. Logge die Eskalationsrate: Eine steigende Zahl bedeutet, dass sich das billige Modell oder der Prompt geändert hat, nicht dass der Traffic schwieriger geworden ist. Und halte den Antwortvertrag über alle Modelle hinweg identisch, sonst wird aus einem Downgrade eine Verhaltensänderung, die deine Nutzer bemerken.
Arbeit, die warten kann, bündeln
Der dritte Hebel gilt für alles, was nicht dem Nutzer direkt begegnet. Batch-APIs nehmen viele Requests an, führen sie über ein längeres Zeitfenster aus und rechnen mit ungefähr dem halben Preis ab, was für Zusammenfassungen, Klassifikation, Extraktion und Evaluierungsläufe ein großer Abschlag ist. Der Preis dafür ist Latenz: Ein Batch-Job wird in Stunden gemessen, nicht in Millisekunden.
Die praktische Teilung ist einfach. Alles, worauf der Nutzer wartet, läuft synchron, mit Caching und Routing. Alles, was sich einreihen lässt, läuft als Batch: nächtliche Zusammenfassungen, Tagging neuer Dokumente, das Bewerten einer Eval-Suite vor einem Release, das Anreichern eines Backlogs. Auf der Claude-Seite beträgt der Abschlag 50 % des Standardpreises: Ein nächtlicher Job, der 50 Millionen Input-Tokens verarbeitet, rutscht damit von einer großen Kostenposition auf eine bescheidene.
Bei Agentenschleifen wird das erst interessant, denn eine lange Agentenschleife schickt bei jeder Iteration ihren gesamten Verlauf erneut. Den Prefix zu cachen macht jede Iteration billig; lässt sich die Schleife so umbauen, dass unabhängige Schritte als ein Batch statt als sequenzielle Turns laufen, ist die Ersparnis noch größer.
Ein Kosten-Dashboard pro Feature
Die Kosten pro Request sagen fast nichts; die Zahl, auf die es ankommt, sind die Kosten pro erfolgreichem Ergebnis, getrennt nach Feature. Vier Metriken pro Feature reichen für den Anfang: Input- und Output-Tokens pro Request, Cache-Treffer-Quote, p95-Latenz und der Anteil der Requests, die auf das größere Modell eskaliert sind. Ein Feature, das seine Cache-Treffer-Quote und seine Eskalationsrate verdoppelt hat, ist nicht der Gewinn, den die Token-Spalte suggeriert.
Lies das Dashboard wöchentlich gegen die Eval-Suite, nicht gegen die Zahlen der Vorwoche. Eine Kostensenkung, die still die Ausgabequalität verändert, ist eine Regression, und der einzige Weg, das zu wissen, ist, denselben bewerteten Satz in beiden Konfigurationen laufen zu lassen. Der Evals-Artikel beschreibt, wie man diese Suite aufbaut, ohne eine Woche dafür zu brauchen.
Abwägungen und wann es sich nicht lohnt
Prompt-Caching ist nicht kostenlos in der Komplexität. Ein cachefreundlicher Prompt muss byte-stabil sein, was Personalisierung und jeden dynamischen Inhalt einschränkt; die Invalidierungsregeln sind beim ersten Mal nicht einleuchtend; und die Ersparnis materialisiert sich erst, wenn ein Prefix lang genug ist, um etwas zu zählen, was auf Claude mindestens 512 Tokens bedeutet. Darunter routest du lieber: Investiere die Mühe in die Wahl eines kleineren Modells.
Routing hat den umgekehrten Trade-off: Es fügt ein zweites Modell, eine zweite Menge Fehlerbilder und einen zusätzlichen Latenz-Hop hinzu und zahlt sich nur aus, wenn der billige Weg oft genug richtig liegt. Batch-APIs lohnen sich bei genügend Volumen und sind für ein Feature mit wenig Traffic sinnlos. Bedient dein Feature 50 Requests am Tag, ist das alles wenig wichtig, und die bessere Nutzung desselben Nachmittags ist das Feature selbst.
Checkliste für LLM-Kosten und Latenz
- Logge Tokens pro Request, getrennt nach gecachtem Input, frischem Input und Output, pro Feature.
- Ordne den Prompt als Tools, System, Verlauf, Request und halte alles Variable unterhalb des Verlaufs.
- Markiere Cache-Breakpoints explizit und prüfe die Trefferquote täglich; ein stiller Einbruch ist eine Schema- oder Template-Änderung.
- Wähle die TTL nach dem Lesemuster: fünf Minuten für burstige interaktive Nutzung, eine Stunde für seltene, aber teure Prefix.
- Behandle Änderungen an den Tool-Definitionen als Kostenereignisse, weil sie den gesamten Cache invalidieren.
- Fahre zuerst das billigste Modell und eskaliere anhand eines Konfidenzsignals, das du vorher definiert hast.
- Bringe nicht interaktive Arbeit auf Batch-APIs und nimm die Stunden Latenz in Kauf.
- Tracke Eskalationsrate und p95-Latenz neben den Kosten, damit sich keine billige Regression verstecken kann.
- Führe die Eval-Suite bei jeder Konfigurationsänderung erneut aus, bevor du die Ersparnis feierst.
Alles davon gehört in dasselbe Gespräch wie die Eval-Suite und das Design der Agentenschleife; wenn du ein Feature baust, das alle drei braucht, beschreibt die Seite AI Engineering, wie ich die Arbeit sequenziere.
Quellen
Häufige Fragen
Wie viel spart Prompt-Caching?
Gecachte Lesevorgänge werden mit dem 0,1-Fachen des Input-Preises abgerechnet, auf Claude Opus 5.5 mit dem 0,05-Fachen, während der erste Schreibvorgang beim Fünf-Minuten-Cache das 1,25-Fache und beim Ein-Stunden-Cache das 2-Fache des Input-Preises kostet. Ein Prefix, der im Zeitfenster mehr als etwa fünfmal erneut gelesen wird, rechnet sich damit also, und ein stark wiederverwendeter Prefix kostet ein Zehntel dessen, was ohne Cache.
Warum trifft mein Prompt-Cache nie?
Fast immer, weil der Prefix zwischen den Requests nicht Byte für Byte identisch ist: ein Zeitstempel, eine User-ID, ein zufälliger Seed, eine umsortierte Tool-Liste oder ein einziges geändertes Zeichen in den Anweisungen. Prüfe außerdem, ob alles Dynamische unterhalb des Verlaufs sitzt, und denke daran, dass eine Änderung an den Tool-Definitionen den gesamten Cache invalidiert, sodass ein nächtliches Schema-Update die Kosten verdoppeln kann, bis es auffällt.
Soll ich den 5-Minuten- oder den 1-Stunden-Cache nehmen?
Nimm den Fünf-Minuten-Cache für burstige interaktive Workloads, bei denen viele Fragen innerhalb weniger Minuten dasselbe Dokument oder denselben System-Prompt verwenden, weil sich der geringere Schreibaufschlag nach rund fünf Lesevorgängen bezahlt hat. Nimm den Ein-Stunden-Cache für einen stabilen Prefix, der selten genutzt wird, etwa einen großen Dokumentbestand hinter einem Feature mit wenig Traffic oder einen nächtlichen Job, bei dem das zweimalige Zahlen besser ist, als den Prefix jede Stunde neu zu verarbeiten.
Wie senke ich LLM-Kosten ohne Qualitätsverlust?
In dieser Reihenfolge: stabilisiere den Prompt-Prefix und lege ihn in den Cache, verschiebe das Feature dann auf das kleinste Modell, das deine Eval-Suite besteht, routiere die verbleibenden schweren Fälle mit einem vorab definierten Konfidenzsignal auf ein größeres Modell und bringe zuletzt alles Nicht-Interaktive auf eine Batch-API. Führe den bewerteten Testsatz nach jeder Änderung erneut aus, denn eine billigere Konfiguration, die die Ausgabe verändert, ist eine Regression und keine Ersparnis.
Beeinflusst Caching die Latenz?
Es senkt die Zeit bis zum ersten Token, weil der gecachte Prefix nicht neu verarbeitet wird, aber der Effekt schrumpft, wenn die Konversation wächst, weil der nicht gecachte Teil länger wird. Latenz adressiert man meist besser mit einem kleineren Modell und damit, die Antwort an den Nutzer zu streamen, während Caching vor allem Kosten senkt und einen bescheidenen Latenzgewinn beim ersten Token bringt.