Blog/KI-Agenten
Die Agentenschleife erklärt: wie Coding-Agenten laufen und wie man sie stoppt
Wie die Agentenschleife im Code funktioniert, welche Abbruchbedingungen und Budgets man erzwingen sollte und wie sich Ralph, /loop und /goal verhalten.
Balázs Csorba··10 Min. Lesezeit
- Agent loop
- Coding agents
- Tool calling
- Claude Code
- Stop conditions
Das Wichtigste in Kürze
- Eine Agentenschleife ruft das Modell auf, führt das angeforderte Tool aus, hängt das Ergebnis an und wiederholt das, bis eine Abbruchbedingung den Lauf beendet.
- In der Claude Messages API heißt stop_reason tool_use: Tool ausführen und ein tool_result mit passender tool_use_id zurückschicken.
- Das end_turn des Modells ist die schwächste Abbruchbedingung; erzwinge Iterations-, Token- und Zeitlimits im Code und ergänze Stillstandserkennung.
- Tests sind nur dann die Ground Truth der Schleife, wenn sie scheitern können: Ein Regressionstest muss scheitern, wenn nur der Fix zurückgenommen wird.
- Äußere Schleifen wie die Ralph-Shell-Schleife sowie Claude Code /loop und /goal starten den Agenten neu oder geben ihm einen neuen Prompt, und jede braucht ihre eigene Abbruchregel.
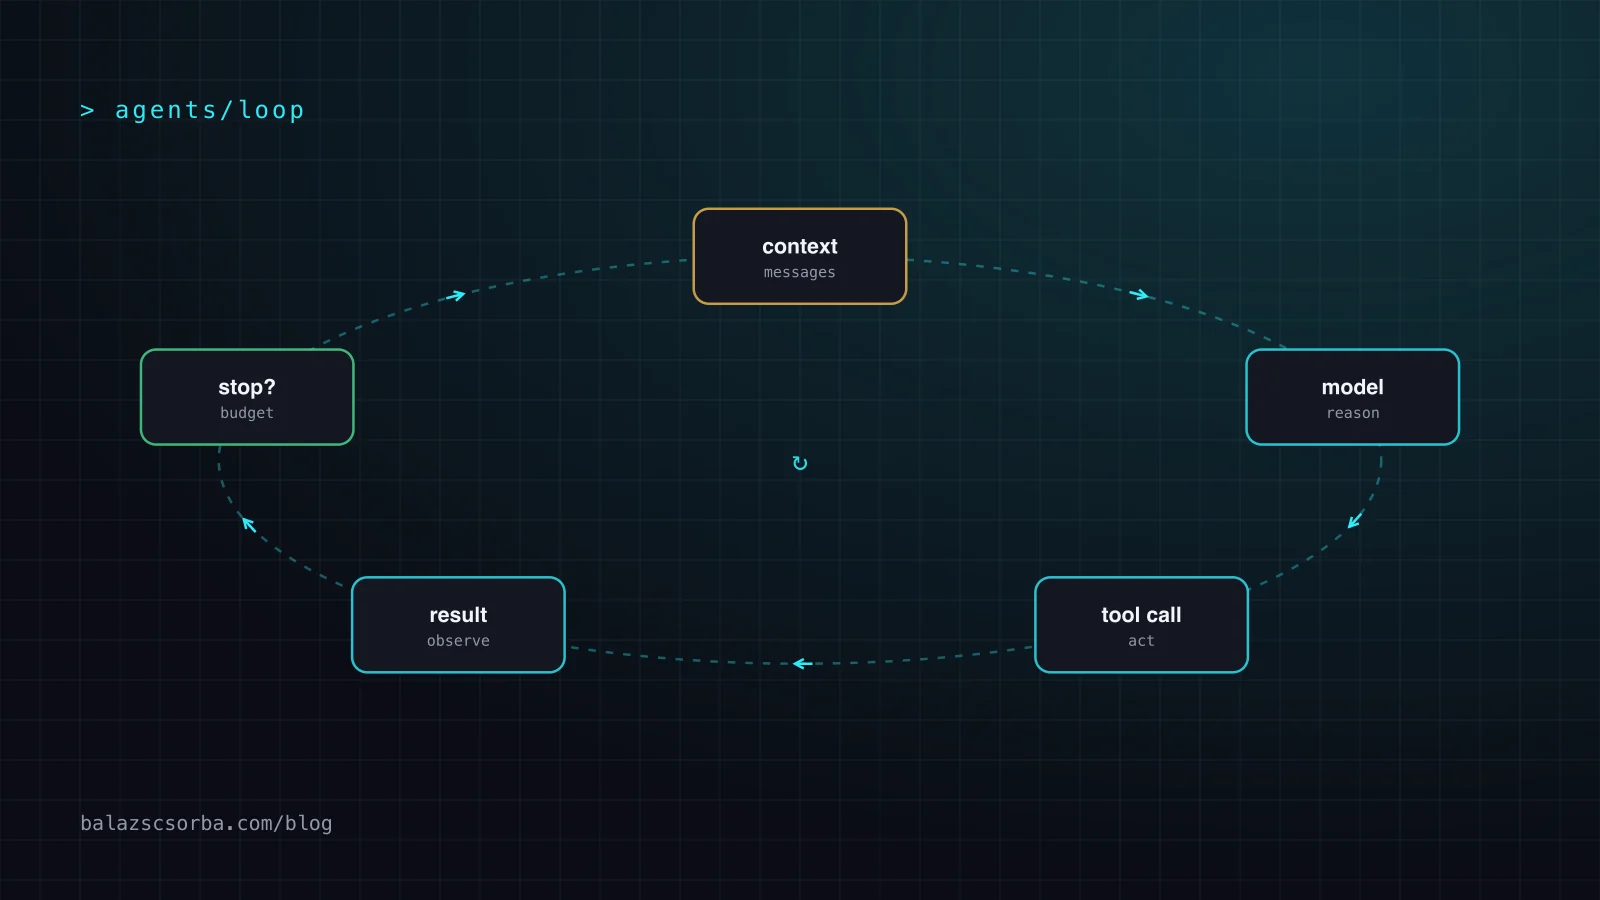
Eine Agentenschleife ist die Kontrollschleife in jedem KI-Agenten: Das Modell liest seinen Kontext, fordert einen Tool-Aufruf an, dein Code führt das Tool aus und hängt das Ergebnis an, und das Modell wird erneut aufgerufen. Das wiederholt sich, bis eine Abbruchbedingung den Lauf beendet. Coding-Agenten, Recherche-Agenten und Support-Bots haben sie alle. Was einen nützlichen Agenten von einem teuren unterscheidet, ist vor allem, wie die Schleife ihre eigene Arbeit prüft und wann sie stoppt.
Dieser Artikel geht die Schleife im Code durch, die Abbruchbedingungen und Budgets, die man erzwingen sollte, warum Tests die Ground Truth der Schleife sind, und die äußeren Schleifen darüber: Geoffrey Huntleys „Ralph“-Technik sowie die Befehle /loop und /goal von Claude Code. Am Ende stehen Fehlerbilder und eine Checkliste.
Was ist eine Agentenschleife?
Eine Agentenschleife ist ein Modell, das wiederholt Tools aufruft, aus jedem Ergebnis den nächsten Schritt ableitet, bis es meint, fertig zu sein, oder bis etwas es stoppt. Anthropics „Building effective agents“ (Dezember 2024) beschreibt Agenten als Modelle, die „in einer Schleife anhand von Rückmeldungen aus der Umgebung Tools einsetzen“, und grenzt sie von Workflows ab, in denen „LLMs und Tools durch vordefinierte Codepfade orchestriert werden“. In einem Agenten steuert das Modell seinen eigenen Ablauf; in einem Workflow tut das dein Code.
Die Idee ist älter als die heutigen Coding-Agenten. Das ReAct-Papier von Yao et al. („ReAct: Synergizing Reasoning and Acting in Language Models“, 2022) brachte Modellen bei, „Denkverläufe und aufgabenspezifische Aktionen in verflochtener Weise“ zu erzeugen: denken, handeln, beobachten, wieder denken. Bei den interaktiven Benchmarks ALFWorld und WebShop lag es mit ein oder zwei In-Context-Beispielen um 34 beziehungsweise 10 absolute Prozentpunkte über den Baselines aus Imitation und Reinforcement Learning. Moderne Tool-Calling-APIs haben dieses Prompt-Muster zu einem Protokoll gemacht: Das Modell liefert eine strukturierte Tool-Anfrage statt Text, den man parsen muss.
Wie funktioniert die Agentenschleife im Code?
Im Code ist die Agentenschleife eine while-Schleife um einen API-Aufruf. Jede Iteration sendet die vollständige Nachrichtenhistorie, und der Stoppgrund der Antwort sagt dir, ob du ein Tool ausführen und weitermachen sollst oder ob du stoppst.
Mit der Claude Messages API ist der Vertrag explizit. Wenn das Modell ein Tool braucht, hat die Antwort stop_reason: "tool_use" und einen oder mehrere tool_use-Blöcke, jeder mit id, einem Tool-name und einem input. Dein Code führt das Tool aus und schickt eine Nachricht in der Rolle „user“ zurück, die nur tool_result-Blöcke enthält, deren tool_use_id passt. Die Dokumentation zu den Stoppgründen listet die anderen Werte auf: end_turn (fertig), max_tokens, stop_sequence, refusal, model_context_window_exceeded und pause_turn – das bedeutet, dass eine serverseitige Tool-Schleife ihr eigenes Iterationslimit (standardmäßig 10) erreicht hat und du den Inhalt zurückschicken sollst, um weiterzumachen.
# Simplified sketch of an agent loop (Claude Messages API, Python SDK)
messages = [{"role": "user", "content": task}]

for turn in range(MAX_TURNS):                        # hard stop 1: iterations
    response = client.messages.create(
        model=MODEL, max_tokens=4096, tools=TOOLS, messages=messages)
    messages.append({"role": "assistant", "content": response.content})

    if response.stop_reason != "tool_use":           # end_turn, max_tokens, refusal ...
        break

    results = []
    for block in response.content:
        if block.type == "tool_use":
            output = run_tool(block.name, block.input)   # your code, your sandbox
            results.append({"type": "tool_result",
                            "tool_use_id": block.id,
                            "content": output})
    messages.append({"role": "user", "content": results})

    if budget.exceeded() or no_progress(messages):    # hard stops 2 and 3
        break
Zwei Details sind wichtiger, als sie aussehen. Erstens steckt in run_tool das gesamte Risiko: Es führt aus, worum das Modell gebeten hat, gehört also in eine Sandbox mit eng begrenzten Credentials (siehe Coding-Agenten in der CI sandboxen). Zweitens bleibt jedes Tool-Ergebnis in messages stehen, der Kontext wächst also mit jeder Iteration. Eine lange Schleife bezahlt ihre ganze Historie bei jedem Aufruf.
Wann soll eine Agentenschleife stoppen?
Eine Agentenschleife sollte stoppen, wenn die Aufgabe nachweisbar erledigt ist, und sie muss auch stoppen, wenn ein Budget ausgeht, egal was das Modell denkt. Anthropics Rat sagt es deutlich: Es ist „entscheidend, Abbruchbedingungen (etwa eine maximale Anzahl von Iterationen) einzubauen, um die Kontrolle zu behalten“.
Das end_turn des Modells ist der natürliche Ausgang, aber der schwächste. Es bedeutet nur, dass das Modell sich für fertig hält. Alles andere in der Tabelle unten gibt es, weil diese Annahme manchmal falsch ist und weil eine Schleife, die nie endet, still Geld ausgibt.
| Abbruchbedingung | Was sie aufgreift | Allein betrachtet: Schwäche |
|---|---|---|
Modell beendet seinen Turn (end_turn) | Normale Beendigung | Das Modell kann zu früh Sieg melden |
| Maximale Iterationen | Ausufernde Schleifen | Schneidet legitimerweise lange Aufgaben ab |
| Token- oder Kostenbudget | Teure Spiralen, wachsender Kontext | Braucht pro Aufgabe gemessene Zahlen |
| Zeitlimit nach echter Zeit | Hängende Tools, langsame externe Systeme | Sagt nichts über Qualität |
| Stillstandserkennung | Kreisläufe | Braucht eine Definition von „Fortschritt“ |
| Externe Prüfung (Tests, Evaluator) | Falsches „fertig“ | Nur so gut wie die Prüfung |
Stillstandserkennung ist das, was Teams überspringen – und ausgerechnet sie rettet am meisten. Definiere Fortschritt als etwas, das die Schleife zählen kann: weniger fehlschlagende Tests, erledigte Review-Stränge, eine kürzere To-do-Liste. Mein Review-Schleifen-Skill zählt erledigte Review-Stränge und stoppt nach drei Runden ohne Fortschritt, dann übergibt er an einen Menschen, statt eine vierte Variante desselben Fixes zu versuchen. Die Zahl ist willkürlich; dass es eine gibt, nicht.
Warum Tests die Ground Truth der Agentenschleife sind
Eine Schleife kann sich nur an etwas korrigieren, womit sie nicht diskutieren kann. Für Coding-Agenten ist das ein Testlauf, ein Compiler oder ein Type Checker: Ausgabe aus der Umgebung, nicht die Meinung des Modells über seine eigene Arbeit.
„Building effective agents“ sagt, Agenten brauchen „in jedem Schritt Ground Truth aus der Umgebung (etwa Ergebnisse von Tool-Aufrufen oder Codeausführung)“. In der Praxis heißt das zwei Regeln. Der Agent führt die Tests selbst aus, innerhalb der Schleife, und liest die Ausgabe. Und die Tests müssen scheitern können. Simon Willisons Rot/Grün-TDD-Muster sagt es deutlich: „Wenn du diesen Schritt überspringst, baust du möglicherweise einen Test, der schon grün ist.“ Meine eigene Regel für Bugfixes ist strenger: Der Regressionstest muss mit dem Fix bestehen und scheitern, wenn nur der Fix zurückgenommen wird. Ein Test, der in beiden Fällen besteht, gibt der Schleife nichts, womit sie steuern kann.
Anthropics „Effective harnesses for long-running agents“ (November 2025) zeigt dieselbe Idee in größerem Maßstab: eine Feature-Liste in JSON, in der jedes Feature mit "passes": false beginnt, ein Feature pro Session und die Anweisung, es sei „inakzeptabel, Tests zu entfernen oder zu ändern“. Die Fehlerbilder, die sie aufzählen, sind genau die, die man bei einer schwachen Prüfung erwartet: das Projekt zu früh für fertig erklären und Features ohne End-to-End-Tests abhaken. Das größere System aus Prüfungen rund um das Modell ist Thema von Harness Engineering.
Äußere Schleifen: Ralph, /loop und /goal
Eine äußere Schleife startet die Agentenschleife selbst neu: eine frische Session pro Iteration, einen Zeitplan oder eine Bedingung, die nach jedem Turn geprüft wird. So bekommst du aus einem Agenten, dessen einzelner Lauf nach Minuten endet, Stunden Arbeit.
Die Ralph-Technik
Geoffrey Huntleys „Ralph“ (Juli 2025) ist die Minimalversion. In seinen Worten: „Ralph ist eine Bash-Schleife“:
while :; do cat PROMPT.md | claude-code ; done Jede Iteration startet eine neue Agentensession mit demselben Prompt. Der Zustand liegt auf der Platte, nicht im Kontext: Spezifikationen und eine fix_plan.md mit der priorisierten Restarbeit, die der Agent aktualisiert. Seine zentrale Regel lautet „ein Punkt pro Schleife“, weil „je mehr du das Kontextfenster nutzt, desto schlechter werden die Ergebnisse“. Tests nach jeder Änderung halten die Schleife ehrlich. Zum Anwendungsbereich sagt er ausdrücklich: Das Verfahren passt zu Greenfield-Projekten, in einer bestehenden Codebasis würde er es nicht einsetzen.
Claude Code /loop und /goal
Claude Code bringt zwei äußere Schleifen auf Session-Ebene mit. Laut den Dokumenten zu Scheduled Tasks ist /loop ein mitgelieferter Skill, der einen Prompt wiederholt, solange die Session offen bleibt. /loop 5m check the deploy wandelt das Intervall in einen Cron-Schedule um (Einheiten s, m, h, d, mit Minutengenauigkeit). Mit einem Prompt, aber ohne Intervall wählt Claude nach jeder Iteration eine Verzögerung zwischen einer Minute und einer Stunde und gibt an, warum. Ein blankes /loop führt einen eingebauten Wartungs-Prompt aus: unfertige Arbeit fortsetzen, den Pull Request des aktuellen Branchs betreuen, dann Aufräumdurchläufe. Eine .claude/loop.md oder ~/.claude/loop.md ersetzt diesen Standard-Prompt.
Interessant sind die Abbruchregeln. Geplante Prompts werden nur zwischen den Turns ausgelöst, solange die Session untätig ist. Esc stoppt eine selbstgesteuerte Schleife, und Claude kann sie selbst beenden, sobald die Arbeit fertig ist. Schleifen mit festem Intervall laufen, bis sie abgebrochen werden, und wiederkehrende Aufgaben laufen nach sieben Tagen ab, was „begrenzt, wie lange eine vergessene Schleife laufen kann“. Eine Session fasst bis zu 50 geplante Aufgaben.
/goal arbeitet mit einer Bedingung statt mit einer Uhr. Nach jedem Turn prüft ein kleines, schnelles Modell, ob die Bedingung erfüllt ist; wenn nicht, startet Claude einen weiteren Turn. Das Ziel ist erledigt, wenn die Bedingung erfüllt ist, wenn der Evaluator sie für unerreichbar hält, oder bei einem Fehler, den du beheben musst. Nutzt Claude mehrere Turns hintereinander keine Tools mehr, stoppt Claude Code die Schleife und gibt die Kontrolle zurück. Die Dokumentation empfiehlt einen messbaren Endzustand, eine benannte Prüfung und eine Grenze wie „oder nach 20 Turns stoppen“.
| Äußere Schleife | Die nächste Iteration startet, wenn | Kontext pro Iteration | Sie stoppt, wenn |
|---|---|---|---|
Ralph (Shell-while) | Die vorige Session endet | Frisch; Zustand in Dateien | Du sie beendest oder der Plan aufgebraucht ist |
Claude Code /loop | Ein Intervall verstreicht | Gleiche Session | Du stoppst oder brichst ab, Claude beendet sie oder sieben Tage vergehen |
Claude Code /goal | Der vorige Turn endet | Gleiche Session | Der Evaluator sagt erfüllt oder unerreichbar, oder ein nicht behebbarer Fehler |
Sub-Agenten sind der andere Weg, Schleifen zu verschachteln. Ein Orchestrator zerlegt laut Anthropic Aufgaben „dynamisch, delegiert sie an Worker-LLMs und synthetisiert deren Ergebnisse“. Jeder Worker läuft mit seiner eigenen Schleife in seinem eigenen Kontext und gibt nur eine Zusammenfassung zurück, was den Kontext des Elternteils klein hält. Wie sich das gegen Regeln-Dateien, Skills und Tools rechnet, steht in der Entscheidungsmatrix für das Kontextbudget.
Wann du keine Agentenschleife einsetzen solltest und wie Schleifen scheitern
Setz keine Agentenschleife ein, wenn du die Schritte schon kennst. Ein fester Workflow ist günstiger, schneller und leichter zu testen. Anthropics Rat lautet, mehrstufige agentische Systeme „erst einzuführen, wenn einfachere Lösungen nicht ausreichen“.
Wenn eine Agentenschleife das richtige Werkzeug ist, sind das die Wege, auf denen sie falsch geht:
- Endlose Schleife. Denselben Fix in kleinen Varianten erneut versuchen. Das Gegenmittel ist eine harte Iterationsgrenze plus Stillstandserkennung, nicht ein besserer Prompt.
- Kontextaufblähung. Jedes Tool-Ergebnis bleibt in der Historie, und die Qualität sinkt, wenn der Kontext wächst. Huntleys „ein Punkt pro Schleife“ und frische Sessions pro Iteration sind eine direkte Antwort; ebenso Sub-Agenten und Kompaktierung.
- Die Prüfung aushebeln. Ist der einzige Ausgang „Tests sind grün“, ist das Bearbeiten des Tests eine Abkürzung zum Ausgang. Verbiete es in den Anweisungen, schütze Testdateien, wo du kannst, und reviewe den Test-Diff getrennt vom Code-Diff.
- Zu früh Sieg melden. Das Modell beendet seinen Turn mit offener Arbeit. Eine äußere Prüfung (ein Evaluator, eine Feature-Liste, CI) entscheidet über „fertig“, nicht der Agent.
- Unbegrenzte Nebenwirkungen. Schleifen, die pushen, deployen oder posten, können eine unumkehrbare Aktion wiederholen. Menschen geben alles Öffentliche oder Unumkehrbare frei; die Schleife bereitet es vor.
Checkliste für die Agentenschleife
- Entscheide, ob du eine Schleife brauchst. Wenn die Schritte bekannt sind, schreib einen Workflow.
- Setze harte Limits im Code: maximale Iterationen, ein Token- oder Kostenbudget und ein Zeitlimit nach echter Zeit.
- Definiere Fortschritt als Zahl (fehlschlagende Tests, offene Stränge, verbleibende Punkte) und stopp nach N Runden ohne Änderung.
- Gib der Schleife Ground Truth: Tests, Typen und Linter, die der Agent selbst ausführt, und einen Regressionstest, der scheitert, wenn der Fix zurückgenommen wird.
- Halte den Zustand auf der Platte, nicht nur im Kontext: eine Plan-Datei, ein Fortschrittsprotokoll, Git-Commits.
- Ein Punkt pro Iteration bei langen Läufen, mit frischem Kontext oder Sub-Agenten für die Exploration.
- Pack den Tool-Runner in eine Sandbox und gib ihm eng begrenzte, kurzlebige Credentials.
- Übergib an einen Menschen, wenn die Schleife stockt, und vor allem Öffentlichen oder Unumkehrbarem.
So ist die Review-Schleife in meinen Coding-Agent-Skills gebaut, und dieselbe Schleife taucht wieder auf, wenn es um den Umgang mit agentengeschriebenen Pull Requests geht. Wenn du Agentenschleifen für dein eigenes Team entwirfst, schau dir AI Engineering an.
Quellen
- Anthropic: Building effective agents (Dezember 2024)
- Yao et al.: ReAct: Synergizing Reasoning and Acting in Language Models (2022)
- Claude API-Dokumentation: Handling stop reasons
- Anthropic: Effective harnesses for long-running agents (November 2025)
- Simon Willison: Red/green TDD (Agentic Engineering Patterns)
- Geoffrey Huntley: Ralph Wiggum as a "software engineer" (Juli 2025)
- Claude Code-Dokumentation: Run prompts on a schedule (/loop)
- Claude Code-Dokumentation: Keep Claude working toward a goal (/goal)
Häufige Fragen
Was ist der Unterschied zwischen einem KI-Agenten und einem Workflow?
In einem Workflow legt dein Code die Reihenfolge der LLM- und Tool-Aufrufe vorab fest. In einem Agenten entscheidet das Modell den nächsten Schritt selbst, anhand der Ergebnisse früherer Tool-Aufrufe, und macht weiter, bis es selbst stoppt oder ein Limit es stoppt. Workflows sind günstiger und leichter zu testen, also nimm einen Agenten nur, wenn sich die Schritte nicht vorab kennen lassen.
Wie bringe ich einen KI-Agenten dazu, nicht endlos zu laufen?
Setze harte Limits in den Code, der die Schleife ausführt: eine maximale Iterationszahl, ein Token- oder Kostenbudget und ein Zeitlimit nach echter Zeit. Dazu kommt eine Stillstandserkennung, etwa das Stoppen nach drei Runden, in denen die Zahl der fehlschlagenden Tests oder der offenen Review-Stränge nicht sinkt, und an diesem Punkt die Übergabe an einen Menschen.
Wofür ist die Ralph-Schleife bei Coding-Agenten gut?
Ralph ist eine Technik, die Geoffrey Huntley im Juli 2025 beschrieben hat: eine while-Schleife in der Shell, die einem frischen Coding-Agenten immer wieder dieselbe Prompt-Datei vorlegt. Der Zustand liegt in Dateien wie Spezifikationen und einem priorisierten Fix-Plan, jede Iteration erledigt einen Punkt, und Tests halten die Arbeit ehrlich. Huntley empfiehlt sie für Greenfield-Projekte, nicht für bestehende Codebasen.
Was macht der Befehl /loop in Claude Code?
/loop ist ein mitgelieferter Skill von Claude Code, der einen Prompt wiederholt, solange die Session offen bleibt. Mit einem Intervall wie 5m läuft er als Cron-Schedule; ohne Intervall wählt Claude jedes Mal eine Verzögerung zwischen einer Minute und einer Stunde. Ein blankes /loop führt einen eingebauten Wartungs-Prompt oder deine loop.md aus. Wiederkehrende Aufgaben laufen nach sieben Tagen ab.
Was bedeutet pause_turn in der Claude API?
pause_turn ist ein Stoppgrund: Eine serverseitige Tool-Schleife, etwa eine Websuche, die die API ausführt, hat ihr Iterationslimit erreicht, standardmäßig 10. Das ist kein Fehler. Schick den Inhalt der Assistant-Nachricht in einer neuen Anfrage zurück, und das Modell macht da weiter, wo es aufgehört hat.