Blog/KI-Agenten
Kontext-Engineering für Coding-Agenten: AGENTS.md, Skills, MCP oder CLI?
Kontext-Engineering entscheidet, was ein Coding-Agent im Kontext hat: Regeln in AGENTS.md, Prozeduren in Skills – und wann ein MCP-Tool einen Shell-Befehl schlägt.
Balázs Csorba··8 Min. Lesezeit
- Context engineering
- AGENTS.md
- Agent skills
- MCP
Das Wichtigste in Kürze
- Kontext-Engineering ist ein Aufmerksamkeitsbudget statt eines Token-Budgets: Was du dem Modell vorlegst, konkurriert mit dem Code, den es lesen muss.
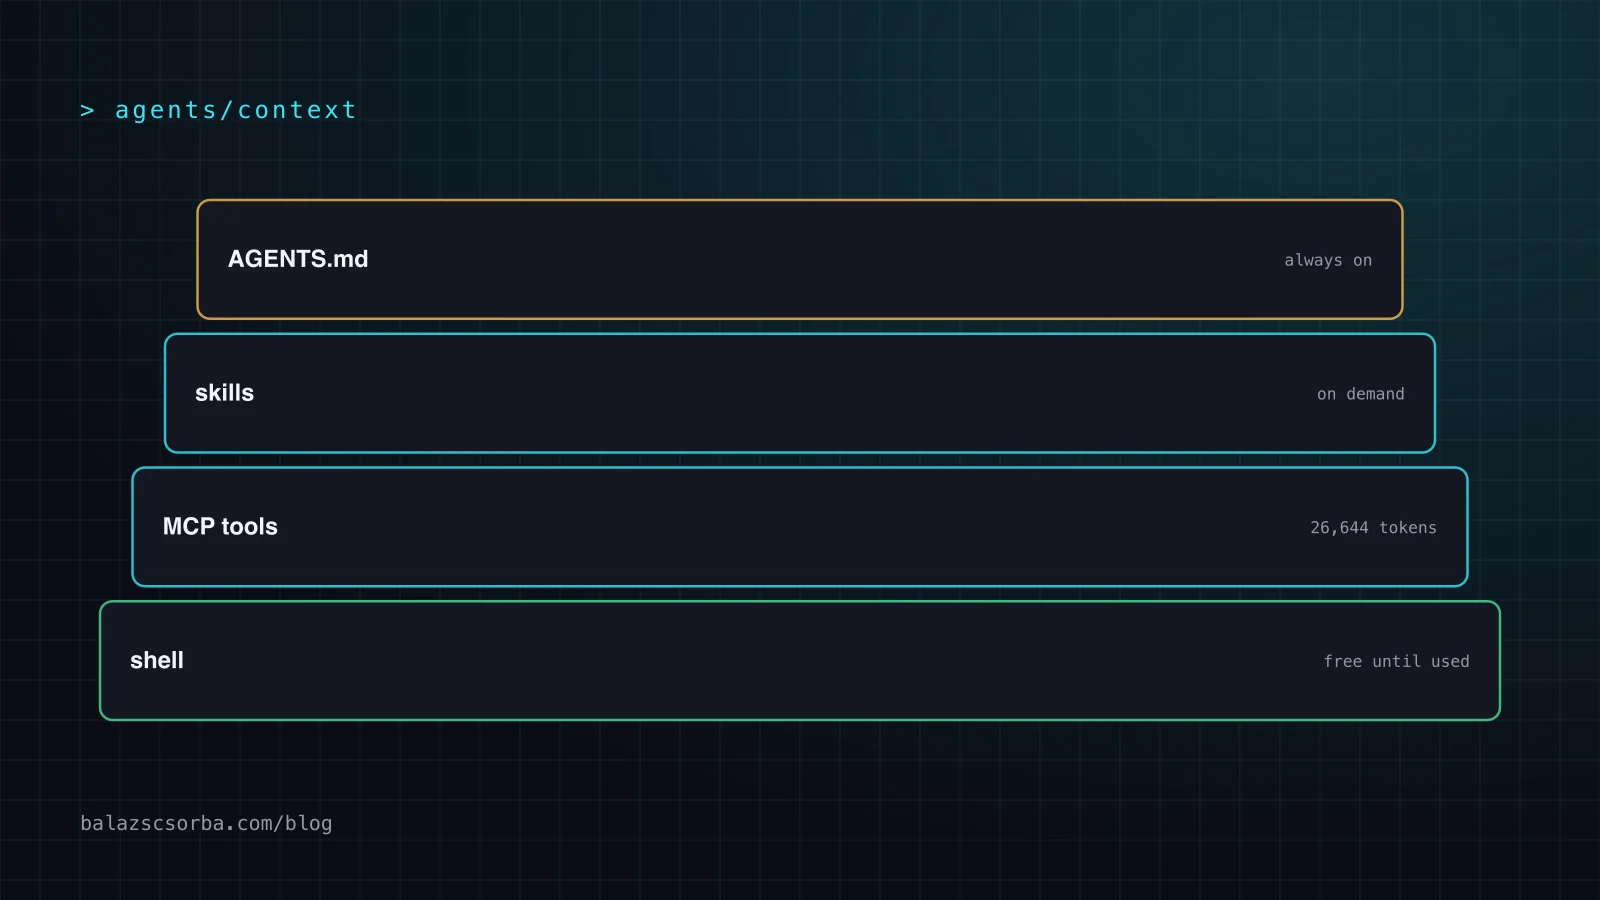
- Vier Schichten erledigen die Arbeit: dauerhaft geladene Regeln in AGENTS.md, on demand geholte Prozeduren in Skills, resident geladene MCP-Tool-Schemas und die Shell.
- Tool-Definitionen sind die teure Schicht: 85 GitHub-MCP-Tools gemessen bei 26,644 Tokens gegenüber 3,185 für einen Server mit 15 Tools.
- Tool Search senkte den Token-Verbrauch um 85 % und hob gleichzeitig die Genauigkeit, und Code Execution mit MCP brachte eine Tool-Fläche von 150,000 Tokens auf rund 2,000.
- Eine Fähigkeit, die bereits als dokumentierter Befehl existiert, gehört hinter die Shell, und Credentials sollten den Agenten nur über die Umgebung erreichen.
Kontext-Engineering heißt zu entscheiden, was ein Coding-Agent in seinem Kontextfenster hat, wann er es bekommt und in welcher Form. Ein Agent liest nie dein Repository; er liest ein Fenster, das dein Tooling aus Anweisungsdateien, Tool-Definitionen, Skills und Kommandoausgaben zusammensetzt. Wird dieses Fenster schlecht gebaut, arbeitet der Agent mit einer veralteten Regel, einer fehlenden Prozedur – oder 26.000 Tokens Tool-Schemas und keinem Platz mehr für den Code, den er ändern soll.
Dieser Artikel zerlegt das Fenster in vier Schichten, beziffert grob die Token-Kosten jeder und klärt, wann sich ein MCP-Server lohnt und wann ein einfacher Shell-Befehl die bessere Schnittstelle ist. Am Ende stehen eine Entscheidungsmatrix, die du in fünf Minuten auf ein neues Werkzeug anwenden kannst, und eine Checkliste, um eine bestehende Einrichtung zu prüfen.
Was ist Kontext-Engineering?
Kontext-Engineering ist die Praxis, den Input zusammenzustellen, mit dem ein Modell arbeitet. Anthropics Leitfaden „Effective context engineering for AI agents“ (September 2025) rahmt das als Aufmerksamkeitsbudget statt als Token-Budget: Was du dem Modell vorlegst, konkurriert um seine Aufmerksamkeit, also zählt Relevanz mehr als Vollständigkeit. Derselbe Beitrag empfiehlt, für die kleinstmögliche Zahl von Schritten die kleinstmögliche Menge aussagekräftiger Tokens zu schreiben.
Das Wort ist schneller in den Mainstream gerutscht als die Praxis. Thoughtworks' Technology Radar hat Kontext-Engineering im April 2026 auf Adopt gesetzt, und das fasst die Lage ziemlich genau zusammen: Das Muster steht, die Implementierungen sind noch uneinheitlich. Die interessante Engineering-Arbeit liegt nicht im Prompting. Sie liegt darin, je nach Situation zu entscheiden, welche der vier Schichten resident sein soll, welche on demand geholt wird und welche überhaupt nicht ins Fenster gehört.
Warum langer Kontext schlechter wird: Context Rot
Context Rot ist der beobachtete Genauigkeitsverlust, wenn die Eingabe wächst, und er verläuft nicht als glatte Kurve. Chromas Studie Context Rot (Juli 2025) ließ 18 Modelle über Needle-in-a-Haystack-Aufgaben mit wachsender Eingabelänge laufen und fand, dass die Leistung ungleichmäßig abfällt: Manche Modelle verlieren mitten in einer langen Eingabe deutlich an Qualität, andere halten viel länger durch, und die Rangfolge der Modelle verschiebt sich mit der Länge.
Zwei praktische Folgen. Ein 1M-Token-Fenster ist eine Kapazitätsangabe, keine Genauigkeitsangabe, und die Mitte eines langen Kontexts ist der schlechteste Ort für eine Anweisung, der du nachfolgen willst. Und weil der Verlust modellspezifisch ist, ist „es passt“ kein Argument: Du musst mit dem Modell testen, das du tatsächlich betreibst.
Die vier Schichten und ihre Kosten
Fast jede Agenten-Einrichtung, die ich kenne, ist eine Variante dieser vier Schichten, und die nützliche Frage ist nicht, welche davon man nimmt, sondern wie viel davon dauerhaft resident bleibt. Die Schichten unterscheiden sich darin, wann sie geladen werden, und genau darum geht es: Eine resident geladene Schicht kostet bei jedem Request Aufmerksamkeit, auch bei den vielen Requests, in denen sie irrelevant ist.
| Schicht | Inhalt | Geladen | Typische Kosten |
|---|---|---|---|
| Anweisungsdatei (AGENTS.md) | Regeln, die immer gelten: Build-Befehle, Konventionen, Ablehnungen | Jeder Request | 200 bis 1.000 Tokens |
| Skills | Prozeduren für eine bestimmte Aufgabe, jede in einer eigenen Datei | Zuerst nur Metadaten, dann die Datei | Etwa 100 Tokens pro Skill, Inhalt on demand |
| MCP-Tools | Namen, Beschreibungen und JSON-Schemas jedes bereitgestellten Tools | Jeder Request, pro Server | 85 Tools: 26.644 Tokens; 15 Tools: 3.185 |
| Shell | Alles, was auf der Maschine schon vorhanden ist | Nur wenn ein Befehl läuft | Null, bis Ausgaben ankommen |
AGENTS.md ist das Nächste, was es an einem gemeinsamen Standard gibt: ein offenes Dateiformat, das die Agentic AI Foundation pflegt und das von über 60.000 Projekten genutzt wird. Sein Wert: Es ist immer geladen und immer gleich, deshalb kann die Runtime eine Regel darin nicht vergessen. Sein Preis: Es wird bei jedem Turn berechnet, weshalb es Regeln enthalten sollte und kein Wissen.
Skills sind die Schicht der progressiven Offenlegung: ein Verzeichnis kleiner Markdown-Prozeduren, in dem der Agent zuerst nur einen Namen und eine Beschreibung sieht und eine Datei erst dann liest, wenn die Aufgabe es verlangt. Die Spezifikation begrenzt den Namen auf 64 Zeichen und die Beschreibung auf 1,024, und die Konvention ist, eine SKILL.md unter 500 Zeilen zu halten. Mein eigenes Setup hält rund zwanzig davon in einem Masterordner, der in drei Agenten synchronisiert ist; der Beitrag zum Skills-Workflow beschreibt, wie dieser Ordner aufgebaut ist.
MCP-Tools sind die teure Schicht
Tool-Definitionen sind reiner Overhead, bis ein Tool aufgerufen wird, und genau in dieser Schicht fügen Leute am schnellsten Tools hinzu. Ein gemessener Vergleich von Blocks.ai setzt die 85 Tools des GitHub-MCP-Servers bei 26.644 Tokens an und einen Server mit 15 Tools bei 3.185 Tokens. Beide Zahlen gehen bei jedem Turn in jeden Request dieser Session, auch in die Turns, in denen der Agent nur eine Datei liest.
Zwei Ansätze verringern das, ohne Fähigkeiten zu löschen. Tool Search lud in Anthropics Arbeit Advanced Tool Use (November 2025) Tool-Definitionen on demand und senkte den Token-Verbrauch um 85 %, während die Genauigkeit bei einem Modell von 49 % auf 74 % und bei einem anderen von 79,5 % auf 88,1 % stieg. Code Execution mit MCP, aus demselben Jahr, ging den anderen Weg: Statt Tools zu beschreiben, bekommt das Modell Code, der sie aufruft, und die Tool-Fläche schrumpft von rund 150.000 Tokens auf 2,000, eine Reduktion um 98,7 %.
Die praktische Regel ist die, bei der die Tool-Design-Literatur immer wieder landet: eine Fähigkeit pro Tool und ein Name, der sagt, wann man es einsetzt. Ein Server, der eine REST-API eins zu eins abbildet, gibt dem Modell 85 Wege, vier Dinge zu tun. Die Erkenntnisse aus einem Jira-Server mit 20 Tools zeigen, wie ich meinen konsolidiert habe.
Wann eine CLI statt eines MCP-Servers die richtige Wahl ist
Ein Shell-Befehl und ein MCP-Tool können dieselbe Aufgabe erfüllen, und die Schnittstelle, die du wählst, verändert die Kontextrechnung und die Angriffsfläche. Die CLI gewinnt, wenn die Fähigkeit bereits als Befehl existiert, wenn der Agent sie mit Pipes verketten muss, und wenn das Ergebnis groß, aber mit Flags filterbar ist. Der MCP-Server gewinnt, wenn der Agent sonst die Befehlssyntax erraten müsste, und wenn Credentials an einer Stelle liegen sollen statt auf jeder Maschine.
Die Verwahrung der Credentials ist der Grund, warum MCP in vielen Setups weiterhin gewinnt, auch in meinem. Meine Regel: Credentials kommen nur aus der Umgebung; der Agent liest nie eine Credential-Datei und gibt nie ein Token aus. Ein MCP-Server hält das Token in seinem eigenen Prozess, ein Tool-Aufruf trägt also eine kurzlebige Berechtigung statt eines Pfads zu einem langlebigen Geheimnis. Ein Shell-Befehl kann genauso sicher sein, wenn die Umgebung die einzige Quelle ist, und unsicherer, wenn der Befehl curl gegen ein Token ist, das der Agent erst lesen musste.
| Situation | Dann nimm | Warum |
|---|---|---|
| Der Befehl existiert schon und ist dokumentiert | Shell | Null resident Tokens, und Pipes setzen sich zusammen |
| Der Agent müsste Flags oder die Ausgabeform raten | MCP-Tool | Das Schema dokumentiert beides |
| Die Ausgabe ist riesig, hat aber einen Filter | Shell | Serverseitig filtern statt im Kontext |
| Der Agent muss ein Geheimnis verwenden | MCP-Tool oder ein Shell-Befehl, der nur die Umgebung liest | Beides braucht das Token nicht im Fenster |
| Ein Server bräuchte mehr als rund 20 Tools | Erst Shells, dann Tool Search | Residente Tokens wachsen linear mit der Tool-Zahl |
| Die Aufgabe ist eine einmalige Untersuchung | Shell | Eine Skill-Datei wäre dauerhafter Overhead für einen seltenen Fall |
Kompaktierung, Notizdateien und Sub-Agenten
Das Kontextfenster füllt sich in jeder langen Session, und die Lösung ist kein größeres Fenster. Drei Mechanismen fangen das ab: Kompaktierung (die ältesten Turns zusammenfassen), Notizen auf der Platte und Sub-Agenten. Alle drei tauschen resident Tokens gegen Indirektion, und alle drei verlieren Details, also sollte behalten, was du nicht ungern neu herleiten würdest.
Anthropics Beitrag zum Kontext-Engineering beschreibt Sub-Agenten als das Werkzeug für teure Suchen: Der Sub-Agent verbrennt seinen eigenen Kontext an der Exploration und gibt statt der Rohseiten eine Zusammenfassung von grob 1.000 bis 2.000 Tokens zurück. Das ist ein guter Handel, wenn die Zwischenausgabe sperrig und die Schlussfolgerung klein ist. Für eine Aufgabe, in der das Detail selbst das Ergebnis ist, ist es ein schlechter Handel.
Notizdateien sind der dritte Mechanismus und der am meisten unterschätzte. Zustand, der über Sessions hinweg wichtig ist, gehört in eine Datei, die der Agent schreibt und wieder einliest, nicht in eine Zusammenfassung, die die Runtime erzeugt hat. Die Agentenschleife ist der Grund, warum das zählt: Eine lange Schleife, die den Zustand im Fenster hält, zahlt bei jeder Iteration dafür.
Die Entscheidungsmatrix
Lege die vier Schichten nebeneinander, dann geht es im Kern um den Ladezeitpunkt. Regeln, die in jedem Turn gelten müssen, gehören in AGENTS.md. Prozeduren, die für eine Aufgabenklasse gelten, gehören in einen Skill, damit ihr Inhalt nur dann bezahlt wird, wenn er gebraucht wird. Fähigkeiten gegen ein laufendes System gehören in ein MCP-Tool, wenn der Agent sonst die Schnittstelle raten müsste. Alles Übrige gehört in einen Shell-Befehl.
Der Zielkonflikt, den man kennen muss: Jede Schicht, die du hinzufügst, hat Wartungskosten. Regeln veralten, wenn sie dem Code widersprechen. Skills veralten, wenn sich die Prozedur ändert. Tool-Schemas veralten, wenn sich die API bewegt, und eine veraltete Tool-Beschreibung ist schlimmer als gar kein Tool, weil der Agent ihr vertraut. Halte jede Schicht so klein, dass du sie beim Review ganz lesen kannst, und lösche lieber eine Schicht, als sie wachsen zu lassen.
Kontext-Engineering-Checkliste
- Die residenten Tokens einmal pro Session ausgeben: Regeln, Skill-Metadaten, Tool-Schemas. Was man nicht gemessen hat, kann man nicht steuern.
- AGENTS.md auf Regeln beschränken, die in jedem Turn gelten, und Prozeduren in Skills verschieben.
- Jedem Skill einen Namen und eine Beschreibung geben, die sagen, wann man ihn einsetzt, und den Inhalt unter ein paar hundert Zeilen halten.
- Tools konsolidieren, sodass jedes eine Fähigkeit ist und kein Endpunkt; deutlich unter 20 Tools pro Server anstreben.
- Tool Search oder Code Execution einsetzen, sobald das Schema eines Servers rund 10.000 Tokens überschreitet.
- Zuerst zur Shell greifen, wenn ein dokumentierter Befehl die Sache schon erledigt.
- Credentials ausschließlich über die Umgebung übergeben, niemals über eine Datei, die der Agent liest, und niemals in einem Prompt.
- Sperrige Exploration an Sub-Agenten schicken und die Schlussfolgerungen im Hauptkontext lassen.
- Zustand in Notizdateien festhalten statt in Zusammenfassungen, die die Runtime irgendwann wegkompaktiert.
- Bei jeder Änderung am Build die Regeln neu lesen. Eine Regel, die dem Code widerspricht, bringt dem Agenten bei, Regeln zu ignorieren.
Wenn du das für ein Team einrichtest: Der Beitrag zu den Skills behandelt die Dateistruktur, der Beitrag zum Tool-Design die Werkzeugseite, und die Seite KI-Engineering zeigt, wie es in einen Auslieferungsprozess passt.
Quellen
- Anthropic: Effective context engineering for AI agents (Sep. 2025)
- Chroma: Context Rot (Juli 2025)
- AGENTS.md: das offene Format für Agenten-Anweisungen
- Agent Skills specification
- Anthropic: Advanced tool use, tool search and programmatic tool calling (Nov. 2025)
- Blocks.ai: MCP vs CLI, the context window cost
- Thoughtworks Technology Radar: Context engineering (Adopt, April 2026)
Häufige Fragen
Was ist Kontext-Engineering bei Coding-Agenten?
Es ist die Entscheidung, was ein Modell in seinem Kontextfenster hat, wann dieser Inhalt geladen wird und in welcher Form. Anthropic rahmt das als Aufmerksamkeitsbudget statt als Token-Budget, weil die Tokens, die du hinzufügst, um Aufmerksamkeit mit dem Code konkurrieren, den der Agent lesen muss. In der Praxis heißt das: dauerhaft geladene Regeln klein halten, Prozeduren in on-demand-Skills legen und bewusst entscheiden, wie viele Tool-Definitionen resident bleiben.
AGENTS.md oder Skills?
AGENTS.md für Regeln, die in jedem Turn gelten müssen, etwa den Build-Befehl, die Konventionen und das, was der Agent ablehnen muss. Skills für Prozeduren, die für eine Aufgabenklasse gelten, denn der Inhalt eines Skills wird erst gelesen, wenn die Aufgabe es verlangt, und kostet vorher rund 100 Tokens Metadaten. Wenn eine Regel einen Absatz Erklärung braucht, ist sie ein Skill, der sich als Regel verkleidet.
Was kosten MCP-Tools im Kontext?
Tool-Definitionen werden bei jedem Request einer Session gesendet, die Kosten skalieren also mit der Anzahl der Tools. Blocks.ai hat die 85 Tools des GitHub-MCP-Servers bei 26,644 Tokens gemessen, einen Server mit 15 Tools bei 3,185. Tool Search von Anthropic lädt Definitionen on demand und senkte den Token-Verbrauch um 85 %, während die Genauigkeit stieg, und Code Execution mit MCP reduzierte eine Tool-Fläche von 150,000 Tokens auf rund 2,000.
Wann ist eine CLI besser als ein MCP-Server?
Ein Shell-Befehl ist besser, wenn die Fähigkeit bereits als dokumentierter Befehl existiert, wenn der Agent die Ausgabe durch eine Pipe leiten muss, oder wenn die Ausgabe groß, aber filterbar ist – Filtern außerhalb des Modells hält die Tokens aus dem Fenster. Ein MCP-Server ist besser, wenn der Agent Flags oder die Ausgabeform raten müsste, und wenn ein Credential in einem Prozess bleiben soll, statt aus einer Datei gelesen zu werden.
Wie verhindere ich, dass sich der Kontext eines Agenten füllt?
Drei Mechanismen: Kompaktierung fasst die ältesten Turns zusammen, Notizdateien halten den Zustand über Sessions hinweg auf der Platte fest, und Sub-Agenten verbrennen ihren eigenen Kontext an der Exploration und geben eine kurze Zusammenfassung zurück, typisch 1,000 bis 2,000 Tokens. Alle drei verlieren Details, also behalte, was du nicht ungern neu herleiten würdest, und bevorzuge eine Datei, die der Agent selbst schreibt, gegenüber einer Zusammenfassung der Runtime.