Blog/KI-Agenten
Harness Engineering: Guides und Sensors, die Agent-PRs mergebar machen
Harness Engineering für Coding-Agenten: Guides und Sensors, wo jede Prüfung laufen soll, Rot/Grün-TDD und Mutationstests für die Tests des Agenten.
Balázs Csorba··8 Min. Lesezeit
- Harness engineering
- Coding agents
- Code quality
- Mutation testing
- TDD
Das Wichtigste in Kürze
- Harness Engineering baut alles rund um das Modell eines Coding-Agenten so, dass dessen Ausgabe geprüft und korrigiert wird, bevor ein Mensch sie reviewt.
- Guides lenken den Agenten vor dem Handeln, Sensors prüfen das Ergebnis danach; beide können computational oder inferential sein.
- Regeln in Markdown-Dateien sind Anleitung, keine Durchsetzung: Gates, die immer laufen müssen, gehören in Hooks oder CI.
- Rot/Grün-TDD beweist, dass ein Test die Änderung wirklich ausübt; bei Bugfixes muss der Regressionstest scheitern, wenn nur der Fix zurückgenommen wird.
- Mutationstests auf dem Diff zeigen, ob agentengeschriebene Tests einen Bug wirklich fangen würden – über ihre Coverage-Zahl hinaus.
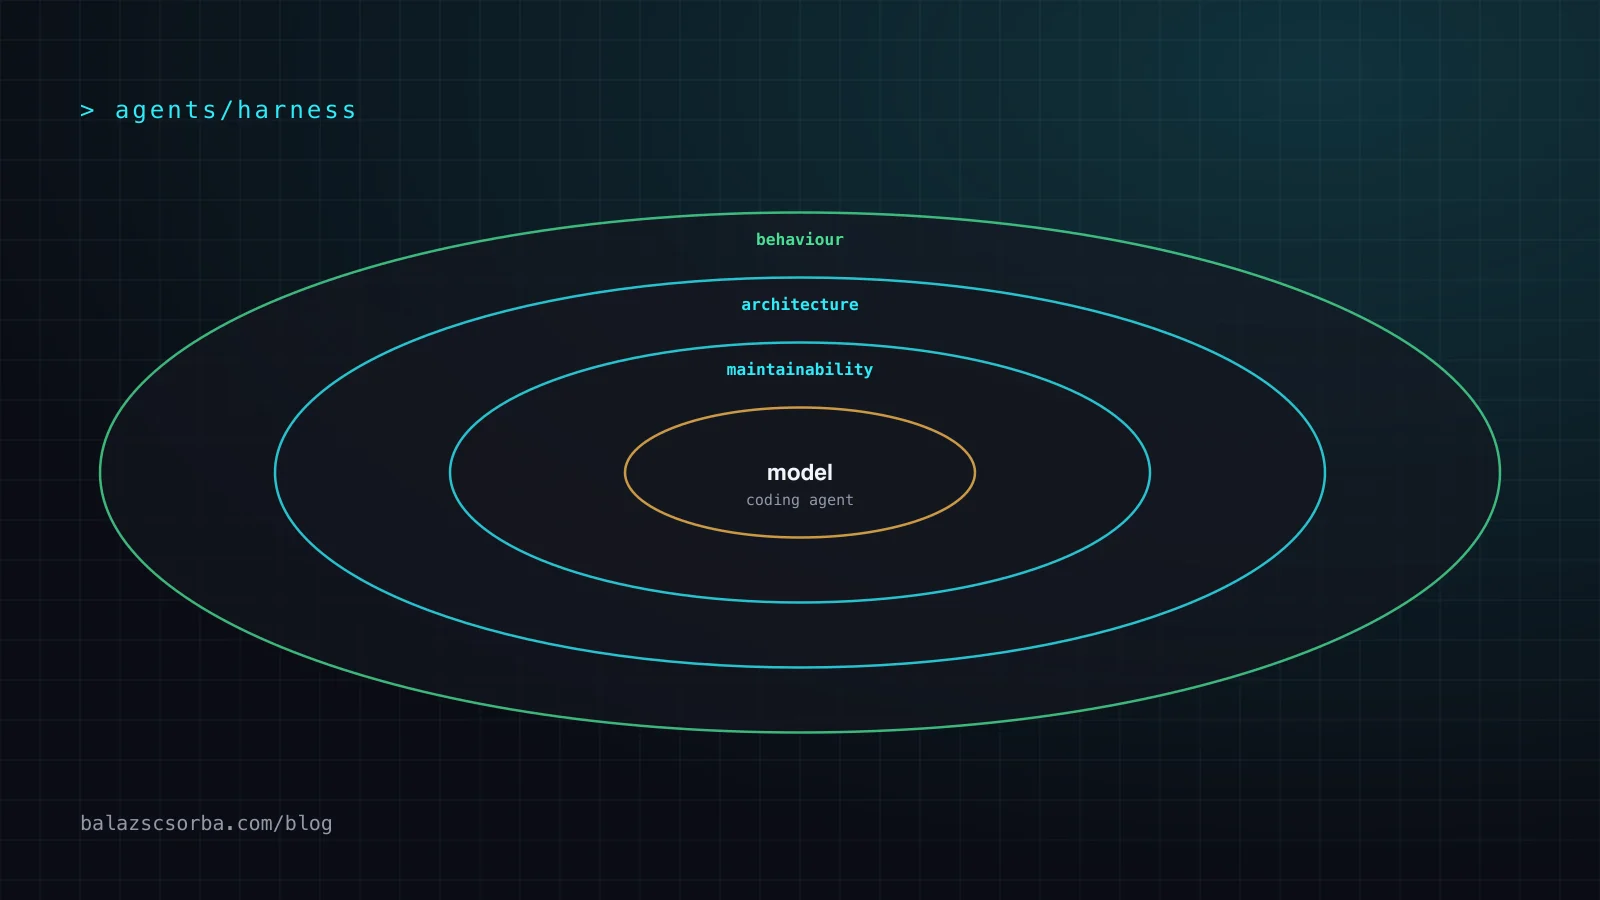
Harness Engineering ist die Arbeit, alles rund um das Modell eines Coding-Agenten zu bauen (Anweisungen, Tools, Tests, Linter, Reviews), damit das, was der Agent produziert, korrekt und wartbar ist, bevor ein Mensch es ansieht. Das Modell schreibt den Code. Der Harness entscheidet, ob dieser Code etwas taugt, und sagt dem Agenten, wenn nicht.
Dieser Artikel verwendet Birgitta Böckelers Rahmen aus Guides und Sensors, wird dann aber praktisch: welche Prüfungen wo laufen, wie Rot/Grün-TDD mit einem Agenten funktioniert, wie Mutationstests die vom Agenten geschriebenen Tests prüfen und warum Verhalten weiterhin der Schwachpunkt ist. Am Ende steht eine Checkliste dafür, wie agentische Pull Requests mergebar werden.
Was ist Harness Engineering?
Harness Engineering behandelt die Umgebung rund um das Modell als das, was man entwirft. Böckelers Artikel „Harness engineering for coding agent users“ (April 2026) fasst es so zusammen: „Agent = Model + Harness“.
Sie unterscheidet zwei Harnesses. Der eine wird mit dem Agenten ausgeliefert – in Claude Code, Codex oder opencode: System-Prompt, Tool-Schleife, Sandbox. Der andere entsteht bei dir rund um deine Codebasis: Regeln-Dateien, Skills, Testbefehle, Linter, Review-Schritte. Am ersten änderst du wenig. Der zweite gehört dir, und aus ihm kommt der größte Qualitätsunterschied zwischen Teams.
Manche Codebasen nehmen einen Harness besser auf als andere. Böckeler nennt das Harnessability: Eine „stark typisierte Sprache hat von Natur aus das Type Checking als Sensor“, und klare Modulgrenzen machen Architekturregeln überhaupt erst möglich. Eine Codebasis ohne Tests und ohne Typen gibt einem Agenten nichts, wogegen er sich prüfen könnte – er muss raten.
Guides und Sensors: Feedforward und Feedback
Guides lenken den Agenten, bevor er handelt; Sensors prüfen das Ergebnis, nachdem er gehandelt hat, damit er sich selbst korrigieren kann. Beide gibt es in zwei Ausprägungen: computational (von der CPU ausgeführt, deterministisch) und inferential (von einem Modell ausgeführt, semantisch, aber probabilistisch).
In Böckelers Worten „antizipieren die Guides das Verhalten des Agenten und zielen darauf ab, ihn bevor sein Handeln zu lenken“, während Sensors „nachdem der Agent gehandelt hat, beobachten und ihm helfen, sich selbst zu korrigieren“. Computational Controls sind „deterministisch und schnell, von der CPU ausgeführt“: Tests, Linter, Type Checker. Inferential Controls sind semantische Analyse und KI-Code-Review: langsamer, teurer und nicht deterministisch, aber sie können Dinge beurteilen, die ein Linter nicht kann.
| Merkmal | Computational Control | Inferential Control |
|---|---|---|
| Beispiele | Tests, Type Checker, Linter, Abhängigkeitsregeln, Mutationstests | KI-Code-Review, Review-Sub-Agent, Regeln in AGENTS.md oder Skills |
| Ergebnis | Gleiche Eingabe, gleiche Antwort | Kann zwischen Läufen schwanken |
| Geschwindigkeit und Kosten | Schnell, günstig zu wiederholen | Langsamer, kostet pro Lauf Tokens |
| Fängt ab | Strukturelle Probleme: Typen, Stil, Testabdeckung, verbotene Importe | Semantische Probleme: Benennung, Design, fehlende Randfälle |
| Kann einen Merge allein blockieren? | Ja | Besser als Rat an den Agenten oder einen Menschen |
Böckeler gruppiert Harnesses danach, was sie beschützen. Wartbarkeit ist am weitesten entwickelt: Computational Sensors fangen zuverlässig „doppelten Code, zyklomatische Komplexität, fehlende Testabdeckung, architektonisches Abdriften“. Architekturtauglichkeit umfasst Performance-Anforderungen und Konventionen, geprüft mit Fitness Functions. Verhalten, also ob die Software tut, was sie soll, ist die Lücke – es bekommt unten einen eigenen Abschnitt.
Wo sollten Sensors laufen?
Die schnellen Sensors laufen in der Schleife des Agenten nach jeder Änderung, das vollständige Gate vor jedem Commit, die langsamen in der CI. Je früher ein Sensor auslöst, desto billiger ist die Korrektur: Der Agent behebt sie in derselben Session, bevor ein Reviewer sie überhaupt sieht.
Böckeler nennt das, Qualität links zu halten: schnelle Linter vor dem Commit, breiteres Review danach, teure Analysen wie Mutationstests nach der Integration. In ihrem Folgeartikel „Maintainability sensors for coding agents“ (Mai 2026) probierte sie ESLint, dependency-cruiser, Semgrep, Coverage, Stryker und GitLeaks als Sensors aus und fand, dass computistische Werkzeuge auf Dateiebene am besten funktionieren, ein modellbasiertes Review dagegen bei Fragen über Modulgrenzen hinweg. Sie schildert auch das praktische Problem: „Ich musste die Agenten viele, viele Male fragen, warum sie die Sensorenprüfung nicht ausgeführt haben.“
Genau dieser Satz ist das Argument für Durchsetzung. Eine Regel in einer Markdown-Datei ist ein Guide; der Agent hält sich womöglich daran, vielleicht auch nicht. Die Memory-Dokumentation von Claude Code sagt dasselbe über die eigenen Regeln-Dateien: Claude behandelt sie „als Kontext, nicht als durchgesetzte Konfiguration“, und um eine Aktion unabhängig von der Modellentscheidung zu blockieren, brauchst du einen Hook. Mein eigenes Gate ist absichtlich langweilig: die komplette PHPUnit-Suite und PHPStan laufen vor jedem Commit, und ein übersprungener oder partieller Lauf wird genau so gemeldet, niemals als grün.
Rot/Grün-TDD mit Coding-Agenten
Rot/Grün-TDD heißt: Der Agent schreibt einen Test, führt ihn aus und schaut, wie er scheitert, dann schreibt er den Code und schaut, wie der Test besteht. Der fehlschlagende Lauf ist der Punkt: Er beweist, dass der Test das neue Verhalten überhaupt ausübt.
Simon Willison führt das in seinem Leitfaden „Agentic Engineering Patterns“ als kurzen Prompt auf – „Use red/green TDD“ – und nennt den Grund: „Wenn du diesen Schritt überspringst, baust du möglicherweise einen Test, der schon besteht und deshalb deine neue Implementierung weder ausübt noch bestätigt.“ Das Gegenstück, „First run the tests“, lässt den Agenten zu Beginn einer Session herausfinden, wie die Suite läuft – das macht ihn deutlich eher geneigt, sie später noch einmal zu starten.
Für Bugfixes benutze ich eine strengere Variante. Der Regressionstest muss mit dem Fix bestehen, scheitern, wenn nur der Fix zurückgenommen wird, und wieder bestehen, wenn er zurückkommt. Den Revert macht der Agent selbst und berichtet beide Läufe. Das fängt Tests ab, die das Falsche prüfen, und ist billig: zwei zusätzliche Testläufe. Der Ablauf drumherum steht in meinem Beitrag darüber, wie ich Skills für Bugfixes einsetze.
Anthropics „Effective harnesses for long-running agents“ überträgt dieselbe Idee auf ganze Projekte: eine Feature-Liste, in der jedes Feature mit "passes": false startet, ein Feature pro Session und die Regel, es sei „inakzeptabel, Tests zu entfernen oder zu ändern“. Der rote Zustand steht fest, bevor es irgendeinen Code gibt.
Mutationstests: die Tests des Agenten prüfen
Mutationstests nehmen kleine Änderungen am Produktionscode vor und lassen die Tests erneut laufen. Bestehen die Tests weiterhin, haben sie die Änderung nicht bemerkt, und sie sind schwächer, als ihre Coverage-Zahl nahelegt.
Stryker beschreibt es so: Mutanten werden „automatisch in deinen Produktionscode eingefügt. Für jeden Mutanten werden deine Tests ausgeführt. Wenn deine Tests scheitern, ist der Mutant getötet. Wenn deine Tests bestehen, hat der Mutant überlebt.“ Stryker deckt JavaScript und TypeScript, C# und Scala ab. Für PHP meldet Infection einen Mutation Score Indicator (MSI) und kann einen CI-Job unterhalb eines Schwellenwerts fehlschlagen lassen.
Das wird wichtiger, sobald Agenten die meisten Tests schreiben. Ein Agent, der „Tests ergänzen“ soll, erreicht mühelos hohe Zeilenabdeckung; ob die Assertions einen echten Bug fangen würden, ist eine andere Frage. Böckeler kommt zur selben Beobachtung: Abdeckung allein kaschiert schwache Tests, also werden Mutationstests wichtiger, wenn KI sie schreibt. Mutantenläufe dauern in einer ganzen Codebasis lange, also grenzt man sie auf die Änderung ein:
# CI step: mutate only the lines this PR touched (PHP, Infection)
git fetch --depth=1 origin $GITHUB_BASE_REF
infection --git-diff-lines --git-diff-base=origin/$GITHUB_BASE_REF --min-covered-msi=80
# 80 is an example threshold; start from your current score and raise it
Überlebende Mutanten sind zugleich gute Eingabe für den Agenten. Gib die Liste zurück mit „die folgenden haben überlebt; ergänze oder verschärfe die Assertions, damit sie getötet werden, ohne den Produktionscode zu ändern“, und der Sensor wird zu einer Rückkopplung, die der Agent selbst schließen kann.
Der Schwachpunkt: Verhaltens-Harnesses und wann man nicht überbaut
Verhalten ist der Bereich, in dem Harnesses am schwächsten sind, denn die übliche Verhaltensprüfung ist eine Testsuite, die der Agent aus einer Spezifikation geschrieben hat, die der Agent gelesen hat. Böckelers Urteil dazu: Das setzt „riesiges Vertrauen in KI-generierte Tests, und das reicht noch nicht“.
Drei Dinge helfen, keines davon umsonst:
- Akzeptanztests unter menschlicher Verantwortung. Ein kleiner Satz End-to-End-Tests, den ein Mensch geschrieben oder freigegeben hat; der Agent darf sie ausführen, aber nicht bearbeiten.
- Tests über die echte Schnittstelle. Anthropics Harness für lange Läufe hielt Browser-Automatisierung für entscheidend, damit der Agent Features „wie ein menschlicher Benutzer“ verifiziert. Bei mir übernimmt das Playwright.
- Getrenntes Review des Test-Diffs. Wenn Code und Tests zusammen geändert werden, liest ein Reviewer zuerst die Tests.
Der Preis ist Zeit und Rauschen. Jeder Sensor verlängert die Schleife, und inferential Sensors kosten Tokens und erzeugen Fehlalarme. Ein Review-Sub-Agent, der pro PR zehn Stil-Nits meldet, trainiert alle – Mensch und Agent –, ihn zu übergehen. Baue keinen Harness für ein Wegwerf-Skript. Baue einen für Code, der gepflegt wird, und lass ihn an echten Fehlschlägen wachsen: Muss ein Agent-PR jedes Mal von einem Menschen korrigiert werden, frage, welcher Guide oder Sensor das gefangen hätte. Böckelers Vorbehalt gilt auch: Menschen bringen Urteilsvermögen und Verantwortung als „impliziten Harness“ mit, und ein dokumentierter Harness „kommt nur so weit“. Wie das menschliche Review nicht zum Engpass wird, steht in meinem Beitrag über das Review KI-generierter Pull Requests.
Checkliste für Harness Engineering
- Schreibe die Guides: Build- und Testbefehle, Konventionen und verbotene Muster in AGENTS.md oder Skills.
- Lass die schnellen Sensors in der Schleife laufen: Type Checker, Linter und die betroffenen Tests nach jeder Änderung.
- Erzwinge das Gate mit Hooks oder CI, nicht mit einem Satz in einem Prompt: volle Suite und statische Analyse vor jedem Commit.
- Verlange Rot/Grün: Der Agent zeigt den fehlschlagenden Lauf vor dem erfolgreichen; bei Bugfixes scheitert der Test, wenn der Fix zurückgenommen wird.
- Füge Mutationstests auf dem Diff hinzu und gib überlebende Mutanten an den Agenten zurück.
- Schütze Akzeptanztests, die einem Menschen gehören; der Agent darf sie ausführen, nicht bearbeiten.
- Lass inferential Reviews beratend bleiben und stimme sie so ab, dass ihre Kommentare lesenswert sind.
- Mache aus jeder menschlichen Korrektur einen Guide oder Sensor, damit derselbe Fehler zweimal nicht ins Review kommt.
Wenn du so einen Harness für ein Team aufsetzt, schau dir AI Engineering an.
Quellen
- Birgitta Böckeler: Harness engineering for coding agent users (April 2026)
- Birgitta Böckeler: Maintainability sensors for coding agents (Mai 2026)
- Simon Willison: Agentic Engineering Patterns
- Simon Willison: First run the tests
- Anthropic: Effective harnesses for long-running agents (November 2025)
- Claude Code-Dokumentation: How Claude remembers your project
- Stryker Mutator-Dokumentation
- Infection: Optionen auf der Kommandozeile
Häufige Fragen
Was ist der Unterschied zwischen einem Guide und einem Sensor im Harness eines Coding-Agenten?
Ein Guide ist Feedforward: Er lenkt den Agenten, bevor dieser handelt, etwa eine AGENTS.md-Datei, ein Skill, Typdefinitionen oder ein Scaffolding-Skript. Ein Sensor ist Feedback: Er prüft das Ergebnis, nachdem der Agent gehandelt hat, etwa Tests, ein Type Checker, ein Linter oder ein KI-Review, und gibt die Befunde zurück, damit der Agent sich selbst korrigieren kann.
Kann ich Tests vertrauen, die ein Coding-Agent geschrieben hat?
Nicht allein anhand der Coverage. Agentengeschriebene Tests können hohe Abdeckung mit schwachen Assertions erreichen. Prüfe sie, indem du den Agenten zuerst einen fehlschlagenden Lauf zeigen lässt, indem du den Fix zurücknimmst und verifizierst, dass der Regressionstest scheitert, und indem du auf den geänderten Zeilen Mutationstests laufen lässt, um zu sehen, ob die Tests kleine, absichtlich eingebaute Bugs fangen.
Wie bringe ich einen Coding-Agenten dazu, vor dem Commit immer die Tests zu starten?
Verlasse dich nicht auf eine Anweisung allein, denn Agenten überspringen Schritte aus Regeln-Dateien gelegentlich. Erzwinge das Gate mit einem Pre-Commit-Hook, einem Agent-Hook, der den Commit-Befehl blockiert, bis die Prüfungen durch sind, oder einem verpflichtenden CI-Check. Lass die Anweisung zusätzlich stehen, damit der Agent die Prüfungen früh startet und Fehler selbst behebt.
Ist Mutationstests für die CI zu langsam?
Auf einer ganzen Codebasis oft, aber das brauchst du nicht bei jedem Pull Request. Werkzeuge wie Infection für PHP können nur die Zeilen mutieren, die ein Branch gegenüber dem Basisbranch geändert hat, das hält den Lauf kurz. Die vollständige Mutationsanalyse läuft stattdessen nach Zeitplan.