Blog/KI-Agenten
KI-Code-Review ist der neue Engpass: Umgang mit einer Flut agentengeschriebener PRs
KI-Code-Review kommt bei agentengeschriebenen PRs nicht hinterher: Daten, Größenbudgets, gestapelte PRs, KI als erster Durchgang, Verantwortlichkeit.
Balázs Csorba··8 Min. Lesezeit
- AI code review
- Pull requests
- Agentic engineering
- Stacked PRs
Das Wichtigste in Kürze
- KI-generierte Pull Requests sind billig herzustellen und teuer zu reviewen; in der Auslieferung ist deshalb das Lesen des Codes der Engpass, nicht sein Schreiben.
- Über 8,1 Millionen Pull Requests sind KI-gestützte im 75. Perzentil mehr als doppelt so groß, warten über 16 Stunden auf Aufnahme und werden nur zu 32,7 % innerhalb von 30 Tagen gemergt.
- Ein PR-Größenbudget, in die Agenten-Regeln geschrieben und in der CI durchgesetzt, ist der wirksamste Hebel, weil Agenten die Arbeit genau so fein aufteilen, wie du es ihnen sagst.
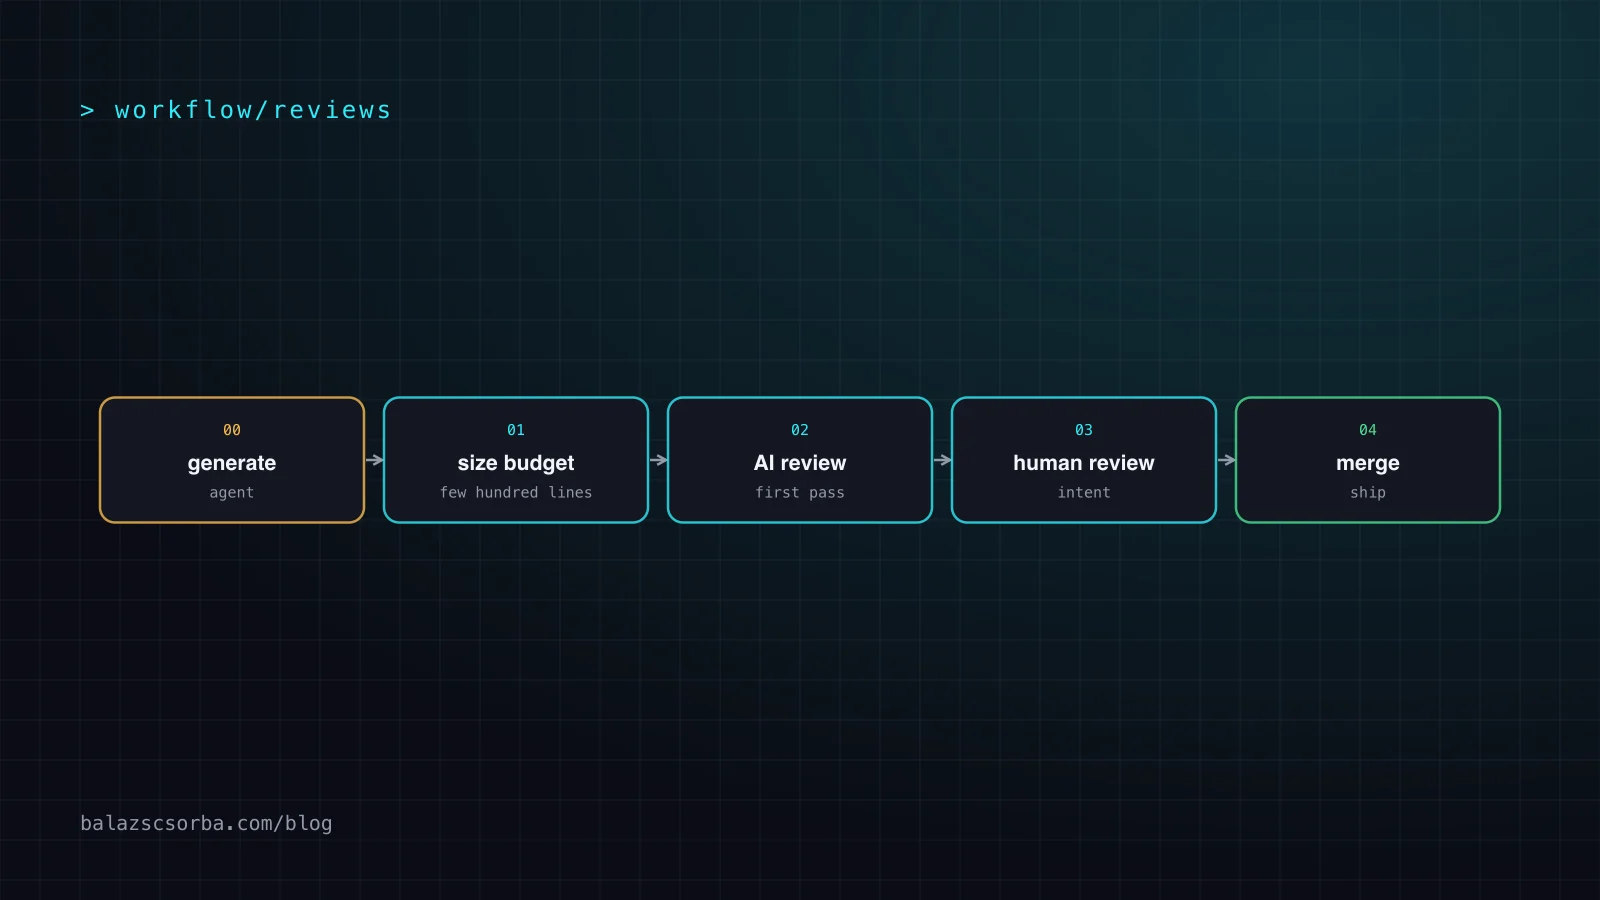
- Lass einen KI-Reviewer und die automatisierten Checks den ersten Durchgang machen, behalte aber menschliche Reviewer für Absicht, Design, Risiko und die Merge-Entscheidung selbst.
- Der Agent, der den Pull Request geöffnet hat, sollte die Review-Kommentare beheben, den Fix belegen und im Thread antworten und nach drei Runden ohne Fortschritt an einen Menschen übergeben.
KI-generierte Pull Requests sind billig herzustellen und teuer zu reviewen, und dieses Ungleichgewicht hat den Engpass in der Softwareentwicklung vom Schreiben des Codes zum Lesen verschoben. Agentengeschriebene PRs sind größer, warten länger auf einen Reviewer und werden seltener gemergt als PRs von Hand. Mehr Agents machen die Queue länger, nicht kürzer.
Dieser Beitrag schaut, was die Daten zeigen, warum das Review zum Engpass wurde und was zu ändern ist: PR-Größenbudgets, gestapelte Pull Requests, KI-Code-Review als erster Durchgang, Agents, die auf ihre eigenen Review-Kommentare antworten, und eine klare Regel für die Verantwortung. Am Ende steht eine Policy-Vorlage, die ein Team übernehmen kann.
Was sagen die Daten über KI-generierte Pull Requests?
Zwei große Datensätze sagen dasselbe: KI-gestützte Pull Requests sind größer, und mehr davon bleiben unreviewt oder werden nie gemergt. Die individuelle Leistung steigt; die Auslieferung auf Teamebene folgt nicht.
LinearBs Analyse von 8,1 Millionen Pull Requests (Mai 2026) über 4.800 Teams in 42 Ländern ist die detaillierteste. Faros AIs AI Productivity Paradox Report (Juli 2025), basierend auf mehr als 10.000 Entwicklern in 1.255 Teams, fand ein Jahr zuvor dieselbe Form.
| Metrik | Ohne KI / Baseline | KI-gestützt oder KI-generiert | Quelle |
|---|---|---|---|
| PR-Größe, 75. Perzentil | 157 Zeilen | über 400 Zeilen (PRs von Agenten rund 290) | LinearB 2026 |
| Innerhalb von 30 Tagen gemergt | rund 84,5 % | 32,7 % | LinearB 2026 |
| Zeit bis zum Beginn des Reviews | rund 200 Minuten | im Schnitt mehr als 16 Stunden | LinearB 2026 |
| Review-Dauer ab Beginn | 252 Minuten | rund 194 Minuten | LinearB 2026 |
| Gemergte PRs pro Entwickler | Baseline | 98 % mehr | Faros 2025 |
| PR-Review-Zeit | Baseline | 91 % länger | Faros 2025 |
| Durchschnittliche PR-Größe | Baseline | 154 % größer | Faros 2025 |
Lies das als Signale, nicht als Gesetze. Beide sind Herstellerstudien über ihre eigenen Kunden, und „AI-assisted“ wird in jeder Studie anders klassifiziert. Ein Detail sticht bei den LinearB-Zahlen heraus: Sobald sich tatsächlich ein Reviewer an einen KI-generierten PR macht, ist das Review nicht langsamer. Explodiert ist die Wartezeit, bevor ihn jemand aufnimmt. Reviewer meiden große, unbekannte Diffs.
Warum das Code-Review zum Engpass wurde
Review ist der Engpass, weil einen Diff zu erzeugen inzwischen Minuten kostet, ihn zu verstehen einen Menschen aber noch immer genauso viel Aufmerksamkeit kostet wie früher. Jede Zeile, die ein Agent schreibt, ist eine Zeile, die jemand lesen muss, und die Lesezeit wächst mit der Größe und mit der Unvertrautheit des Codes.
Googles Engineering Practices setzen die Zielgröße einer Änderung dort an, wo „100 Zeilen meist eine vernünftige Größe für einen CL sind und 1000 Zeilen meist zu groß“, und nennen den Grund in einem Satz: „Es ist für einen Reviewer leichter, mehrere Male fünf Minuten für kleine CLs zu finden, als einen Block von 30 Minuten für einen großen CL freizuhalten.“ Ein Agent, der in zehn Minuten einen 600-zeiligen PR produziert, hat gerade einen 30-Minuten-Block im Tag eines anderen eingeplant.
PR-Größenbudgets und gestapelte Pull Requests
Die wirksamste Gegenmaßnahme ist, Agents kleinere Pull Requests produzieren zu lassen und sie zu stapeln, wenn eine Änderung für einen einzelnen zu groß ist. Die Größe ist die eine Variable, die du vollständig kontrollierst, denn der Agent teilt die Arbeit genau so fein, wie du es ihm sagst.
Ein Größenbudget ist eine Zeile in den Agenten-Regeln plus ein CI-Check: Beispielsweise jeden PR oberhalb einiger hundert geänderter Zeilen fehlschlagen lassen oder labeln, mit Ausnahme von Lockfiles und generiertem Code. Googles Leitfaden listet die Aufteilungsstrategien auf, die funktionieren: abhängige Änderungen stapeln, nach Dateien aufteilen, die verschiedene Reviewer brauchen, horizontal nach Schicht oder vertikal nach Feature aufteilen und Refactorings „in einem separaten CL von Feature-Änderungen oder Bugfixes“ halten.
Gestapelte Pull Requests machen das praktisch. GitHub hat gestapelte PRs am 30. Juli 2026 in die öffentliche Vorschau gebracht: „eine geordnete Reihe von Pull Requests, die jeweils fokussierte Schichten deiner Änderung darstellen“, wobei jeder PR auf den darunter liegenden zielt. Reviewer sehen eine Stack-Karte und reviewen immer den Diff einer Schicht. Ein Merge des obersten fertigen PRs holt ihn und jede darunterliegende, noch nicht gemergte Schicht in einem Vorgang; ein Merge einer tieferen Schicht lässt die oberen offen und rebased sie automatisch. Die CLI kommt als Erweiterung, und GitHub erwähnt einen gh-stack-Skill für Coding-Agenten:
gh extension install github/gh-stackFür Agents ändert Stacking die Anweisung von „implementiere das Feature“ zu „implementiere das Feature als Stack: zuerst das Schema, dann der Service, dann die UI, je ein PR, jeder für sich grün“. Das ist leichter zu reviewen und leichter zurückzunehmen.
KI-Review als erster Durchgang, Menschen für die Absicht
Lass einen KI-Reviewer und die deterministischen Checks den ersten Durchgang machen, damit der menschliche Reviewer seine Aufmerksamkeit nur für Absicht, Design und Risiko braucht. Lass den KI-Durchgang den menschlichen nicht ersetzen.
Die Werkzeuge unterstützen beide Verwendungen, die Entscheidung liegt also bei dir. GitHubs Copilot code review docs sagen, dass Reviews über Rulesets automatisch ausgelöst werden können, dass Copilots Approval-Bewertung standardmäßig nicht auf die erforderlichen Approvals angerechnet wird und dass Copilot bei aktivierten „Copilot approvals“ „eine genehmigende Review einreichen kann, die die Required-Approval-Regel deines Repositories erfüllt“. Dieselbe Seite warnt: „Copilot ist nicht garantiert, alle Probleme oder Fehler in einem Pull Request zu finden.“ Meine Empfehlung: Lass KI-Approvals für alles aus, was in Produktion geht.
Der erste Durchgang funktioniert am besten, wenn er geschichtet ist: zuerst deterministische Sensoren (Tests, Typen, Linter, Mutationstests auf dem Diff, wie in Harness Engineering beschrieben), dann ein KI-Review für semantische Probleme, dann der Mensch. Wenn ein Mensch den PR öffnet, sollten die offenen Fragen „ist das die richtige Änderung?“ und „was könnte das brechen?“ sein, nicht „hast du die Tests gelaufen?“.
Die Schleife schließen: Agents, die auf Review-Kommentare antworten
Wenn ein Mensch doch kommentiert, sollte der Agent, der den PR geschrieben hat, die Folgearbeit machen: jeden Kommentar beheben, den Fix belegen und im Thread antworten. Der zweite Durchgang des Reviewers dauert dann Minuten.
Mein Review-Schleifen-Skill funktioniert so. Er sammelt alle Review-Kommentare des PRs über die GitHub API ein, behebt sie und markiert jeden Thread als behoben, teilweise, offen oder nicht zutreffend. Er lässt Tests und statische Analyse erneut laufen und wiederholt das. Nach drei Runden ohne Fortschritt hört er auf und übergibt an mich, weil ein vierter Versuch beim selben Kommentar selten besser wird. Am Ende antwortet er auf jeden Thread und nennt den Commit, der ihn erledigt hat, damit der Reviewer jede Antwort gegen einen konkreten Diff prüfen kann. Der Skill ist ausführlicher in meinem Beitrag über den Workflow meiner Coding-Agent-Skills beschrieben, und die Abbruchlogik ist ein allgemeines Muster, das in der erklärten Agentenschleife behandelt wird.
Wenn der erste KI-Durchgang viele Findings produziert, triagiere sie, bevor der Agent mit dem Beheben anfängt. Ein typisierter Classifier, der jedes Finding als „jetzt beheben“, „Backlog“ oder „braucht einen Menschen“ labelt, ist billiger und konsistenter, als ein allgemeines Modell zu fragen, „was ist wichtig“; dieser Ansatz ist in typisierten Entscheidungen für Routing und Triage beschrieben.
Abwägung: was diese Regeln kosten
Jede Regel hier kauft Review-Geschwindigkeit mit etwas anderem, und manche Teams sollten nicht alle einführen. Kenne den Preis, bevor du die Policy schreibst.
- Größenbudgets kosten Overhead. Mehr PRs bedeuten mehr CI-Läufe und mehr Kontextwechsel. Für eine einmalige Migration, die ein Codemod erzeugt, ist ein großer PR mit klarer Beschreibung leichter zu reviewen als zwanzig kleine.
- Stacks brauchen Tool-Disziplin. Ein Stack, den niemand rebased, verfällt schnell. GitHubs gestapelte PRs sind Stand September 2026 in öffentlicher Vorschau, prüfe also, was deine Merge-Queue unterstützt, bevor du dich darauf verlässt.
- KI-Review erzeugt Rauschen. Ein Reviewer-Bot mit vielen geringwertigen Kommentaren bringt die Leute dazu, ihn zu ignorieren. Stimme seine Anweisungen so ab, dass die meisten Kommentare zu einer Änderung führen, oder schalte ihn ab.
- Menschliches Review skaliert nicht linear. Wenn Agenten die Leistung verdreifachen, verdreifachen Reviewer nicht. Irgendwann lautet die richtige Antwort: weniger PRs. Erzeuge weniger und gib Agenten-Zeit stattdessen für Tests und Aufräumen aus, nicht für neue Features.
Eine Team-Policy für agentengeschriebene Pull Requests
Eine schriftliche Policy nimmt beiden Seiten das Rätselraten: den Reviewern und den Agents. Packe sie in den Contribution Guide und in die Regeldateien der Agents, damit dieselben Regeln gelten, wer oder was den PR auch öffnet.
- Ein benannter Mensch besitzt jeden PR. Wer den Agenten um die Änderung gebeten hat, ist dafür verantwortlich, reviewt ihn zuerst und steht nach dem Merge dafür ein.
- Größenbudget: PRs über der vereinbarten Zeilenzahl werden aufgeteilt oder gestapelt; Refactorings kommen in einen eigenen PR.
- Nachweise in der Beschreibung: was gelaufen wurde, mit exakten Ergebnissen, und was nicht gelaufen wurde und warum.
- Zuerst das deterministische Gate: Tests, Typen, Linter und Mutationstests auf dem Diff müssen grün sein, bevor das Review angefordert wird.
- KI-Review ist beratend. Es kommentiert; es liefert keine erforderliche Freigabe.
- Der Agent beantwortet seine Kommentare, mit einem Commit pro Thread, und stoppt nach drei Runden ohne Fortschritt.
- Menschen geben alles Öffentliche oder Unumkehrbare frei: Merges in Produktions-Branches, Migrationen, Deployments.
Die PR-Vorlage, die meine Agents ausfüllen, hat fünf feste Abschnitte:
## Ticket
Link to the issue. No ticket, no PR.

## Description
What changed and why, in two or three sentences.

## Testing
Commands run and exact results. Anything not run, and why.

## How to test
Steps a reviewer can follow to see the change working.

## Deployment notes
Migrations, config, feature flags, rollback. "None" if none.
Wenn du herausfindest, wie Coding-Agenten in den Review-Prozess deines Teams passen, schau dir AI Engineering an.
Quellen
Häufige Fragen
Wie groß sind KI-generierte Pull Requests im Vergleich zu handgeschriebenen?
LinearBs Analyse von 8,1 Millionen Pull Requests setzt das 75. Perzentil für Arbeit ohne KI bei 157 geänderten Zeilen und für KI-gestützte Arbeit bei über 400 Zeilen an, agentische Pull Requests liegen im Schnitt bei rund 290 Zeilen. Googles Engineering Practices halten 100 geänderte Zeilen für eine vernünftige Größe und 1000 Zeilen für klar zu groß, ein typischer agentengeschriebener Pull Request überschreitet also bereits das, was ein Reviewer auf einmal im Kopf behalten soll.
Warum ist das Code-Review bei agentengeschriebenen Pull Requests der Engpass?
Einen Diff zu erzeugen dauert inzwischen Minuten, ihn zu verstehen kostet einen Menschen aber noch immer genauso viel Aufmerksamkeit wie früher. LinearB hat für PRs ohne KI eine Wartezeit von rund 200 Minuten bis zur Aufnahme gemessen, für KI-gestützte PRs mehr als 16 Stunden, und 32,7 % der KI-gestützten Pull Requests wurden innerhalb von 30 Tagen gemergt, bei den anderen 84,5 %. Das Review-Tempo setzt den Takt, nicht das Generieren.
Soll KI-Code-Review den menschlichen Reviewer ersetzen?
Nein. Lass einen KI-Reviewer und die automatisierten Checks den ersten Durchgang machen, damit die menschliche Aufmerksamkeit für Absicht, Design und Risiko frei wird, und lass einen Menschen für den Merge verantwortlich bleiben. Copilot code review zählt bei GitHub standardmäßig nicht zu den erforderlichen Approvals, und genau das ist das gewünschte Verhalten: Der erste Durchgang ist billig und breit, die Entscheidung bleibt menschlich.
Was ist die beste Gegenmaßnahme gegen eine Flut von KI-Pull Requests?
Kürze sie. Ein Budget in den Agenten-Regeln, durchgesetzt in der CI, etwa ein paar hundert geänderte Zeilen ohne Lockfiles und generierten Code, zwingt den Agenten zum Aufteilen. Ist eine Änderung wirklich zu groß für einen Pull Request, stape sie stattdessen: GitHub hat die stacked pull requests im Juli 2026 in die öffentliche Vorschau gebracht, mit einer gh-Erweiterung für die Kommandozeile.
Wie soll ein Agent auf Review-Kommentare zu einem Pull Request antworten?
Der Agent, der den Pull Request geöffnet hat, sollte alle Review-Kommentare über die GitHub API einsammeln, sie beheben, jeden Thread als behoben, teilweise, offen oder nicht zutreffend markieren, die Tests erneut laufen lassen und im Thread mit Nennung des Commits antworten. Mein Review-Schleifen-Skill wiederholt das und stoppt nach drei Runden ohne Fortschritt, dann übergibt er den Pull Request an einen Menschen, statt eine vierte Variante desselben Fixes zu versuchen.