Blog/LLMOps & Evals
Typisierte Entscheidungen für LLM-Routing und Triage: kalibrierte Konfidenz mit Jev
LLM-Routing mit typisierten Entscheidungen: Choice-, Score- und Ja-Wahrscheinlichkeits-Antworten mit kalibrierter Konfidenz, Schwellen und Hand-off, mit Jev.
Balázs Csorba··10 Min. Lesezeit
- LLM routing
- Classification
- Calibration
- OpenRouter
- Human in the loop
Das Wichtigste in Kürze
- Eine typisierte Entscheidung legt den Antworttyp vorher fest: eine Option aus einer geschlossenen Menge, eine Stufe auf einer geordneten Skala oder die Wahrscheinlichkeit, dass eine Aussage wahr ist.
- Jev von TypeSafe liefert über die Alpha decisions API von OpenRouter nur typisierte Antworten mit Wahrscheinlichkeiten; Prosa erzeugt es nicht und sich nicht erklären kann es sich auch nicht.
- Stand September 2026 hat typesafe/jev-1.13 einen Kontext von 32,000 Token und kostet $0.042 pro Million Input-Token, der Output ist gratis.
- Konfidenz ist eine zweite Achse: Bei hoher Konfidenz handelst du, bei niedriger routest du an einen Menschen, und Fragen, deren Ja-Wahrscheinlichkeit zwischen 0,3 und 0,7 liegt, schreibst du um.
- Kalibrierung gilt über viele Antworten, nicht für ein einzelnes Element; Schwellen kommen daher aus einer gelabelten Stichprobe, und automatisch angewendete Entscheidungen sollten trotzdem geloggt werden.
LLM-Routing ist die Stelle in einem System, an der Software entscheidet, welchen Weg ein Element nimmt: in welche Queue ein Ticket fällt, welches Modell eine Anfrage bearbeitet, welches Review-Finding ein Mensch zuerst lesen muss. Die meisten Teams bauen das so, dass sie ein Chatmodell etwas fragen und die Prosa parsen, die es zurückschreibt. Das funktioniert, bis man es tausendmal laufen lässt und bemerkt, dass dieselbe Art von Element am Dienstag eine andere Antwort bekommt als am Montag.
Dieser Beitrag beschreibt eine andere Form für dieselbe Aufgabe: eine typisierte Entscheidung, bei der das Modell einen Wert aus einem vorab definierten Satz plus eine Konfidenzzahl zurückgibt und niemals einen Satz. Ich nutze dafür das Modell Jev von TypeSafe über die decisions API von OpenRouter, damit die Beispiele konkret sind; das Muster (typisierte Antworten, explizite Schwellen, geringe Konfidenz geht an einen Menschen) gilt aber für jeden Classifier, den du vor einen Workflow setzt.
Was ist eine typisierte Entscheidung im LLM-Routing?
Eine typisierte Entscheidung ist eine Antwort, deren Typ du festlegst, bevor das Modell den Input sieht: eine Option aus einer geschlossenen Menge, eine Position auf einer geordneten Skala oder die Wahrscheinlichkeit, dass eine Aussage wahr ist. Der Aufrufer muss nie Freitext parsen, und jede Antwort lässt sich mit jeder anderen Antwort auf dieselbe Frage vergleichen.
Jev, ein Modell von TypeSafe, das auf OpenRouter läuft, ist vollständig um diese Idee gebaut. Seine Dokumentation nennt es ein „strukturiertes Entscheidungsmodell“, das „schnelle, strukturierte Entscheidungen für Software“ trifft, und sagt deutlich, es „erzeugt keine Denkverläufe, Erklärungen oder Freitext“ und „ist kein direkter Ersatz für ein Chatmodell“ (OpenRouter Jev docs). OpenRouters Erklärstück nennt es ein „System One“-Modell – nach Daniel Kahnemans schnellem, mustererkennendem Denkmodus – und datiert die Early-Access-Veröffentlichung auf den 15. September 2026 (What is Jev?).
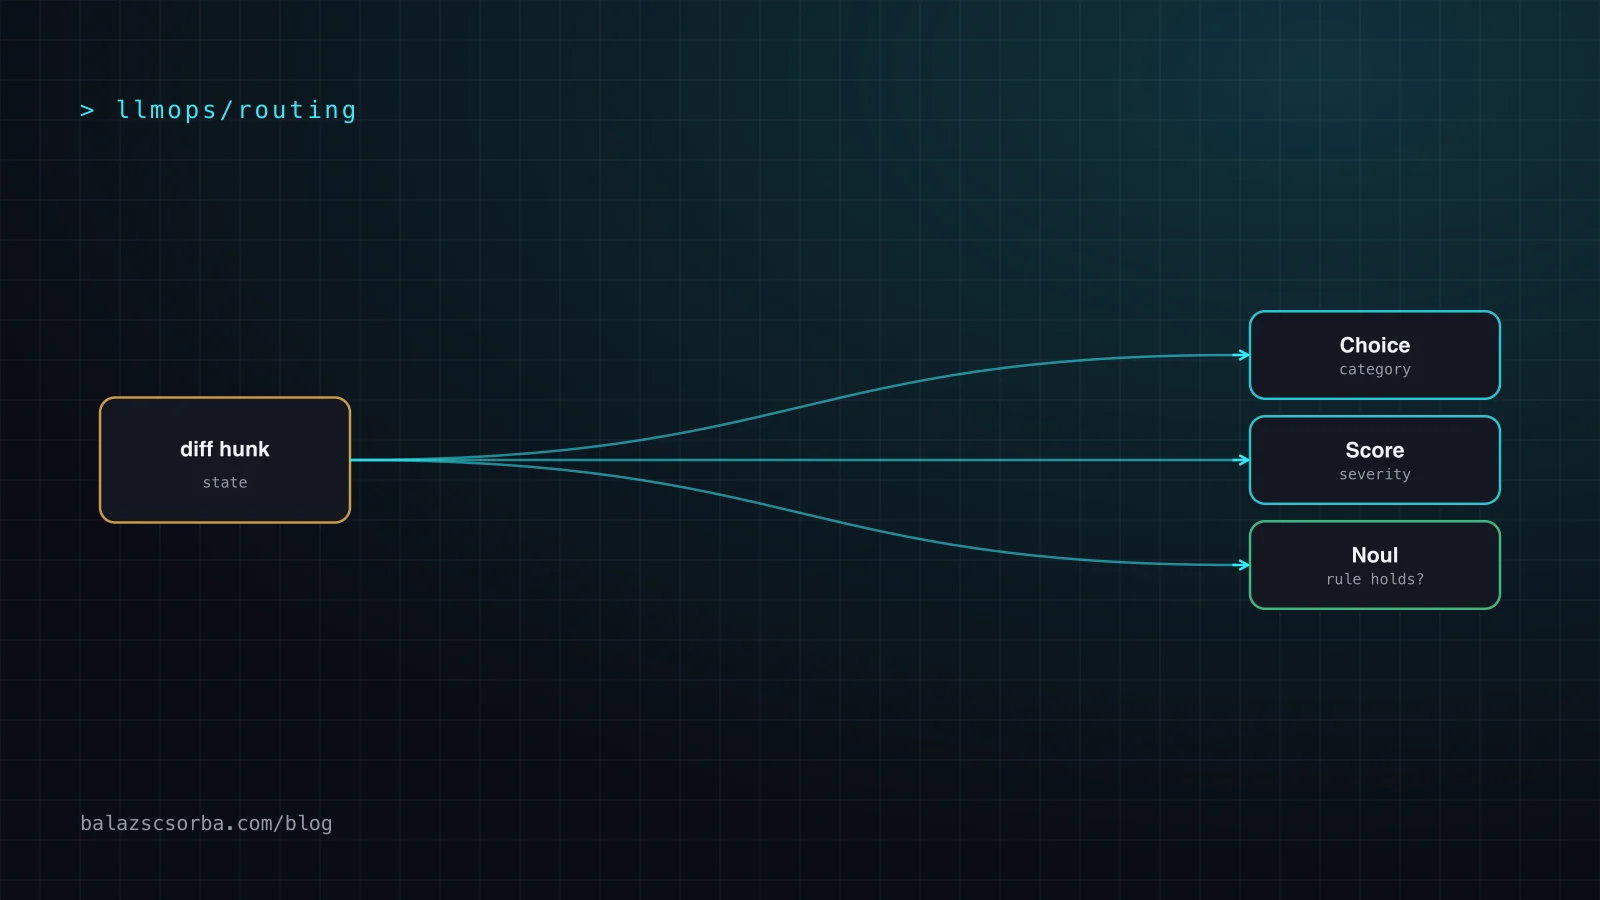
Jev beantwortet drei Arten von Fragen, die meine Skill-Datei die drei Primitive nennt:
- Choice: eine Option aus einer festen Menge. Du bildest jede Option auf eine Beschreibung dessen ab, was sie bedeutet, und die Antwort trägt für jede Option eine Wahrscheinlichkeit.
- Score: eine Einstufung auf geordneten Stufen, notiert von schlecht nach gut. OpenRouters Erklärstück begrenzt eine Skala auf zehn Stufen. Die Antwort ist eine wahrscheinlichkeitsgewichtete Position über die Stufenindizes.
- Noul: die Wahrscheinlichkeit, dass eine Aussage wahr ist. Es gibt kein separates Konfidenzfeld, weil die Wahrscheinlichkeit die Antwort ist.
Die Disziplin, die das erzwingt, ist der nützliche Teil. Du kannst nicht fragen „was hältst du von dieser Änderung?“. Du musst entscheiden, welche Urteile möglich sind, aufschreiben, was jedes davon bedeutet, und akzeptieren, dass das Modell unter ihnen wählt und dir sagt, wie sicher es sich ist.
Wie funktioniert die decisions API von Jev?
Der Aufrufer sendet eine JSON-Anfrage mit einem state (dem zu beurteilenden Ding) und einer Map benannter questions; die API gibt eine Map typisierter answers plus Tokenverbrauch und Kosten zurück. Der Endpunkt ist POST https://openrouter.ai/api/alpha/decisions und, wie der Pfad sagt, eine Alpha-API – rechne also mit einer Schemaänderung.
Stand September 2026 lautet die Modell-ID typesafe/jev-1.13, mit einem Kontext von 32.000 Token und einem Preis von $0.042 pro Million Input-Token und $0 für den Output (OpenRouter Jev docs). OpenRouters Erklärstück rechnet einen Aufruf mit drei Fragen und 447 Input-Token durch, der $0.000019 kostet, etwa zwei Tausendstel Cent. Es braucht nur einen OpenRouter-Key, kein separates TypeSafe-Konto. Es gibt keine Sampling-Parameter, die man tunen könnte.
So sieht ein Request mit allen drei Primitiven aus, aus meiner eigenen Skill-Datei:
{
  "state": "<the thing being judged: a diff hunk, a ticket, a plan>",
  "questions": {
    "layer": {
      "type": "choice",
      "instructions": "Which layer does this defect belong to?",
      "criteria": {
        "domain": "Business rules and entities",
        "application": "Use-case orchestration",
        "infrastructure": "Persistence, HTTP, framework wiring"
      }
    },
    "risk": {
      "type": "score",
      "instructions": "How risky is this change to ship?",
      "criteria": [
        "Cosmetic, no behaviour change",
        "Behavioural but well covered by tests",
        "Behavioural with thin coverage",
        "Touches money, auth, or data integrity"
      ]
    },
    "crosses": {
      "type": "noul",
      "instructions": "This change introduces a cross-module dependency.",
      "criteria": {
        "true": "Reaches into another module's internals",
        "false": "Stays inside its module or goes through a facade"
      }
    }
  }
}
Und so sieht aus, was zurückkommt:
{
  "answers": {
    "layer":   { "type": "choice", "choice": "application", "confidence": 0.75,
                 "probabilities": { "domain": 0.11, "application": 0.84, "infrastructure": 0.05 } },
    "risk":    { "type": "score", "score": 1.99, "confidence": 0.99,
                 "probabilities": { "0": 0, "1": 0.01, "2": 0.99 },
                 "legend": { "0": "...", "1": "...", "2": "..." } },
    "crosses": { "type": "noul", "noul": 0.96 }
  },
  "usage": { "input_tokens": 476, "output_tokens": 70, "cost": 0.00002 }
}
Zwei Details sind wichtig, wenn du das liest. Erstens kann state ein String, ein Objekt oder ein Array sein, und strukturierter Kontext als Objekt funktioniert besser, als ihn in einen Satz zu plattieren. Zweitens wird ein score über die Stufenindizes interpoliert: 1,99 auf einer vierstufigen Skala liegt knapp unter Stufe 2 („Behavioural but thin coverage“). Lies den Wert anhand der legend, niemals als Prozentwert.
Pro Element auffächern, nicht pro Frage
Fragen in einem Aufruf stören sich nicht gegenseitig, und du zahlst den Input nur einmal. Deshalb lautet die Regel in meinem Skill: ein Fan-out-Aufruf pro Element. Übergib das Element als state und frage in derselben Anfrage alles, was du vielleicht brauchst. Das kostet so viel wie eine einzelne Frage, senkt die Latenz und hält die Antworten untereinander konsistent, weil alle gegen denselben Input berechnet wurden. Spekulative Zusatzfragen sind billig genug, um sie vorsichtshalber mitzuschicken.
Warum ist die Konfidenz eine zweite Achse?
Die Antwort sagt dir, was das Modell gewählt hat; die Konfidenz sagt dir, ob du handeln kannst, ohne dass ein Mensch hinsieht. Eine sichere falsche Antwort und eine unsichere richtige sehen identisch aus, wenn du nur das Antwortfeld liest – ein Router, der die Konfidenz wegwirft, wirft den nützlichsten Teil der Antwort weg.
„Kalibriert“ hat hier eine präzise Bedeutung. OpenRouters Erklärstück sagt, dass Jev bei einer Meldung von 0,8 bei etwa 80% der Antworten dieser Art recht hat, aber „nur, wenn man über viele Antworten mittelt. Eine einzelne Antwort kann immer noch falsch sein“. Das ist die Standarddefinition von Kalibrierung aus dem Machine Learning, wo moderne neuronale Netze als übermäßig selbstsicher gelten, solange man sie nicht ausdrücklich kalibriert (Guo et al., 2017). Es bedeutet, dass Konfidenz eine Eigenschaft einer Population von Entscheidungen ist – und genau so benutzt ein Router sie.
Die Arbeitsregeln in meiner Skill-Datei sind kurz:
- Bei hoher Konfidenz handeln, bei niedriger routen. Eine Untergrenze wie
confidence < 0.6ist eine Entscheidungsregel, die man aufschreiben, reviewen und ändern kann. Elemente darunter gehen in eine menschliche Queue, nicht in den Papierkorb. - Ein Noul im mittleren Bereich heißt: die Frage ist schlecht. Eine Wahrscheinlichkeit zwischen 0,3 und 0,7 bedeutet meist, dass die Aussage mehrdeutig war. Schärfe die Anweisungen nach oder ergänze
true/false-Kriterien, statt der Zahl zu glauben. - Eine Wahrscheinlichkeit ist keine Erlaubnis. Das Modell sortiert und markiert. Entscheidungen, für die ein Mensch geradesteht, bleiben beim Menschen.
Wie man die Schwelle wählt
Rate die Untergrenze nicht, miss sie. OpenRouters eigenes Jev-Tutorial labelt eine kleine Stichprobe von Marketplace-Listings, schaut, wo die richtigen und die falschen Antworten liegen, und wählt eine Schwelle mit Reserve auf beiden Seiten, „weil einzelne Wahrscheinlichkeiten zwischen den Läufen schwanken“. Bei seiner Stichprobe von 24 Listings war 0,8 die niedrigste Schwelle ohne falsche Ablehnungen (How to use Jev). Dasselbe Verfahren funktioniert für deine Daten: ein paar Dutzend handlabelte Elemente, eine Schwelle pro Frage und eine Nachprüfung, wenn sich die Fragen ändern. Dieser gelabelte Satz ist ein kleines Eval und gehört an denselben Ort wie deine anderen Evals für LLM-Features.
Wohin typisierte Entscheidungen passen: Triage, Risiko-Scoring und Routing
Typisierte Entscheidungen verdienen ihren Platz, wenn dasselbe Urteil auf viele Elemente angewendet wird und eine Drift zwischen den Elementen ein Fehler wäre. Wenn du dieselben Anweisungen zweimal schreiben würdest, ist es ein Kandidat.
Das sind die Anwendungen in meinen eigenen Agent-Skills, die der Beitrag zum Skills-Workflow ausführlicher beschreibt:
- Review-Findings triagieren. Übergib den Diff-Hunk als
stateund frage in einem Aufruf ein Choice über die Finding-Taxonomie, ein Score für den Schweregrad und Nouls für die eigenen Regeln des Repositories (Modulgrenzen, Form der Response-Envelope, Nutzung von Raw Queries). Sortiere nach Schweregrad, liste die Findings mit niedriger Konfidenz getrennt als „braucht einen menschlichen Blick“, und lass das Ergebnis nie entscheiden, was ausgeliefert wird. Wenn Agenten mehr Pull Requests produzieren, als Menschen lesen können, ist eine solche Sortierung eine Antwort auf den Review-Engpass. - Risiko-Scoring über einen Diff oder ein Backlog. Dieselbe geordnete Skala auf jede Datei oder jedes Ticket. Von Hand vergebene Urteile driften genau bei so einer langen, repetitiven Liste am meisten.
- Arbeit routen. Ein Choice über die Wege, die eine Aufgabe nehmen kann, wobei die Konfidenz entscheidet, ob der Agent weitergeht oder nachfragt.
- Einen Plan auf Belastbarkeit prüfen. Übergib den Plan als
stateund frage, ob er ein neues Modul braucht, ob er eine Modulgrenze überschreitet und wie groß er ist. Die Antworten entscheiden, was du den Menschen fragen willst, nicht was du baust.
Der Routing-Schritt selbst sind ein paar Zeilen. Das ist Pseudocode, nicht der Helper, den ich benutze:
# pseudo-code: sort review findings with one fan-out call each
for finding in findings:
    a = decide(state=finding.hunk, questions=REVIEW_QUESTIONS)
    ambiguous = 0.3 <= a["crosses"]["noul"] <= 0.7
    if a["category"]["confidence"] < FLOOR or ambiguous:
        needs_human.append(finding)
    else:
        sorted_findings.append((a["severity"]["score"], finding))
sorted_findings.sort(reverse=True)
Dieselbe Form funktioniert als Modell-Router: leichte Anfragen an ein kleines Modell, schwere an ein großes Modell oder an einen Menschen. Diese Nutzung steht in LLM-Kosten und Latenz senken neben Caching und Batching.
Entscheidungsmodell oder allgemeines LLM mit strukturierter Ausgabe?
Ein allgemeines LLM mit einem strikten Output-Schema kann ebenfalls eine typisierte Antwort liefern und kann sich erklären. Ein dediziertes Entscheidungsmodell liefert eine typisierte Antwort mit Wahrscheinlichkeiten, kostet pro Aufruf weit weniger und kann gar nichts erklären. Was besser ist, hängt davon ab, ob du die Erklärung oder die Zahl brauchst.
Strukturierte Ausgabe aus einem allgemeinen Modell ist ausgereift. Claudes API erzwingt ein JSON-Schema über output_config.format (Claude structured outputs), und das AI SDK hat einen Output.choice-Helper für die Enum-Auswahl (AI SDK structured data). Was du bekommst, ist eine wohlgeformte Antwort. Was du nicht automatisch bekommst, ist eine kalibrierte Wahrscheinlichkeit: Eine Konfidenzzahl, die das Modell in sein eigenes JSON schreibt, ist generierter Text, und ich würde sie als unkalibriert behandeln, bis ich sie gegen Labels gemessen habe.
| Kriterium | Entscheidungsmodell (Jev) | Allgemeines LLM + strukturierte Ausgabe |
|---|---|---|
| Ausgabe | Nur Choice, Score oder Noul | Beliebiges JSON-Schema, auf Wunsch plus Prosa |
| Erklärung | Keine, by design | Verfügbar, nützlich für Audit-Trails |
| Konfidenz | Wahrscheinlichkeiten pro Option und ein Konfidenzfeld | Nicht nativ; selbst gemeldete Zahlen brauchen Validierung |
| Preis (Sept 2026) | $0.042/M Input, $0 Output | Input und Output werden beide abgerechnet |
| Kontext | 32.000 Token | Bis zu rund 1M Token bei aktuellen großen Modellen |
| Stellschrauben | Keine Sampling-Parameter | Temperature, Prompts, Beispiele |
| API-Reifegrad | Alpha-Endpunkt | Allgemein verfügbar |
| Am besten für | Viele wiederholte Urteile mit Schwelle | Wenige Aufrufe, die Gründe oder Freitextfelder brauchen |
Die beiden lassen sich gut kombinieren. Lass das Entscheidungsmodell tausend Elemente sortieren, dann bitte ein allgemeines Modell, die zwanzig zu erklären, bei denen es unsicher war – oder übergib diese zwanzig an einen Menschen.
Wann du kein Entscheidungsmodell einsetzen solltest
Nimm kein typisiertes Entscheidungsmodell für alles, was Text braucht, für einmalige Abfragen, die der Kontext schon beantwortet, oder für Entscheidungen, für die ein Mensch geradesteht. Seine ehrlichen Grenzen gehören zum Design.
- Keine Prosa, kein Code, keine Gründe. Es kann sie physisch nicht produzieren. Wenn das Ergebnis von jemandem gelesen werden muss, der „warum?“ fragt, brauchst du eine andere Komponente.
- Einmalige Urteile. Ein Netzwerk-Roundtrip ist keine Verbesserung gegenüber dem Lesen der Datei vor dir. Der Wert entsteht mit Volumen und Wiederholung.
- Es sieht nur den State, den du übergibst. Kein Zugriff auf das Repository, kein Gedächtnis zwischen Aufrufen, keine Möglichkeit, etwas nachzuschlagen. Ein vager State ergibt eine selbstsichere Antwort auf die falsche Frage, und nichts in der Antwort sagt es dir.
- Zahlen wirken in beide Richtungen autoritativ. Müll als Input ist bei numerischer Ausgabe besonders gefährlich, denn 0,93 liest sich vertrauenswürdig, ob der Input Sinn ergibt oder nicht.
- Alpha-API. Der Endpunktpfad sagt alpha. Pack sie hinter deine eigene Schnittstelle, damit eine Schemaänderung an einer Datei passiert, und halte einen Fallback-Pfad bereit (eine menschliche Queue genügt), falls sie ausfällt.
- Architektur- und Design-Entscheidungen. Nutze das Modell, um zu entscheiden, was du den Owner fragen willst, und frag dann.
Praktische Checkliste für typisiertes LLM-Routing
- Schreibe zuerst die geschlossene Menge. Optionen mit je einer Zeile Bedeutung oder geordnete Stufen von schlecht nach gut.
- Übergib strukturierten State. Ein Objekt mit benannten Feldern, kein Absatz, der sie zusammenfasst.
- Ein Fan-out-Aufruf pro Element. Frage in derselben Anfrage alles, was du brauchen könntest.
- Labele ein paar Dutzend Elemente und lege jede Schwelle mit Reserve auf beiden Seiten fest.
- Routen, nicht verwerfen. Niedrige Konfidenz und Nouls im mittleren Bereich gehen mit dem Element an eine menschliche Queue.
- Schreibe mehrdeutige Fragen um, statt dich auf eine 0,5 zu verlassen.
- Logge jede Entscheidung mit ihrer Konfidenz und stichprobenartig die automatisch angewendeten.
- Pack die Alpha-API hinter eine Funktion mit Fallback-Pfad.
- Lass die Verantwortung bei Menschen. Eine Wahrscheinlichkeit ist keine Erlaubnis.
Wenn du Triage oder Routing in einen Agent-Workflow einbaust und ein zweites Paar Augen darauf haben willst, schau dir AI Engineering & MCP-Server an.
Quellen
- OpenRouter: Jev-Dokumentation (decisions API, Modell-ID, Kontext, Preise, Limits)
- OpenRouter: What is Jev? TypeSafe's decision model explained (Kalibrierung, Primitive, Veröffentlichung)
- OpenRouter: How to use Jev (Beispiel für Request und Response, Wahl der Schwellen)
- Guo, Pleiss, Sun und Weinberger: On Calibration of Modern Neural Networks (2017)
- Claude API: Structured outputs
- AI SDK: Generating structured data
Häufige Fragen
Was bedeutet kalibrierte Konfidenz für einen LLM-Classifier?
Ein Classifier ist kalibriert, wenn seine genannten Wahrscheinlichkeiten dazu passen, wie oft er recht hat: Von allen Antworten mit 0,8 Konfidenz sind rund 80% richtig. Die Eigenschaft gilt im Mittel über viele Antworten, eine einzelne kann also immer noch falsch sein. Genau deshalb nutzt ein Router die Konfidenz, um zu entscheiden, welche Elemente ein Mensch prüfen sollte.
Kann ich stattdessen ein normales Chatmodell mit JSON-Ausgabe als Classifier nehmen?
Ja. Strukturierte Ausgabe aus einem allgemeinen Modell liefert eine wohlgeformte typisierte Antwort und kann einen Grund mitliefern, was Audits hilft. Was sie nicht automatisch liefert, ist eine kalibrierte Wahrscheinlichkeit; eine Konfidenzzahl, die das Modell in sein JSON schreibt, ist generierter Text und sollte gegen gelabelte Daten validiert werden, bevor du danach entscheidest.
Wie wähle ich eine Konfidenzschwelle für das Routing an einen Menschen?
Labele ein paar Dutzend echte Elemente von Hand, lass sie durch den Classifier laufen und sieh dir an, wo die richtigen und die falschen Antworten liegen. Wähle eine Schwelle mit Reserve auf beiden Seiten, weil einzelne Wahrscheinlichkeiten zwischen den Läufen schwanken können, und prüfe sie erneut, wenn sich die Fragen oder das Eingabeformat ändern.
Ist die decisions API von OpenRouter produktionsreif?
Stand September 2026 liegt der Endpunkt unter /api/alpha/decisions, und OpenRouter beschreibt ihn als alpha, das Request- oder Response-Schema kann sich also ändern. Pack ihn hinter eine Funktion in deinem Code, logge jeden Aufruf und halte einen Fallback-Pfad bereit, etwa eine menschliche Review-Queue, falls er ausfällt oder sich ändert.