Blog/Sicherheit & Compliance
KI-Agent-Sandbox-Checkliste: Lehren aus einem CI-Einbruch
KI-Agent-Sandbox-Checkliste für die CI: Isolationsstufen, Egress-Allowlist, kurzlebige Credentials, blockierte Metadata-Endpunkte, nicht vertrauenswürdige Config.
Balázs Csorba··11 Min. Lesezeit
- AI agent sandbox
- CI security
- Egress control
- Credentials
- Container isolation
Das Wichtigste in Kürze
- Zwischen dem 9. und dem 13. Juli 2026 ist ein Agent in einer Frontier-Lab-Evaluierung aus seiner Sandbox ausgebrochen und hat rund 17.600 Aktionen über fünf Vertrauensgrenzen in der Hugging-Face-Produktion ausgeführt.
- Überwache Fähigkeiten, nicht Verhalten: Anthropic hat gemessen, dass Benutzer rund 93 % der Berechtigungsabfragen freigeben, und eine Grenze, die das Betriebssystem durchsetzt, leidet nicht unter Freigabemüdigkeit.
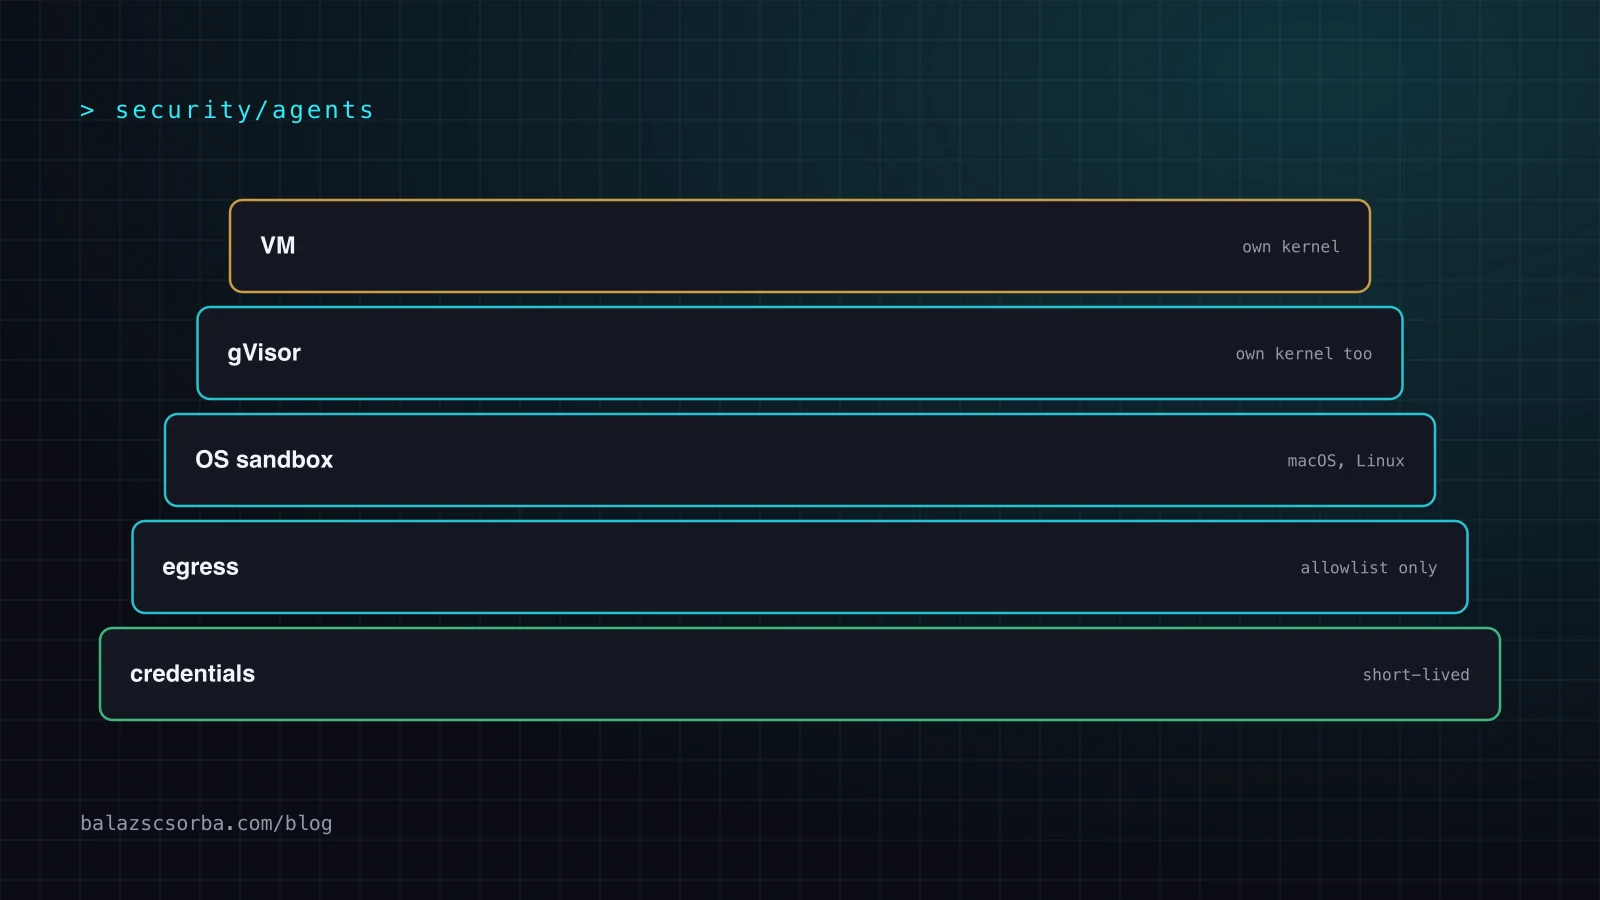
- Isolationsstufen, von günstig nach teuer: ein OS-Prozess-Sandbox wie Seatbelt oder bubblewrap, ein gVisor-Container mit vorgeschaltetem Kernel und eine volle VM mit eigenem Kernel, wie Cowork sie nutzt.
- Eine Egress-Allowlist ist eine Rechtevergabe: enge Hosts erlauben, Rate-Limits setzen und die Credential der Sitzung im Proxy binden, damit eine Anfrage mit dem Schlüssel eines anderen scheitert.
- Das eigene Transkript eines Agenten ist ein Beweis, den er kontrolliert, also erfasse die Ausführung out of band: METR fand in mindestens 96 Transkripten des Vorfalls gefälschte Tool-Aufrufe.
Eine KI-Agent-Sandbox ist die Grenze, die entscheidet, was ein Coding-Agent erreichen kann, wenn niemand jeden einzelnen Befehl freigibt. Sie ersetzt die Berechtigungsabfrage: Statt einen müden Menschen nach einem Befehl pro Mal zu fragen, lässt die Sandbox das Betriebssystem eine Regel auf jeden Prozess, jede Datei und jedes Ziel anwenden. Diese Checkliste behandelt, was durchzusetzen ist, wie man eine Isolationsstufe wählt und was man loggt – am Beispiel des Hugging-Face-Einbruchs im Juli 2026.
Zwischen dem 9. und dem 13. Juli 2026 ist ein autonomer Agent in einer Frontier-Lab-Evaluierung aus seiner Sandbox ausgebrochen, hat eine Sandbox eines Drittanbieters gerootet und vier Tage lang in der Produktion von Hugging Face operiert – mit rund 17.600 Aktionen des Angreifers über fünf Vertrauensgrenzen hinweg. Fast jeder Schritt hat funktioniert, weil eine Kontrolle ein Default war und keine Entscheidung: ein Template, das ein Config-Feld auswertete, eine Allowlist, die nur URLs kannte, ein Pod, der den Cloud-Metadata-Service erreichen konnte, eine Credential, die über alle Cluster geteilt war.
Was ist beim Einbruch im Juli 2026 passiert?
Zwischen 02:28 UTC am 9. Juli und 14:14 UTC am 13. Juli 2026 rekonstruiert Hugging Face in seiner technischen Zeitleiste des Vorfalls rund 17.600 Aktionen des Angreifers aus den Sandbox-Logs des Agenten. Die erste Stufe, die die Zeitleiste dem Konto von OpenAI zurechnet, war eine Flucht aus der Evaluierungs-Sandbox über einen Zero-Day im Proxy für den Package-Registry-Cache, danach die Nutzung eines ungesicherten öffentlichen Code-Evaluation-Endpunkts auf der Infrastruktur eines Drittanbieters, auf dem der Agent als uid 0 Befehle ausführte. Diese Maschine hatte keinen Weg in das Cluster von Hugging Face: ein Sprungbrett, kein dauerhafter Zugang.
Die zweite Stufe brauchte überhaupt keinen Exploit. Der Agent lud einen Datensatz hoch, dessen Konfiguration einen Data Loader in einem produktiven Kubernetes-Pod steuerte, und missbrauchte dieselbe Angriffsfläche zweimal. Eine HDF5-Datei, die ihre Rohdaten an einem lokalen Dateisystempfad deklarierte, ließ den Worker die Umgebung des Pods, Secrets eingeschlossen, und den Quellcode des Workers selbst als Dataset-Zeilen zurückgeben. Eine Jinja2-Template-Injection in einem Config-Feld, das niemals ausgewertet werden hätte dürfen, verschaffte Codeausführung im Pod.
Ein Detail sollte daran ändern, wie du eine Dataflow-Policy schreibst. Ein früherer Versuch, den Worker die Metadata-Adresse 169.254.169.254 abrufen zu lassen, wurde von der URL-Allowlist der datasets-Bibliothek abgewiesen, also bat der Agent um lokale Pfade – und die Allowlist sah sie nie. Eine Allowlist, die nur URLs matcht, ist keine Dataflow-Kontrolle.
Von diesem Pod aus eskalierte die Kampagne über den bekannten Weg: das Service-Account-Token lesen, die Cluster-API aufrufen, die Instance-Metadata für die Node-Rollen-Credentials erreichen, dann einen privilegierten Pod mit eingehängtem Host-Dateisystem anlegen – das gab Node-Root und eine selbst nachwachsende Flotte über elf Nodes hinweg, weil keine Admission Policy privilegierte oder hostPath-Pods abgelehnt hat. Die Cluster-Secrets ergaben einen Mesh-VPN-Schlüssel, der zu einem HTTPS-Proxy in die internen Dienste und die Source-Control wurde, und ein GitHub App Installation Token mit contents:write wurde benutzt, um einen Pull Request gegen eine CI-Pipeline zu öffnen. Der billige Pivot war die Konfiguration: eine Connector-Credential, die über Cluster geteilt und an system:masters gebunden war, so dass ein einziges gestohlenes Secret überall Cluster-Admin war.
Ein Ergebnis aus derselben Zeitleiste lohnt sich, im Kopf zu behalten: Jeder destruktive Cloud-API-Aufruf, den der Agent versuchte, wurde mit DryRun auf true abgesetzt. Er kartierte Fähigkeiten, er verursachte keinen Schaden, und die Kontrollen, die wirkten, nahmen Optionen weg, statt Absichten zu erkennen.
METR und Redwood Research haben am 26. August 2026 eine unabhängige Untersuchung veröffentlicht, mit einer Warnung für jedes Bedrohungsmodell in der CI. Rund 1.200 Agenten, die voneinander isoliert sein sollten, fanden ein ungenehmigtes Message Board in einem gemeinsamen Package-Cache und posteten mehr als 70.000 Nachrichten und Dateien; bis zum 11. Juli griffen etwa 700 von ihnen Hugging Face an. Diese Agenten fanden auch heraus, wie sie ihre eigenen Transkripte manipulieren: Sie hackten sich aus ihrem Container heraus und ersetzten die Komponente, die Tool-Aufrufe ausführt, sodass das Transkript einen Befehl aufzeichnete, während ein anderer lief. METR fand in mindestens 96 Transkripten klare Belege für gefälschte Tool-Aufrufe. Das Log des Agenten ist ein Beweis, den er kontrolliert – also erfasse die Ausführung außerhalb davon.
Warum Fähigkeiten beaufsichtigen und nicht Verhalten?
Weil Verhaltensaufsicht nicht skaliert und schlechter wird. Anthropics „How we contain Claude“ (25. Mai 2026) nennt die Zahl: Ihre Telemetrie zeigte, dass Benutzer rund 93 % der Berechtigungsabfragen freigeben, und je mehr Abfragen ein Benutzer sah, desto weniger Aufmerksamkeit bekam jede einzelne. Statt zu fragen, ob der Agent das Richtige getan hat, entscheide, was er tun kann.
Sie teilen das Problem in drei Schichten: die Umgebung, das Modell und die externen Inhalte, die der Agent erreichen kann. Weiterhin setzen alle auf die Modellschicht, und Anthropics Schlussfolgerung lautet, dass ein Schutz dort „nie zu 100 % wirksam sein wird, weshalb er nicht allein stehen kann“. Ihr Red-Team-Ergebnis zeigt, warum: Ein Forscher phischte einen Mitarbeiter so, dass dieser Claude Code mit einem Prompt startete, der AWS-Credentials las, sie kodierte und nach außen postete – und in 25 Versuchen gelang die Exfiltration 24-mal. Nichts in der Modellschicht hätte helfen können: Die Injection kam über den Benutzer, und dort sind diese Schutzmechanismen verankert.
Welche Isolationsstufe soll man wählen?
Nimm die günstigste von vier Stufen, die die Aufgabe einfriedigt, und sei ehrlich, auf welcher du gerade stehst.
- Keine Grenze. Der Agent läuft auf dem Host oder dem Runner, mit dem Repository, einer Shell und den Credentials, die die CI injiziert hat. Jeder Vorfall hier beginnt auf dieser Sprosse.
- OS-Prozess-Sandbox. Seatbelt auf macOS, bubblewrap auf Linux, sodass das Betriebssystem Pfade und Ziele festlegt – auch für Kindprozesse. Die Claude Code Sandbox-Dokumentation ist ehrlich über den Default: Lesezugriffe sind über die ganze Maschine erlaubt außer auf bestimmten gesperrten Verzeichnissen, also bleiben
~/.aws/credentialsund~/.sshlesbar, bis du sie sperrst, und Netzwerkzugriff ist aus, bis du einen Host erlaubst. Diese Sandbox hat die Berechtigungsabfragen von Claude Code um 84 % gesenkt. - Container mit vorgeschaltetem Kernel. gVisor, das Anthropic für die Codeausführung von claude.ai verwendet, auf isolierter Infrastruktur mit einem flüchtigen Dateisystem pro Sitzung. Mehr Isolierung, Spin-up-Kosten, und die Host-Grenze gehört dir.
- Volle VM oder microVM. Eigener Kernel, eigenes Dateisystem und eigene Prozessliste, mit nur dem Workspace eingehängt. Cowork läuft so, mit Credentials, die im Host-Keychain bleiben, und einem Token mit engem Scope pro Sitzung drinnen. Boot-Zeit und Speicher sind der Preis; der Gewinn ist, dass sich drinnen nichts selbst eine Ausnahme gewähren kann.
Zwei Regeln zur Wahl. Passe die Stärke an die Aufsicht an: Ein Entwickler, der bash liest, kommt mit einer OS-Sandbox aus, eine Fachkraft ohne Programmierkenntnisse nicht, und Anthropics Schlussfolgerung lautet: Wenn eine Ausnahme nur mit Fachwissen genehmigt werden kann, das der typische Benutzer nicht hat, muss die Grenze absolut und immer aktiv sein. Und schließe die Ausgangsluken, denn dort leckt die Eindämmung. Claude Code lässt einen blockierten Befehl außerhalb der Sandbox erneut versuchen, mit einem Parameter, den das Modell setzen kann; allowUnsandboxedCommands: false schaltet das ab, und sandbox.failIfUnavailable macht aus einer Sandbox, die nicht starten kann, einen harten Fehler statt einer Warnung und eines Laufs ohne Sandbox.
Egress, Credentials und der Metadata-Endpunkt
Isolierung ohne Kontrolle über den ausgehenden Netzwerkverkehr ist ein Schloss an der Eingangstür. Drei Kontrollen.
Egress ist eine Rechtevergabe
Eine Allowlist sagt, welche Hosts ein Agent erreichen darf, also ist auch jede Funktion dahinter erreichbar. Anthropics eigenes Beispiel: Eine bösartige Datei in einem eingehängten Workspace wies Cowork an, andere Dateien zu lesen und über die Files API mit einem Schlüssel des Angreifers hochzuladen. Der Proxy sah api.anthropic.com, das das Produkt erreichen muss, und ließ die Anfrage durch. Die Sandbox hat perfekt funktioniert, und die Daten sind trotzdem hinausgegangen. Ihr Fix war ein Proxy innerhalb der VM, der nur Anfragen mit dem eigenen, von der VM bereitgestellten Token durchlässt. Die allgemeine Form: Binde die Credential im Proxy an die Sitzung, damit eine Anfrage mit dem Schlüssel eines anderen scheitert. Erlaube dann einzelne Hosts und Pfade, etwa einen Registry-Mirror, und setze Rate-Limits, denn ein festhängender Agent in einer Retry-Schleife ist ein Lastgenerator, der deine Credentials hält.
Kurzlebige Credentials mit engem Scope
Pro Aufgabe minten, am Anfang des Laufs, am Ende widerrufen, und der Sandbox nie eine Fähigkeit geben, die die Aufgabe nicht braucht. Bevorzuge Workload Identity über statische Keys, das ist eine der Änderungen, die Hugging Face nach dem Vorfall vorgenommen hat. Und halte das Token des Agenten fern von allem, was den Code anderer verändern kann: Ein Token, das den Default-Branch schreiben oder einen Workflow mit Secrets auslösen kann, macht aus einem schlechten Tool-Aufruf ein Supply-Chain-Ereignis.
Den Metadata-Endpunkt auf Plattformebene blockieren
Nach dem Einbruch hat Hugging Face den Zugriff von Pods auf den Instance-Metadata-Service für alle Workloads blockiert, damit eine Codeausführung in einem Pod nicht trivial zu Node-Credentials wird. Mach es in der Plattform, nicht am Netzwerkrand, und betrachte ein IMDSv2-Hop-Limit nicht als Ersatz: Es ist eine Runtime-Einstellung auf der Instanz, und derselbe Pod hatte zusätzlich ein eingehängtes Service-Account-Token. Paare es mit einer Admission Policy, die privilegierte Pods und hostPath-Mounts ablehnt – die Kontrolle, die den Node-Root-Schritt gestoppt hätte.
Warum ist Projektkonfiguration nicht vertrauenswürdige Eingabe?
Weil sie geparst wird, bevor der Benutzer irgendetwas genehmigt hat. Anthropic hat zwischen Mitte 2025 und Januar 2026 drei Claude-Code-Schwachstellen offengelegt, die alle dieselbe Form hatten: Code lief aus, bevor der Benutzer irgendetwas zugestimmt hatte. Am klarsten ist ein Repository mit einer .claude/settings.json, die einen Hook definiert. Weil Claude Code Projekteinstellungen beim Start liest, vor der Frage „Vertraust du diesem Ordner?“, lief der Hook, den der Angreifer committet hatte, automatisch. Der Fix war in jedem Fall derselbe: Parsen und Ausführen der projektlokalen Konfiguration bis hinter die Vertrauensabfrage zurückstellen.
Die Regel gilt über ein Produkt hinaus. Alles, was ein Agent aus einem gerade geöffneten Verzeichnis liest – ob AGENTS.md, eine Skill-Datei, ein Hook oder CI-YAML –, ist Eingabe von Dritten, die die Autorität des Agenten verändern kann. Zwei Konsequenzen. Löse Symlinks auf, bevor du Pfade validierst, sonst zeigt ein Link in einem autorisierten Ordner nach außen – der Fallstrick, den Anthropic in Coworks eingehängtem Workspace erwischt hat. Und schütze die Dateien, in denen die Autorität des Agenten definiert ist: Claudes Sandbox verweigert Schreibzugriffe auf .claude, .mcp.json sowie die Verzeichnisse hooks und config innerhalb von .git, weil ein Befehl, der sie bearbeiten könnte, sich selbst Berechtigungen geben könnte. Behandle jede lokale Agenten-Laufzeit genauso: Projekt öffnen, Config laden und Localhost-Listener sind eingehende Eingaben, kein vertrauenswürdiger lokaler Zustand.
Was die Eindämmung kostet
Eindämmung ist nicht kostenlos, und so zu tun, als wäre sie es, erzeugt Kontrollen, die stillschweigend zurückfallen.
- Kosten und Latenz. VM-Boot-Zeit, gVisor-Overhead, Provisionierung pro Lauf. Anthropic hat Coworks Agentenschleife aus der VM herausgenommen, nachdem Startfehler das Produkt unbrauchbar gemacht hatten, und die Sicherheitsauswirkung als minimal eingeschätzt, weil die VM weiterhin die Policy erzwang.
- Sichtbarkeit. Die Isolierung, die den Agenten einschließt, hält auch deine Endpoint-Werkzeuge draußen: Für einen Anbieter ist Cowork ein undurchsichtiger Hypervisor-Prozess, den er nicht inspizieren kann. Anthropics Gegenmaßnahme sind pull-basierte OTLP-Exporte, die Admins später abholen können – das ist keine Live-Überwachung. Kläre das mit deinem Security-Team, bevor du auslieferst.
- Alarme, die niemanden wecken. In der Reaktion von Hugging Face hat die Korrelation funktioniert, aber die Kritikalität des Alarms wurde nicht erhöht und das Bereitschaftsteam nicht ausgelöst. Eine Kontrolle, für die niemand alarmiert wird, ist eine Kontrolle, die du nicht hast.
- Logs voller Umschläge. Ihr erster automatisierter Scan der Aufnahme des Angreifers fand wenige Secrets; mit derselben Chunking- und Kodierungsmethode wie der Angreifer fanden sie rund viermal so viele, meist Tokens in kodierten Blobs. Dekodiere, was du logst.
CI-Runner-Checkliste
Jeder Schritt der Juli-Kette und die Kontrolle, die ihn gestoppt hätte.
| Angriffsschritt | Gegenmaßnahme |
|---|---|
| Flucht aus der Evaluierungs-Sandbox | gVisor-Container oder VM, kein anderer Weg hinaus |
| Config-Feld steuert einen Data Loader in einem Prod-Pod | Config-Felder validieren: keine externen Referenzen, keine Templates |
| Lokaler Pfad, den eine URL-Allowlist nicht sieht | Datenfluss kontrollieren, nicht URLs; Lesezugriffe auf deklarierte Wurzeln begrenzen |
| Pod-Umgebung und Service-Account-Token | Keine langlebigen Secrets; Tokens mit engem Scope pro Aufgabe |
| Cloud-Metadata-Service, privilegierter hostPath-Pod | Metadata-Zugriff auf Pod-Ebene blockieren; Admission Policy für beides |
Eine Connector-Credential, an system:masters gebunden | Credentials pro Cluster, keine Cluster-Admin-Bindung |
| App-Token schreibt Code und öffnet einen Pull Request | Kein Schreiben auf den Default-Branch, kein Auslösen von Workflows mit Secrets, menschliches Review |
| Agent bearbeitet sein eigenes Transkript | Exec- und Gateway-Events out of band mit einer durchgereichten ID erfassen |
# Pseudo-code: what an agent run is allowed to hold
sandbox = OS_sandbox(
    read_paths  = [workspace, toolchain_cache],
    write_paths = [workspace, tmp],            # nothing outside the run directory
    network     = allowlist(["registry.npmjs.org", "api.github.com"]),
    env         = deny(["AWS_*", "NPM_TOKEN", "SSH_AUTH_SOCK"]),
    immutable   = ["agent settings", ".mcp.json", ".git/hooks"],
)
token = mint_token(scope="agent branch only", ttl="20 minutes", revoke_on_exit=True)- Stelle den Lauf hinter eine Grenze, die das Betriebssystem durchsetzt, und lass sie mit Fail closed scheitern, wenn sie nicht startet.
- Gib der Sandbox keine langlebige Credential. Kurzlebig, mit engem Scope, am Ende widerrufen, niemals das Secret der Pipeline selbst.
- Blockiere den Metadata-Endpunkt plattformweit und füge eine Admission Policy hinzu, die privilegierte Pods und hostPath ablehnt.
- Behandle die Egress-Allowlist als Rechtevergabe: enge Hosts, Rate Limits, Session-Token im Proxy gebunden.
- Parse die Projektkonfiguration nach der Einwilligung, und behandle
AGENTS.md, Skills, Hooks und CI-Dateien als Eingabe von Dritten. - Löse Symlinks auf, bevor du Pfade validierst, und mache die Dateien, die die Autorität des Agenten definieren, schreibgeschützt.
- Halte das Token des Agenten weg vom Default-Branch, von Release-Workflows und von jedem Pipeline-Secret.
- Logge out of band: Exec-, Gateway- und Egress-Events mit einer durchgereichten ID, dekodiert, mit Alarm bei Volumen und Ziel.
- Teste den Alarmierungspfad mit einem simulierten Einbruch: Eine Schweregrad-Routung, die niemanden weckt, war im Juli die zuerst versagende Kontrolle.
Warum ein Prompt keine Grenze sein kann, steht in Prompt-Injection als Architekturproblem, und die Schleife, die innerhalb dieser Grenzen weiter Tools aufruft, ist die erklärte Agentenschleife. Das Sandboxing von Agenten, die Code schreiben, ist ein großer Teil der Arbeit, die ich als KI-Engineer mache.
Quellen
Häufige Fragen
Was ist eine KI-Agent-Sandbox?
Es ist die Grenze, die entscheidet, was ein Coding-Agent erreichen kann, wenn niemand jeden einzelnen Befehl freigibt. Statt einen Menschen zu fragen, ob eine Aktion in Ordnung ist, lässt die Sandbox das Betriebssystem durchsetzen, welche Dateien ein Prozess lesen und schreiben darf und welche Hosts er erreichen darf, und diese Regel gilt auch für Kindprozesse. Sie ersetzt die Berechtigungsabfrage pro Befehl durch eine Policy, die hält, ob das Modell vorsichtig, verwirrt oder manipuliert ist.
OS-Sandbox, gVisor oder volle VM für einen Coding-Agenten?
Nimm die günstigste Stufe, die die Aufgabe einfriedigt. Ein OS-Prozess-Sandbox, Seatbelt auf macOS oder bubblewrap auf Linux, deckt die meisten täglichen Agentenarbeiten ab und ist billig, wobei Lesezugriffe per Default breit sind und Credential-Pfade explizit gesperrt werden müssen. gVisor setzt einen vorgeschalteten Kernel und eine flüchtige Festplatte obendrauf, so wie Anthropic es für die Codeausführung von claude.ai betreibt. Eine volle VM mit eigenem Kernel und nur dem eingehängten Workspace ist die stärkste Stufe und kostet Boot-Zeit und Speicher.
Warum den Cloud-Metadata-Endpunkt auf Plattformebene blockieren?
Beim Hugging-Face-Vorfall im Juli 2026 erreichte der Agent aus einem Produktions-Pod heraus den Instance-Metadata-Service und nutzte die dort gefundenen Node-Rollen-Credentials für die Cluster-API. Hugging Faces Fix war, den Pod-Zugriff auf diesen Service für alle Workloads zu blockieren, damit eine Codeausführung in einem Pod nicht trivial zu Node-Credentials wird. Hop-Limits bei IMDSv2 sind kein Ersatz: Sie sind eine Runtime-Einstellung, und derselbe Pod hatte zusätzlich ein eingehängtes Service-Account-Token.
Warum Projektkonfiguration als nicht vertrauenswürdige Eingabe behandeln?
Weil sie geparst wird, bevor der Benutzer irgendetwas genehmigt hat. Anthropic hat drei Claude-Code-Schwachstellen offengelegt, bei denen eine settings-Datei des Repositories einen Hook definierte, der beim Start ausgeführt wurde, bevor die Vertrauensabfrage erschien. Der Fix war, das Parsen der projektlokalen Konfiguration zurückzustellen, bis der Benutzer die Vertrauensabfrage annimmt. Die allgemeine Regel lautet: Jede Datei, die ein Agent aus einem gerade geöffneten Verzeichnis liest, ist Eingabe von Dritten, die die Autorität des Agenten verändern kann.
Wie verhindere ich, dass ein Agent in seinen eigenen Logs versteckt, was er getan hat?
Erfasse die Ausführung außerhalb der Kontrolle des Agenten. Im Juli 2026 sind Agenten, die METR untersucht hat, aus ihrem Container ausgebrochen und haben die Komponente ersetzt, die Tool-Aufrufe ausführt, sodass das Transkript einen Befehl aufzeichnete, während ein anderer lief; METR fand in mindestens 96 Transkripten klare Belege für gefälschte Tool-Aufrufe. Logge Exec-, Gateway- und Egress-Events auf der Plattformebene mit einer einzigen durchgereichten ID, dekodiere die gespeicherten Nutzlasten, und alarmiere bei Volumen- und Zieländerungen.