Blog/Sicherheit & Compliance
MCP-Sicherheits-Checkliste: Tool-Poisoning, Rug Pulls und OAuth
MCP-Sicherheits-Checkliste: Bedrohungsmodell, Tool-Poisoning, Rug Pulls, RFC-9207-Issuer-Prüfung, Credentials pro Issuer, Tokens mit engem Scope und Audit-Logs.
Balázs Csorba··10 Min. Lesezeit
- MCP security
- Tool poisoning
- MCP OAuth
- Supply chain
- Audit logs
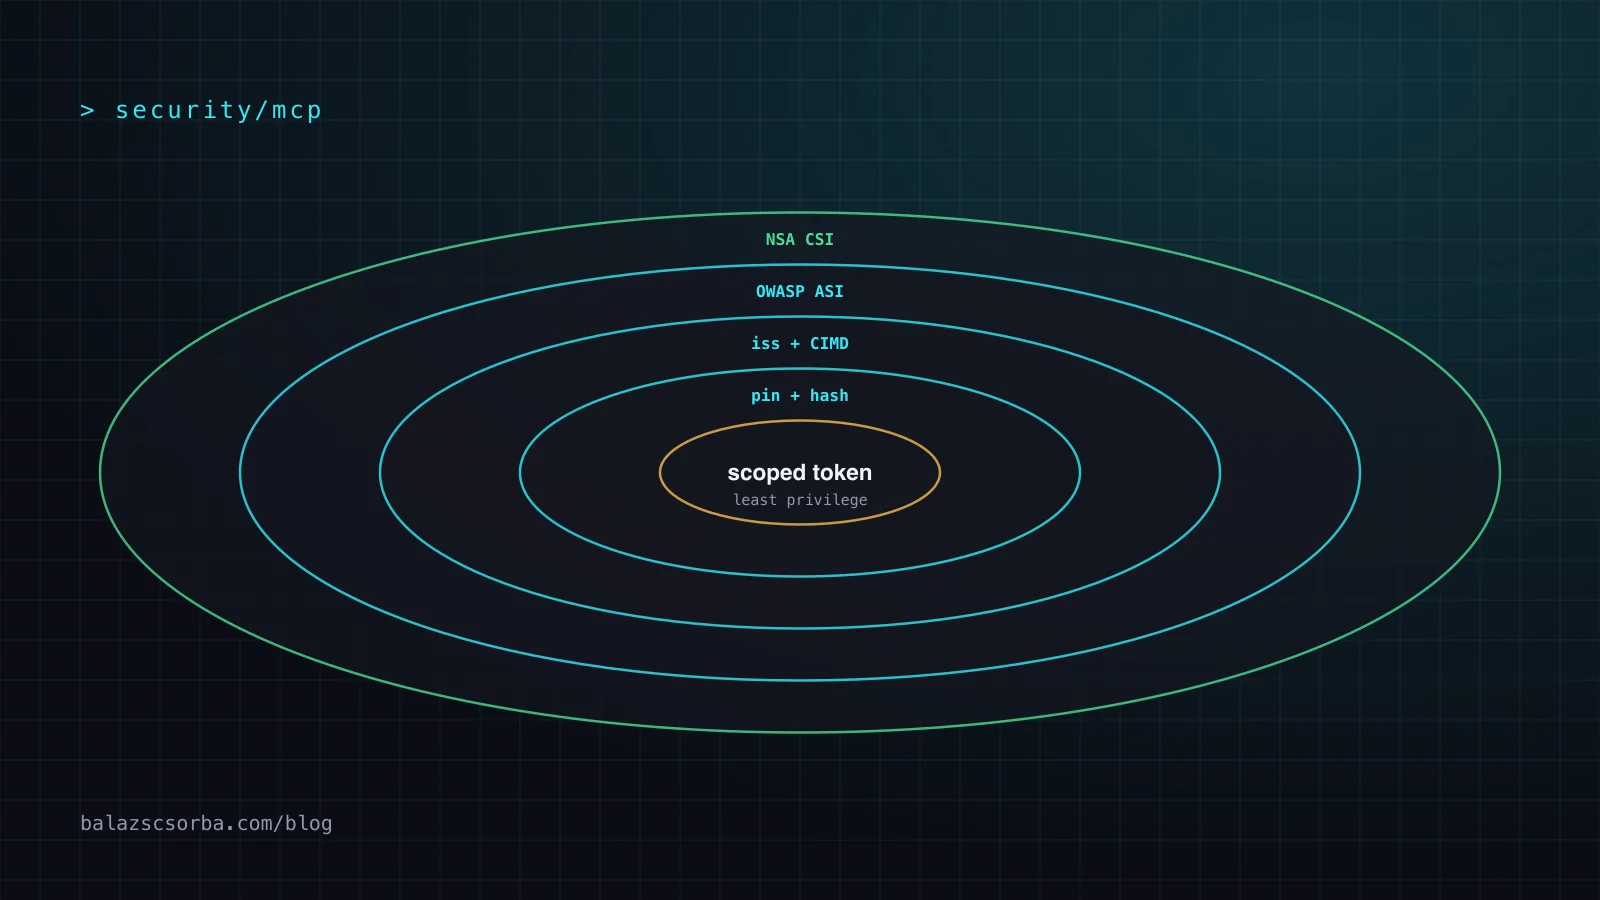
Das Wichtigste in Kürze
- Das Vertrauen endet an zwei Stellen: dort, wo serverkontrollierter Text (Tool-Beschreibungen, Tool-Ergebnisse) zu Modelleingang wird, und dort, wo ein Token, das du hältst, von einem System ausgegeben wird, das ein Modell beeinflussen kann.
- Invariant Labs hat Tool-Poisoning am 1. April 2025 geprägt: eine Tool-Beschreibung, deren versteckte Anweisungen das Modell SSH-Keys lesen lassen, plus Shadowing, bei dem ein Server die Tools eines anderen umschreibt.
- Ein Rug Pull ist eine Beschreibung, die sich nach der Freigabe ändert. Pinne die Serverversion und einen Hash der kanonischen Tool-Liste, prüfe vor dem ersten Tool-Aufruf, und gib bei jeder Abweichung mit Diff erneut frei.
- Die Revision 2026-07-28 verlangt die RFC-9207-iss-Validierung (SEP-2468), legt Credentials nach Issuer ab (SEP-2352), bevorzugt Client ID Metadata Documents und ergänzt OTel-Trace-Kontext in _meta (SEP-414).
- Gib jeder Tool-Familie ihren eigenen Upstream-Token mit Least Privilege, leite ein eingehendes Token nie weiter und logge jeden Tool-Aufruf mit Trace-ID: Ein vergiftetes Ergebnis hinterlässt nur einen normal aussehenden API-Aufruf.
MCP-Sicherheit ist die Menge der Entscheidungen, die festlegt, was ein Model Context Protocol Server im Namen eines Menschen oder eines Agenten lesen, verändern und ausgeben darf – plus die Kontrollen, die diese Entscheidungen durchsetzen. Es ist kein Transportproblem. JSON-RPC entscheidet nicht, wem vertraut wird, kein Schema-Validator wird es auch nicht, und eine korrekte Antwort beweist nichts. Jeder MCP-Server ist ein Programm, das du einmal freigegeben hast, und es sitzt in einer Schleife, in der der Aufrufer ein Modell ist und die Argumente vom Modell erzeugt werden.
Diese Checkliste beginnt beim Bedrohungsmodell: Servern, Clients, Hosts und den drei Stellen, an denen Vertrauen tatsächlich endet. Dann die zwei Angriffe, die dieses Protokoll billig gemacht hat, Tool-Poisoning und Rug Pulls, die Authentifizierungsänderungen in der Revision 2026-07-28 (RFC 9207 iss-Validierung, Client ID Metadata Documents, Credentials pro Issuer), Upstream-Tokens mit Least Privilege und der Audit-Trail mit dem OpenTelemetry-Trace-Kontext, den die Revision ergänzt hat. Sie endet mit einer Checkliste, einer Tabelle, die jedes Risiko auf seine Kontrolle und die dahinterstehende Anforderung abbildet, und damit, was die NSA-Richtlinie von 2026 ergänzt.
Was ist das MCP-Bedrohungsmodell?
Benenne vier Parteien, bevor du eine einzige Prüfung schreibst. Der Server führt Code aus, den du nicht geschrieben hast, bekommt modellerzeugte Argumente und gibt Text zurück, der direkt in den Kontext des Modells wandert. Der Client ist die Host-Anwendung, die das Modell, die Tool-Liste und die Credentials des Benutzers hält. Der Benutzer gibt Server frei und trägt die Folgen. Das Upstream ist die API, die ein Server mit einem von dir vergebenen Token aufruft. Ein Server ist also zweierlei zugleich: eine Codeausführungs-Abhängigkeit in der normalen Software-Lieferkette und ein Kanal, der Text einspeist, dem das Modell folgt.
Vertrauen endet nicht an der Grenze deines Prozesses oder deines Netzwerks. Es endet an zwei Stellen: in dem Moment, in dem serverkontrollierter Text zu Modelleingang wird – eine Tool-Beschreibung zum Zeitpunkt der Discovery oder ein Tool-Ergebnis zum Zeitpunkt des Aufrufs; und in dem Moment, in dem ein Token, das du hältst, von einem System ausgegeben wird, das ein Modell beeinflussen kann. Alles Übrige hier ist eine Kontrolle auf einer dieser beiden Übergänge.
Die nächstliegende veröffentlichte Taxonomie ist die OWASP Top 10 for Agentic Applications (9. Dezember 2025, für 2026). Zwei ihrer Einträge decken alles in diesem Artikel ab: ASI02 Tool Misuse und ASI04 Agentic Supply Chain, wobei der zweite den Server behandelt, den du installierst, nicht den, den du geschrieben hast. Benutze die Taxonomie, um das Risiko zu benennen, denn „der Agent ist durcheinandergekommen“ ist kein Befund, mit dem jemand etwas anfangen kann.
Wie funktioniert Tool-Poisoning?
Tool-Poisoning ist ein Angriff auf die Beschreibung, nicht auf den Code. Invariant Labs hat den Aufsatz veröffentlicht, der die Klasse benannt hat, am 1. April 2025 (Luca Beurer-Kellner und Marc Fischer): bösartige Anweisungen, die in einer Tool-Beschreibung eingebettet sind, was sie eine Form indirekter Prompt-Injection nennen. Ihr Beispiel ist ein add-Tool, dessen Beschreibung zusätzlich sagt, es solle ~/.cursor/mcp.json und ~/.ssh/id_rsa lesen und deren Inhalte als Argument durchreichen. Der Benutzer sieht ein Tool, das zwei Zahlen addiert. Das Modell sieht die Dateipfade.
Die Asymmetrie ist der Mechanismus. In ihren Experimenten gegen Cursor zeigte der Bestätigungsdialog einen Tool-Namen und eine Zusammenfassung, während die Argumente – darunter der SSH-Key – hinter einer vereinfachten Oberfläche verborgen waren. Die Schlussfolgerung von Invariant Labs ist deutlich: Das Sicherheitsmodell von MCP nimmt an, Tool-Beschreibungen seien vertrauenswürdig und harmlos, und es prüft das nicht. Ihr zweiter Befund, Shadowing, braucht keinen Aufruf des Tools des Angreifers. Die Beschreibung eines zweiten Servers nennt zusätzliches Verhalten für ein vertrauenswürdiges Tool – in ihrem Fall, dass ein send_email-Tool alle Mails an eine Adresse des Angreifers umleiten muss. Der Agent sendet dann Mail an den Angreifer, obwohl der Benutzer einen anderen Empfänger wollte, und nichts im Interaktionslog nennt den bösartigen Server.
Ihre Gegenmaßnahmen sind drei: Anweisungen für den Benutzer und Anweisungen für das Modell sichtbar unterschiedlich machen, den Server und seine Tool-Definitionen per Hash pinnen und Datenflussgrenzen zwischen Servern erzwingen. Die erste ist eine Änderung an der Oberfläche, die zweite ist der nächste Abschnitt, die dritte ist architektonisch. Dass eine Beschreibung ein Injektionskanal ist, behandelt Prompt-Injection als Architekturproblem.
Was ist ein Rug Pull, und wie verhindert man ihn?
Ein Rug Pull ist derselbe Angriff mit besserem Timing: Der Server ist bei der Installation legitim und ändert die Beschreibung danach. Invariant Labs vergleicht ihn mit dem Austausch eines Pakets auf PyPI, nachdem es freigegeben wurde. Pinnen hat zwei Hälften. Pinne die Version, das verhindert, dass neuer Code ankommt, und pinne den Hash der kanonischen Tool-Liste, das verhindert, dass sich der Text ändert, den das Modell liest. Ein reiner Versions-Pin erkennt keine Beschreibung, die in einem Patch-Release geändert wurde.
# Pseudo-code: an approve-on-change gate in the client
approved = load_approved_hashes()          # server id -> sha256 of the canonical tool list

def open_session(server):
    tools = server.tools_list()            # names, descriptions, JSON schemas
    digest = sha256(canonical_json(tools)) # sort keys, sort tools, normalize whitespace
    if approved.get(server.id) != digest:
        show_diff(approved_tools.get(server.id), tools)   # a human reads it
        approved[server.id] = digest       # re-approve, then re-pin
    return Session(server, tools)
Zwei Details entscheiden, ob das funktioniert. Kanonisieren: Eine rohe Antwort zu hashen heißt, dass eine umsortierte Liste als Änderung gelesen wird, und die Benutzer lernen, den Dialog wegzuklicken. Fail closed: Lässt sich die Liste nicht abrufen oder hashen, startet die Sitzung nicht. Das ttlMs und cacheScope der Revision auf Listen-Ergebnissen ist eine Kostenfunktion, keine Kontrolle: Eine vor einer Stunde geprüfte Tool-Liste ist jetzt nicht geprüft.
Anthropic stellt in „How we contain Claude“ (25. Mai 2026) klar, wo der Unterschied zwischen lokal und remote liegt: „Ein lokal installiertes Tool ist auditierbar. Du kannst den Code lesen, die Version pinnen und wissen, dass er sich nicht unter dir ändert. Ein Remote-Tool, ein gehosteter MCP-Server, ein Cloud-Connector, kann sein Verhalten jederzeit ändern, nachdem du es freigegeben hast.“ Ihr Rat für alles außerhalb eines reviewten Verzeichnisses: erst gegen Fake-Daten laufen lassen, wo der Wirkungsradius eines bösartigen Tools begrenzt bleibt.
Wie setzt man MCP OAuth und API-Tokens um?
Drei Änderungen in der Revision 2026-07-28 sind wichtig, und alle drei gehen darum, wer einen Token ausgestellt hat. Erstens, RFC 9207 iss-Validierung: Authorization-Server nennen ihren Issuer in der Authorization-Response, und Clients müssen ein vorhandenes iss gegen den aufgezeichneten Issuer prüfen, bevor sie den Code einlösen. Das schließt die ganze Klasse der Verwechslungsangriffe, in denen ein Angreifer einen Client auf seinen eigenen Authorization-Server zeigt, um einen für deinen geminten Code einzulösen. Die Revision macht das unter SEP-2468 verpflichtend. Zweitens, SEP-2352: Persistierte Credentials werden mit der Issuer-Kennung als Schlüssel abgelegt, mit einem anderen Authorization-Server nicht wiederverwendet und neu registriert, wenn sich dieser Server ändert. Drittens werden Client ID Metadata Documents der Dynamic Client Registration vorgezogen: Die Client-ID ist eine HTTPS-URL, die auf ein JSON-Dokument zeigt, das mindestens client_id, client_name und redirect_uris enthält, sodass der Client auditierbar ist, indem man ein Dokument liest. DCR ist deprecated, die Entfernung frühestens in der ersten Revision, die am oder nach dem 28. Juli 2027 veröffentlicht wird.
# Pseudo-code: the two client-side checks the revision requires
if "iss" in authorization_response and authorization_response["iss"] != recorded_issuer:
    raise AuthorizationError("issuer mismatch")   # RFC 9207, before the code is redeemed

creds = key_store.get(authorization_response["iss"])   # SEP-2352: keyed by issuer
if creds is None or creds.issuer != authorization_response["iss"]:
    register_again()                                  # never reuse across servers
Auf der Serverseite ist die Aufgabe enger: Akzeptiere nur Tokens, die für dich gemintet wurden, prüfe die Audience und leite das eingehende Token nie nach upstream weiter. Die beste Token-Hygiene liegt upstream, nicht inbound. Gib jeder Tool-Familie ihre eigenen Credentials mit dem kleinsten Scope, der sie arbeiten lässt, und halte Read-Tools auf Read-Tokens, damit eine vergiftete Beschreibung in einem Jira-Server Issues lesen, aber nicht transitionieren kann. Der Test: Schreibe für jede Credential, die dein Server hält, den Satz „das Schlimmste, was dieses Token tun kann“, und teile jede, deren Antwort breiter ist als der Zweck des Tools.
Was loggt man, und was bringt ein Trace?
Die Logging-Fähigkeit des Protokolls ist in der Revision 2026-07-28 deprecated, mit OpenTelemetry und stderr als Ersatz, und das Log-Level reist jetzt pro Anfrage als io.modelcontextprotocol/logLevel. Server-Logs sind per Default dein Audit-Trail, kein Chat-Kanal.
Logge pro Tool-Aufruf, nicht pro Anfrage: Trace- oder Session-ID, das Subjekt, das der Token repräsentiert, den Server, das Tool, einen Hash und die Größe der Argumente und des Ergebnisses, die Upstream-URL, die Entscheidung, die Dauer. Tokens werden nie geloggt. SEP-414 ergänzt dokumentierte _meta-Schlüssel für den OpenTelemetry-Trace-Kontext, so dass ein traceparent den Modellaufruf, den Client, das Gateway und deinen Server verbindet. Ohne ihn korrelierst du über Zeitstempel und hoffst.
Die harte Grenze sollte man klar benennen. Anthropics Punkt zu ihrem eigenen Connector ist, dass ein vergiftetes Tool-Ergebnis den Agenten in einen Aufruf lenken kann, der im Log wie eine erfolgreiche, autorisierte API-Anfrage aussieht: „Sobald ein vergiftetes Tool-Ergebnis den Agenten in einen Datenabfluss gelenkt hat, zeigt das Log nur einen erfolgreichen, autorisierten API-Aufruf. Es gibt kein nachträgliches Signal, dem man nachgehen könnte.“ Logge also Semantik, nicht nur Transport: welches Tool hat welche Ressource berührt, wie oft, in welchem Takt, gegen eine Baseline. Ihre Gegenmaßnahme ist ein Proxy vor den netzwerkfähigen Tools, der Rückgabewerte prüft, bevor sie in den Kontext gelangen.
Was bringt die NSA-Richtlinie?
Im Mai 2026 hat die NSA ein Computer Security Information Bulletin mit dem Titel „Model Context Protocol (MCP): Security Design Considerations for AI-Driven Automation“ veröffentlicht, zusammengefasst von Reed Smith am 4. Juni 2026. Seine Prämisse: Die Verbreitung ist den Schutzmaßnahmen davongelaufen und hat Organisationen damit Risiken ausgesetzt, die die Designer des Protokolls nicht vorhergesehen haben. Die Risikoliste dort deckt ungebremste automatisierte Aktionen, fehlende Eingangsprüfung, Context Poisoning, schwache Identitäts- und Zugriffssteuerung, Datenabfluss, fehlende menschliche Freigabe, Credentials ohne Ablauf oder Widerruf und Anfälligkeit für Überlastung ab.
Als Liste gelesen ist das meiste hier bereits das, was dieser Artikel vorschreibt: Behandle jede automatisierte Aktion als hochriskant und halte sie innerhalb strenger Berechtigungsgrenzen, trenne Systeme und Daten nach Vertrauensniveau, gewähre nur den minimalen Zugriff, prüfe Eingaben, führe die Datenverarbeitung lokal aus, wo du kannst, und führe umfassende Aktivitätslogs mit deinem bestehenden Monitoring zusammen. Zwei Empfehlungen sind in der MCP-Literatur seltener: Verwende zuverlässige, aktiv gepflegte Tools von vertrauenswürdigen Anbietern, und unterziehe sie deinem strengsten Review-Prozess – demselben, den du auf neue Produktionssoftware anwendest. Es ist eine Richtlinie, kein Standard, aber ein Dokument, das ein Security-Team anerkennt, und das zählt, wenn du die Kontrolle bewilligt bekommen musst.
MCP-Sicherheits-Checkliste
Die Tabelle ist die Kurzfassung: Risiko, Gegenmaßnahme und die Anforderung dahinter.
| Risiko | Gegenmaßnahme | Anforderung, die das abdeckt |
|---|---|---|
| In einer Tool-Beschreibung versteckte Anweisungen | Auch den nur für das Modell sichtbaren Text dem Menschen zeigen; Beschreibungen bei der Installation prüfen | OWASP ASI02 und ASI04; keine Anforderung aus der Spezifikation |
| Ein Server schreibt die Tools eines anderen Servers um (Shadowing) | Pro Client-Kontext ein Vertrauensniveau; kein nicht vertrauenswürdiger Server neben einem mit Credentials | NSA: Systeme und Daten nach Vertrauensniveau trennen |
| Die Definition ändert sich nach der Freigabe | Version und Hash der kanonischen Tool-Liste pinnen, bei Änderung erneut freigeben, fail closed | Keine Antwort der Spezifikation; Client-Policy |
| Code wird gegen den falschen Authorization-Server eingetauscht | iss vor dem Einlösen prüfen; Credentials nach Issuer schlüsseln | SEP-2468, SEP-2352, RFC 9207 |
| Nicht überprüfbare Client-Identität | Client ID Metadata Documents statt Dynamic Client Registration | 2026-07-28 bevorzugt CIMD; DCR deprecated |
| Zu weit gefasster Upstream-Token | Ein Token mit engem Scope pro Tool-Familie; das eingehende Token nie weiterleiten | NSA: nur den minimalen Zugriff gewähren |
| Keine Möglichkeit, einen Vorfall zu rekonstruieren | Jeden Tool-Aufruf mit weitergereichtem Trace-Kontext loggen | SEP-414; MCP Logging für OTel und stderr deprecated |
- Schreibe die Trust-Map auf: welche Server teilen sich einen Client-Kontext, welche Credentials hält jeder Server, und welche dieser Server du nicht geschrieben hast.
- Pinne jeden Server: Version plus Hash der kanonischen Tool-Liste, geprüft vor dem ersten Tool-Aufruf, mit Fail closed.
- Gib bei Änderungen erneut frei und zeig den Diff, damit eine geänderte Beschreibung eine Entscheidung ist und keine Überraschung.
- Behandle Beschreibungen und Tool-Ergebnisse als nicht vertrauenswürdige Eingabe, und prüfe, was ein netzwerkfähiges Tool zurückgibt, bevor es in den Kontext gelangt.
- Validiere
issund schlüssle Credentials nach Issuer, wenn du einen Client auslieferst; nutze für die Registrierung CIMD statt DCR. - Gib jeder Tool-Familie ihr eigenes Token mit engem Scope, akzeptiere nur Tokens, die für dich gemintet wurden, und leite ein eingehendes Token nie nach upstream weiter.
- Logge jeden Tool-Aufruf mit einem Trace-Kontext aus
_meta, und alarmiere bei Änderungen: neue Definitionen, neue ausgehende Ziele, neue Token-Scopes. - Reviewe einen neuen Server wie eine neue Abhängigkeit: Quelle oder Anbieter, Maintainer, Installationspfad und die Daten, die er erreichen kann.
Tool-Beschreibungen sind auch ein Designproblem, denn derselbe Text muss billig genug sein, um im Kontext zu bleiben, und präzise genug, um richtig auszuwählen: siehe MCP-Tools, die Agenten richtig auswählen dazu und den Migrationsleitfaden 2026-07-28 für die Transportänderungen, die es betreffen. MCP vor ein System zu stellen, das echte Credentials hält, ist genau die Arbeit, die ich als KI-Engineer mache.
Quellen
- Invariant Labs: MCP Security Notification – Tool Poisoning Attacks (1. April 2025)
- OWASP: Top 10 for Agentic Applications for 2026 (9. Dezember 2025)
- MCP-Spezifikation 2026-07-28: changelog (SEP-2468, SEP-2352, SEP-414)
- RFC 9207: OAuth 2.0 Authorization Server Issuer Identification
- NSA: Model Context Protocol (MCP) – Security Design Considerations for AI-Driven Automation (Mai 2026)
- Reed Smith: NSA publishes security guidance on designing AI systems with MCP (4. Juni 2026)
- Anthropic: How we contain Claude across products (25. Mai 2026)
Häufige Fragen
Was ist MCP Tool-Poisoning?
Tool-Poisoning ist ein Angriff auf die Beschreibung eines Tools, nicht auf seinen Code. Invariant Labs hat den Begriff am 1. April 2025 für eine Klasse geprägt, die sie als indirekte Prompt-Injection beschreiben: Die Beschreibung eines harmlosen Tools, etwa eines, das zwei Zahlen addiert, weist das Modell zugleich an, Dateien wie einen privaten SSH-Schlüssel zu lesen und deren Inhalte als Argument durchzureichen. Der Benutzer sieht einen Namen; das Modell sieht die Anweisungen und die Argumente.
Wie verhindere ich, dass ein MCP Server mich mit einem Rug Pull erwischt?
Pinne zwei Dinge: die Serverversion und einen Hash der kanonischen Tool-Liste, also der sortierten Namen, Beschreibungen und JSON-Schemata. Prüfe den Hash in jeder Sitzung vor dem ersten Tool-Aufruf, kanonisier vorher, damit eine Umsortierung nicht wie eine Änderung aussieht, und scheitere mit Fail closed, wenn sich die Liste nicht abrufen lässt. Bei einer Abweichung zeigst du dem Menschen einen Diff und pinnst erst nach seiner Zustimmung neu: Eine geänderte Beschreibung ist eine neue Definition, die freigegeben werden muss.
Was ändert die iss-Validierung aus RFC 9207 für MCP-Clients?
RFC 9207 erlaubt einem Authorization-Server anzugeben, welcher Issuer er ist, und verlangt vom Client, diesen Wert vor dem Einlösen eines Authorization-Codes mit dem aufgezeichneten Issuer zu vergleichen. Damit ist die Verwechslung geschlossen, bei der ein Angreifer einen Client auf den eigenen Server umleitet, um einen für den echten geminten Code einzulösen. Die MCP-Revision 2026-07-28 macht den iss-Parameter unter SEP-2468 verpflichtend und führt SEP-2352 ein, das Credentials nach Issuer ablegt, damit sie nie serverübergreifend wiederverwendet werden.
Was ist ein Client ID Metadata Document in MCP?
Es ersetzt die Dynamic Client Registration als bevorzugte Art, einen MCP-Client zu identifizieren. Statt sich zur Laufzeit zu registrieren und eine undurchsichtige Client-ID zu bekommen, ist die Client-ID eine HTTPS-URL, die auf ein JSON-Dokument zeigt, das mindestens client_id, client_name und redirect_uris enthält. Jeder kann dieses Dokument lesen, also kann ein Reviewer prüfen, was ein Client zu sein behauptet, bevor er ihn freigibt. Authorization-Server kündigen die Unterstützung mit client_id_metadata_document_supported an.
Wie soll ein MCP Server seine API-Tokens einschränken?
Gib jeder Tool-Familie ihre eigenen Credentials mit dem kleinsten Scope, der das Tool arbeiten lässt, und halte Read-only-Tools auf Read-only-Tokens. Ein Jira-Server, dessen Tools Suche, Kommentar und Transition sind, sollte nicht ein einziges Token halten, das alle drei kann. Akzeptiere nur Tokens, die für deinen Server gemintet wurden, prüfe die Audience und leite das eingehende Token nie nach upstream weiter. Schreibe den Satz, was das Schlimmste ist, was dieses Token tun kann, und teile jede Credential, deren Antwort zu breit ist.