Blog/Sicherheit & Compliance
DSGVO-LLM-Datenresidenz: Regionssteuerung, Zero Retention, EU-Optionen
DSGVO-LLM-Datenresidenz erklärt: was deine Server verlassen, Regionssteuerung bei First-Party- und Hyperscaler-APIs, Zero Data Retention und Minimierung.
Balázs Csorba··11 Min. Lesezeit
- GDPR
- Data residency
- LLM API
- Zero data retention
- PII minimisation
- EU hosting
Das Wichtigste in Kürze
- Vier Dinge überschreiten die Grenze zu einer Modell-API: der Prompt, die Anhänge, der Identitätskontext wie User- und Tenant-IDs und jede Telemetrie oder jeder Trace, den du anhängst.
- Seit September 2026 hat die First-Party-API von Claude keine EU-Inferenzregion: inference_geo nimmt nur "us" oder "global", und die Workspace-Geografie bietet nur "us". Die beste verfügbare Steuerung ist rein US-basierte Inferenz.
- Auf Amazon Bedrock und Google Cloud setzt stattdessen der Endpoint die Region; regionale Bedrock-Endpoints garantieren das Datenrouting für Claude Sonnet 4.5 und neuer, globale Endpoints routen dynamisch.
- Zero Data Retention gilt pro Organisation und pro Feature: die Files API, Batch-Jobs, Code-Execution-Container und einige Modelle sind ausgenommen, markierte Sessions können bis zu zwei Jahre aufbewahrt werden.
- Datenminimierung und Pseudonymisierung vor dem Prompt sind billiger und wirksamer als jede Regions-Einstellung, aber pseudonymisierte Daten bleiben nach Artikel 4(5) der DSGVO personenbezogene Daten.
DSGVO-LLM-Arbeit ist im Grunde Datenresidenz-Arbeit mit einem Modell in der Mitte. In dem Moment, in dem dein Server einen Prompt an ein gehostetes Modell schickt, haben personenbezogene Daten deine Datenbank verlassen, ein Netzwerk durchquert und sind auf einer Infrastruktur gelandet, die du nicht betreibst, unter einer Aufbewahrungsregel, die du nicht geschrieben hast. Seit September 2026 lautet die interessante Frage nicht mehr, ob das möglich ist – offensichtlich ist es –, sondern welche Wege die Verarbeitung tatsächlich innerhalb der Europäischen Union halten und was jeder davon dich an Aufbewahrung, Features und Debugging kostet.
Dieser Artikel geht die Grenze von innen nach außen durch: was genau sie überschreitet, warum die First-Party-API von Claude seit September 2026 keine EU-Region zum Aktivieren hat, wie die EU-Regionen der Hyperscaler zur praktischen Antwort geworden sind, was Zero Data Retention wirklich entfernt, wie du die Nutzlast vor dem Absenden verkleinern kannst, wann ein selbst betriebenes Modell mit offenen Gewichten die richtige Wahl ist, und eine Architektur, die du kopieren kannst. Aussagen über das Verhalten der Anbieter sind datiert und belegt; prüfe sie gegen deinen eigenen Vertrag, bevor du dich auf eine davon verlässt.
Was deine Server wirklich verlassen, wenn du eine Modell-API rufst
Vier Dinge reisen, und nur eines davon ist der Text, den du getippt hast. Der Prompt: dein System-Prompt, der Gesprächsverlauf, die abgerufenen Chunks, die Tool-Ergebnisse. Die Anhänge: hochgeladene Dateien, Bilder, PDFs und die Metadaten, die mit ihnen mitreisen. Der Identitätskontext: eine User-ID, eine Tenant-ID, eine Session-ID, eine Request-ID sowie das Konto oder den API-Key, mit dem du dich authentifizierst. Und die Telemetrie, an die du nicht gedacht hast: Request-Metadaten, Latenz- und Token-Zahlen, Fehler-Payloads sowie jeder Trace oder Span, den du für die Observability anhängst.
Der Fehlerfall ist meist nicht der Prompt. Es ist die userId, die du der Bequemlichkeit halber in den System-Prompt packst, der Trace, der den vollständigen Request-Body mitschreibt, und das abgerufene Dokumentfragment, das noch eine E-Mail-Adresse enthält, weil niemand sie vorgeschaltet geschwärzt hat. Der Anbieter sieht alles davon. Was danach passiert, hängt von zwei unabhängigen Einstellungen ab: wo die Inferenz läuft und wie lange etwas aufbewahrt wird.
First-Party-Regionssteuerung – und die EU-Option, die es nicht gibt
In der First-Party-Claude-API von Anthropic gibt es Regionssteuerung, und sie ist tatsächlich gut dokumentiert. Die Dokumentation zur Datenresidenz ist eindeutig: Der Request-Parameter inference_geo akzeptiert genau zwei Werte, "global", den Standard, bei dem die Inferenz in jeder verfügbaren Geografie laufen kann, für optimale Performance und Verfügbarkeit, und "us", bei dem die Inferenz ausschließlich in US-Infrastruktur läuft. Du kannst ihn pro Request oder als Workspace-Standard setzen, die erlaubten Werte mit allowed_inference_geos einschränken und im Feld usage.inference_geo der Antwort nachsehen, wo ein Aufruf gelandet ist. Auf den letzten Teil baust du einen Test.
Und hier kommt die Überraschung, die seit September 2026 das Nützlichste ist, was du wissen kannst, wenn du um EU-Datenresidenz herum planst: auf der First-Party-API gibt es keine EU-Inferenzregion. Die Workspace-Geografie – sie legt fest, wo Daten im Ruhezustand gespeichert werden und wo die Endpoint-Verarbeitung stattfindet –, wird beim Anlegen des Workspace gesetzt, lässt sich danach nicht ändern, und "us" ist derzeit der einzige verfügbare Wert. Die stärkste Steuerung, die die First-Party-API anbietet, ist also eine Wahl zwischen „irgendwohin“ und „in die USA“.
Aus derselben Seite folgen zwei kleinere Einschränkungen. inference_geo wird ab Claude 4.6 unterstützt; sendest du ihn mit einem älteren Modell, kommt ein 400 zurück. Und rein US-basierte Inferenz kostet 1.1× den Standardpreis, und zwar für Input-Token, Output-Token, Cache-Writes und Cache-Reads. Die Geografie festzupinnen ist nicht kostenlos, es ist nur billiger als die Alternative, nicht zu wissen, wohin deine Daten gegangen sind.
EU-Regionen der Hyperscaler sind der praktische Weg
Dieselben Modelle gibt es über Amazon Bedrock und Google Cloud, und dort wird die Geografie vom Endpoint gewählt, nicht von einem Parameter. Auf diesen Plattformen sagen die Docs, die Inferenzregion wird durch die Endpoint-URL oder das Inferenzprofil bestimmt, und inference_geo gilt nicht. Das dreht die Aufgabe um: Statt den Anbieter zu bitten, die Verarbeitung in einer Region zu halten, sprichst du einen regionalen Endpoint an, und die Region folgt.
Der Unterschied zwischen den Endpoint-Typen ist wichtig und wird leicht falsch verstanden. Die Übersicht der Modelle schreibt ihn aus: Amazon Bedrock bietet sowohl globale Endpoints, die dynamisch routen, als auch regionale Endpoints, die das Datenrouting garantieren, und diese Garantie gilt für Claude Sonnet 4.5 und neuer. Google Cloud bietet globale, multiregionale und regionale Endpoints. Ist EU-Datenresidenz eine Anforderung und keine Präferenz, bekommst du sie von einem globalen oder dynamisch gerouteten Endpoint nicht; von einem regionalen schon. Beachte außerdem, dass sich hier das Verhältnis zum Auftragsverarbeiter ändert – auf Bedrock und Google Cloud ist der Cloud-Anbieter der Auftragsverarbeiter, es gilt also dessen Dokumentation zu Aufbewahrung und Compliance, nicht die Richtlinie der First-Party-API.
| Weg | Regionssteuerung | Aufbewahrungssteuerung | Kosten oder Grenze |
|---|---|---|---|
| Claude, First-Party-API | inference_geo nimmt "us" oder "global"; Workspace-Geografie nur "us", also keine EU-Region | Zero Data Retention auf Anfrage, pro Organisation; einige Features und Modelle sind ausgenommen | Rein US-basierte Inferenz kostet 1.1× den Standardpreis |
| Claude über Amazon Bedrock oder Google Cloud | Wird vom Endpoint gesetzt; regionale Bedrock-Endpoints garantieren das Routing für Sonnet 4.5 und neuer | Der Cloud-Anbieter ist der Auftragsverarbeiter; lies dessen Dokumentation zur Aufbewahrung | Regionale Preise des Partners; inference_geo gilt nicht |
| OpenAI API Platform | Europa wählbar beim Anlegen eines neuen Project; bestehende Projects lassen sich nicht aktualisieren | Zero Data Retention für Requests über EU-konfigurierte Projects | Nur berechtigte Endpoints und nur neue Projects |
| Selbst betriebenes Modell mit offenen Gewichten | Wo du es betreibst, also dort, wo du die GPUs mietest | Deine, durchgängig | Kapazität, Patches und Evaluation sind dein Problem |
Bei OpenAI beschreibt die Ankündigung zur Datenresidenz in Europa vom 5. Februar 2025, seither mehrfach aktualisiert, wie API-Kunden für berechtigte Endpoints eine Verarbeitung in Europa wählen: Sie legen ein neues Project im Dashboard der API Platform an und wählen Europa als Region. Requests über diese Projects werden in der Region verarbeitet, mit Zero Data Retention, das heißt, Modell-Requests und Antworten werden nicht im Ruhezustand gespeichert. Zwei Einschränkungen nennt dieselbe Seite: Die europäische Residenz lässt sich nur für neue Projects konfigurieren, und sie gilt für berechtigte Endpoints, also prüfe deine eigene Endpoint-Liste, bevor du darauf aufbaust. OpenAI schreibt außerdem, dass Modelle standardmäßig nicht auf Kundendaten trainiert werden, sofern sich ein Kunde nicht ausdrücklich dafür entscheidet, dass Daten im Ruhezustand mit AES-256 und bei der Übertragung mit TLS 1.2 oder höher verschlüsselt werden, und dass es einen Auftragsverarbeitungsvertrag für die Rollen und Pflichten nach der DSGVO gibt.
Zero Data Retention und was es dich beim Debugging kostet
Zero Data Retention ist die am häufigsten missverstandene Steuerung in diesem Bereich, weil Anbieter sie als „wir speichern deine Daten nicht“ beschreiben, obwohl sie etwas Engeres meinen. In der Claude API sagt die Dokumentation zur Aufbewahrung, ZDR bedeutet, dass Prompts und Antworten nach der Rückgabe der Antwort nicht im Ruhezustand gespeichert werden. Sie wird pro Organisation auf Anfrage aktiviert, jede Organisation braucht eine eigene Aktivierung, und es gibt eine Tabelle zur Eignung von Features, die sagt, welche Endpoints und Features sie tatsächlich abdeckt.
In dieser Tabelle zeigt sich der Engineering-Aufwand. Features, die von Nature aus zustandsbehaftet sind, kommen für ZDR nicht infrage: Die Files API behält Dateien, bis du sie löschst, die Batch-Verarbeitung behält Jobs 29 Tage, der Code-Execution-Container behält Daten bis zu 30 Tage, und Managed-Agents-Transkripte bleiben, bis du sie löschst. Manche sind eher „bedingt“ als sauber – strukturierte Ausgaben cachen dein JSON-Schema bis zu 24 Stunden, und Prompt-Caching hält Cache-Darstellungen für die Cache-TTL im Speicher. Prompt-Caching ist der interessante Fall für die Kostenarbeit, mehr dazu steht in Caching, Routing und Batching. Einige Modelle sind vollständig ausgenommen: die ausgewiesenen Covered Models verlangen eine 30-tägige Aufbewahrung und sind unter ZDR nicht verfügbar, sofern Anthropic es nicht genehmigt.
Zwei Folgen beißen. Erstens wird Debugging genau dann schwerer, wenn du es am nötigsten brauchst. Wenn du ein Gespräch nicht beim Anbieter nachspielen kannst, ist dein eigener Speicher der einzige Nachweis, du musst also selbst eine geschwärzte, minimierte Kopie aufbewahren – und du musst wissen, dass das eine bewusste Entscheidung ist, keine Nebenwirkung. Zweitens ist ZDR nicht absolut: Wo das Gesetz es verlangt, kann weiterhin aufbewahrt werden, und eine Session, die automatisierte Trust-and-Safety-Systeme markieren, kann mit ihren Ein- und Ausgaben bis zu zwei Jahre aufbewahrt werden. Lies den Abschnitt zur Aufbewahrung mit Ausnahme der Vereinbarung, bevor du jemandem versprichst, dass nichts aufbewahrt wird.
Minimieren und Pseudonymisieren vor dem Prompt
Die billigste Datenschutzmaßnahme ist keine Regions-Einstellung; es ist, die Daten nicht zu senden. Artikel 5(1)(c) der DSGVO formuliert die Datenminimierung als personenbezogene Daten, die „zweckmäßig, relevant und auf das beschränkt sein müssen, was im Hinblick auf die Zwecke, für die sie verarbeitet werden, erforderlich ist“, und dieser Grundsatz gilt für den Prompt genauso wie für die Spalte in der Datenbank. Muss das Modell wissen, dass eine Bestellung verspätet ist, schicke den Bestellstatus, nicht Name, Adresse und Bestellhistorie des Kunden.
Pseudonymisierung ist der zweite Hebel, und sie verlangt Sorgfalt. Artikel 4(5) der DSGVO definiert sie als eine Verarbeitung, bei der personenbezogene Daten einer bestimmten betroffenen Person nicht mehr ohne Verwendung zusätzlicher Informationen zugeordnet werden können, vorausgesetzt, diese zusätzlichen Informationen werden getrennt gespeichert und unterliegen nicht technischen und organisatorischen Maßnahmen, die vernünftigerweise zur Re-Identifizierung verwendet werden könnten. Das ist Pseudonymisierung, keine Anonymisierung: Die Daten bleiben personenbezogene Daten nach der DSGVO, sie lassen sich nur nicht ohne eine Zuordnung lesen, die du kontrollierst. Nur wirklich anonymisierte Daten fallen aus der Verordnung heraus, und diese Hürde erreichen die meisten Prompts nicht.
// Illustrative pattern: resolve identifiers before the prompt, never in it
// PSEUDONYM_KEY comes from the environment, never from a file in the repo.
function buildPrompt(order) {
  const subjectRef = hmac(order.customerId, process.env.PSEUDONYM_KEY)
  return [
    `Customer ${subjectRef}: order ${order.id} is ${order.status}.`,
    `Ship to ${order.region}, carrier ${order.carrier}, ETA ${order.eta}.`,
  ].join('\n')
}
// The mapping subjectRef → customerId lives in your EU store, not in the prompt.
Zwei praktische Gewohnheiten machen den Unterschied. Ersetze stabile Kennungen im Prompt durch einen geschlüsselten Verweis, den du serverseitig auflösen kannst, und halte den Schlüssel in deinem eigenen Speicher – das ist Pseudonymisierung, und der Prompt ist dann kein Nachweis einer namentlich genannten Person mehr. Und entferne den Request-Body aus deinen eigenen Traces: Logge einen Hash des Prompts, dessen Token-Zahl und das Modell, nicht den Prompt-Text, sofern du keinen konkreten Grund und keine Aufbewahrungsfrist hast. Beides ist billig. Es hinterher nachzuholen ist es nicht.
Wann ein selbst betriebenes Modell mit offenen Gewichten in der EU die richtige Wahl ist
Self-Hosting ist die einzige Option auf der Liste, bei der die Antworten auf Region und Aufbewahrung lauten: „wo wir sagen“. Wenn die Daten unter keiner Konfiguration EU-Infrastruktur verlassen dürfen, oder die Last stabil genug ist, um GPUs abzuschreiben, beseitigt der Betrieb eines Modells mit offenen Gewichten auf gemieteter EU-Infrastruktur die ganze Anbieterfrage. Es gibt keine grenzüberschreitende Inferenzoption, die man prüfen müsste, weil es keine Gegenpartei gibt.
Du übernimmst die volle betriebliche Last: Kapazitätsplanung und Reserve für Spitzenlast, gepatchte Runtime und gepatchte Gewichte, die GPU-Kosten pro Token gegen den Preis einer gehosteten API, und – der Teil, den Teams unterschätzen – die Evaluationsarbeit, weil die Qualität jetzt von deiner Auslieferungskonfiguration abhängt und nicht von einer Versionsnummer, die jemand anderes ausliefert. Wenn du bereits Regressionsevals in der CI fährst, hast du den Harness für diesen letzten Teil.
Meine Regel: Betreibe eng umrissene, hochvolumige, wenig mehrdeutige Aufgaben selbst – Klassifikation, Routing, Extraktion, Zusammenfassung von Material, das du bereits minimiert hast –, und behalte ein Frontier-Modell für die Requests, bei denen Qualität tatsächlich das Produkt ist. Die Grenze ist eine Routing-Entscheidung, sie gehört also in Code, wo du sie messen kannst, und nicht auf eine Wiki-Seite.
Eine Architekturvorlage, die du kopieren kannst
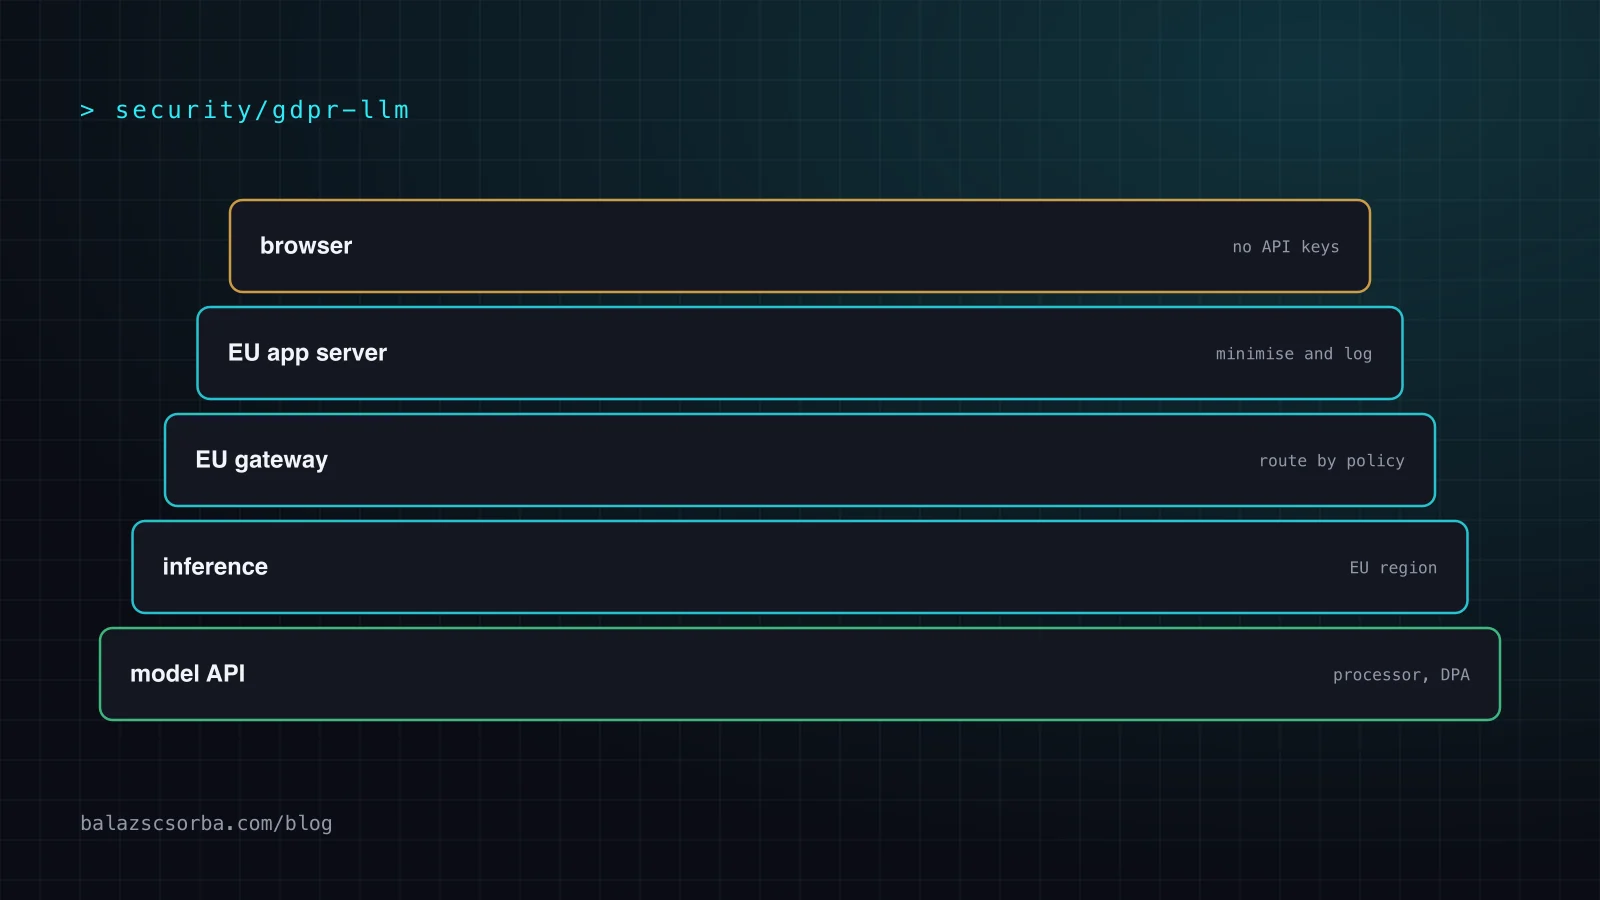
Das Design, das weiter trägt, während sich die Anbieter ändern, ist ein Gateway zwischen deiner Anwendung und jedem Modell, mit der Richtlinie an einer Stelle. Der Anwendungscode hält nie einen Anbieter-Key und entscheidet nie, wohin Daten gehen; er ruft deinen eigenen Endpoint, und das Gateway klassifiziert den Request, wendet die Minimierungsregeln an, wählt eine Route und protokolliert, was es getan hat.
Vier Eigenschaften lassen das Gateway tragen. Die Credentials des Anbieters liegen nur im Gateway, der Browser hält also nie einen Key, und ein geleaktes Frontend-Bundle leakt nichts. Die Route wird aus einer Richtlinie gewählt, nicht aus einer Voreinstellung; „nur EU“ ist also eine Konfigurationsänderung mit einem Test dahinter. Jeder Request erzeugt einen Audit-Eintrag – Route, Modell, Region, Token-Zahl, Prompt-Hash –, und nur dieser Eintrag muss aufbewahrt werden. Und der Minimierungsschritt liegt vor dem Aufruf beim Anbieter, sodass die Regeln gelten, egal welche Route gewinnt.
Dasselbe Denken in Vertrauenszonen taucht überall dort auf, wo ein Agent Daten erreichen kann: Eine Allowlist erlaubter Ziele, nicht eine Blockliste verbotener, macht die Grenze wirklich. Ich habe dieses Muster in Coding-Agenten in der CI sandboxen beschrieben, und das Gateway hier ist dieselbe Idee mit einem Modellanbieter auf der anderen Seite. Wenn du eines für deinen Stack gebaut haben willst, ist das die Art Arbeit, die ich als KI-Engineer mache.
Quellen
- Claude API-Dokumentation: Data residency (inference_geo, workspace geo, pricing)
- Claude API-Dokumentation: API and data retention (Umfang und Eignung von Zero Data Retention)
- Claude API-Dokumentation: Models overview (Plattform-Modell-IDs, Endpoint-Typen)
- OpenAI: Introducing data residency in Europe
- Regulation (EU) 2016/679 (General Data Protection Regulation) – EUR-Lex
Häufige Fragen
Hat Claude eine EU-Datenresidenz-Option?
Seit September 2026 nicht auf der First-Party-API. Der Request-Parameter inference_geo akzeptiert nur "global", bei dem die Inferenz in jeder verfügbaren Geografie laufen kann, und "us", bei dem sie ausschließlich in US-Infrastruktur läuft. Die Workspace-Geografie, die die Speicherung im Ruhezustand steuert, bietet nur "us" und lässt sich nach dem Anlegen des Workspace nicht mehr ändern. Dieselben Modelle erreichen EU-Regionen über Amazon Bedrock oder Google Cloud, wo der Endpoint, den du ansprichst, die Region bestimmt.
Was ist der Unterschied zwischen Datenresidenz und Zero Data Retention?
Das sind zwei unabhängige Schalter. Die Datenresidenz beantwortet, wo verarbeitet wird; Zero Data Retention beantwortet, ob nach der Rückgabe der Antwort noch etwas gespeichert wird. Ein Anbieter kann das eine ohne das andere anbieten. In der Claude API ist rein US-basierte Inferenz als Residenzsteuerung verfügbar, solange keine EU-Region existiert, und Zero Data Retention wird pro Organisation aktiviert, schließt aber zustandsbehaftete Features wie die Files API, die Batch-Verarbeitung und Code-Execution-Container aus.
Erfüllt es die DSGVO, wenn ich die Daten vor dem Senden an ein LLM pseudonymisiere?
Nein, und die Unterscheidung ist wichtig. Artikel 4(5) definiert Pseudonymisierung als eine Verarbeitung, bei der die Daten einer betroffenen Person nicht mehr ohne separat gespeicherte zusätzliche Informationen zugeordnet werden können. So behandelte Daten bleiben personenbezogene Daten, und die DSGVO gilt weiterhin für sie: Du behältst deine Rechtsgrundlage, deine Auftragsverarbeitungsverträge und deine Aufbewahrungsregeln. Nur wirklich anonymisierte Daten, und das ist eine weit höhere Hürde, fallen aus der Verordnung heraus.
Ist die EU-Datenresidenz von OpenAI für bestehende API-Projekte verfügbar?
Nein, laut der Ankündigung von OpenAI. Die europäische Datenresidenz wird aktiviert, indem du ein neues Project im Dashboard der API Platform anlegst und Europa als Region wählst, und die Ankündigung sagt, dass sie nur für neue Projects konfiguriert werden kann, weil bestehende nach der Erstellung nicht aktualisierbar sind. Requests über diese Projects werden in der Region mit Zero Data Retention verarbeitet, und die Ankündigung gilt für berechtigte Endpoints, prüfe also deine eigene Endpoint-Liste, bevor du darauf aufbaust.
Wann sollte ein Team ein Modell mit offenen Gewichten selbst betreiben statt eine API zu rufen?
Betreibe es selbst, wenn die Daten unter jeder Konfiguration innerhalb der EU-Infrastruktur bleiben müssen, oder wenn die Last stabil genug ist, um GPUs abzuschreiben. Danach sind Kapazitätsplanung, gepatchte Runtime und Gewichte, GPU-Kosten pro Token und die Evaluationsarbeit deine, weil die Qualität jetzt von deiner Auslieferungskonfiguration abhängt. Üblich ist die Aufteilung, eng umrissene, hochvolumige Aufgaben wie Klassifikation, Routing und Extraktion selbst zu betreiben und ein Frontier-Modell für die Requests zu behalten, bei denen Qualität das Produkt ist.