Blog/RAG & Retrieval
RAG im Jahr 2026: hybrides Retrieval, agentisches Suchen oder Long Context?
RAG 2026: wann ein gecachter 1M-Token-Kontext das Retrieval schlägt, wann hybride Suche gewinnt, wann agentisches Suchen passt und was es pro Anfrage kostet.
Balázs Csorba··8 Min. Lesezeit
- RAG
- Long context
- Agentic search
- Hybrid search
- Contextual retrieval
Das Wichtigste in Kürze
- RAG im Jahr 2026 heißt, sich zwischen einem gecachten Long Context, hybridem Retrieval und agentischem Suchen zu entscheiden; jeder Weg gewinnt in einer anderen Situation.
- Anthropics Empfehlung: Bei einer Wissensbasis unter 200,000 Tokens (rund 500 Seiten) das Ganze mit Caching in den Prompt aufnehmen.
- Ein 200,000-Token-Präfix auf Claude Opus 5.5 kostet nach den Listenpreisen von September 2026 $0.80 ungecacht und $0.04 als Cache-Read.
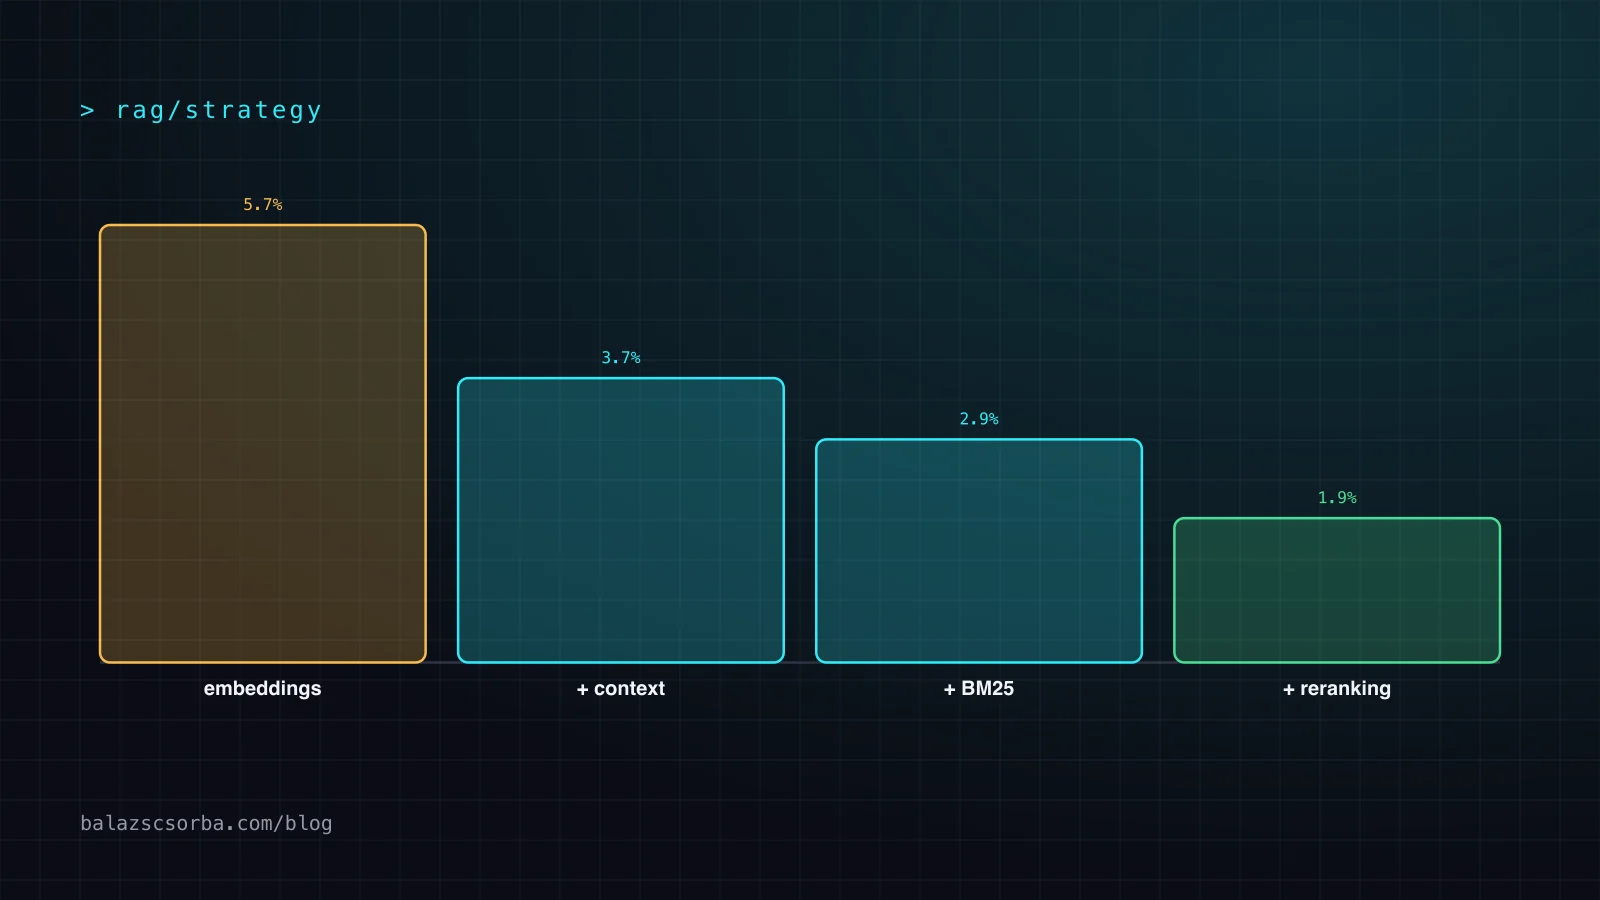
- Kontextuelle Embeddings, BM25 und Reranking senken Anthropics Top-20-Retrieval-Fehlerrate von 5.7% auf 1.9%.
- Agentisches Suchen passt zu ständig wechselnden, strukturierten Korpora wie Codebasen, kostet aber pro Frage mehr Tokens und mehr Latenz.
RAG im Jahr 2026 ist nicht mehr eine Architektur. Retrieval-Augmented Generation bedeutet heute, sich zwischen drei Wegen zu entscheiden, einem Modell eigenes Wissen zu geben: alles in ein Kontextfenster packen, das eine Million Tokens fasst, die richtigen Chunks mit einer hybriden Suchpipeline abrufen oder einen Agenten mit Tools iterativ suchen lassen. Jeder Weg gewinnt in einer anderen Situation, und die falsche Wahl kostet bei jeder Anfrage entweder Genauigkeit oder Geld.
Das ist der Strategie-Teil: wann welcher Ansatz passt, was er pro Anfrage kostet, wo er versagt und wie man die Wahl bewertet. Zur Umsetzung selbst (Parsing, Chunking, BM25, Reciprocal Rank Fusion, Reranking, Quellenangaben) siehe eine RAG-Pipeline in Produktion, Schritt für Schritt.
Was sind die drei Wege, einem LLM eigenes Wissen zu geben?
Die drei Optionen sind Long Context (alles mitsenden), Retrieval (die besten Chunks aus einem Index senden) und agentisches Suchen (das Modell so lange Suchtools aufrufen lassen, bis es genug hat). Sie unterscheiden sich darin, wer entscheidet, was das Modell liest: niemand, eine Ranking-Funktion oder das Modell selbst.
- Long Context. Die gesamte Wissensbasis geht in den Prompt, meist hinter einem Prompt-Cache. Kein Index, kein Chunking, keine Retrieval-Fehler. Stand September 2026 haben die aktuellen Claude-Modelle (Opus 5.5, Sonnet 5, Fable 5.1) ein Kontextfenster von 1M Tokens.
- Hybrides Retrieval. Dokumente werden im Voraus gechunkt und indiziert; jede Frage läuft durch BM25 und Vektorsuche, die Ergebnisse werden fusioniert und rerankt, und die besten Chunks gehen an das Modell. Eine Retrieval-Runde pro Frage.
- Agentisches Suchen. Das Modell bekommt Tools wie grep, Datei-Reads, eine Search-API oder einen SQL-Endpunkt und entscheidet anhand seiner Funde, was es als Nächstes nachschlägt. Mehrere Runden pro Frage.
Wann schlägt ein Kontext mit 1M Tokens das RAG?
Ein Long Context schlägt Retrieval, wenn die gesamte Wissensbasis bequem hineinpasst und sich selten ändert. Anthropic sagt selbst: unter 200.000 Tokens, rund 500 Seiten, kannst du „einfach die gesamte Wissensbasis“ in den Prompt aufnehmen.
Das Preisargument hat sich geändert. Stand September 2026 rechnen Claude 4.6 und neuere Modelle das volle 1M-Token-Fenster zu regulären Tarifen ab; die Preisseite formuliert es so: „eine 900k-token request wird zum gleichen Token-Preis abgerechnet wie eine 9k-token request“. Ein bisschen Rechnen mit den Listenpreisen: ein 200.000-Token-Präfix auf Claude Opus 5.5 ($4 pro Million Input-Tokens) kostet $0.80 pro ungecachte Anfrage und $0.04, wenn es mit $0.20 pro Million aus dem Prompt-Cache gelesen wird. Auf Sonnet 5 ($2 Input, $0.20 Cache-Reads) kostet der Cache-Read ebenfalls $0.04. Zu diesem Preis ist es eine ernsthafte Option, auf den Retrieval-Stack zu verzichten.
Das Genauigkeitsargument hat nicht ganz aufgeholt. Chromas Studie Context Rot (Juli 2025, 18 Modelle) fand, dass „Modelle nutzen ihren Kontext nicht gleichmäßig; stattdessen wird ihre Leistung immer unzuverlässiger, je länger die Eingabe“, und dass es schneller abfällt, wenn Frage und Antwort wenige gemeinsame Wörter haben. Das ältere Ergebnis „Lost in the Middle“ zeigt in dieselbe Richtung: Informationen in der Mitte eines langen Kontexts werden schlechter genutzt als Informationen am Anfang oder am Ende. Ein Long Context beseitigt also Retrieval-Fehler, fügt aber Ablenkung hinzu. Am besten funktioniert er bei breit gefassten Fragen („fasse unsere Rückgaberichtlinie über diese Dokumente zusammen“) und am schlechtesten bei nadelartigen Suchen in großen, redundanten Korpora.
Warum ist hybrides Retrieval bei großen Korpora immer noch der Default?
Sobald ein Korpus weit über das hinausgeht, was in den Kontext passt, oder Fragen präzise Nachschläge brauchen, bleibt Retrieval die zuverlässigste und günstigste Option. Das stärkste veröffentlichte Rezept kombiniert kontextuelle Chunks, BM25 plus Embeddings und einen Reranker.
Anthropics Beitrag Contextual Retrieval hat gemessen, was jede Schicht an der Top-20-Retrieval-Fehlerrate ausmacht. Ein kurzer, vom Modell geschriebener Kontext, der jedem Chunk vor dem Embedding vorangestellt wird („contextual embeddings“), senkte sie von 5.7% auf 3.7%. Kontextuelles BM25 brachte sie auf 2.9%, ein Reranker auf 1.9% – insgesamt eine Senkung um 67%. Die einmaligen Vorverarbeitungskosten lagen bei rund $1.02 pro Million Dokument-Tokens mit Prompt-Caching.
Zwei Dinge machen das zum Default. Erstens sind die Kosten pro Frage klein und konstant: ein Embedding-Call, zwei Index-Lookups, ein Rerank und ein Prompt von ein paar tausend Tokens. Zweitens ist der Retrieval-Schritt nachvollziehbar. Du kannst loggen, welche Chunks zurückkamen, Recall gegen gelabelte Fragen berechnen und Berechtigungen in der Query durchsetzen. Für einen Prompt mit einer Million Tokens gilt beides nicht.
Was ist agentisches Suchen, und wann schlägt es Vektoren?
Agentisches Suchen gibt dem Modell Suchtools und lässt es iterieren: fragen, lesen, verfeinern, nochmal fragen. Es schlägt einen Vektorindex, wenn sich der Korpus ständig ändert, eine starke Struktur hat (Pfade, Identifier, Schemata) und die Frage mehrere Sprünge braucht.
Coding-Agenten sind der klarste Fall. Eine Community-Beschreibung des agentischen Suchmusters zitiert Anthropics Cat Wu zu Claude Code: „Wir haben anfangs durchaus Vektor-Embeddings verwendet. Die sind wirklich mühsam zu pflegen, weil man sie fortlaufend neu indexieren muss… Claude ist wirklich gut im agentischen Suchen.“ Eine Codebasis ändert sich mit jedem Commit, Identifier sind exakte Strings, die grep zuverlässig findet, und der Agent kann einem Import von Datei zu Datei folgen. Ein Index wäre immer leicht veraltet, auch was noch nicht committet ist.
Dieselbe Beschreibung listet die Kosten ehrlich auf: mehr Tokens über die Iterationen, höhere Latenz bei komplexen Fragen, schwächeres semantisches Matching („authentication“ gegen „login“) und die Notwendigkeit leistungsfähiger Modelle. Agentisches Suchen verlagert außerdem die Abbruchentscheidung zum Modell, es braucht also ein Budget; die Mechanik steht in die Agentenschleife, erklärt. Ein pragmatischer Mittelweg: dem Agenten ein hybrides Suchtool als eines seiner Tools geben. Dann bekommt er semantischen Recall, wenn er ihn braucht, und sonst exakte Treffer.
Wie verhalten sich Kosten und Latenz über die drei Ansätze?
Retrieval hat die niedrigsten und planbarsten Kosten pro Frage; Long Context ist nur so lange günstig, wie der Cache warm ist; agentisches Suchen kostet am meisten und schwankt am stärksten. Die Tabelle ist qualitativ, außer wo ein Preis genannt wird.
| Kriterium | Long Context | Hybrides Retrieval | Agentisches Suchen |
|---|---|---|---|
| Aufwand beim Aufbau | Am geringsten | Am höchsten: Parsing, Index, Evals | Mittel: Tools und Budgets |
| Input-Tokens pro Frage | Gesamter Korpus (z. B. 200K: $0.04 gecacht, $0.80 ungecacht auf Opus 5.5) | Ein paar tausend | Wächst mit jeder Runde |
| Latenz | Niedrig bei warmem Cache, hoch bei kaltem | Niedrig: eine Retrieval-Runde | Am höchsten: mehrere Modell- und Tool-Aufrufe |
| Aktualität | Prompt neu bauen, Cache neu schreiben | Geänderte Dokumente neu indizieren | Immer aktuell |
| Berechtigungen | Ein Prompt pro Zugriffsstufe | Filter in der Query | Werden von den Tools durchgesetzt |
| Typischer Fehler | Ablenkung, in der Mitte übersehene Details | Relevanter Chunk nicht abgerufen | Hört zu früh auf oder läuft in eine Schleife |
Prompt-Caching macht die Long-Context-Spalte überhaupt erst brauchbar, und seine Details (5-Minuten- gegen 1-Stunden-Cache, was ihn invalidiert) entscheiden über die echte Rechnung. Das steht in LLM-Kosten und Latenz mit Caching, Routing und Batching senken.
Abwägung: wo jeder Ansatz versagt
Jede Option hat eine Fehlerart, die die anderen vermeiden. Gut zu wählen heißt zu wissen, welchen Fehler deine Nutzer zuerst bemerken würden.
- Long Context scheitert an Größe, Berechtigungen und Präzision. Er hört auf zu funktionieren, wenn der Korpus über das Fenster hinauswächst, er kann Nutzer mit unterschiedlichen Zugriffsrechten nicht aus einem gecachten Prompt bedienen, und nadelartige Fragen leiden unter Context Rot.
- Hybrides Retrieval versagt still. Ist der richtige Chunk nicht in den Top k, antwortet das Modell aus den falschen – und klingt genauso selbstsicher. Nur eine Retrieval-Metrik fängt das ab.
- Agentisches Suchen scheitert an Kosten und Abbruch. Die Tokens wachsen mit jeder Runde, und das Modell kann nach dem ersten plausiblen Treffer aufhören oder weitersuchen, obwohl es die Antwort schon hat.
- Keine davon kann aggregieren. „Wie viele Bestellungen wurden im letzten Quartal verspätet versandt“ ist eine SQL-Abfrage. Gib dem Modell ein Query-Tool statt Dokumenten.
Wie bewertest du die Wahl?
Bewerte das Retrieval getrennt von der Generierung, und zwar mit demselben gelabelten Fragenkatalog für jede Option. Wenn du nur Endantworten bewertest, kannst du einen Retrieval-Fehler nicht von einem Generierungsfehler unterscheiden.
Sammle ein paar Dutzend echte Fragen, labelle die Passagen, die sie beantworten, und nimm auch Fragen ohne Antwort auf. Für das Retrieval misst du recall@k (Anthropics Fehlerrate ist 1 minus recall@20). Für Long Context, wo es keinen Retrieval-Schritt gibt, prüfst du, ob die Antwort die richtige Passage zitiert. Für agentisches Suchen loggst du die Tool-Aufrufe und misst, ob überhaupt die richtige Datei oder Zeile gelesen wurde, dazu die Anzahl der Runden und der Tokens. Dann bewertest du die Antworten mit einem validierten Grader. Wie man Grader baut und validiert, steht in Evals für LLM-Produktfeatures.
Eine Entscheidungscheckliste
- Zähle deinen Korpus in Tokens mit dem Tokenizer des Anbieters, nicht in Seiten oder Wörter.
- Unter ~200K Tokens und stabil: Probiere zuerst Long Context mit Prompt-Caching und miss die Antwortqualität.
- Verschiedene Nutzer sehen verschiedene Dokumente: Nimm Retrieval mit Berechtigungsfiltern in der Query.
- Großer oder wachsender Korpus: hybrides Retrieval mit kontextuellen Chunks, BM25 plus Vektoren und einem Reranker.
- Code oder strukturierte Dateien, die sich ständig ändern: agentisches Suchen mit grep, Reads und einem Runden-Budget.
- Zähl- und Aggregationsfragen: Gib dem Modell ein SQL- oder API-Tool, keine Dokumente.
- Logge für jede Antwort, was das Modell gelesen hat: Chunk-IDs, Dateien oder die Version des Cache-Präfixes.
- Bewerte Retrieval und Antworten getrennt an einem gelabelten Fragenkatalog – vor und nach jeder Änderung.
Wenn du für ein Produkt zwischen diesen Optionen wählst und das durchsprechen willst, findest du mehr unter KI-Engineering.
Quellen
- Anthropic: Introducing Contextual Retrieval (2024)
- Chroma: Context Rot – How Increasing Input Tokens Impacts LLM Performance (2025)
- Liu et al., Lost in the Middle: How Language Models Use Long Contexts (2023)
- Claude docs: Pricing (Long Context, Prompt-Caching, Tokenizer)
- Claude docs: Models overview
- Awesome Agentic Patterns: Agentic search over vector embeddings
Häufige Fragen
Braucht man RAG noch, wenn Modelle Kontextfenster von 1M Tokens haben?
Oft ja. Long Context funktioniert gut bei kleinen, stabilen Wissensbeständen, und Anthropic empfiehlt, alles unter etwa 200,000 Tokens mitzuschicken. Aber die Leistung wird mit wachsender Eingabe unzuverlässiger (Chromas Context-Rot-Studie), ein gecachter Prompt kann keine Nutzer mit unterschiedlichen Berechtigungen bedienen, und große Korpora sprengen trotzdem das Fenster. Retrieval bleibt im großen Maßstab die günstigere und nachvollziehbarere Option.
Was ist der Unterschied zwischen agentischem RAG und klassischem RAG?
Klassisches RAG führt pro Frage einen Retrieval-Schritt aus: Index durchsuchen, die besten Chunks nehmen, generieren. Agentisches RAG gibt dem Modell Suchtools und lässt es über mehrere Runden selbst entscheiden, was es als Nächstes nachschlägt, bis es genug hat. Es kommt besser mit Fragen über mehrere Sprünge und mit sich ändernden Korpora zurecht, verbraucht aber mehr Tokens, addiert Latenz und braucht ein Runden-Budget.
Was kostet es, eine gesamte Wissensbasis in den Prompt zu packen?
Zu den Claude-Listenpreisen von September 2026 kostet ein 200,000-Token-Prompt auf Opus 5.5 ($4 pro Million Input-Tokens) $0.80 pro ungecachte Anfrage und $0.04, wenn er aus dem Prompt-Cache gelesen wird ($0.20 pro Million). Claude 4.6 und neuere Modelle rechnen das volle 1M-Fenster zu regulären Tarifen ab. Die erste Anfrage zahlt einen Cache-Write-Aufschlag von 1.25x für den 5-Minuten-Cache.
Warum nutzen Coding-Agenten grep statt Vektorsuche?
Codebasen ändern sich mit jedem Commit, ein Vektorindex ist also immer leicht veraltet, und Identifier sind exakte Strings, die grep zuverlässig findet. Anthropics Cat Wu hat gesagt, Claude Code habe anfangs Embeddings benutzt, die aber schwer aktuell zu halten waren, während agentisches Suchen gut funktionierte. Der Preis sind schwächere Treffer bei Synonymen und mehr Tokens pro Frage.