Blog/Retrieval & Suche
RAG-Index aktuell halten: inkrementelles Indexieren, CDC und Blue/Green-Neueinbettung
RAG-Index aktuell halten: Aktualitätsbudget, Änderungserkennung, CDC aus Postgres mit Debezium, Löschungen, Rechte, Blue/Green-Wechsel und Kosten.
Balázs Csorba··aktualisiert ·8 Min. Lesezeit
- RAG
- Change data capture
- PostgreSQL
- Vector databases
- Data freshness
Das Wichtigste in Kürze
- Geben Sie jeder Quelle ein Aktualitätsbudget in Minuten und messen Sie die Verzögerung dagegen; „irgendwann konsistent“ ist keine testbare Anforderung.
- Wasserstandsmarken und Inhalts-Hashes reichen für viele Quellen; CDC aus Postgres per Logical Decoding und Debezium ist für Quellen, bei denen Minuten zählen, und seine Replikationsslots müssen überwacht werden.
- Löschungen und Rechteänderungen sind die Deltas, die Indexer übersehen: Azure AI Search dokumentiert, dass Indexer Löschungen nicht verfolgen, und eine DSGVO-Löschung muss unverzüglich erfolgen.
- Neueinbettung bei einem Modellwechsel gehört in eine neue Collection hinter einem Alias, umgeschaltet mit einem API-Aufruf und für den Rückweg behalten; in pgvector Indizes nebenläufig aufbauen.
- Die Tokens sind der billige Teil: 100 Millionen Tokens neu einzubetten kostet bei $0,02 pro Million etwa $2; Engineering, Nachladezeit und Korrektheit sind die eigentlichen Kosten.
Inkrementelles Indexieren für RAG ist die Schicht, die den Index nach dem ersten Crawl richtig hält: Neue Dokumente werden gechunkt und eingebettet, geänderte ersetzt, gelöschte verschwinden, und Rechteänderungen erreichen den Index, bevor jemand ein Dokument sieht, das er nicht sehen darf. Die meisten RAG-Prototypen lassen sie weg, weil die erste Demo einen statischen Ordner nutzt. Produktive Korpora ändern sich den ganzen Tag, und ein Assistent, der die Preisliste der Vorwoche oder eine zurückgezogene Richtlinie zitiert, ist schlechter als einer, der sagt, dass er es nicht weiß.
Dieser Artikel behandelt ein Aktualitätsbudget, Änderungserkennung mit Wasserstandsmarken und Hashes, Change Data Capture aus Postgres, Löschungen und Rechteänderungen, vollständiges Neuindexieren mit Blue/Green-Wechsel, die Kosten der Neueinbettung und wann CDC übertrieben ist. Chunking, Suche und Reranking behandelt RAG-Pipelines: Chunking, hybride Suche und Reranking; Versionen und Preise gelten Stand Oktober 2026.
Was aktuell heißt: ein Aktualitätsbudget
Aktuell heißt eine gemessene Zahl pro Quelle, kein Gefühl. Legen Sie für jede Quelle fest, wie viele Minuten eine Änderung bis in den Index brauchen darf: vielleicht fünf für Lagerbestände, eine Stunde für Produktbeschreibungen, einen Tag für archivierte Handbücher und sofort für entzogene Zugriffe. Kein Standard schreibt diese Zahlen vor; sie folgen daraus, was eine falsche Antwort kostet. Messen Sie dann die tatsächliche Verzögerung vom Commit in der Quelle bis zum Schreiben im Index und alarmieren Sie, wenn sie das Budget überschreitet.
Das Budget zeigt auch, welchen Mechanismus Sie brauchen. Ein Tagesbudget erfüllt ein nächtlicher Abgleich; ein Fünf-Minuten-Budget braucht einen häufigen Scan oder Ereignisse; ein Budget von Sekunden für Rechte bedeutet meist, den Zugriff zur Anfragezeit und im Index zu prüfen. Eine Aufteilung des Index hilft hier. In Katalogen auf Spryker- und Pimcore-Basis ändern sich Preis und Bestand den ganzen Tag, lange Beschreibungen selten, flüchtige skalare Felder lassen sich also als Metadaten aktualisieren, ohne den Text daneben neu einzubetten.
Änderungserkennung mit Wasserstandsmarken und Hashes
Die meisten Quellen brauchen kein Datenbanklog, nur eine verlässliche Art zu finden, was sich seit dem letzten Lauf geändert hat. Eine Wasserstandsmarke ist das klassische Muster: den größten verarbeiteten updated_at-Wert merken und beim nächsten Mal die Zeilen darüber holen. Azure AI Search benennt dies als wiederverwendbare Richtlinie zur Änderungserkennung, und seine geplanten Indexer laufen zwischen alle 5 Minuten und alle 24 Stunden (Azure AI Search). Nutzen Sie eine monoton steigende Spalte, halten Sie ein kleines Überlappungsfenster und machen Sie Schreibvorgänge idempotent, denn Uhren und lange Transaktionen erzeugen Zeilen, die mit älterem Zeitstempel bestätigt werden.
Inhalts-Hashes ergänzen Wasserstandsmarken. Hashen Sie den Text, der eingebettet wird, nicht die ganze Zeile, und überspringen Sie die Neueinbettung, wenn der Hash unverändert ist; ein Preisupdate berührt dann nur Metadaten. Dieselbe Idee funktioniert im Kleinen für Dateien und Repositorys, wo ein Hash pro Datei entscheidet, was neu gechunkt wird, wie in RAG über Code beschrieben. Die Schwachstelle beider ist das Löschen: Eine Zeile, die es nicht mehr gibt, taucht in keiner Abfrage nach geänderten Zeilen auf.
Ein Abgleich braucht außerdem eine Absicherung gegen Abdrift. Vergleichen Sie einmal pro Woche die vollständige Liste der Quell-IDs mit den IDs im Index: Alles, was im Index, aber nicht in der Quelle ist, ist eine verpasste Löschung, und alles, was in der Quelle, aber nicht im Index ist, ein verpasster Insert. Dieser Vergleich ist günstig, fängt Fehler in jedem anderen Mechanismus und ergibt eine Zahl, die neben der Verzögerung aufs selbe Dashboard passt.
Change Data Capture aus Postgres
Change Data Capture liest bestätigte Änderungen aus dem Write-Ahead-Log der Datenbank, statt Tabellen abzufragen, sodass Inserts, Updates und Deletes alle binnen Sekunden als Ereignisse ankommen. In Postgres ist der Mechanismus Logical Decoding, „der Vorgang, alle dauerhaften Änderungen an den Tabellen einer Datenbank in ein zusammenhängendes, leicht verständliches Format zu extrahieren“, gestützt auf Replikationsslots und ein Output-Plugin (PostgreSQL). Eine Publication legt fest, welche Tabellen erfasst werden (CREATE PUBLICATION), aber Schemaänderungen werden nicht repliziert, DDL ist also eine eigene Aufgabe (Einschränkungen).
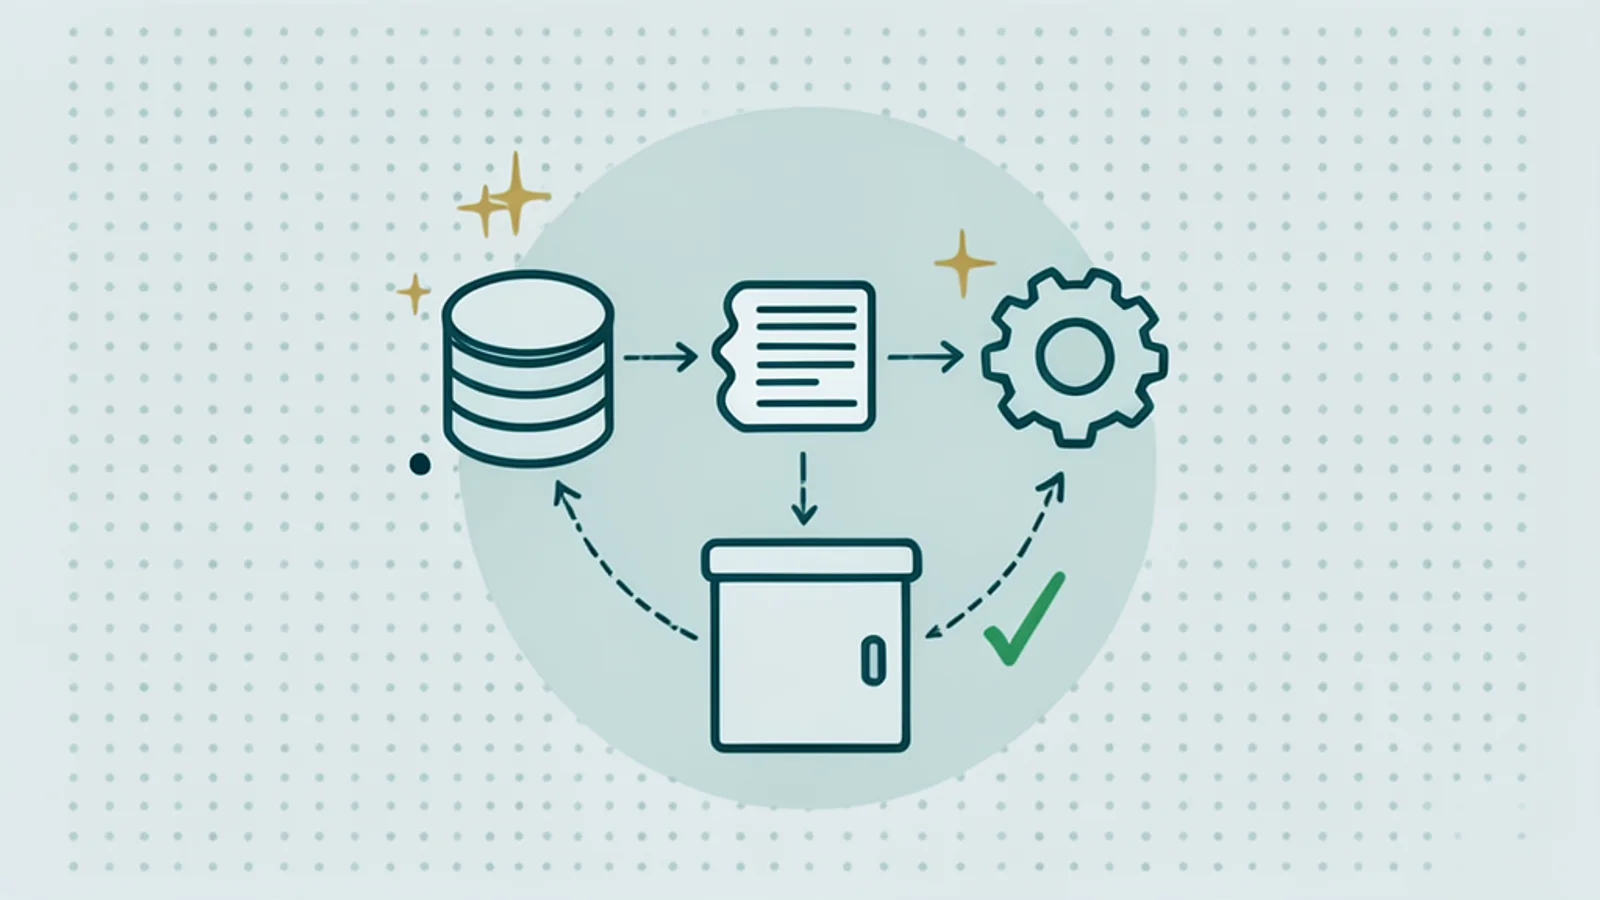
Debezium ist der übliche Weg, es zu verarbeiten. Sein PostgreSQL-Connector braucht wal_level=logical sowie genug WAL-Sender und Replikationsslots, und seine Dokumentation benennt das Risiko klar: Replikationsslots bewahren allen WAL, den Debezium braucht, auch während Ausfällen auf, also müssen sie überwacht werden, um volle Platten und Katalog-Bloat zu vermeiden (Debezium). Update-Ereignisse enthalten die vorherigen Spaltenwerte nur mit REPLICA IDENTITY FULL; ein Heartbeat-Intervall hält den Slot in Bewegung, wenn die erfassten Tabellen ruhen, und eine Signaltabelle löst gezielte Nachladungen statt eines vollständigen Neuindexierens aus.
-- Postgres side of CDC: scope, slot health and lag
ALTER TABLE products REPLICA IDENTITY FULL;            -- update events carry old values too
CREATE PUBLICATION rag_sources FOR TABLE products, product_texts, document_acl;

-- WAL retained by each slot: alert long before the disk fills
SELECT slot_name, active, wal_status,
       pg_size_pretty(pg_wal_lsn_diff(pg_current_wal_lsn(), confirmed_flush_lsn)) AS behind
FROM pg_replication_slots;
Postgres stellt die Zahlen für den Verzögerungsalarm bereit: pg_replication_slots zeigt für jeden Slot die bestätigte Position und den WAL-Status, und max_slot_wal_keep_size begrenzt, wie viel WAL ein Slot halten darf, bevor er ungültig wird (PostgreSQL). Alarmieren Sie auf den Abstand zwischen aktueller WAL-Position und bestätigter Slot-Position lange bevor er diese Grenze erreicht. Für Auftrags- und Katalogdaten, die ohnehin zwischen Systemen fließen, gelten dieselben Outbox- und Idempotenzmuster, siehe Auftragssynchronisation zwischen Shop und ERP.
Löschungen und Rechteänderungen
Löschungen und Rechteänderungen sind die beiden Deltas, die Indexer am häufigsten übersehen, und genau die beiden mit rechtlichen Folgen. Azure AI Search sagt es deutlich: Ein Indexer verfolgt das Löschen von Objekten in Datenquellen nicht, daher braucht es eine Soft-Delete-Strategie, und die Richtlinie muss ab dem allerersten Indexer-Lauf gelten, sonst bleiben gelöschte Dokumente im Index (Azure AI Search). Nach Art. 17 DSGVO müssen personenbezogene Daten unverzüglich gelöscht werden, sobald die Löschung fällig ist (DSGVO), und ein Vektorindex mit Chunks dieser Daten gehört dazu.
Behandeln Sie beides ausdrücklich. Speichern Sie Quell-ID und Dokument-ID an jedem Chunk, damit eine Löschung alle Chunks eines Dokuments mit einem Aufruf entfernen kann; verarbeiten Sie Löschereignisse aus CDC, wo vorhanden; und lassen Sie regelmäßig einen Abgleich laufen, der Chunks entfernt, deren Quelle nicht mehr existiert. Für die Zugriffskontrolle halten Sie den Rechtezustand im Index neben Text und Vektoren und geben Rechteänderungen als eigene Ereignisse weiter. Azure AI Search speichert ACL-Metadaten inzwischen im Index und hat 2026 für seinen SharePoint-Indexer eine inkrementelle ACL-Synchronisierung pro Lauf ergänzt (Azure AI Search).
Vollständiges Neuindexieren und Blue/Green-Wechsel
Manche Änderungen lassen sich nicht inkrementell anwenden: Ein neues Embedding-Modell, eine neue Chunking-Strategie oder eine neue Indexkonfiguration bedeutet, dass sich jeder Vektor ändert. Behandeln Sie das als Migration mit Blue/Green-Wechsel. Qdrant dokumentiert Aliase genau für diesen Fall, den Wechsel zwischen Vektorversionen „beim Upgrade auf eine neue Version des neuronalen Netzes“, wobei Alias-Änderungen als eine Aktionsanfrage gesendet werden (Qdrant); Aliase in Elasticsearch dienen demselben Zweck und sind als Weg dokumentiert, ohne Ausfallzeit neu zu indexieren (Elastic).
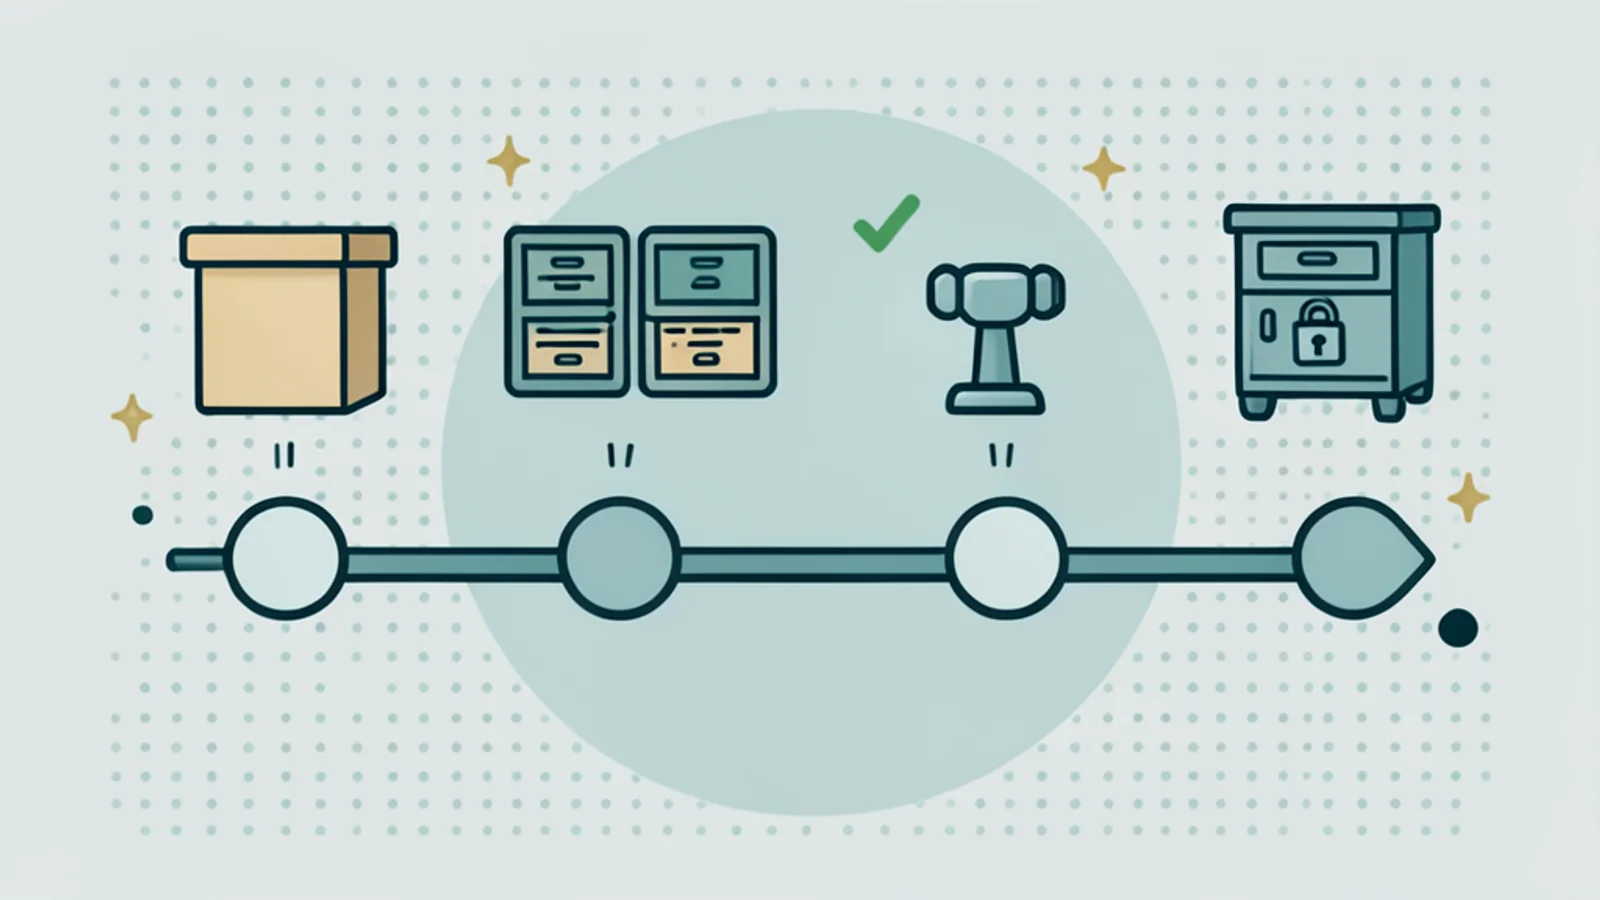
Der Ablauf ist überall gleich: die neue Collection mit dem neuen Modell aufbauen, während die alte bedient, aus der Quelle nachladen, neue Änderungen während des Nachladens in beide schreiben, den Alias umschalten und die alte Collection schreibgeschützt behalten, bis die neue Ihre Such-Evaluierung in der Produktion bestanden hat. Die Dokumentation beschreibt den Alias-Aufruf, nicht seine Transaktionsgarantien unter Last, testen Sie das Umschalten also zuerst an einer Staging-Kopie. In pgvector ist das Gegenstück eine neue Spalte oder Tabelle, ein mit CREATE INDEX CONCURRENTLY aufgebauter Index, damit Schreibvorgänge nicht blockiert werden, und ein Umschalten in der Anwendungskonfiguration (pgvector).
pgvector ergänzt zwei praktische Hinweise: Indexaufbauten sind deutlich schneller, wenn der HNSW-Graph in maintenance_work_mem passt, und die Standardwerte m = 16 und ef_construction = 64 sind ein vernünftiger Start für den neuen Index. Die Wahl des Zielmodells ist eine eigene Entscheidung, behandelt in der Auswahl von Embedding-Modellen.
Die Kosten der Neueinbettung
Die Tokens sind der billige Teil. Stand Oktober 2026 nennt OpenAI für text-embedding-3-small $0,02 und für text-embedding-3-large $0,13 pro Million Tokens (OpenAI), und Voyage für voyage-4-lite $0,02 und für voyage-4 $0,06 pro Million, mit Batch-Rabatt (Voyage). Die Neueinbettung eines Korpus mit 100 Millionen Tokens kostet also etwa $2 bis $13 an API-Gebühren. Das ist eine Rechnung mit Listenpreisen, kein Angebot, und es ist wenig im Vergleich zu allem anderen.
Die eigentlichen Kosten liegen woanders: Stunden des Nachladens unter Ratenlimits, ein Doppelschreib-Fenster, das korrekt sein muss, zusätzlicher Speicher, solange zwei Indizes existieren, und eine Such-Evaluierung mit dem neuen Modell vor dem Umschalten. Auf meiner eigenen Nuxt-Seite, auf der ich LLM-Funktionen über einem kleinen Korpus betreibe, ist eine vollständige Neueinbettung trivial, und genau deshalb ist die Token-Rechnung kein Grund, CDC zu bauen; Aktualität, Löschungen und Rechte sind es.
Eine Abkürzung lohnt die Prüfung vor einer vollständigen Neueinbettung. Manche Anbieter beschreiben Modellfamilien, deren Mitglieder einen gemeinsamen Embedding-Raum teilen, was ein Upgrade zuerst auf der Anfrageseite erlauben würde; prüfen Sie eine solche Aussage in der Dokumentation des Anbieters und mit Ihrem Evaluierungsset, bevor Sie sich darauf verlassen, denn das Mischen von Vektoren inkompatibler Modelle verschlechtert die Suche unbemerkt.
Wann CDC übertrieben ist
CDC ist übertrieben, wenn das Aktualitätsbudget Stunden oder einen Tag beträgt, wenn die Quelle ein SaaS-System ohne Datenbankzugang ist oder wenn im Team niemand Replikationsslots überwachen wird. Ein nächtlicher oder stündlicher Abgleich mit Wasserstandsmarken, Inhalts-Hashes und einem Lösch-Abgleich ist einfacher, leichter nachzuvollziehen und für die meisten Dokumentsammlungen ausreichend. Für SaaS-Quellen sind Webhooks der Ereignispfad: ein Geheimnis prüfen, binnen 10 Sekunden antworten, den Ereignistyp prüfen, verpasste Zustellungen erneut anfordern und über die Zustell-ID deduplizieren, wie GitHubs Leitfaden beschreibt (GitHub).
| Mechanismus | Typische Verzögerung | Erfasst Löschungen | Erfasst Rechteänderungen | Betriebsaufwand |
|---|---|---|---|---|
| Nächtliches Neuindexieren | bis zu einem Tag | ja, per Neuaufbau | ja, per Neuaufbau | gering, aber teuer bei Größe |
| updated_at-Abgleich | Minuten bis Stunden | nein, braucht Abgleich | nur mit Zeitstempeln an ACL-Zeilen | gering |
| Inhalts-Hash-Vergleich | pro Lauf | ja, beim Vergleich der vollen Liste | nein | gering |
| CDC per Logical Decoding | Sekunden | ja, Löschereignisse | ja, wenn ACL-Tabellen publiziert sind | hoch: Slots, Verzögerung, Schema |
| Eingehende Webhooks | Sekunden | wenn die Quelle sie sendet | wenn die Quelle sie sendet | mittel: Wiederholung, Dedupe |
Eine Checkliste für einen aktuellen Index
- Pro Quelle ein Aktualitätsbudget festlegen und die Verzögerung dagegen messen.
- Quell-ID, Dokument-ID, Inhalts-Hash und Rechte an jedem Chunk speichern.
- Nur neu einbetten, wenn sich der eingebettete Text geändert hat; sonst Metadaten aktualisieren.
- Löschungen und Rechteänderungen ausdrücklich weitergeben und die Löschung durchgängig testen.
- Bei CDC auf Verzögerung und gehaltenen WAL der Replikationsslots alarmieren.
- Einen regelmäßigen Abgleich behalten, der fängt, was Ereignisse verpasst haben.
- Modellwechsel als Blue/Green-Migration hinter einem Alias durchführen, mit Rückweg.
Wenn Ihr RAG-System richtig bleiben muss, während sich die zugrunde liegenden Daten den ganzen Tag ändern, sehen Sie sich meine KI-Engineering-Arbeit an. Die Produktdatenseite desselben Problems behandelt der Pimcore-ERP-Delta-Sync.
Quellen
- PostgreSQL docs: logical decoding concepts
- Debezium docs: PostgreSQL connector
- PostgreSQL docs: CREATE PUBLICATION
- PostgreSQL docs: pg_replication_slots
- Azure AI Search: changed and deleted blobs
- Azure AI Search: scheduling indexers
- Qdrant docs: collections and aliases
- Elastic docs: aliases
- pgvector on GitHub
- GDPR Article 17
- OpenAI API pricing
- Voyage AI docs: pricing
Häufige Fragen
Wie hält man einen RAG-Index aktuell?
Verfolgen Sie, welche Quelldatensätze sich geändert haben, per Wasserstandsmarke, Inhalts-Hash oder Change Data Capture, chunken und betten Sie nur diese neu ein, geben Sie Löschungen und Rechteänderungen ausdrücklich weiter und lassen Sie regelmäßig einen Abgleich laufen, der fängt, was der Ereignispfad verpasst hat. Messen Sie die Verzögerung gegen ein Aktualitätsbudget pro Quelle.
Was ist Change Data Capture für RAG?
Änderungen aus dem Log der Datenbank zu lesen, statt Tabellen abzufragen. In Postgres stellt Logical Decoding bestätigte Inserts, Updates und Deletes bereit, und Debezium macht daraus Ereignisse, die ein Indexer binnen Sekunden verarbeiten kann. Dafür braucht es Replikationsslots, die WAL bis zur Verarbeitung aufbewahren und überwacht werden müssen.
Wie erreichen Löschungen den Vektorindex?
Nur, wenn Sie sie senden. Viele Indexer verfolgen keine Löschungen in der Quelle, also nutzen Sie Löschereignisse aus CDC, ein Soft-Delete-Kennzeichen, das der Indexer liest, oder einen regelmäßigen Abgleich, der Chunks entfernt, deren Quell-ID nicht mehr existiert. Personenbezogene Daten müssen nach DSGVO unverzüglich gelöscht werden.
Wie bettet man mit einem neuen Modell ohne Ausfall neu ein?
Bauen Sie eine neue Collection mit dem neuen Modell, während die alte bedient, laden Sie sie nach und schreiben Sie neue Änderungen doppelt in beide, schalten Sie dann einen Alias mit einem Aufruf auf die neue Collection um und behalten Sie die alte schreibgeschützt für den Rückweg. In pgvector legen Sie den neuen Index nebenläufig an und schalten per Konfiguration um.
Was kostet die Neueinbettung eines Korpus?
Bei Embedding-API-Preisen von $0,02 bis $0,13 pro Million Tokens, Stand Oktober 2026, kostet die Neueinbettung von 100 Millionen Tokens etwa $2 bis $13. Die eigentlichen Kosten sind Nachladezeit, Ratenlimits, das Engineering des Umschaltens und die erneute Prüfung der Suchqualität mit dem neuen Modell.