Blog/RAG & Retrieval
pgvector oder Vektordatenbank? So wählst du 2026 den Vektorspeicher
pgvector, Qdrant, Weaviate, Milvus, Pinecone, OpenSearch oder Elasticsearch? Ein praktischer Leitfaden 2026 zu Filtern, Hybridsuche, Skalierung, Kosten und EU-Hosting.
Balázs Csorba··13 Min. Lesezeit
- pgvector
- Vector databases
- RAG
- Hybrid search
- EU hosting
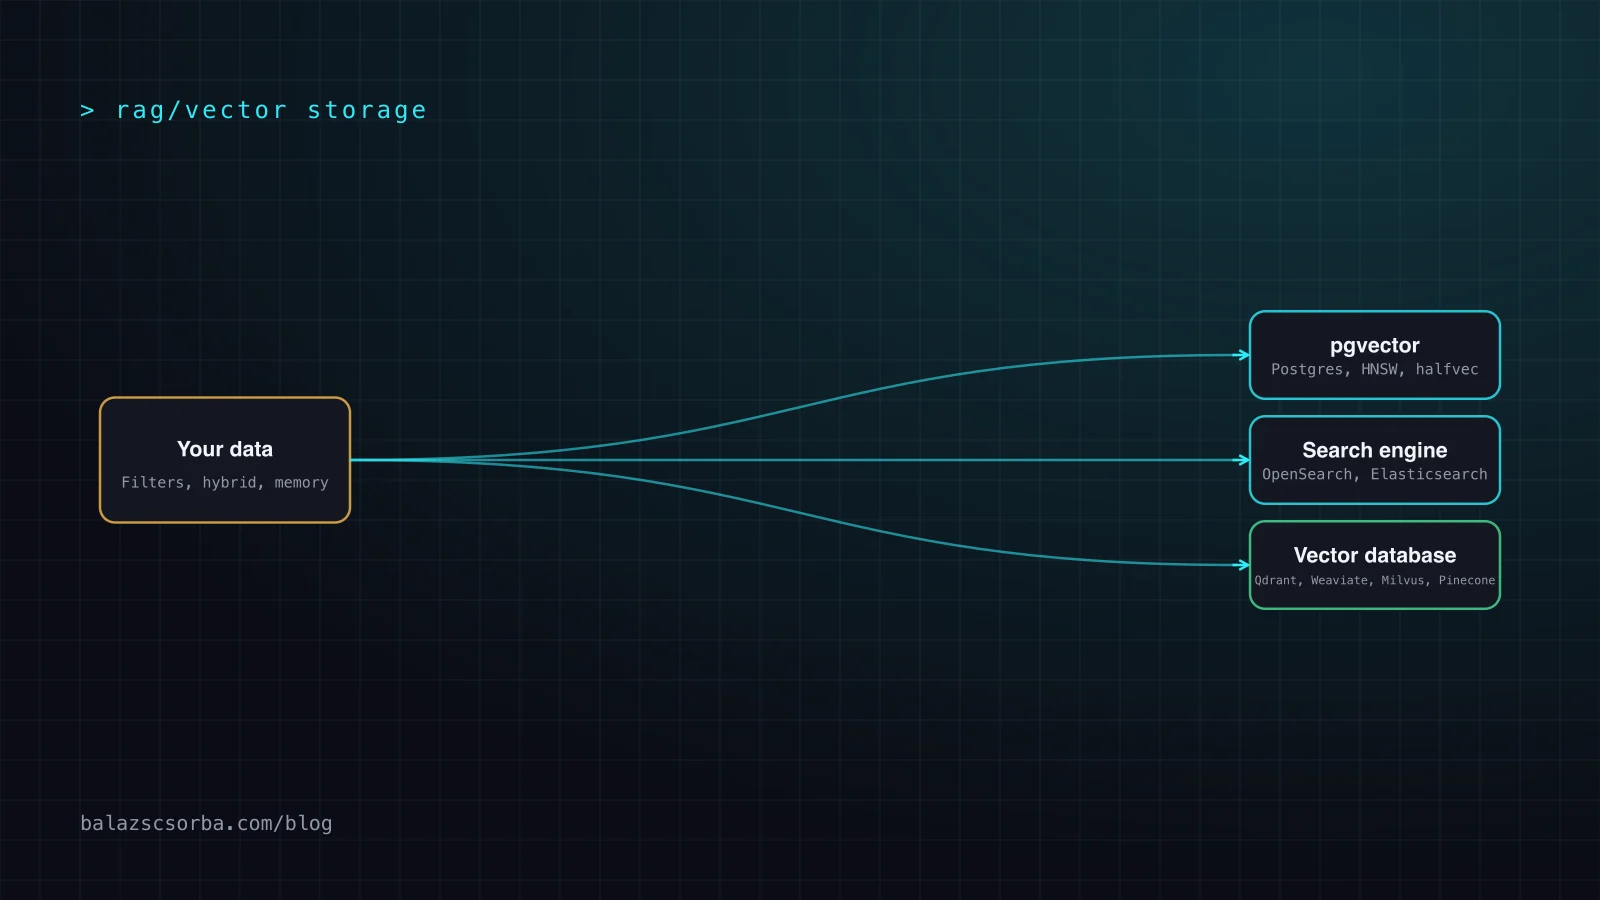
Das Wichtigste in Kürze
- Fang dort an, wo deine Daten schon liegen: Liegen deine Datensätze in Postgres, deckt pgvector mit HNSW, halfvec und iterativen Scans die meisten RAG-Workloads ab, ohne ein zweites System zu betreiben.
- Das Filtern entscheidet mehr als die reine Geschwindigkeit. Teste deine echten Filter, denn ein Filter, der nach einem approximativen Index-Scan greift, kann zu wenige Treffer liefern.
- Der Speicher ist die Skalierungsschwelle, die du ausrechnen kannst: Ein float32-Vektor mit 1.536 Dimensionen braucht 6.144 Bytes, noch vor jedem Index-Overhead, halfvec halbiert das.
- Betreibst du schon OpenSearch oder Elasticsearch für die Stichwortsuche, ist es oft günstiger, dort Vektorfelder zu ergänzen, als eine neue Datenbank einzuführen.
- Wähle eine dedizierte Vektordatenbank, wenn Vektoren das Produkt sind: sehr große Korpora, viele Mandanten oder ein Team, das die Suche verantwortet. Prüfe EU-Regionen und Betrieb vor der Unterschrift.
Jedes RAG-Projekt landet im selben Meeting. Jemand öffnet eine Folie mit sechs Logos von Vektordatenbanken, jemand anderes sagt „wir haben doch schon Postgres“, und die Diskussion wird zur Geschmacksfrage. 2026 geht es dabei weniger darum, welche Engine die schnellste ist, sondern darum, was du ohnehin betreibst, wie deine Abfragen gefiltert werden und wer nachts angerufen wird, wenn der Index umfällt.
Ich habe Retrieval auf relationalen Datenbanken, Suchmaschinen und dedizierten Vektorspeichern ausgeliefert. Mein ehrliches Fazit: Die Wahl hängt selten an einem Benchmark. Sie hängt an Filtern, Hybridsuche, Speicher, Hosting und Betrieb, ungefähr in dieser Reihenfolge. Dieser Artikel geht diese fünf Punkte durch, am Ende mit Entscheidungsdiagramm und Vergleichstabelle.
Ein Hinweis zur Beleg-Lage. Alles Konkrete stammt aus der Dokumentation und den Release Notes der Hersteller, die ich in den ersten Oktobertagen 2026 gelesen habe. Benchmark-Zahlen nenne ich bewusst nicht: Vektor-Benchmarks hängen von Datensatz, Recall-Ziel, Hardware und Filtern ab, und die kursierenden stammen meist von den Herstellern selbst. Wo ich eine Schwelle nenne, sage ich dir, dass es mein Urteil ist.
Die kurze Antwort
In einem Satz: Nimm den Speicher, den dein Team schon zu betreiben weiß, und verlasse ihn erst, wenn du das gemessene Limit benennen kannst, das dich zwingt. Für die meisten europäischen B2B-Teams heißt das Postgres mit pgvector oder die Suchmaschine, die sie schon betreiben.
Der Rest des Artikels erklärt, warum, und wie du herausfindest, in welcher Situation du bist. Wenn du die Retrieval-Schicht selbst noch entwirfst, lies zuerst meinen RAG-Pipeline-Leitfaden zu Chunking, Hybridsuche und Reranking: Der Speicher ist die kleinere Entscheidung.
Was pgvector heute kann
pgvector hat sich seit den frühen IVFFlat-only-Tagen stark verändert. Das Changelog zeigt die für RAG wichtigen Meilensteine, und das neueste Release, das ich gesehen habe, war 0.8.7 vom 1. Oktober 2026.
- HNSW-Indizes kamen in 0.5.0 (August 2023), zusammen mit parallelen IVFFlat-Builds.
- halfvec und sparsevec kamen in 0.7.0 (April 2024), dazu Funktionen für binäre Quantisierung und Indizierung des bit-Typs.
- Iterative Index-Scans kamen in 0.8.0 (Oktober 2024), also das Feature, das gefilterte Abfragen vernünftig macht.
- Patch-Releases zählen. 0.8.3 (Juni 2026) behob mögliche Index-Korruption beim HNSW-Vacuuming und 0.8.4 einen HNSW-Reparaturfehler, bleib also auf dem neuesten 0.8.x-Patch.
Die README dokumentiert die Grenzen, um die du herumplanen musst. Eine vector-Spalte lässt sich bis 2.000 Dimensionen indizieren, halfvec bis 4.000, bit bis 64.000 und sparsevec bis 1.000 Nicht-Null-Elemente. Die HNSW-Standardwerte sind m = 16, ef_construction = 64 und ef_search = 40. Der Index baut am schnellsten, wenn der Graph in `maintenance_work_mem` passt, und mit halfvec indizierst du dieselben Embeddings bei halbem Speicher, indem du einen Ausdruck wie `embedding::halfvec(1536)` indizierst und mit demselben Cast abfragst.
Das eigentliche Argument für pgvector ist, was über den Index hinausgeht: Die Embeddings liegen neben den Zeilen, die sie beschreiben. Joins, Transaktionen, Row-Level-Security, Backups und Point-in-Time-Recovery betreibst du ohnehin. Ein gelöschter Kunde ist an einer Stelle gelöscht, was für die DSGVO zählt. Was du aufgibst, ist Isolation: Vektorabfragen und Index-Builds konkurrieren mit deinem OLTP-Verkehr um Speicher und CPU, es sei denn, du nutzt ein Replikat.
Wächst du aus reinem pgvector heraus, willst aber bei Postgres bleiben, ergänzt pgvectorscale einen StreamingDiskANN-Index, statistische binäre Quantisierung und labelbasierte gefilterte Suche unter der PostgreSQL-Lizenz. Zum Zeitpunkt des Schreibens war das Managed-Angebot in der Timescale Cloud eine Private Beta, und die Hersteller-Benchmarks dazu sind genau die Art Zahlen, die ich auf deinen Daten nachmessen würde, bevor ich ihnen glaube.
Beim Filtern fallen die Entscheidungen
Echte RAG-Abfragen lauten nie „nächste Nachbarn dieses Vektors“. Sie lauten „nächste Nachbarn unter Dokumenten, die dieser Nutzer sehen darf, in dieser Sprache, aus diesem Jahr“. Ein approximativer Index läuft einen Graphen entlang, und ein Filter, der erst danach greift, wirft Ergebnisse weg.
pgvector ist hier explizit. Mit dem Standard hnsw.ef_search von 40 behält eine Abfrage mit einer WHERE-Klausel, die etwa 10 Prozent der Zeilen trifft, typischerweise nur rund vier der 40 Kandidaten. Iterative Scans beheben das: Setze `hnsw.iterative_scan` auf `strict_order` oder `relaxed_order`, und der Index scannt weiter, bis genug Zeilen passen oder `hnsw.max_scan_tuples` (Standard 20.000) erreicht ist. Mit `relaxed_order` können die Ergebnisse leicht aus der Reihenfolge geraten, und die README zeigt, wie du die Ordnung mit einer materialisierten CTE wiederherstellst.
- Wenige verschiedene Filterwerte: Die README empfiehlt partielle Indizes.
- Viele verschiedene Werte, etwa ein Mandant pro Kunde: partitioniere die Tabelle.
- Geringe Trefferquote: ein gewöhnlicher B-Tree-Index auf der Filterspalte, damit Postgres einen exakten Scan wählen kann.
Dedizierte Systeme machen Filtern zum Designziel. Qdrant empfiehlt Payload-Indizes auf jedem Feld, nach dem du filterst, und unterstützt verschachtelte must-, should- und must_not-Bedingungen sowie Bereichs-, Geo- und Volltextbedingungen. OpenSearch dokumentiert effizientes Filtern, bei dem die Engines Faiss und Lucene den Filter während der Graph-Traversierung anwenden, sodass auch restriktive Filter ein korrektes Top-k liefern. Elasticsearch beschreibt seinen kNN-Filter als Pre-Filter, der während der approximativen Suche greift. Pinecone filtert auf Record-Metadaten in seinen Query-Executors.
Der praktische Test ist einfach, und ich mache ihn in jedem Projekt: Nimm die fünf selektivsten echten Filter, fahre jeweils 200 echte Abfragen beim nötigen Recall und schau, wie viele Ergebnisse zurückkommen und wie sich die Latenz verhält. Kombiniere das mit einem gelabelten Evaluierungsset, wie ich es in LLM-Evals für Produktfunktionen beschreibe, damit du Antwortqualität misst und nicht nur Tempo.
Hybridsuche: eingebaut oder selbst gebaut
Dichte Vektoren verfehlen exakte Tokens wie Teilenummern, Fehlercodes und Namen, und B2B-Kataloge sind voll davon. Fast jedes ernsthafte RAG-System kombiniert am Ende Stichwort- und Vektor-Retrieval, wie ich in RAG 2026: hybrid, agentisch und Long-Context argumentiere.
Die Engines unterscheiden sich darin, wie viel davon du geschenkt bekommst. Qdrant unterstützt Sparse- und Dense-Vektoren in einer Abfrage, mit Reciprocal Rank Fusion und Distribution-Based Score Fusion, verschachtelten Prefetch-Stufen und Multi-Vektor-Unterstützung für ColBERT-artiges Re-Scoring. Weaviate führt BM25- und Vektorsuche parallel aus und fusioniert sie, mit Relative Score Fusion als Standard und einem alpha-Parameter, der standardmäßig 0,75 ist. Milvus kann mehrere Vektorfelder, dicht und sparse, in einer Collection durchsuchen. Pinecone unterstützt Sparse-Vektoren, Hybridabfragen und BM25-basierte Volltextsuche. OpenSearch und Elasticsearch sind zuerst Suchmaschinen, BM25 und Vektoren liegen also in einem Index.
Postgres liefert dir die Bausteine: Volltextsuche mit tsvector und gerankte Vektorergebnisse aus pgvector, per Reciprocal Rank Fusion in SQL fusioniert. Das sind etwa dreißig Zeilen, die dir gehören und die du testen kannst, ein guter Tausch, wenn dir ein transaktionaler Speicher wichtig ist. Will dein Team den Fusionscode und das Relevanz-Tuning drumherum nicht besitzen, ist das ein legitimer Grund für Weaviate oder Qdrant oder dafür, in einer Suchmaschine zu bleiben.
Ein Entscheidungsdiagramm
In dieser Reihenfolge stelle ich die Fragen. Sie ist bewusst zugunsten der Systeme verzerrt, die du schon betreibst.
Zwei Einschränkungen. Das erste „Ja“ beendet die Diskussion nicht, wenn der Korpus riesig ist: Rechne im Abschnitt zur Skalierung den Speicher durch. Und „mit pgvector starten“ als Fallback ist meine Neigung für kleine Teams, weil es die am leichtesten umkehrbare Option ist: Für eine Migration genügt ein Export von Vektoren und Metadaten.
Die Optionen im Vergleich
Diese Tabelle verdichtet, was ich in der Dokumentation verifiziert habe. Die Versionen sind die neuesten Releases, die ich Anfang Oktober 2026 auf GitHub gesehen habe: Qdrant 1.19.1, Weaviate 1.39.8, Milvus 3.0.2, OpenSearch 3.9.0 und pgvector 0.8.7.
| Option | Am stärksten bei | Filtern | Hybridsuche | Worauf achten |
|---|---|---|---|---|
| pgvector | Vektoren neben relationalen Daten, ein System | WHERE plus iterative Scans, partielle Indizes, Partitionen | Volltextsuche plus eigene Fusion in SQL | Index-Speicher, konkurriert mit OLTP, Dimensionsgrenzen beim Indizieren |
| Qdrant | Filterlastiges Retrieval, flexible Hybridabfragen | Payload-Indizes, verschachtelte boolesche Bedingungen | Sparse und Dense, RRF, DBSF, Prefetch | Ein zweites System zum Synchronisieren und Absichern |
| Weaviate | Eingebaute Hybridsuche, Mandantenfähigkeit | Gefilterte Vektorsuche; Details nicht verifiziert, teste deine | BM25 plus Vektor, standardmäßig Relative Score Fusion | In der Cloud skaliert der Preis mit den Vektordimensionen |
| Milvus | Sehr große, verteilte Workloads | Metadatenfilter; Details nicht verifiziert, teste deine | Mehrere dichte und Sparse-Vektorfelder | Verteilter Betrieb auf Kubernetes ist echter Betriebsaufwand |
| Pinecone | Managed, serverless, keine Server | Metadatenfilter in den Query-Executors | Sparse-Vektoren, Hybrid, BM25-Volltext | In der gelesenen Doku nur serverless, Region beim Anlegen fix |
| OpenSearch | Eine Engine für Stichwörter, Facetten und Vektoren | Filtern während der Faiss- oder Lucene-Traversierung | BM25 und Vektoren in einem Index | Cluster-Tuning, JVM und Shard-Planung |
| Elasticsearch | Dasselbe, mit Elastic-Tooling und BBQ-Quantisierung | Pre-Filter während der approximativen kNN-Suche | BM25 und kNN in einem Index | Cluster-Dimensionierung und Betrieb |
Einige Details hinter den Zellen. Weaviate bietet die Indextypen HNSW, flat, dynamic und HFresh, wobei dynamic oberhalb einer Schwelle (Standard 10.000 Objekte) von flat auf HNSW wechselt und zu vielen kleinen Mandanten passt. Milvus dokumentiert HNSW, IVF, DiskANN, ScaNN und GPU-Indizes sowie eine zustandslose, entkoppelte Architektur. Elasticsearch dokumentiert, dass neue Indizes mit float-Vektoren ab 384 Dimensionen standardmäßig BBQ HNSW nutzen. OpenSearch unterstützt die Engines Lucene (HNSW) und Faiss (HNSW und IVF).
Skalierungsschwellen und Kosten
Die eine Schwelle, die ich dir ohne Benchmark nennen kann, ist Arithmetik. Ein float32-Vektor braucht 4 Bytes pro Dimension. Bei 1.536 Dimensionen sind das 6.144 Bytes, also brauchen 1 Million Vektoren etwa 6,1 GB und 10 Millionen etwa 61 GB, vor Graph-Verknüpfungen, Metadaten und Replikaten. halfvec halbiert das auf etwa 3 GB und 31 GB, und binäre Quantisierung schrumpft es weit mehr, auf Kosten eines Recalls, den du messen musst.
HNSW will seinen Graphen im Speicher, die praktische Frage lautet also, ob dieser Speicher auf die Maschine passt, die du ohnehin mieten würdest. Meine Faustregel, und sie ist Urteil und keine Messung: Bis zu einigen Millionen Chunks ist eine gut dimensionierte Postgres-Instanz selten der Engpass. Irgendwo in den zig Millionen, oder wenn Index-Builds deine Primärdatenbank belasten, beginne ich, festplattenbasierte oder quantisierte Optionen in dedizierten Systemen zu vergleichen.
- Selbst gehostetes oder Managed Postgres: Die Kosten sind die Instanz, die du ohnehin zahlst, plus zusätzlicher RAM. Kein neuer Anbieter.
- Suchmaschinen-Cluster: Du zahlst pro Node für Speicher und Platte, teilst sie aber mit Stichwortsuche und Logs.
- Dedizierter Cloud-Service: Du zahlst für Kapazität oder Nutzung. Weaviate rechnet hauptsächlich nach Vektordimensionen ab, niedrigdimensionale oder komprimierte Embeddings senken die Rechnung also direkt.
- Versteckte Kosten: Ein zweites System bedeutet eine zweite Sync-Pipeline, ein zweites Zugriffsmodell und einen zweiten Incident-Kanal.
Die Kosten hängen auch von den gewählten Embeddings ab. Ein kleineres Modell oder eines, das gekürzte Vektoren unterstützt, senkt den Speicher überall. Die weiteren Hebel behandle ich in LLM-Kosten, Latenz, Prompt Caching und Routing.
EU-Hosting und Datenschutz
Für europäische Kunden ist „wo liegen die Vektoren“ eine Beschaffungsfrage. Embeddings werden aus deinen Dokumenten abgeleitet und können Informationen darüber preisgeben, behandle sie also als personenbezogene Daten, wenn die Quelle es ist.
- Postgres: jede EU-Region eines Managed-Anbieters oder deine eigenen Server. Am einfachsten zu auditieren.
- Pinecone: dokumentiert AWS eu-west-1 (Irland) und eu-central-1 (Frankfurt) sowie GCP europe-west4 (Niederlande) ab dem Builder-Tarif. Der Starter-Tarif ist auf AWS us-east-1 beschränkt, und die Region lässt sich nach dem Anlegen nicht ändern.
- Weaviate Cloud: EU-Regionen bei Shared- und Dedicated-Deployments, mit einer Bring-your-own-Cloud-Option, die als „coming soon“ geführt wird.
- Qdrant: verwaltete Cluster auf AWS, GCP und Azure sowie Hybrid Cloud, eine selbstverwaltete Option.
- Selbst gehostetes Milvus, Qdrant, Weaviate, OpenSearch: Du bestimmst das Rechenzentrum und trägst den Betrieb.
Eine Region in Frankfurt ist nötig, aber nicht immer ausreichend: Ein Anbieter mit Hauptsitz in den USA kann weiter Fragen zum Zugriff aus dem Ausland aufwerfen, und der Aufruf des Embedding-Modells ist ein zweiter Datenfluss. Meine DSGVO-Hinweise in DSGVO und LLM-APIs: EU-Datenresidenz decken diesen Teil ab. Prüfe die aktuelle Regionenliste auf der Seite des Anbieters bei Vertragsabschluss, denn sie ändert sich.
Betriebsaufwand
Das sind die Kosten, die Benchmarks nie zeigen. Stelle jeder Option vier Fragen.
- Backups und Restore: Kannst du Vektoren und Metadaten auf einen konsistenten Zeitpunkt zurückspielen? Postgres hat das gelöst. Teste bei anderen den Restore, nicht nur das Backup.
- Re-Indexierung: Ein neues Embedding-Modell bedeutet, den Korpus neu zu embedden. Kannst du den neuen Index neben dem alten aufbauen und umschalten?
- Upgrades: pgvector-Patches wie 0.8.3 behoben Fälle von Index-Korruption. Wer beobachtet die Release Notes?
- Bereitschaft: Ein verteiltes System auf Kubernetes ist eine andere Verpflichtung als eine Extension in einer Datenbank, die du ohnehin betreibst.
Nach meiner Erfahrung entsteht der billigste Betrieb dadurch, ein System weniger zu fahren. Das ist das ganze Argument für pgvector und für Suchmaschinen, und es ist der Grund, warum ein verwalteter dedizierter Dienst die richtige Antwort ist, wenn dein Team keine Lust hat, irgendeines davon zu betreiben.
Eine Checkliste vor der Entscheidung
- Schreibe deine fünf wichtigsten Filter auf, inklusive Mandanten- und Berechtigungsprüfungen.
- Zähle Chunks, Dimensionen und Wachstum und rechne den Speicher für float32 und halfvec durch.
- Baue ein gelabeltes Evaluierungsset aus mindestens einigen Dutzend echten Fragen.
- Fahre dieselben Abfragen mit deinen echten Filtern gegen deine zwei Top-Kandidaten und vergleiche Recall und Latenz.
- Entscheide, wer Fusion und Relevanz-Tuning für die Hybridsuche verantwortet.
- Lass dir EU-Region, Backup, Restore und Upgrade-Prozess schriftlich bestätigen.
- Plane den Re-Embedding-Pfad, bevor du die erste Million Vektoren lädst.
Gibt es ein Unentschieden, nimm die Option mit weniger beweglichen Teilen. Du kannst später immer wechseln: Vektoren und Metadaten lassen sich sauber exportieren.
Was ich tun würde
Für ein typisches europäisches B2B-Projekt mit Katalog oder Wissensbasis im niedrigen Millionenbereich an Chunks würde ich mit pgvector, halfvec, einem HNSW-Index und iterativen Scans starten, die Postgres-Volltextsuche für Hybrid-Retrieval ergänzen und das Evaluierungsset am ersten Tag schreiben. Betreibt der Kunde schon OpenSearch, würde ich die Vektoren dort ablegen.
Zu einer dedizierten Vektordatenbank würde ich wechseln, wenn ein gemessenes Limit auftaucht: gefilterter Recall, den iterative Scans nicht retten, Index-Builds, die die Produktion belasten, oder Mandantenfähigkeit und Skalierung, die Postgres nicht tragen sollte. Und ich würde sie ebenso wegen ihres Betriebsmodells wählen, verwaltet oder selbst gehostet in der EU, wie wegen ihrer Funktionen. Wenn du Hilfe bei dieser Entscheidung auf deinen eigenen Daten möchtest, sieh dir meine KI-Engineering-Arbeit an.
Quellen
- pgvector README (index limits, HNSW defaults, iterative scans, filtering, halfvec)
- pgvector CHANGELOG (0.4.0 to 0.8.7)
- pgvectorscale: StreamingDiskANN, statistical binary quantization, filtered search
- Qdrant documentation: Filtering
- Qdrant documentation: Hybrid queries
- Qdrant documentation: Create a cluster (providers, free tier, Hybrid Cloud)
- Weaviate documentation: Hybrid search
- Weaviate documentation: Vector index types
- Weaviate Cloud pricing and deployment options
- Milvus documentation: Overview
- Pinecone documentation: Database architecture
- Pinecone documentation: Create an index (clouds, regions, sparse and hybrid)
- OpenSearch documentation: Methods and engines
- OpenSearch documentation: Efficient k-NN filtering
- Elasticsearch documentation: Dense vector search
- Elasticsearch documentation: kNN query (filter as pre-filter)
- GitHub releases: Qdrant, Weaviate, Milvus, OpenSearch, pgvectorscale (versions as of 1 October 2026)
Häufige Fragen
Reicht pgvector für produktives RAG?
Für viele Workloads ja. pgvector unterstützt HNSW- und IVFFlat-Indizes, die Typen halfvec und sparsevec und seit Version 0.8.0 iterative Index-Scans für gefilterte Abfragen. Liegen deine Daten schon in Postgres und passt der Index in den Speicher, ist es ein solider Standard. Führe vor der Entscheidung einen Lasttest mit eigenen Filtern und Daten durch.
Wann nehme ich eine dedizierte Vektordatenbank statt pgvector?
Wenn die Vektor-Last das übersteigt, was du neben deinen Transaktionsdaten betreiben willst: ein sehr großer Korpus, starkes Filtern über viele Mandanten, spezielle Indextypen oder ein Team, das Suche als eigenes Produkt versteht. Dann bieten Qdrant, Weaviate, Milvus oder Pinecone gezielte Funktionen und unabhängige Skalierung.
Was sind iterative Index-Scans in pgvector?
Iterative Scans, in pgvector 0.8.0 ergänzt, lassen einen approximativen Index weiterscannen, bis genug Zeilen deinen WHERE-Filter bestehen. Ohne sie besucht eine HNSW-Abfrage etwa hnsw.ef_search Kandidaten (Standard 40) und filtert danach, sodass ein selektiver Filter weniger Zeilen liefern kann als angefordert. Aktivieren kannst du sie mit hnsw.iterative_scan.
Kann ich Hybridsuche in Postgres machen?
Ja. pgvector lässt sich mit der PostgreSQL-Volltextsuche kombinieren, und die beiden Ranglisten kannst du per Reciprocal Rank Fusion in SQL zusammenführen oder mit einem Cross-Encoder neu bewerten. Dedizierte Systeme wie Qdrant, Weaviate und Milvus liefern Hybridabfragen als eingebaute Funktion, sodass du die Fusion nicht selbst schreiben musst.
Wie halte ich Vektordaten in der EU?
Wähle einen Managed Service mit EU-Region oder hoste selbst in einem EU-Rechenzentrum. Pinecone nennt AWS Frankfurt und Irland sowie GCP Niederlande, Weaviate Cloud unterstützt EU-Regionen. Lege die Region beim Anlegen fest, denn laut Pinecone lässt sie sich nachträglich nicht ändern, und prüfe auch, wo dein Embedding-Modell läuft.
Brauche ich für eine kleine RAG-App eine Vektordatenbank?
Meistens nicht. Einige hunderttausend Chunks passen locker in Postgres mit pgvector oder sogar in einen In-Process-Index. Starte mit dem einfachsten Speicher, der deine Filter unterstützt, miss die Retrieval-Qualität mit einem Evaluierungsset und migriere erst, wenn dich ein gemessenes Limit dazu zwingt.