Blog/RAG & Retrieval
LLM-Halluzinationen in Produktion reduzieren: Grounding, Zitate und das Nein zur richtigen Zeit
Halluzinationen im produktiven RAG senken: Zitier-APIs, Abstention, Claim-Prüfung, Faithfulness-Metriken, Quellen-UI und die Fehler, die trotzdem durchrutschen.
Balázs Csorba··13 Min. Lesezeit
- Hallucinations
- RAG
- Citations
- Grounding
- Faithfulness
Das Wichtigste in Kürze
- Retrieval beseitigt Halluzinationen nicht. Eine Stanford-Studie fand bei führenden juristischen RAG-Tools weiterhin 17 bis 33 Prozent Halluzinationen, oft durch Zitate echter Quellen, die die Aussage nicht stützen.
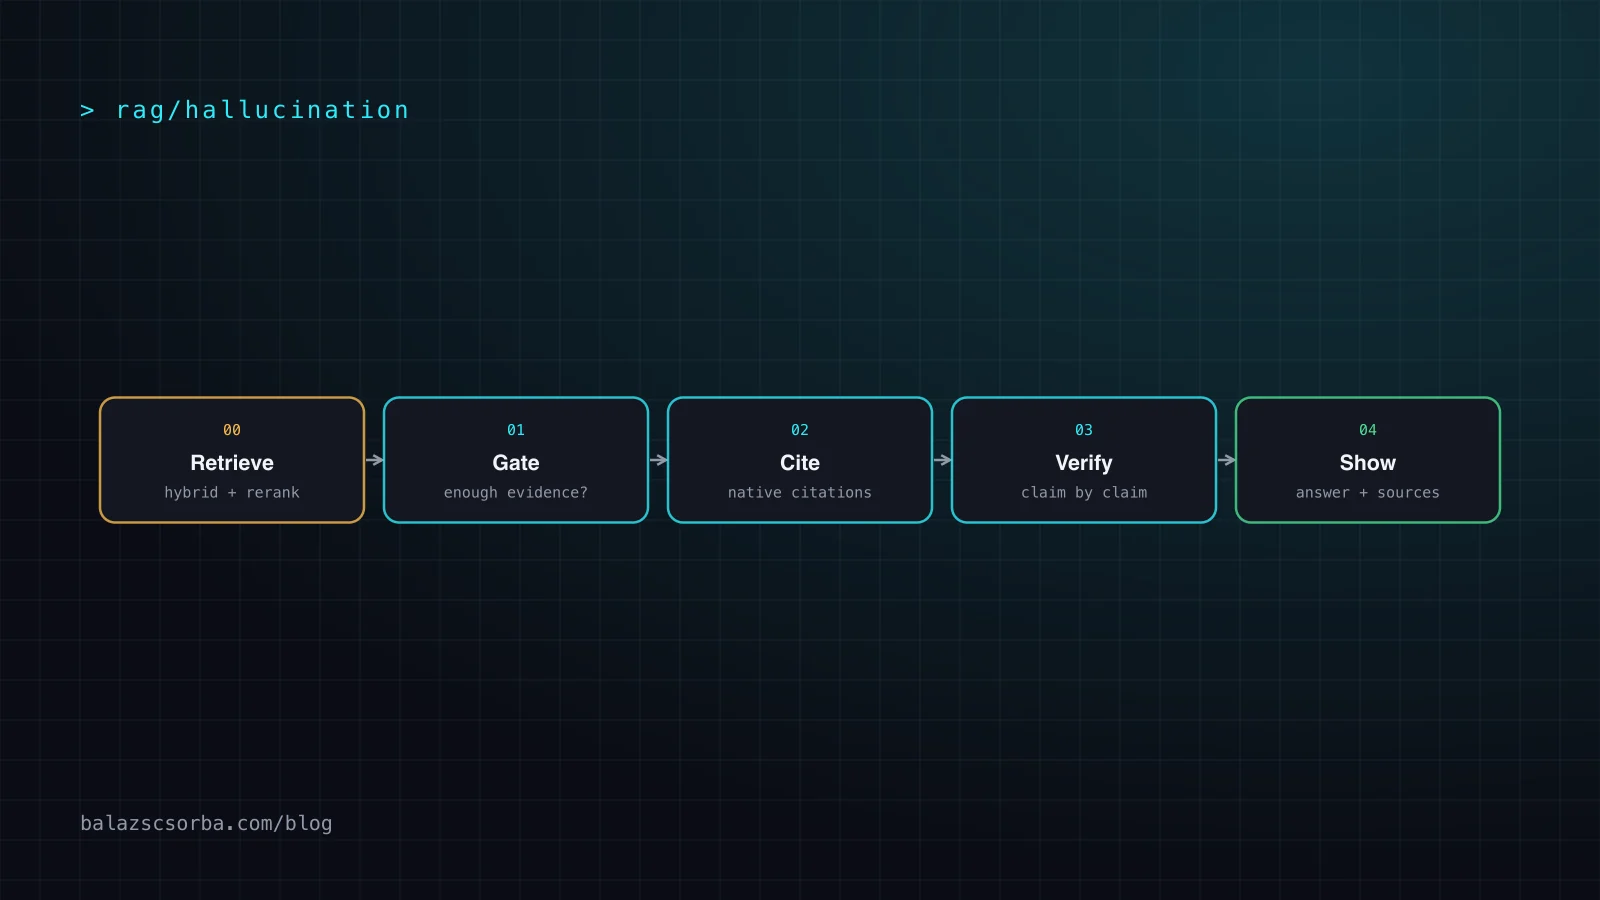
- Grounding ist eine Pipeline, kein Prompt: ein Evidenz-Gate vor der Generierung, native Zitate währenddessen, Claim-Prüfung danach und eine Oberfläche, die die Belege zeigt.
- Abstention ist ein Produktzustand, keine Fehlermeldung. Gestalte den Pfad „Das kann ich aus den Dokumenten nicht beantworten“, miss ihn und gib ihm einen nächsten Schritt.
- Zitier-APIs machen Verweise gültig, nicht Schlussfolgerungen wahr. Anthropic garantiert gültige Dokumentverweise; ob die Passage die Aussage stützt, musst du weiter prüfen, denn in einer Studie waren bis zu 57 Prozent der Zitate nachträglich rationalisiert.
- Miss Faithfulness (Aussagen, die der abgerufene Kontext stützt) getrennt von der Korrektheit, auf einem Testset, das auch Fragen enthält, die die Dokumente nicht beantworten können.
Jedes Team, das einen RAG-Assistenten ausliefert, durchläuft dieselben Phasen. Zuerst kommt die Demo, die wunderbar antwortet. Dann kommt der erste echte Nutzer, der am zweiten Tag eine selbstsichere, flüssige, falsche Antwort findet. Dann fragt jemand: „Wir nutzen doch schon RAG, warum erfindet es trotzdem Dinge?“
Die ehrliche Antwort: Retrieval verändert die Wahrscheinlichkeiten, nicht das Wesen des Systems. Ein Sprachmodell erzeugt weiter plausiblen Text; Retrieval gibt ihm nur besseres Material und die Chance, seine Arbeit zu zeigen. In diesem Artikel beschreibe ich, wie ich den Teil rund um das Modell bauen würde, damit falsche Antworten seltener, sichtbar und korrigierbar werden. Er baut auf meinen Beiträgen zu Chunking, Hybrid-Suche und Reranking und Evals für Produkt-Features auf; hier geht es darum, was nach dem Abrufen der Passagen passiert.
Was in einem RAG-System als Halluzination zählt
In einem Closed-Book-Chatbot ist eine Halluzination eine falsche Aussage. In einem RAG-System gibt es zwei getrennte Fehler, die unterschiedliche Gegenmittel brauchen:
- Falscher Inhalt: Die Antwort behauptet etwas Falsches, entweder weil das Retrieval die falsche oder eine veraltete Passage lieferte, oder weil das Modell den Kontext ignorierte und aus dem Gedächtnis antwortete.
- Misgrounded-Inhalt: Die Antwort zitiert eine Quelle, aber die Quelle sagt das nicht. Das Team von Stanford und Yale, das kommerzielle juristische Recherche-Tools evaluierte, definiert es präzise: Eine Antwort ist halluziniert, wenn sie falsch oder misgrounded ist, also wenn sie fälschlich behauptet, eine Quelle stütze eine Aussage („falsely asserts that a source supports a statement“).
Die zweite Art ist die gefährliche. Dieselbe Studie testete Tools von LexisNexis und Thomson Reuters, die mit Versprechen wie „halluzinationsfreien“ Zitaten vermarktet wurden, und fand Halluzinationen in 17 bis 33 Prozent der Fälle. Die Autoren merken an, dass das Prüfen solcher Fehler bedeutet, durchzuklicken, die Quelle zu lesen und sie mit der Aussage zu vergleichen, genau die Arbeit, von der Nutzer erwarten, dass das Tool sie schon erledigt hat.
Warum raten Modelle überhaupt? Das Paper „Why Language Models Hallucinate“ argumentiert, dass Trainings- und Evaluationsverfahren Raten gegenüber dem Eingestehen von Unsicherheit belohnen, weil ein Modell, das rät, in Benchmarks besser abschneidet als eines, das sich enthält. Das hat praktische Folgen: Das Standardverhalten des Modells ist zu antworten, also muss Abstention ins System hineingebaut werden, statt auf sie zu hoffen.
Die Pipeline: vier Gates statt eines Prompts
Ich sehe Grounding als Folge von Gates. Jedes fängt etwas ab, was das vorige nicht kann, und jedes kostet Latenz und Komplexität.
- Gut abrufen. Hybrid-Suche und Reranking entscheiden, ob die richtige Passage überhaupt beim Modell ankommt. Die meisten „Halluzinationen“, die ich debugge, sind Retrieval-Fehlgriffe, bei denen das Modell mit dem falschen Material tat, was es konnte.
- Auf Evidenz prüfen. Sind die besten Passagen schwach, generiere nicht; enthalte dich und sage, was fehlt.
- Mit Zitaten generieren. Nutze einen nativen Zitiermechanismus, damit jede Aussage einen Verweis in ein von dir geliefertes Dokument trägt.
- Aussage für Aussage prüfen. Prüfe, ob die zitierte Passage den Satz stützt, an dem sie hängt, und streiche oder markiere, was durchfällt.
Dann folgt der Anzeigeschritt, der ebenfalls eine Kontrolle ist: Die Oberfläche entscheidet, ob ein Leser die Antwort in fünf Sekunden prüfen kann oder ihr vertrauen muss.
Schritt eins: das Modell auf das beschränken, was du ihm gegeben hast
Anthropics Leitfaden zum Reduzieren von Halluzinationen nennt einige Basistechniken, die so günstig sind, dass ich sie standardmäßig alle einsetzen würde:
- „Ich weiß es nicht“ erlauben. Gib dem Modell ausdrücklich die Erlaubnis, Unsicherheit zuzugeben. Anthropic sagt, diese einfache Technik könne falsche Informationen drastisch reduzieren.
- Bei langen Dokumenten zuerst zitieren. Bei Dokumenten über etwa 20.000 Tokens soll das Modell zuerst wortgetreue Zitate extrahieren und seine Antwort nur darauf stützen.
- Externes Wissen ausschließen. Weise das Modell an, nur die bereitgestellten Dokumente zu verwenden und nicht sein allgemeines Wissen.
- Nach dem Entwurf verifizieren. Lass das Modell zu jeder Aussage ein stützendes Zitat suchen und jede Aussage zurückziehen, die es nicht belegen kann.
Derselbe Leitfaden nennt als fortgeschrittene Optionen den Best-of-N-Vergleich (den Prompt mehrfach ausführen und Abweichungen als Warnsignal werten) und iterative Verfeinerung, und er endet mit einem Vorbehalt, den ich wiederholen will: Diese Techniken senken Halluzinationen deutlich, beseitigen sie aber nicht, und kritische Informationen müssen weiter validiert werden.
Meine praktische Ergänzung: Behandle Prompt-Regeln als schwache Schicht. Ein Prompt bittet das Modell, sich richtig zu verhalten; ein Gate oder Prüfer kontrolliert, ob es das tat. Nutze den Prompt, um die Basis anzuheben, und die späteren Stufen, um den Rest abzufangen.
Schritt zwei: eine Zitier-API nutzen, statt freundlich zu bitten
Du kannst ein Modell bitten, „[1]“ hinter Sätze zu schreiben, und für Prototypen reicht das. In Produktion ist der Verweis das Problem: Modelle erfinden plausible Quellennamen, nummerieren falsch oder zitieren Text, der gar nicht im Dokument steht. Native Zitierfunktionen verlagern diese Arbeit vom Freitext in die API-Antwort.
Anthropic: Citations und Search Results
Anthropics Citations-Funktion arbeitet mit drei Dokumenttypen, und das Zitatformat folgt dem Typ:
| Dokumenttyp | Chunking | Zitat verweist auf |
|---|---|---|
| Plain Text | Sätze | Zeichenindizes (0-basiert) |
| Sätze | Seitenzahlen (1-basiert) | |
| Custom Content | Keines zusätzlich: deine Blöcke werden unverändert genutzt | Blockindizes (0-basiert) |
Für RAG empfiehlt die Dokumentation selbst, jeden abgerufenen Chunk in ein Plain-Text-Dokument zu legen oder `search_result`-Content-Blöcke zu verwenden, die Quelle und Titel tragen und aus deinen eigenen Such-Tools zurückgegeben oder direkt in die User-Nachricht gelegt werden können. Zitate erscheinen dann an den Text-Blöcken, die deinen Inhalt nutzen, ohne besonderes Prompting. Nach meiner Erfahrung ist der Ansatz „ein Chunk pro Dokument“ auch der sauberste Weg, eigene Chunk-IDs in der Antwort nachvollziehbar zu halten.
Die Details, die in Produktion zählen, alle aus der Dokumentation:
- Gültige Verweise. Weil die API Zitate selbst parst und `cited_text` extrahiert, enthalten Zitate garantiert gültige Verweise auf die gelieferten Dokumente. Das beseitigt erfundene Referenzen, nicht falsch gelesene.
- Kosten. Aktivierte Citations erhöhen die Input-Tokens leicht, aber `cited_text` zählt nicht zu den Output-Tokens und kann daher günstiger sein, als das Modell zitieren zu lassen.
- Caching. Die Quelldokumente lassen sich mit `cache_control` cachen; die Zitat-Blöcke in Antworten nicht. Wann sich das lohnt, steht in meinem Beitrag zu Prompt Caching und Routing.
- Streaming. Zitate kommen als `citations_delta`-Events, eines pro Event, am aktuellen Text-Block.
- Grenzen. Citations müssen für alle oder keine Dokumente einer Anfrage aktiviert sein, nur Text ist zitierbar (gescannte PDFs ohne extrahierbaren Text nicht), und die Kombination mit Structured Outputs liefert einen 400-Fehler.
Beim Start berichtete Anthropic, interne Evaluationen zeigten, dass eingebaute Zitate die meisten eigenen Implementierungen beim Recall um bis zu 15 Prozent übertreffen, und ein Kunde, Endex, nannte einen Rückgang von Quellen-Halluzinationen und Formatproblemen von 10 auf 0 Prozent. Das sind vom Anbieter berichtete Zahlen für konkrete Setups; ich würde sie als Grund nehmen, die Funktion zu testen, nicht als Zahl, die man erwarten darf.
Andere Anbieter
Anthropic ist nicht allein. OpenAIs Web-Search-Tool liefert `url_citation`-Annotationen mit URL, Titel und Position im Text, und die Dokumentation verlangt, dass Inline-Zitate in der Oberfläche klar sichtbar und klickbar sind, wenn du Webergebnisse zeigst. Coheres Chat-API liefert Zitat-Objekte mit Start- und Endposition, dem zitierten Text und den dahinterliegenden Quelldokumenten. Die gemeinsame Idee: Die Aussage des Modells und ihr Beleg reisen als strukturierte Daten zusammen, und deine Oberfläche muss das respektieren.
Eine strukturelle Einschränkung gilt für alle: Das Modell entscheidet weiter, auf welche Passage es zeigt. Ein Zitat sagt dir, was das Modell an einen Satz gehängt hat, nicht dass der Satz daraus folgt.
Schritt drei: den Pfad „Das kann ich nicht beantworten“ gestalten
Wenn das Standardverhalten des Modells das Antworten ist, brauchst du zwei Stellen, um es zu unterbrechen.
Ein Retrieval-Gate vor der Generierung. Schau auf das Retrieval-Ergebnis: keine Passagen über einem Ähnlichkeits- oder Reranker-Schwellwert, eine große Lücke zwischen Frage und Fund oder widersprüchliche Top-Passagen. Überspringe in diesen Fällen den Modellaufruf ganz und antworte mit dem, was fehlt, und dem, was der Nutzer tun kann. Das ist günstiger als Generieren und auch die verlässlichste Abstention, weil sie nicht von der Selbsteinschätzung des Modells abhängt. Kalibriere den Schwellwert an echten Anfragen, nicht nach Gefühl.
Eine Erlaubnis im Prompt. Sage dem Modell, dass „die Dokumente enthalten das nicht“ eine gültige und bevorzugte Antwort ist, wenn die Evidenz fehlt. Ohne diese Erlaubnis wirkt der Benchmark-Anreiz zum Raten weiter.
Gestalte die Abstention als Teil des Produkts:
- Sage, was durchsucht wurde und was nicht gefunden wurde, statt eines nackten „Ich weiß es nicht“.
- Biete einen nächsten Schritt an: umformulieren, eingrenzen, eine andere Quelle durchsuchen oder an einen Menschen übergeben.
- Erlaube Teilantworten: beantworte den gestützten Teil und markiere den ungestützten ausdrücklich.
- Zähle sie. Die Abstention-Rate ist eine Metrik mit gesundem Bereich; null heißt, das System rät, zu hoch heißt, das Gate ist zu streng oder das Retrieval schlecht.
Schritt vier: Aussagen nach der Generierung verifizieren
Das verlässlichste Muster, das ich kenne, um misgrounded Antworten zu fangen, ist, die Antwort in Aussagen zu zerlegen und jede gegen ihren Beleg zu prüfen. Es ist dieselbe Idee wie die Faithfulness-Metrik in Ragas, die eine Antwort in einzelne Statements teilt, prüft, ob sich jedes aus dem abgerufenen Kontext ableiten lässt, und den Anteil gestützter Aussagen berechnet.
Du kannst das mit einem zweiten Modellaufruf selbst bauen oder einen verwalteten Prüfer nutzen:
| Option | Was sie tut | Bemerkenswerte Grenzen (laut Dokumentation) |
|---|---|---|
| Prompt-basierter Selbstcheck (Anthropic-Leitfaden) | Modell sucht pro Aussage ein stützendes Zitat, zieht den Rest zurück | Dieselbe Modellfamilie bewertet ihren eigenen Entwurf; zusätzlicher Aufruf |
| Google Check Grounding API | Zerlegt die Antwort in Aussagen, liefert Support Score von 0 bis 1, Zitate und optionale Scores pro Aussage | Antwort bis 4.096 Tokens, bis zu 200 Fakten; Teilwahrheiten gelten als ungestützt; dokumentiert mit unter 500 ms |
| Amazon Bedrock Contextual Grounding Check | Bewertet Grounding und Relevanz gegen Quelle und Frage; blockiert unter deinem Schwellwert | Nicht für Konversations-QA; Quelle bis 100.000 Zeichen; beim Streaming kann Irrelevanz erst nach dem Senden der Antwort markiert werden |
Drei Entscheidungen tauchen jedes Mal auf:
- Was passiert bei einem Fehlschlag? Optionen: mit entfernter Aussage neu generieren, den Satz streichen, ihn mit Markierung „unverifiziert“ behalten oder die ganze Antwort verweigern. In kritischen Domänen bevorzuge ich Streichen oder Markieren gegenüber stiller Neugenerierung, weil Nutzer sehen sollen, dass etwas entfernt wurde.
- Wo läuft es? Ein blockierender Prüfer fügt Latenz vor dem ersten angezeigten Token hinzu, wenn du auf ihn wartest. Bei Streaming-UIs streame den Entwurf mit Zitaten und aktualisiere den Zustand jedes Satzes, sobald Urteile eintreffen, oder verifiziere vor dem Streaming in den wenigen Abläufen, in denen falsche Antworten teuer sind. Die Transportseite behandelt mein Beitrag zu Streaming-LLM-Features in Nuxt.
- Wer prüft den Prüfer? Ein Prüfer ist ein Modell oder Klassifikator und macht Fehler. Labele ein paar hundert Urteile von Hand und verfolge Precision und Recall des Prüfers selbst, sonst hast du Vertrauen nur von einer ungemessenen Komponente auf die nächste verschoben.
Technik gegen Wirkung
So ordne ich die Techniken danach, was sie tatsächlich adressieren. Ich gebe bewusst keinen Prozentwert pro Zeile an: Die Wirkung hängt von Korpus, Anfragen und Modell ab, und die einzigen Zahlen, denen ich vertrauen würde, sind die, die du auf deinem eigenen Testset misst.
| Technik | Ziel-Fehler | Kosten | Wo sie weiter versagt |
|---|---|---|---|
| Besseres Retrieval (Hybrid, Rerank) | Falsche oder fehlende Passagen | Entwicklungszeit; etwas Latenz | Lücken im Korpus, veraltete Dokumente |
| Prompt-Regeln „nur die Dokumente nutzen“ | Antworten aus dem Modellgedächtnis | Fast keine | Ein Prompt ist eine Bitte, keine Garantie |
| Erlaubnis, „Ich weiß es nicht“ zu sagen | Erzwungenes Raten | Keine | Zu viel Abstention, wenn nicht getestet |
| Retrieval-Evidenz-Gate | Generieren aus schwacher Evidenz | Ein Schwellwert zu kalibrieren | Starke, aber irrelevante Passagen kommen durch |
| Quote-first-Extraktion | Paraphrasen-Drift bei langen Dokumenten | Zusätzliche Tokens oder ein Schritt | Zitate können weiter falsch gelesen werden |
| Native Zitate | Erfundene oder ungültige Referenzen | Etwas mehr Input-Tokens | Gültiger Verweis, ungestützte Aussage |
| Claim-Level-Verifikation | Misgrounded Aussagen | Zusätzlicher Aufruf und Latenz | Prüferfehler; mehrstufiges Schließen |
| Quellen-zuerst-UI | Ungeprüftes Vertrauen | Design- und Frontend-Arbeit | Nutzer, die nie klicken |
Faithfulness messen
Ohne Messung ist jede Änderung in diesem Artikel ein Glaube. Ich würde vier Zahlen auf einem festen Evaluationsset verfolgen und sie in der CI laufen lassen wie Unit-Tests (siehe Evals für Produkt-Features):
- Faithfulness: der Anteil der Aussagen, die der abgerufene Kontext stützt, wie in der Ragas-Definition. Sie ist von Korrektheit getrennt: Eine treue Antwort aus einem falschen Dokument ist falsch.
- Zitat-Precision und -Recall: Wie viele der gezeigten Zitate stützen den Satz wirklich; wie viele der Aussagen haben ein stützendes Zitat.
- Abstention-Qualität: Wie oft lehnt das System bei Fragen ab, die der Korpus nicht beantworten kann; wie oft lehnt es bei beantwortbaren Fragen fälschlich ab.
- Antwort-Korrektheit gegen eine Referenzantwort, damit Faithfulness nicht dein einziges Signal ist.
Baue das Set aus drei Gruppen: beantwortbare Fragen mit bekannten Passagen, unbeantwortbare Fragen und Adversarial-Fragen (veraltete Informationen, nahezu doppelte Dokumente, Fragen, die das Modell zur Nutzung seines eigenen Wissens verleiten). Die meisten Teams lassen die unbeantwortbare Gruppe aus, und deshalb wird ihr Abstention-Verhalten nie getestet.
Quellen in der Oberfläche zeigen
Die Oberfläche ist die letzte Verteidigungslinie und die einzige, die der Nutzer sieht. Diese Muster würde ich einsetzen:
- Nummerierte Inline-Marker neben dem Satz, den sie stützen, nicht ein Linkblock am Ende. Die Anbindung pro Aussage macht das Prüfen erst möglich.
- Vorschau bei Hover oder Tippen mit der zitierten Passage und dem Dokumenttitel. Hier ist `cited_text` nützlich, und es macht eine Prüfung in fünf Sekunden realistisch.
- Deep Links, die die Quelle an der zitierten Stelle öffnen (Seitenzahl, Anker oder markierter Bereich), nicht nur am Anfang eines 60-seitigen PDFs.
- Sichtbarer Verifikationszustand pro Satz oder Antwort: verifiziert, unverifiziert oder entfernt. Hat der Prüfer etwas gestrichen, sag es.
- Ein gestalteter Abstention-Zustand mit nächsten Schritten, wie oben, als normales Ergebnis gestaltet statt als Fehler.
- Zitate, die tatsächlich klickbar und sichtbar sind. OpenAIs Dokumentation macht das für Webergebnisse zur Pflicht, und es ist überall eine gute Regel.
Eine Warnung aus der Stanford-Studie betrifft das Design: Echte, seriös wirkende Zitate machen eine falsche Antwort überzeugender. Lass das Vorhandensein einer Fußnote nicht mehr Sicherheit signalisieren, als deine Verifikation hergibt. Hat dein Prüfer nicht gelaufen, zeige kein Badge „verifiziert“.
Achte auch auf die Technik: Antworten mit Zitaten sind kein reiner Textstrom mehr. Simon Willison wies beim Start der Funktion darauf hin, dass das eine Abstraktion für Antworten erzwingt, die annotierte Chunks statt Text sind. Plane dein Streaming-Protokoll und deine Nachrichtenspeicherung von Anfang an für strukturierte Segmente.
Wo Halluzinationen weiter durchrutschen
Nach allen vier Gates erwarte ich noch diese Fehler, und das würde ich jeweils tun:
- Retrieval-Fehlgriffe, die wie Antworten aussehen. Eine teilweise relevante Passage passiert das Gate und das Modell füllt die Lücke. Gegenmittel: Reranker-Schwellwerte und eine explizite Prüfung „beantwortet diese Passage die Frage?“.
- Falsche oder veraltete Quellen. Die Antwort ist treu zu einem veralteten Dokument. Gegenmittel: Dokumentdatum und Version in den Metadaten, in der UI gezeigt, und Aktualitätsfilter.
- Misgrounded Zitate. Das Problem „gültiger Verweis, ungestützte Aussage“. Gegenmittel: Claim-Level-Verifikation und stichprobenartige menschliche Prüfung.
- Schließen über mehrere Passagen. Summen, Vergleiche und mehrstufige Schlüsse stehen nicht wörtlich in einer Passage, deshalb tun sich Prüfer damit schwer. Gegenmittel: Zahlen mit Code berechnen und die Eingaben zeigen.
- Vergiftete Dokumente. Enthält ein abgerufenes Dokument Anweisungen, folgt das Modell ihnen womöglich. Grounding auf nicht vertrauenswürdigem Text ist eine Sicherheitsfrage; siehe Prompt Injection und die Lethal Trifecta.
- Formatvorgaben. Structured Outputs und Citations lassen sich in der Anthropic-API derzeit nicht kombinieren, eine Extraktions-Pipeline braucht also eine andere Grounding-Strategie, zum Beispiel einen Verifikationsdurchlauf über die JSON-Werte.
- Blinde Flecken des Prüfers. Ein Prüfer kann in beide Richtungen irren. Miss ihn.
Auch die längerfristige Richtung, die ich in meinem Beitrag zu Hybrid-, Agentic- und Long-Context-RAG beschreibe, beseitigt das Problem nicht. Ein Agent, der mehrfach abruft, hat mehr Chancen, die richtige Passage zu finden, und mehr Chancen, einen falschen Schluss zu verketten.
Eine Checkliste, mit der du diese Woche starten kannst
- Füge die Anweisung „Die Dokumente enthalten das nicht“ hinzu und teste sie mit mindestens 20 unbeantwortbaren Fragen.
- Füge ein Retrieval-Gate mit an echten Anfragen kalibriertem Schwellwert hinzu; logge jede Abstention.
- Aktiviere native Citations; lege jeden Chunk in ein eigenes Dokument oder einen `search_result`-Block mit deiner eigenen ID im Source-Feld.
- Speichere zu jeder Antwort die Antwort, die zitierten Passagen und die Retrieval-Scores.
- Füge zuerst auf einer Stichprobe einen Claim-Level-Prüfer hinzu, dann in den Abläufen, in denen falsche Antworten Geld oder Vertrauen kosten.
- Verfolge Faithfulness, Zitat-Precision und -Recall sowie Abstention-Qualität in der CI auf einem festen Evaluationsset.
- Zeige nummerierte, klickbare Zitate mit Passagen-Vorschau und sichtbarem Verifikationszustand.
- Prüfe jede Woche eine Zufallsstichprobe von Antworten mit Zitaten von Hand, denn Zitate können nachträglich rationalisiert sein.
Wenn du nur eines mitnimmst: Mach falsche Antworten billig erkennbar. Ein System, das gelegentlich falsch liegt und seine Belege zeigt, ist ein Werkzeug; eines, das gelegentlich falsch liegt und sicher klingt, ist ein Risiko. Wenn du Hilfe beim Bauen oder Prüfen einer solchen Pipeline brauchst, schau dir meine KI-Engineering-Arbeit an.
Quellen
- Anthropic: Citations (Claude API documentation)
- Anthropic: Search results (Claude API documentation)
- Anthropic: Reduce hallucinations (Claude API documentation)
- Anthropic: Introducing Citations on the Anthropic API
- Simon Willison: Anthropic's new Citations API (24 January 2025)
- OpenAI: Web search guide (url_citation annotations and display requirement)
- Cohere: Documents and citations
- Google Cloud: Check grounding API
- AWS: Amazon Bedrock Guardrails contextual grounding check
- Ragas: Faithfulness metric
- Kalai, Nachum, Vempala, Zhang: Why Language Models Hallucinate (arXiv 2509.04664)
- Magesh et al.: Hallucination-Free? Assessing the Reliability of Leading AI Legal Research Tools (arXiv 2405.20362)
- Wallat, Heuss, de Rijke, Anand: Correctness is not Faithfulness in RAG Attributions (arXiv 2412.18004)
Häufige Fragen
Wie reduziert man Halluzinationen in einer RAG-Anwendung?
Stapele mehrere Schichten, statt dich auf eine zu verlassen. Verbessere zuerst das Retrieval, beschränke das Modell dann auf die bereitgestellten Dokumente, erlaube ihm zu sagen, dass es etwas nicht weiß, lass es die genutzten Passagen zitieren, prüfe jede Aussage gegen diese Passagen und zeige die Quellen in der Oberfläche. Keine einzelne Schicht beseitigt Halluzinationen; Anthropics eigener Leitfaden sagt, diese Techniken senken sie deutlich, entfernen sie aber nicht.
Beseitigt RAG Halluzinationen?
Nein. In der Studie von Stanford und Yale zu kommerziellen juristischen Recherche-Tools lieferten Produkte, die RAG als Lösung vermarkteten, in 17 bis 33 Prozent der Fälle halluzinierte Antworten. Die Studie wertet eine Antwort als halluziniert, wenn sie falsch oder „misgrounded“ ist, also behauptet, eine Quelle stütze etwas, was sie nicht stützt.
Was ist der Unterschied zwischen Faithfulness und Korrektheit?
Faithfulness fragt, ob jede Aussage der Antwort vom abgerufenen Kontext gestützt wird. Korrektheit fragt, ob die Aussage in der Welt stimmt. Eine treue Antwort auf Basis eines veralteten Dokuments ist falsch, aber faithful; eine korrekte Antwort aus dem Modellgedächtnis, die die Dokumente nicht stützen, ist richtig, aber unfaithful. Bei RAG willst du meist beides und misst es getrennt.
Wie funktionieren die Anthropic-Citations?
Du übergibst Dokumente oder search_result-Blöcke mit aktivierten Citations, und die Text-Blöcke der Antwort tragen Zitat-Objekte, die auf Zeichenbereiche, Seitenzahlen oder Content-Blöcke deiner Quellen zeigen. Das Feld cited_text zählt nicht zu den Output-Tokens, und die API garantiert gültige Verweise. Citations lassen sich nicht mit Structured Outputs kombinieren und decken derzeit nur Text ab.
Wann sollte ein LLM „Ich weiß es nicht“ sagen?
Wenn die abgerufene Evidenz die Antwort nicht enthält. Setze es an zwei Stellen um: ein Retrieval-Gate, das die Generierung stoppt, wenn die besten Passagen schwach sind, und ein Prompt, der dem Modell ausdrücklich erlaubt zu sagen, dass die Dokumente die Information nicht enthalten. Teste es dann mit Fragen, die dein Korpus nicht beantworten kann, sonst wird das Verhalten nie überprüft.
Wie sollte ein Chatbot seine Quellen zeigen?
Nummerierte Marker neben den Aussagen, die sie stützen, die zitierte Passage bei Hover oder Tippen, ein Link zum Originaldokument an der richtigen Stelle und eine Markierung für Antworten oder Sätze, die nicht verifiziert werden konnten. Zeige nie ein Zitat, dessen Verweis auf echten Text nicht geprüft wurde, denn eine selbstsicher wirkende Fußnote macht eine falsche Antwort glaubwürdiger.