Blog/RAG & Retrieval
Semantische Produktsuche für B2B-Shops: Artikelnummern, Hybrid-Retrieval und was du messen solltest
Semantische Suche im B2B-Shop, ohne die Artikelnummern-Suche zu zerstören: Hybrid aus BM25 und Vektoren, Filter, DE/EN/HU, LLM-Query-Parsing, Reranking, Metriken.
Balázs Csorba··13 Min. Lesezeit
- B2B search
- Hybrid search
- Semantic search
- Spryker
- OpenSearch
Das Wichtigste in Kürze
- Im B2B ist die Artikelnummer die wichtigste Suchanfrage. Gib Kennungen eine eigene Spur mit normalisiertem Exakt- und Präfix-Match und lass die semantische Suche nur helfen, wenn diese Spur keine starke Antwort hat.
- Hybridsuche (BM25 plus Vektoren, per Reciprocal Rank Fusion zusammengeführt) schlägt jede Methode allein, weil Einkäufer „10-32-4711“ und „Schraube für Holz außen“ in dasselbe Feld tippen.
- Sortimente, Preislisten und Lagerbestand müssen Pre-Filter innerhalb der Vektorsuche sein, keine Post-Filter, sonst verschwinden Treffer oder werden über Kunden hinweg sichtbar.
- Nutze ein LLM, um Anfragen in Produkttyp, Attribute und Einheiten zu zerlegen, prüfe die Ausgabe gegen den Katalog und cache häufige Anfragen offline, statt bei jedem Tastendruck ein Modell zu rufen.
- Bewerte das System je Anfragetyp: Zero-Result-Rate, Suchabbruchrate und Klickrate, dazu ein kleines bewertetes Anfrage-Set, in dem exakte Kennungen immer auf Platz 1 stehen müssen.
Ein Einkäufer beim Sanitärgroßhändler tippt „4711-32“. Ein zweiter tippt „Edelstahlschraube für Holz außen“. Ein dritter tippt „hex bolt M8x40 A2“. Alle drei nutzen dasselbe Suchfeld, und in den meisten B2B-Shops, die ich gesehen habe, bekommt mindestens einer von ihnen eine leere Seite.
Semantische Suche verspricht, den zweiten und dritten Fall zu lösen. Das Risiko: Sie zerstört den ersten. Dieser Artikel zeigt, wie ich semantisches Retrieval in einen B2B-Katalog einbauen würde, ohne die exakte Artikelnummern-Suche zu verlieren: Architektur, Anfragetypen, Hybrid-Fusion, Filter, drei Sprachen, Synonyme, LLM-Query-Understanding, Reranking, Messung und was das für einen Spryker-Shop auf Elasticsearch oder OpenSearch bedeutet.
Warum B2B-Suche keine Endkunden-Suche ist
B2B-Anfragen sind heterogener als Endkunden-Anfragen. Einkäufer kopieren eine Artikelnummer aus einer Zeichnung, tippen eine Lieferantennummer aus einer alten Bestellung ab, kürzen Branchenjargon ab oder beschreiben einen Anwendungsfall. Baymard, das Endkunden-Shops vergleicht, unterscheidet acht Arten von Suchanfragen und fand, dass 56 % der getesteten Seiten die Suchbedürfnisse der Nutzer nicht ausreichend unterstützen. B2B-Kataloge bringen obendrein kennungs- und spezifikationslastige Daten mit.
Praktische Folge: Keine einzelne Retrieval-Methode ist die richtige. Das ist die Taxonomie, mit der ich in Projekte starte. Die Beispiele sind erfunden, aber die Muster tauchen in echten Suchlogs auf.
| Anfragetyp | Beispiel | Bestes Retrieval | Typischer Fehler |
|---|---|---|---|
| Artikel- oder Teilenummer | „4711-32“, „4711 32“ | Kennungs-Spur: normalisiert exakt, dann Präfix | Bindestriche und Leerzeichen brechen den Exakt-Match; ein Vektor-Zweig liefert Ähnliches |
| Lieferantennummer, EAN | „4006381333931“ | Kennungs-Spur auf eigenem Feld | Als Zahl gespeichert, führende Nullen weg |
| Produkttyp | „Sechskantschraube“ | Lexikalisch plus Vektor, Kategorie-Boost | Komposita und Plurale verfehlen die lexikalische Suche |
| Spezifikation | „M8x40 A2 DIN 933“ | In Filter zerlegt plus lexikalisch | Embeddings verwischen Zahlen und Einheiten |
| Anwendungsfall | „Schraube für Holz außen“ | Vektor plus Attributfilter | Lexikalische Suche liefert null Treffer |
| Abkürzung oder Jargon | „VA Schraube“ | Synonyme, dann Vektor | Abkürzung dem Analyzer unbekannt |
| Sprachübergreifend | „hex bolt“ im deutschen Katalog | Mehrsprachiger Vektor plus Synonyme | Lexikalische Suche liefert null Treffer |
| Kein Produkt | „Lieferzeit“, „Datenblatt“ | Auf Hilfe- oder CMS-Inhalte routen | Produktindex liefert zufällige Produkte |
Zähle, wie viele deiner echten Anfragen in welche Zeile fallen, bevor du dich für etwas entscheidest. In einem Katalog technischer Teile können die ersten beiden Zeilen einen großen Anteil ausmachen, und genau dort bringt semantische Suche nichts und kann schaden.
Die Architektur: Spuren, Fusion, Rerank
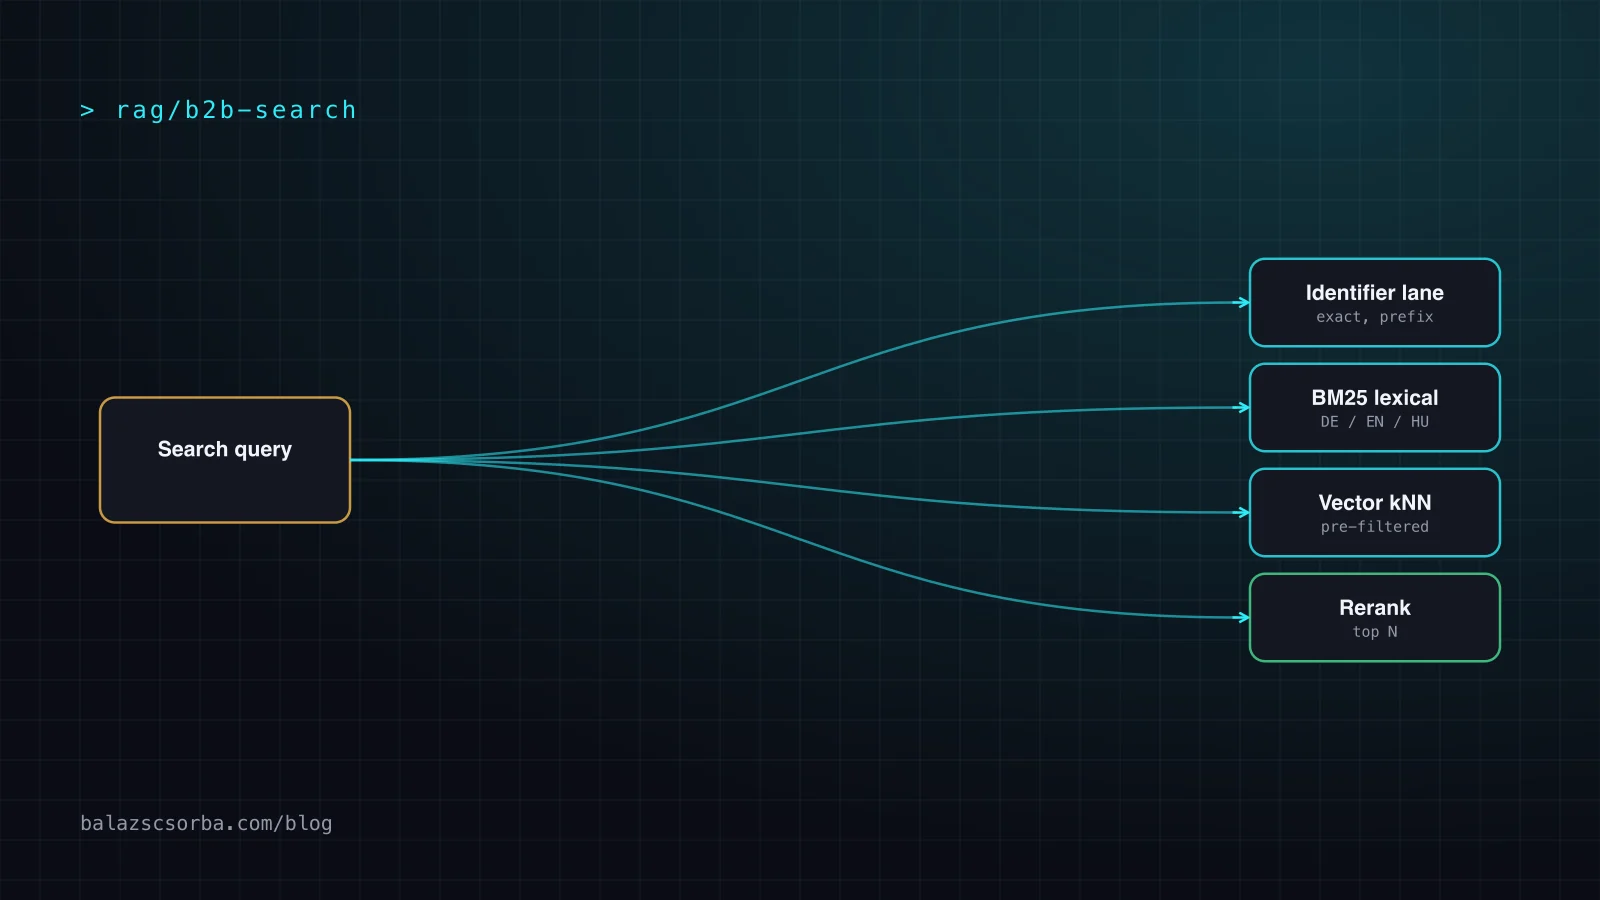
Mein Referenzdesign hat einen Einstiegspunkt und drei parallele Retrieval-Spuren. Ein günstiger Verstehensschritt normalisiert die Anfrage und erkennt, ob sie wie eine Kennung aussieht. Die Kennungs-Spur, eine lexikalische BM25-Abfrage und eine Vektor-kNN-Abfrage laufen alle unter denselben Filtern. Ihre Ranglisten werden fusioniert, ein Reranker sortiert nur die Spitze der Liste neu, und die Antwort enthält die Facetten, die der Shop braucht.
Zwei Designentscheidungen tragen das meiste Gewicht. Erstens: Die Kennungs-Spur ist kein Feature der lexikalischen Spur, sondern eine eigene Abfrage auf eigenen Feldern, und ihre Treffer können den Rest kurzschließen. Zweitens: Die Filter sitzen vor allen Spuren, weil sie im B2B nicht bloß Facetten sind, sondern Berechtigungen.
Als Engine funktionieren Elasticsearch und OpenSearch gleichermaßen. Beide unterstützen BM25, approximatives kNN und Rank-Fusion. Ich würde nehmen, was deine Plattform ohnehin betreibt, und keine zweite Suchmaschine einführen, bevor du der ersten entwachsen bist.
Artikelnummern und Exakt-Match kommen zuerst
Der billigste Weg, eine B2B-Suche zu ruinieren, ist, ein semantisches Modell entscheiden zu lassen, wie ähnlich sich zwei Teilenummern sind. Für ein Embedding sind „4711-32“ und „4711-33“ fast identisch, für einen Einkäufer sind es zwei verschiedene Teile. Deshalb bekommen Kennungen eine eigene Behandlung.
Das gehört in meine Kennungs-Spur:
- Eigene Keyword-Felder für Artikelnummer, Herstellernummer, Lieferantennummer, kundenspezifische Nummer und EAN, immer als Strings gespeichert.
- Ein Normalizer, der beim Indexieren und bei der Anfrage klein schreibt und Bindestriche, Punkte, Schrägstriche und Leerzeichen entfernt, sodass „4711-32“, „4711 32“ und „471132“ in derselben Form zusammentreffen.
- Erst exakt, dann Präfix. Ein vollständiger Treffer steht über einem Präfix-Treffer, sodass ein Einkäufer, der die ersten Ziffern tippt, Kandidaten sieht, während eine vollständige Nummer genau ein Produkt findet.
- Ein Kurzschluss. Ist die normalisierte Anfrage ein exakter Kennungstreffer, liefere ihn aus, ohne auf den Vektor-Zweig oder den Reranker zu warten.
Vorsicht bei Analyzern, die Tokens für dich zerlegen. Der Word-Delimiter-Graph-Filter von Elasticsearch kann an Buchstaben-Zahlen-Übergängen trennen, aus „XL500“ werden dann „XL“ und „500“. Das hilft beim Freitext-Match auf Modellnamen und schadet bei Kennungen, ein weiterer Grund, sie in separaten Feldern mit eigener Analyse zu halten.
Hybrid-Retrieval: BM25 plus Vektoren, per Rang fusioniert
Lexikalische Suche ist präzise bei Wörtern, die sie kennt. Vektorsuche findet Bedeutung über Wörter hinweg, die nie zusammen vorkamen. Elastic beschreibt Hybridsuche als oft deutlich besser als die Summe beider Teile und nennt zwei Fusionsverfahren: eine Konvexkombination normalisierter Scores und Reciprocal Rank Fusion (RRF), die die Position in jeder Liste nutzt und deshalb keine Score-Normalisierung braucht.
Ich starte mit RRF. BM25-Scores und Vektorähnlichkeiten liegen auf unterschiedlichen Skalen, und eine gewichtete Summe braucht eine Normalisierung, die leicht falsch wird und sich mit dem Katalog verschiebt. RRF addiert pro Liste 1/(k + Rang), die Skalen müssen also nie zusammenpassen. OpenSearch bietet dieselbe Idee über den Score-Ranker-Prozessor, eingeführt in 2.19, mit einer Rank-Konstante zwischen 1 und 10.000: Eine größere Konstante glättet den Einfluss der Spitzenränge, eine kleinere bevorzugt sie. Dazu gibt es einen Normalization-Prozessor mit den Verfahren Min-Max, L2 und Z-Score, falls du score-basierte Fusion bevorzugst.
Tune zwei Dinge, sobald die erste Version läuft: das Rank-Fenster (wie viele Kandidaten jede Spur beisteuert) und das Gewicht je Spur. Beides sind günstige Experimente gegen ein bewertetes Anfrage-Set, auf das ich im Abschnitt zur Evaluation zurückkomme.
Ein Fehlermodus verdient eine eigene Warnung. Bei einer exakten Kennungsanfrage liefert der Vektor-Zweig trotzdem etwas, und die Fusion kann einen Beinahe-Treffer über das richtige Teil schieben. Deshalb schließt die Kennungs-Spur kurz, und deshalb muss das bewertete Set Kennungsanfragen enthalten, die Platz 1 prüfen.
Attributbewusste Filter, und warum Zahlen Struktur brauchen
Filter sind im B2B keine Kosmetik. Ein Einkäufer darf nur sein verhandeltes Sortiment, seine Preisliste und das sehen, was an seine Adresse geliefert wird. Filterst du nach der Vektorsuche, fragst du nach den zehn nächsten Produkten und wirfst dann die weg, die der Kunde nicht kaufen darf, was eine kurze oder leere Liste hinterlässt. Die kNN-Query von Elasticsearch dokumentiert den Unterschied: Ein Pre-Filter wird während der approximativen Suche angewendet, sodass k passende Dokumente zurückkommen, ein Post-Filter läuft danach und kann weniger als k Ergebnisse liefern, obwohl genug Treffer existieren.
Sortiment, Verfügbarkeit, Sprache und Sichtbarkeit gehören deshalb als Pre-Filter in jede Spur. Ich behandle das als Sicherheitseigenschaft, nicht als Relevanzdetail: Eine Vektor-Spur ohne Berechtigungsfilter kann Produkte zeigen, die ein Kunde nicht sehen darf.
Embeddings sind schwach bei Zahlen und Einheiten. „M8x40“ und „M8x50“ liegen fast gleich im Vektorraum, und „1,5 Zoll“ und „38 mm“ haben wenig gemeinsam. Bei Spezifikationen zerlege ich die Anfrage in strukturierte Attribute (Gewindegröße, Länge, Material, Norm) und wende sie als Filter oder Boosts auf die Attributfelder an, die dein PIM ohnehin pflegt. Der Vektor-Zweig übernimmt dann den unscharfen Teil des Satzes, Anwendungsfall und Produkttyp, und die Attribute den exakten Teil.
Deutsch, Englisch und Ungarisch in einem Katalog
Ein mehrsprachiger Katalog bringt dir drei getrennte Probleme. Deutsch bildet lange Komposita, „Sechskantschraube“ muss „Schraube“ lexikalisch also nicht treffen. Ungarisch ist stark flektiert, die Form, die der Einkäufer tippt, entspricht daher oft nicht der Form im Produkttext. Englische Anfragen gegen einen deutschen Katalog liefern lexikalisch nichts, weil kein Wort gemeinsam ist.
Mein Ansatz kombiniert beide Welten. Die lexikalische Analyse läuft pro Sprache, mit dem Stemming und der Kompositabehandlung, die jede Sprache braucht, auf getrennten Feldern je Locale. Der Vektor-Zweig nutzt ein mehrsprachiges Modell, damit eine Anfrage in einer Sprache ein Produkt finden kann, das in einer anderen beschrieben ist. Das BGE-M3-Paper beschreibt ein solches Modell, mit semantischem Retrieval in mehr als 100 Arbeitssprachen und Eingaben bis 8.192 Tokens. Ich würde trotzdem zwei oder drei Kandidaten mit eigenen Anfragen vergleichen, denn Katalogvokabular ist weit von allgemeinem Text entfernt.
Zwei praktische Regeln. Embedde den Text, den ein Einkäufer wiedererkennt, also Titel, Schlüsselattribute und eine kurze Beschreibung, nicht das ganze Datenblatt. Und berichte jede Metrik je Sprache, weil ein Durchschnitt über drei Sprachen die eine versteckt, in der die Suche kaputt ist.
Synonyme und Teilenummern bleiben wichtig
Vektoren machen Synonyme nicht überflüssig, sie verringern nur den Bedarf. Branchenkürzel, Markenkurzformen, alte und neue Produktnamen und Lieferantennummern lassen sich weiterhin am besten über explizite Regeln lösen, weil du sie lesen, testen und zurücknehmen kannst. Der Synonym-Graph-Filter von Elasticsearch ist nur für Such-Analyzer gedacht, kann als updateable markiert ohne Reindexierung neu geladen werden und bezieht Regeln aus verwalteten Synonym-Sets (standardmäßig bis zu 100.000 Regeln je Set).
Die beste Quelle für Synonyme ist dein eigenes Zero-Result-Log. Prüfe wöchentlich die häufigsten fehlschlagenden Anfragen, entscheide, ob es ein fehlendes Synonym, ein fehlendes Produkt oder eine Anfrage nach etwas ist, das du nicht verkaufst, und halte die Entscheidung fest. Dieses kleine Ritual ist mehr wert als jedes Modell-Upgrade und gibt dem Vektor-Zweig eine saubere Basislinie zum Schlagen.
Query Understanding mit einem LLM
Ein LLM ist gut im Schritt in der Mitte: „Edelstahl-Sechskantschraube 8 mal 40 für draußen“ in eine strukturierte Abfrage mit Produkttyp, Material, Gewindegröße, Länge und Sprache zu verwandeln. Als Suchmaschine taugt es schlecht. Ich nutze es als Parser mit striktem Ausgabeschema (siehe meine Beiträge zu typisierten Entscheidungen und zum Evaluieren von LLM-Features) und für nichts anderes.
Instacarts Bericht über den Umbau des Query Understanding mit LLMs ist eine nützliche Referenz für das Muster. Sie haben die Katalog-Taxonomie in Prompts eingespeist, Guardrails ergänzt, die Ausgaben per semantischer Ähnlichkeit prüfen, und das Ergebnis in ein kleineres, feinabgestimmtes Modell destilliert. Häufige Anfragen kamen aus einem Offline-Cache, nur der seltene Tail ging an ein Echtzeit-Modell, womit ein Latenzziel von 300 ms erreicht wurde. Das ist ein Endkunden-Lebensmittelfall, aber die Form lässt sich auf B2B übertragen.
- Gegen den Katalog validieren. Liefert das LLM ein Material, einen Attributwert oder eine Teilenummer, die in deinen Daten nicht existiert, wirf sie weg. Lass es niemals Kennungen erfinden.
- Häufige Anfragen cachen. B2B-Anfrageverteilungen haben einen kurzen Kopf, ein nächtlicher Batch über die Top-Anfragen entfernt die meisten Echtzeit-Aufrufe.
- Latenzbudget und Fallback festlegen. Ist der Parser spät oder fällt aus, läuft die einfache Hybrid-Abfrage. Die Suche darf nie ausfallen, weil ein Modell langsam ist. Siehe Kosten- und Latenz-Routing.
- Von Kennungen fernhalten. Hat die Kennungs-Spur einen exakten Treffer, wird der Parser gar nicht erst gerufen.
Behandle die geparsten Felder als Hinweise, nicht als Wahrheit. Ein Boost auf ein geparstes Attribut verzeiht Fehler, ein harter Filter auf ein falsch geparstes Attribut erzeugt eine Seite ohne Treffer. Ich starte deshalb mit Boosts und mache ein Attribut erst zum Filter, wenn seine Parse-Genauigkeit belegt ist.
Die Spitze der Liste neu ranken
Die Fusion liefert eine ordentliche Liste, ein Reranker macht die ersten zehn besser. Die Doku zum Semantic Reranking von Elastic erklärt den Trade-off: Ein Cross-Encoder liest Anfrage und Dokument gemeinsam und beurteilt Relevanz besser, zum Preis größerer Modelle, höherer Latenz und mehr Rechenaufwand. Deshalb läuft er auf einem Kandidatenfenster (der Rank-Window-Größe) statt auf der gesamten Ergebnismenge, und deshalb bietet die Dokumentation Wege, die gesendeten Tokens zu begrenzen, da lange Dokumente abgeschnitten werden können, bevor sie das Modell erreichen.
Ich würde ihn nur auf Nicht-Kennungsanfragen anwenden, vielleicht die Top 50 bis 100 Kandidaten neu ranken und einen kurzen Produkttext senden, nicht das Datenblatt. Danach kommen Geschäftssignale: Verfügbarkeit, frühere Bestellungen des Kunden, bevorzugte Lieferanten. Das allgemeine Muster aus Retrieval und Rerank vertieft mein RAG-Pipeline-Artikel.
Evaluation: Zero Results, Abbrüche und ein bewertetes Set
Ohne Messung ist semantische Suche eine Demo. Ich verfolge eine kleine Menge von Suchmetriken, immer nach Anfragetyp und Sprache aufgeteilt.
| Metrik | Was sie dir sagt | Falle |
|---|---|---|
| Zero-Result-Rate | Anteil der Suchen ohne Treffer; Analytics-Tools wie Algolia melden sie als No Results Rate | Semantische Suche senkt sie, indem sie Unsinn liefert; lies sie zusammen mit der Klickrate |
| Suchabbruchrate | Anteil der Suchen, nach denen der Besucher geht (meine Definition: kein Klick, keine Verfeinerung, Sitzung endet) | Braucht eigenes Event-Tracking; Bots und Lesezeichen erzeugen Rauschen |
| Klickrate | Anteil der Suchen mit mindestens einem Klick auf ein Ergebnis | Positions-Bias: Ein besserer Top-Treffer hebt sie, ein schlechter versteckt sich unter der Falz |
| Reformulierungsrate | Anteil der Suchen, auf die in derselben Sitzung eine weitere Anfrage folgt | Etwas Reformulierung ist gesunde Verfeinerung |
| Rang-1-Genauigkeit bei Kennungen | Bewertetes Set: Steht das exakte Teil an erster Stelle | Muss bei 100 % bleiben; jeder Rückgang ist eine Regression |
Das bewertete Set überspringen die meisten Teams. Ich nehme einige hundert echte Anfragen aus den Logs, geschichtet nach den Anfragetypen der ersten Tabelle, und halte fest, welche Produkte richtig sind. Kennungsanfragen prüfen exakt Rang 1, beschreibende Anfragen prüfen, dass ein relevantes Produkt in den Top Ten steht. Lass es bei jeder Änderung an Analyzern, Synonymen, Embeddings oder Fusion-Einstellungen laufen, möglichst in der CI.
Danach folgt ein A/B-Test mit Live-Traffic, der Klickrate, In-den-Warenkorb-Rate aus der Suche und Suchabbruchrate je Anfragetyp vergleicht. Eine Anfrage ohne Treffer ist manchmal korrekt, weil das Teil nicht im Sortiment ist. Jage die Rate also nicht gegen null, sondern die Zahl der Zero-Result-Anfragen, die etwas hätten finden sollen.
Integration in Spryker, Elasticsearch und OpenSearch
Spryker wird mit Elasticsearch als Standardsuche ausgeliefert und indexiert Produktname, Beschreibung und SKU, Produktattribute, Bewertungen und CMS-Seiten. Die Dokumentation beschreibt außerdem Drittanbieter-Integrationen für die Suche und ein Tutorial zur Integration beliebiger Suchmaschinen sowie einen Migrationspfad für OpenSearch von 1.3 über 2.19 auf 3.5. Dieses Upgrade ist hier relevant, weil Hybrid-Fusion in OpenSearch eine aktuelle Version braucht.
Meine vorgeschlagene Integration ist ein Designvorschlag und kein Spryker-Feature und hat vier Schritte. Berechne ein Embedding je Abstract-Produkt und Locale im Publish-and-Sync-Ablauf, der die Suchdokumente baut, und speichere es in einem Vektorfeld neben den Textfeldern. Erweitere die Suchabfrage so, dass sie Kennungs-, lexikalische und Vektor-Klausel unter den bestehenden Filtern des Shops absetzt, und fusioniere sie mit RRF. Setze den LLM-Parser davor, hinter einem Timeout. Und verpacke alles in ein Feature-Flag je Store und Locale.
Zwei Vorbehalte aus der Erfahrung mit diesen Plattformen. Vektoren vergrößern den Index und verlängern die Publish-Zeit, plane den Cluster also entsprechend und embedde nur neu, wenn sich der eingebettete Text ändert. Und behalte die bestehende Suche als Fallback-Pfad: Ist die Vektor-Spur nicht erreichbar, soll der Shop weiter über die lexikalische und die Kennungs-Spur antworten.
Baust du neu, ist ein gehostetes Suchprodukt eine Alternative, und Spryker dokumentiert Integrationen für diesen Weg. Von jedem Anbieter würde ich trotzdem dieselben vier Dinge verlangen: Kennungsbehandlung, Berechtigungs-Pre-Filter, Metriken je Sprache und eine Möglichkeit, dein bewertetes Set laufen zu lassen.
Eine Rollout-Checkliste
In dieser Reihenfolge würde ich arbeiten.
- Exportiere drei Monate Such-Logs und klassifiziere die Anfragen in die Typen der ersten Tabelle. Zähle sie.
- Baue das bewertete Set mit Kennungsanfragen, die Rang 1 prüfen, und miss die aktuelle Suche als Basislinie.
- Behebe die lexikalischen Grundlagen: Kennungsfelder mit Normalizer, Analyzer je Sprache, ein gepflegtes Synonym-Set.
- Füge die Vektor-Spur mit mehrsprachigem Modell, Berechtigungs-Pre-Filtern und RRF-Fusion hinter einem Feature-Flag hinzu.
- Schließe Kennungstreffer kurz, sodass Vektor-Zweig und Reranker sie nie anfassen.
- Ergänze den LLM-Parser mit Schema-Validierung, Offline-Cache für häufige Anfragen, Timeout und Boost-zuerst-Regel.
- Ergänze einen Reranker auf einem kleinen Fenster für Nicht-Kennungsanfragen und prüfe die Latenz bei p95.
- Fahre einen A/B-Test, vergleiche die Metriken je Anfragetyp und Sprache und prüfe das Zero-Result-Log wöchentlich.
Der größte Gewinn in diesen Projekten kommt aus den Schritten 3 und 4, nicht vom modischsten Modell, und das Vertrauen schafft Schritt 2. Mach die Kennungs-Spur zuerst langweilig zuverlässig, dann fühlt sich semantische Suche wie ein Upgrade an statt wie ein Risiko.
Quellen
- Baymard Institute: E-commerce search query types
- Elastic Search Labs: Hybrid search in Elasticsearch
- Elasticsearch documentation: kNN query (pre-filters and post-filters)
- Elasticsearch documentation: Semantic reranking
- Elasticsearch documentation: Word delimiter graph token filter
- Elasticsearch documentation: Synonym graph token filter
- OpenSearch documentation: Score ranker processor (RRF)
- OpenSearch documentation: Normalization processor
- Spryker documentation: Search feature overview
- Spryker documentation: Migrate from OpenSearch 1.3 to 3.5
- Instacart via ZenML: Rebuilding query understanding for e-commerce search with LLMs
- arXiv: M3-Embedding, multilingual, multi-functionality, multi-granularity text embeddings
- Algolia documentation: Search analytics metrics
Häufige Fragen
Was ist semantische Suche im B2B-E-Commerce?
Semantische Suche wandelt Produkttexte und Anfragen in Vektoren um, sodass eine Anfrage wie „Schraube für Holz außen“ passende Produkte auch ohne gemeinsame Wörter findet. In einem B2B-Shop sollte sie die lexikalische Suche ergänzen, nicht ersetzen, weil Artikelnummern, EANs und exakte Spezifikationen weiterhin präzise Treffer brauchen.
Was ist Hybridsuche und warum brauchen B2B-Shops sie?
Hybridsuche führt eine lexikalische Abfrage (BM25) und eine Vektorabfrage parallel aus und fusioniert beide Ranglisten, oft per Reciprocal Rank Fusion. B2B-Shops brauchen sie, weil ihre Einkäufer exakte Kennungen und natürlichsprachliche Beschreibungen mischen und keine der beiden Methoden allein beides gut abdeckt.
Wie bleibt die Artikelnummern-Suche exakt, wenn ich Vektorsuche einsetze?
Indexiere Kennungen in eigenen Feldern mit einem Normalizer, der Groß-/Kleinschreibung, Bindestriche, Punkte und Leerzeichen entfernt, matche sie zuerst exakt und per Präfix und ranke diese Treffer über alles, was der Vektor-Zweig liefert. Verlass dich bei Kennungen nicht auf Embeddings, denn sie behandeln ähnlich aussehende Nummern als ähnlich.
Funktioniert semantische Suche für deutsche, englische und ungarische Kataloge?
Ja, mit einem mehrsprachigen Embedding-Modell und sprachspezifischer Textanalyse. Mehrsprachige Modelle wie BGE-M3 decken mehr als 100 Sprachen ab, aber deutsche Komposita und ungarische Flexion musst du trotzdem mit eigenen Anfragen testen und die Ergebnisse je Sprache messen.
Wie messe ich, ob die Produktsuche besser geworden ist?
Segmentiere nach Anfragetyp und verfolge Zero-Result-Rate, Suchabbruchrate, Klickrate und In-den-Warenkorb-Rate aus der Suche. Ergänze ein Offline-Set bewerteter Anfragen, in dem jede exakte Kennung auf Platz 1 stehen muss. Eine sinkende Zero-Result-Rate allein kann irrelevante Treffer verdecken, lies sie deshalb immer neben der Klickrate.
Kann ich semantische Suche in Spryker einbauen?
Ja. Spryker liefert Elasticsearch als Standardsuche aus und dokumentiert einen OpenSearch-Upgrade-Pfad, du kannst also beim Publish Vektorfelder zu den Suchdokumenten hinzufügen und die Suchabfrage um eine Vektor-Klausel erweitern. Ich würde das als Pilot hinter einem Feature-Flag bauen und mit der bestehenden Suche vergleichen.