Blog/Retrieval & Suche
Text-to-SQL mit LLMs: Schema-Kontext, Read-only-Rollen und Validierung, die hält
Wie genau Text-to-SQL wirklich ist, wie das Modell Schema-Kontext bekommt und welche Datenbank- und Code-Leitplanken generiertes SQL sicher machen.
Balázs Csorba··8 Min. Lesezeit
- Text-to-SQL
- LLM security
- PostgreSQL
- Agents
- Analytics
Das Wichtigste in Kürze
- Die besten BIRD-Systeme erreichen rund 83 % Ausführungsgenauigkeit gegenüber 93 % bei menschlichen Experten, agentische Unternehmensaufgaben in Spider 2.0 sind viel schwerer.
- Genauigkeit kommt vor allem aus dem Schema-Kontext: kuratierte Views, Spaltenbeschreibungen, Beispielwerte, ein Glossar und geprüfte Beispielabfragen.
- Sicherheit zuerst in der Datenbank erzwingen: eine Rolle mit SELECT nur auf kuratierte Views, Read-only-Transaktionen, Timeouts und Row-Level Security.
- Im Code als zweite Schicht validieren: SQL parsen, genau ein SELECT erlauben, Tabellen gegen eine Allowlist prüfen und ein Zeilenlimit setzen.
- Dem Nutzer das generierte SQL und die Ergebnistabelle zeigen und an eigenen Fragen durch Vergleich der ausgeführten Ergebnisse evaluieren.
Jedes Unternehmen mit einer Datenbank hat jemanden, der ihr Fragen in normaler Sprache stellen will: Wie viele Bestellungen kamen im letzten Quartal aus Österreich, welche Kunden kaufen nicht mehr, welche Artikel liegen unter dem Mindestbestand. LLMs schreiben ordentliches SQL, die Demo dauert also einen Nachmittag. Die Produktion dauert länger, denn die schweren Teile sind nicht die Generierung, sondern der richtige Schema-Kontext und die Gewissheit, dass eine falsche oder manipulierte Abfrage keinen Schaden anrichten kann.
Dieser Artikel beginnt damit, was die Benchmarks zur Genauigkeit sagen, und geht dann die Architektur durch, die ich nutze: kuratierter Schema-Kontext, eine Datenbankrolle, die nur lesen darf, was sie soll, Validierung im Code und eine Prüfschleife mit dem Nutzer. Die Beispiele verwenden PostgreSQL, die Schichten gelten aber für jede SQL-Datenbank.
Wie genau ist Text-to-SQL heute?
BIRD ist der Standard-Benchmark für realistische Datenbanken: 12.751 Frage-SQL-Paare über 95 Datenbanken mit zusammen 33,4 GB, mit unsauberen Werten und benötigtem Zusatzwissen. Das Leaderboard nennt für Menschen (Data Engineers und Datenbankstudierende) 92,96 % Ausführungsgenauigkeit im Testset. Die besten Systeme erreichen im September 2026 rund 83 %, und sie bekommen Oracle-Wissenshinweise, die eigene Nutzer nicht mitliefern.
Spider 2.0 zeigt das Unternehmensende: 632 Workflow-Aufgaben auf echten Datenbanken in BigQuery, Snowflake und anderen, oft mit mehr als 1.000 Spalten und SQL über 100 Zeilen. Bei Veröffentlichung löste ein Code-Agent auf Basis von o1-preview 21,3 % davon, gegenüber 91,2 % auf dem ursprünglichen Spider und 73,0 % auf BIRD. Die Lehre ist nicht, dass Text-to-SQL scheitert, sondern dass die Genauigkeit davon abhängt, wie viel von der Bedeutung des Schemas das Modell findet.
Wie sieht eine sichere Text-to-SQL-Architektur aus?
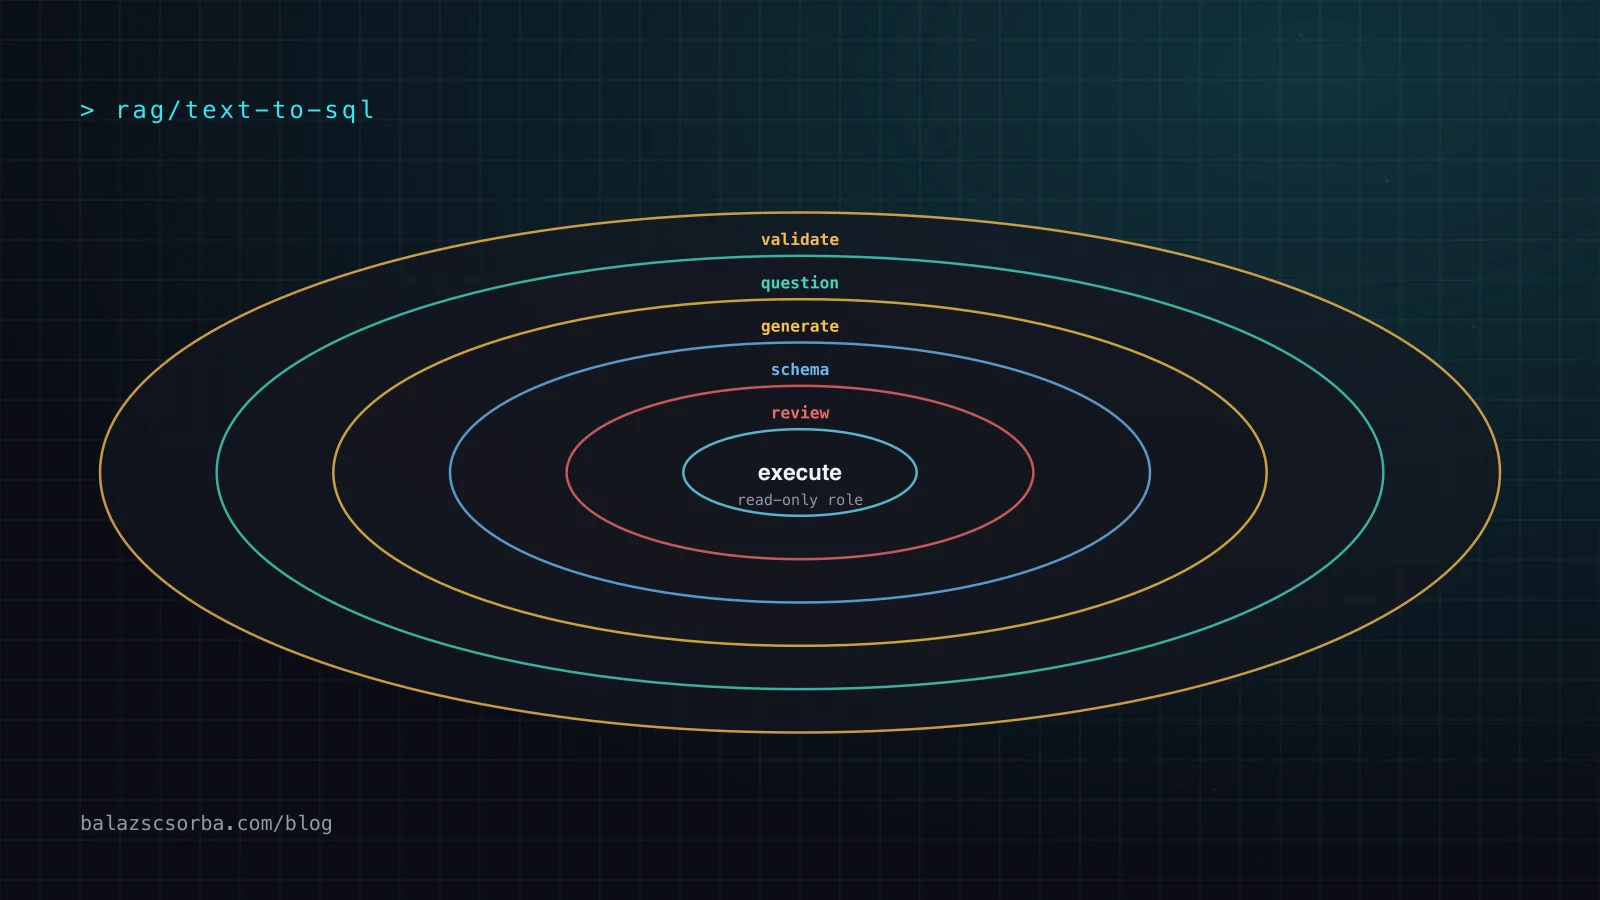
Die Reihenfolge zählt. Die Datenbankschicht ist die Garantie; der Validator ist eine schnelle zweite Schicht, die dem Modell nützliche Fehler liefert; die Prüfung durch den Nutzer fängt Abfragen, die gültig und sicher sind und trotzdem die falsche Frage beantworten.
Welchen Schema-Kontext braucht das Modell?
Rohe CREATE TABLE-Anweisungen reichen nicht. Spaltennamen wie kz_status oder art_typ sagen einem Modell nichts, und neuen Mitarbeitern auch wenig. Was hilft, grob nach Wirkung sortiert:
- Kuratierte Views mit lesbaren Namen, die die Tabellen verbinden, nach denen tatsächlich gefragt wird, etwa
v_ordersmit Kundenland und Nettobetrag in Euro. - Spaltenbeschreibungen mit Einheiten, Codes und deren Bedeutung: Status 3 heißt versendet, Beträge sind netto, Datumswerte in Ortszeit.
- Beispielwerte für Spalten mit wenigen Ausprägungen, damit das Modell
country = 'AT'schreibt und nichtcountry = 'Austria'. - Ein Geschäftsglossar: Was als aktiver Kunde zählt, welche Bestellungen als Umsatz zählen, wie ein Geschäftsjahr definiert ist.
- Geprüfte Beispielabfragen, Paare aus Frage und SQL, die jemand kontrolliert hat, nach Ähnlichkeit zur neuen Frage abgerufen.
Bei großen Schemata nicht alles in den Prompt kopieren. Die relevanten Views und Beschreibungen pro Frage abrufen, genau wie Dokumente bei RAG. In Glossar und Beispiele fließt auch die meiste laufende Arbeit: Jede falsche Antwort, die ein Nutzer meldet, sollte als neues geprüftes Beispiel oder korrigierte Beschreibung enden.
Welche Leitplanken gehören in die Datenbank?
OWASP führt Excessive Agency als Top-Risiko für LLM-Anwendungen und nutzt fast genau diesen Fall als Beispiel: Ein Agent, der nur Lesezugriff auf eine Produkttabelle braucht, sollte keine anderen Tabellen anfassen oder Datensätze ändern können, und das sollte über Datenbankrechte der Identität erzwungen werden, mit der sich der Agent verbindet. Das ist dasselbe Prinzip wie in KI-Agenten sind Identitäten.
-- A role for the assistant: SELECT on curated views, nothing else
CREATE ROLE sql_assistant LOGIN PASSWORD :'pw' NOSUPERUSER NOCREATEDB NOCREATEROLE;
REVOKE ALL ON SCHEMA public FROM sql_assistant;
GRANT USAGE ON SCHEMA reporting TO sql_assistant;
GRANT SELECT ON reporting.v_orders, reporting.v_customers, reporting.v_stock TO sql_assistant;

-- Every transaction read-only, every statement time-limited
ALTER ROLE sql_assistant SET default_transaction_read_only = on;
ALTER ROLE sql_assistant SET statement_timeout = '5s';
ALTER ROLE sql_assistant SET transaction_timeout = '10s';

-- Row-level security on the base table: each session sees only its tenant
-- (views need security_invoker = true so the policy applies to the caller)
ALTER TABLE orders ENABLE ROW LEVEL SECURITY;
CREATE POLICY tenant_only ON orders FOR SELECT TO sql_assistant
  USING (tenant_id = current_setting('app.tenant_id')::int);
ALTER VIEW reporting.v_orders SET (security_invoker = true);
| Kontrolle | Was sie verhindert |
|---|---|
| SELECT nur auf kuratierte Views | Lesen von Gehältern, Passwort-Hashes, anderen Schemata |
default_transaction_read_only | Schreibzugriffe, selbst bei zu breitem Grant |
statement_timeout, transaction_timeout | Kartesische Joins und ausufernde Scans |
| Row-Level Security | Dass ein Kunde oder Mandant die Zeilen eines anderen sieht |
| Lese-Replikat | Dass Analyse-Last Shop oder ERP bremst |
Zwei Details aus der PostgreSQL-Dokumentation zu Row Security übersieht man leicht: Der Tabelleneigentümer unterliegt normalerweise keinen Row-Security-Policies, der Assistent darf sich also nie als Eigentümer verbinden, und ist RLS ohne Policy aktiviert, gilt standardmäßig Ablehnung.
Wie validiert man generiertes SQL im Code?
Das SQL mit einem echten Parser parsen statt mit regulären Ausdrücken. SQLGlot parst über 30 Dialekte in einen Syntaxbaum, den man prüfen kann. Die Prüfungen unten lehnen alles ab, was keine einzelne Leseabfrage auf erlaubten Views ist, und setzen ein Zeilenlimit.
# Illustrative validator with sqlglot (second layer; the database role is the guarantee)
import sqlglot
from sqlglot import exp

ALLOWED = {"v_orders", "v_customers", "v_stock"}
WRITE_NODES = (exp.Insert, exp.Update, exp.Delete, exp.Merge, exp.Create, exp.Drop, exp.Alter, exp.Command)
MAX_ROWS = 1000

def validate(sql: str) -> str:
    statements = sqlglot.parse(sql, read="postgres")
    if len(statements) != 1 or statements[0] is None:
        raise ValueError("exactly one statement is allowed")
    tree = statements[0]
    if not isinstance(tree, exp.Query):
        raise ValueError("only SELECT queries are allowed")
    if any(tree.find_all(*WRITE_NODES)):
        raise ValueError("data-modifying statements are not allowed")
    ctes = {c.alias_or_name for c in tree.find_all(exp.CTE)}
    tables = {t.name for t in tree.find_all(exp.Table)} - ctes
    if unknown := tables - ALLOWED:
        raise ValueError(f"unknown tables: {sorted(unknown)}; allowed: {sorted(ALLOWED)}")
    if not tree.args.get("limit"):
        tree = tree.limit(MAX_ROWS)
    return tree.sql(dialect="postgres")
Die Fehlermeldung ans Modell zurückgeben und ein oder zwei Reparaturversuche erlauben. Die Meldungen sind fürs Modell geschrieben: Die Nennung der erlaubten Views reicht oft, damit es die Abfrage korrigiert.
Können Daten in der Datenbank das Modell angreifen?
Ja. Ergebnisse gehen zurück in den Kontext des Modells, und Textspalten wie Produktbeschreibungen, Kundennotizen oder Ticket-Texte können Anweisungen enthalten, die jeder schreiben konnte, der sie bearbeiten durfte. Kann derselbe Agent auch E-Mails senden oder externe APIs aufrufen, hat man alle drei Teile der tödlichen Dreifaltigkeit: private Daten, nicht vertrauenswürdige Inhalte und einen Weg nach draußen. Die Tools des SQL-Assistenten auf Abfragen und Anzeigen beschränken und Freitextspalten nur zusammenfassen, wenn der Nutzer es ausdrücklich verlangt.
Warum sollten Nutzer das generierte SQL sehen?
Der gefährlichste Fehler ist eine Abfrage, die sauber läuft und eine leicht andere Frage beantwortet: netto statt brutto, Bestelldatum statt Rechnungsdatum, stornierte Bestellungen mitgezählt. Das SQL oder eine verständliche Zusammenfassung seiner Filter neben der Ergebnistabelle zeigen und Nutzern einen Klick zum Melden einer falschen Antwort geben. Diese Meldungen speisen Glossar und geprüfte Beispiele.
Wie evaluiert man ein Text-to-SQL-Feature?
Ausführungsgenauigkeit nutzen, die BIRD-Metrik: generierte und Referenzabfrage ausführen und die Ergebnismengen vergleichen, nicht den SQL-Text. 50 bis 100 Fragen aus echten Anfragen bauen, jeweils mit Referenzabfrage, und sie in der CI laufen lassen, sobald sich Modell, Prompt oder Schema-Kontext ändern, wie in LLM-Evals für Produktfeatures. Einen Anteil an Fragen behalten, die abgelehnt werden sollen, etwa nach Daten, die die Rolle nicht sehen darf, und prüfen, dass das System das sagt statt zu raten.
Wann sollte man gar kein freies SQL generieren?
Drehen sich die meisten Fragen um wenige definierte Kennzahlen, Umsatz, Marge, offene Bestellungen, ist ein Semantic Layer oder ein Satz parametrisierter Abfrage-Tools genauer als freies SQL: Das Modell wählt Kennzahl, Dimensionen und Filter, Code baut die Abfrage. Freies SQL lohnt sein Risiko für explorative Fragen von Analysten, die das Ergebnis kritisch lesen können, nicht für Zahlen, die ungeprüft in einen Vorstandsbericht wandern.
Quellen
- BIRD-bench: leaderboard and dataset description
- Lei et al.: Spider 2.0: Evaluating Language Models on Real-World Enterprise Text-to-SQL Workflows (2024)
- PostgreSQL 18 Documentation: Row Security Policies
- PostgreSQL 18 Documentation: Client Connection Defaults (read-only and timeouts)
- SQLGlot: SQL parser, transpiler and optimizer (GitHub)
- OWASP Gen AI Security Project: LLM06:2025 Excessive Agency
Häufige Fragen
Wie genau ist Text-to-SQL im Jahr 2026?
Auf dem BIRD-Benchmark erreichen die besten veröffentlichten Systeme rund 83 % Ausführungsgenauigkeit im Testset, Data Engineers und Datenbankstudierende rund 93 %. Bei Spider 2.0 mit Unternehmensdatenbanken von über 1.000 Spalten löste ein Agent auf Basis von o1-preview bei Veröffentlichung nur 21,3 % der Aufgaben. Das eigene Schema liegt irgendwo dazwischen.
Ist es sicher, ein LLM SQL gegen die Produktion ausführen zu lassen?
Nur hinter Kontrollen auf Datenbankebene. Mit einer eigenen Rolle verbinden, die nur aus kuratierten Views lesen darf, Read-only-Transaktionen erzwingen, Statement-Timeouts setzen, Row-Level Security pro Nutzer oder Mandant anwenden und am besten ein Replikat abfragen. Prompt-Anweisungen allein sind keine Kontrolle.
Brauche ich SQL-Validierung, wenn die Rolle read-only ist?
Ja, als zweite Schicht. Durch Parsen lassen sich mehrere Statements, unbekannte Tabellen und Funktionen sowie teure Muster ablehnen, bevor sie die Datenbank erreichen, und das Modell bekommt eine klare Fehlermeldung zum Reparieren.
Was ist ein Semantic Layer und brauche ich einen?
Ein Semantic Layer definiert Geschäftskennzahlen wie Umsatz oder aktive Kunden einmal im Code. Fragen Nutzer vor allem nach definierten Kennzahlen, sollte das Modell Kennzahlen und Filter aus dieser Schicht wählen statt freies SQL zu schreiben; das ist genauer und konsistenter.
Können Daten in der Datenbank das Modell angreifen?
Ja. Textspalten wie Produktbeschreibungen oder Ticket-Texte können Anweisungen enthalten, die das Modell in den Ergebnissen liest. Abfrageergebnisse als nicht vertrauenswürdige Eingabe behandeln und demselben Agenten keine Tools geben, die Daten nach außen senden können.