Tools/KI-Agenten
Pydantic AI im Test: typisierte Python-Agenten mit geprüfter Ausgabe
Pydantic AI 2.55 bringt typisierte Abhängigkeiten, geprüfte Ausgaben und OpenTelemetry. Was 2.0 änderte, was Logfire kostet und wer es nehmen sollte.
- Art
- Agent framework
- Preis
- MIT · free library, Logfire Team from $49 a month
Balázs Csorba··8 Min. Lesezeit
- Agent framework
- Typed Python
- Structured output
- Dependency injection
- OpenTelemetry
Das Wichtigste in Kürze
- Pydantic AI 2.55.0, veröffentlicht am 9. Oktober 2026, ist MIT-lizenziert und im Betrieb kostenlos. Deine Kosten sind Modell-Tokens und, falls du es nutzt, Logfire-Records.
- Die 2.0-Linie ist seit dem 23. Juni 2026 stabil, nach sieben Betas, und hat die Konfiguration in Capabilities verlagert. Pinne die Version und folge dem Upgrade-Pfad.
- Abhängigkeiten erreichen deine Tools über einen typisierten RunContext, und output_type prüft jede Antwort. Eine fehlgeschlagene Prüfung geht ans Modell zurück, bevor dein Code sie sieht.
- Tracing ist optional und folgt OpenTelemetry, sodass Spans an Logfire oder an jedes OpenTelemetry-Backend gehen können. Durable Runs brauchen Temporal, DBOS, Prefect, Restate oder AWS Lambda.
- Nimm es für typisierte Python-Dienste. Nimm das OpenAI Agents SDK für einen kleinen, OpenAI-zentrierten Stack und LangGraph, wenn explizite Graphen, Checkpoints und Unterbrechungen das Produkt sind.
Pydantic AI ist das Python-Agenten-Framework des Teams hinter Pydantic, der Bibliothek für Datenvalidierung. Abhängigkeiten, Tools und Ergebnisse sind gewöhnliche Python-Typen, und jede strukturierte Antwort des Modells wird geprüft, bevor dein Code sie bekommt. Das Urteil vorweg – nimm es für typisierte Agenten in Python-Diensten, wo das Team ohnehin mit Pydantic-Modellen denkt. Lass es, wenn dein Team in TypeScript baut, einen visuellen Builder als Hauptweg zum Entwerfen von Workflows will oder API-Änderungen zwischen Releases nicht verkraften kann.
Was es ist
Das aktuelle Release ist 2.55.0, auf PyPI veröffentlicht am 9. Oktober 2026. Es ist MIT-lizenziert, braucht Python 3.11 oder neuer und hat auf GitHub rund 20.500 Sterne. Das Projekt nennt sich „How Python does AI“: Agenten, Echtzeit-Sprache, Bildgenerierung und Embeddings, durchgehend typisiert. Die 2.0-Linie wurde am 23. Juni 2026 stabil, deshalb beschreiben ältere Tutorials womöglich noch die 1.x-API.
- Typisierte Abhängigkeiten. `deps_type` legt fest, was ein Agent braucht, und jeder Lauf bekommt eine Instanz über `deps=`.
- Geprüfte Ausgabe. `output_type` nimmt ein Pydantic-Modell, eine Union oder eine Liste von Typen. Das Modell füllt sie standardmäßig über Tool-Calling aus.
- Rund zwei Dutzend Anbieter. Ein Präfix wie `openai:`, `anthropic:` oder `google:` wählt den Anbieter. Das Verzeichnis deckt außerdem Groq, Mistral, Ollama und OpenRouter ab, dazu jeden OpenAI-kompatiblen Endpunkt.
- Capabilities und durable Runs. Capabilities bündeln Tools, Hooks, Anweisungen und Modelleinstellungen zu einer wiederverwendbaren Einheit. Durable Runs werden über Temporal, DBOS, Prefect, Restate und AWS Lambda angebunden.
Wie es funktioniert
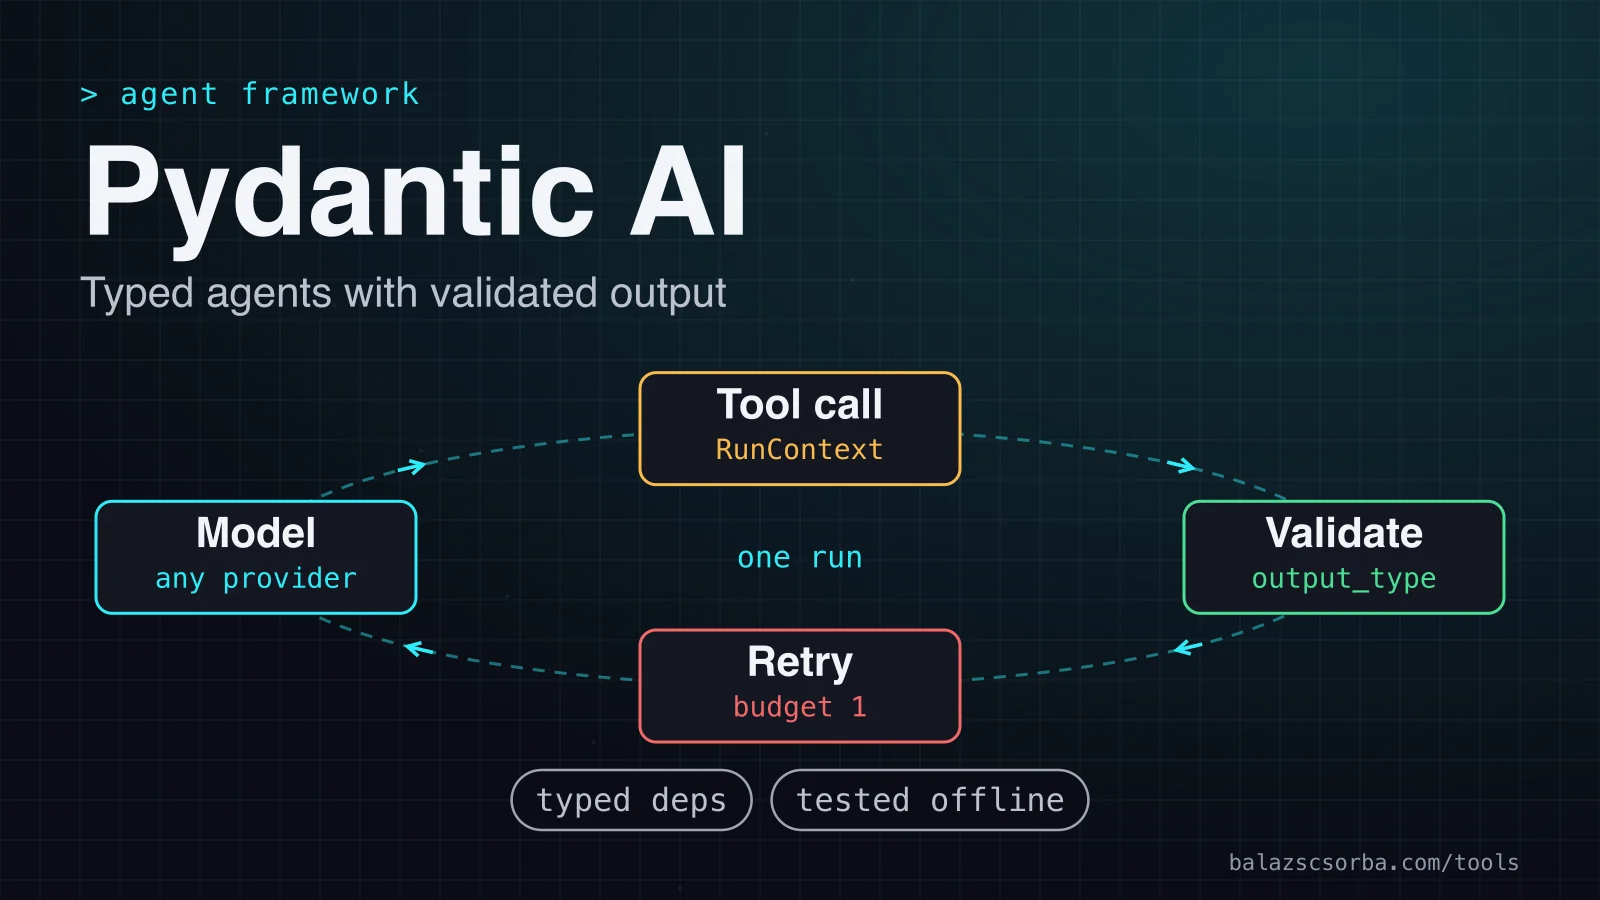
Ein Agentenlauf ist eine Schleife mit einer Prüfung am Ende. Der Agent schickt seine Anweisungen, den Nachrichtenverlauf und die Tool-Schemata an das Modell. Ruft das Modell ein Tool auf, führt Pydantic AI deine Python-Funktion mit dem typisierten Kontext aus und gibt das Ergebnis ans Modell zurück. Hört das Modell auf, Tools aufzurufen, wird seine Ausgabe gegen `output_type` geprüft. Eine fehlgeschlagene Prüfung geht als Wiederholung zurück ans Modell, und das Standardbudget für Wiederholungen der Ausgabe ist eins.
Abhängigkeiten gehen an deine Funktionen, nie an das Modell. Ein Datenbank-Pool oder eine HTTP-Session kann neben dem Agenten stehen, ohne in einem Prompt aufzutauchen. Das Modell sieht nur die Anweisungen, die Tool-Schemata und die Nachrichten. Diese Grenze lohnt es, bewusst zu entwerfen.
Erste Schritte
Installiere mit `uv add pydantic-ai` oder `pip install pydantic-ai` und setze dann die Zugangsdaten, die dein Anbieter erwartet. Das Beispiel unten ist ein Support-Triage-Agent. Er nimmt eine typisierte Abhängigkeit, ruft ein Tool auf und gibt ein geprüftes Objekt zurück.
from dataclasses import dataclass
from typing import Literal

from pydantic import BaseModel, Field
from pydantic_ai import Agent, RunContext

from myshop.orders import OrderService


@dataclass
class SupportDeps:
    customer_id: int
    orders: OrderService  # your own client, injected per run


class Triage(BaseModel):
    category: Literal['refund', 'shipping', 'other']
    risk: int = Field(ge=0, le=10, description='How urgently a person should review this')
    reply: str


support = Agent(
    'openai:gpt-6-sol',
    deps_type=SupportDeps,
    output_type=Triage,
    instructions='Triage the message. Check the order before you answer.',
)


@support.tool
async def latest_order(ctx: RunContext[SupportDeps]) -> str:
    '''Return the status of the most recent order.'''
    return await ctx.deps.orders.latest_status(ctx.deps.customer_id)


result = support.run_sync(
    'Where is my parcel?',
    deps=SupportDeps(customer_id=42, orders=OrderService()),
)
print(result.output.category, result.output.risk)
Zwei Teile des Codes leisten die Arbeit. Die Klasse `Triage` ist sowohl das Schema, das ans Modell geht, als auch der Typ, den dein Code bekommt. Eine Antwort außerhalb der erlaubten Kategorien oder des Risikobereichs von 0 bis 10 wird wiederholt und, wenn sie weiter scheitert, als Fehler ausgelöst, statt deinen Code zu erreichen. Die Annotation `RunContext[SupportDeps]` gibt dem Tool eine typisierte Sicht auf deinen Client, sodass der Editor jedes Attribut prüfen kann, das du verwendest.
Typisierte Abhängigkeiten und geprüfte Ausgabe
Abhängigkeiten würde ich zuerst übernehmen. `deps_type` deklariert den Typ, `RunContext[Deps]` gibt Tools, Anweisungen und Output-Validatoren Zugriff auf `ctx.deps`, und ein Test kann den echten Client mit `agent.override(deps=...)` gegen einen Fake tauschen. Die Verdrahtung bleibt im Konstruktor und im Aufruf statt in globalen Variablen auf Modulebene, und so bleibt der Agent leicht testbar.
Bei der Ausgabe zahlt sich das Framework aus. Standardmäßig liefert das Modell strukturierte Daten über seine Tool-Calling-Schnittstelle, und eine Union von Typen wird zu einem Ausgabe-Tool pro Mitglied. Die Marker `TextOutput` und `PromptedOutput` schalten auf Klartext um, für Modelle mit unzuverlässigem Tool-Calling. `ToolOutput` gibt einem Ausgabe-Tool ein eigenes Wiederholungsbudget, sodass ein komplexer Typ mehr Versuche bekommen kann als ein einfacher.
- `ModelRetry` lässt ein Tool oder eine Ausgabefunktion einen Wert ablehnen und dem Modell sagen, was es ändern soll.
- `@agent.output_validator` führt nach dem Parsen deine eigenen Prüfungen aus, zum Beispiel ob eine Bestellnummer in der Antwort existiert.
- `Agent(retries={'output': N})` erhöht das Wiederholungsbudget der Ausgabe für den ganzen Agenten. Der Standard ist eins.
- `ToolOutput(Fruit, max_retries=2)` gibt einem Ausgabetyp eine eigene Anzahl an Wiederholungen.
Beim Testen zahlt sich der Entwurf aus. `TestModel` ruft jedes Tool auf und liefert eine strukturell gültige Antwort, `FunctionModel` lässt einen Test die Antwort des Modells vorgeben, und `ALLOW_MODEL_REQUESTS=False` blockiert versehentliche Aufrufe echter Anbieter in der CI. Ein Unit-Test des Support-Ablaufs braucht dann weder API-Schlüssel noch Netzwerk.
Tracing und durable Runs
Tracing ist optional. Rufe beim Start `logfire.configure()` und `logfire.instrument_pydantic_ai()` auf, dann wird jeder Lauf, jede Modellantwort und jeder Tool-Aufruf zu einem OpenTelemetry-Span, der den Konventionen für generative KI folgt. Das Logfire-SDK kann dieselben Daten an jedes OpenTelemetry-Backend schicken, was zählt, wenn die Telemetrie in einem System bleiben muss, das das Team ohnehin betreibt. Den größeren Zusammenhang findest du in Agent-Observability mit OpenTelemetry.
Durable Execution ist das zweite Feature, das du verstehen solltest. Die Doku führt acht Engines auf. Temporal, DBOS, Prefect, Restate und AWS Lambda werden gemeinsam mit ihren Anbietern gepflegt, und Kitaru, Apache Airflow und Absurd kommen als externe Integrationen. In 2.x hängst du eine Durability-Capability an den Agenten. Das README-Beispiel fügt `TemporalDurability()` in einem Temporal-Workflow zu den Capabilities eines Agenten hinzu.
Kosten, Hosting und Datenschutz
Stand Oktober 2026 kostet die Bibliothek im Betrieb nichts. Die Lizenz deckt den Code ab, also kommen die Rechnungen aus drei Quellen: Modell-Tokens von deinem Anbieter, Logfire-Records, wenn du Logfire nutzt, und die Infrastruktur für eine Durable-Engine, falls du eine einsetzt. Die Logfire-Tarife zeigen, wie die zweite Rechnung aussieht.
| Tarif | Preis | Inbegriffen | Was sich ändert |
|---|---|---|---|
| Personal | Kostenlos | 10 Mio. Records pro Monat, hart begrenzt | 3 Projekte, 30 Tage Aufbewahrung, 1 Platz und 2 Gäste mit Lesezugriff |
| Team | 49 $ pro Monat | 10 Mio. Records, dann 2 $ pro Mio. | 5 Plätze (bis 12), 10 Gäste, 5 Projekte, 30 Tage Aufbewahrung, Ausgabenlimit |
| Growth | 249 $ pro Monat | 10 Mio. Records, dann 2 $ pro Mio. | Unbegrenzte Plätze, Gäste und Projekte, 90 Tage Aufbewahrung, Priority-Support und BAA-Vorlage |
| Enterprise | Individuell | Nach Vereinbarung | Cloud, Dedicated oder Self-hosted; SSO, SCIM und ein SLA |
Logfire rechnet Records ab: Logs, Spans und Metriken. Die inbegriffenen 10 Millionen pro Monat sind durch das Plan-Guthaben abgedeckt, darüber kosten Team und Growth 2 $ pro Million. Ein Team, das 30 Millionen Records im Monat sendet, zahlt 49 $ plus 40 $ für die zusätzlichen 20 Millionen, also rund 89 $ vor allen Modell-Tokens. Das AI-Gateway schlägt bei eingebauten Anbietern 5 Prozent Aufschlag drauf, während bis zu drei eigene Anbieter-Schlüssel ohne Aufschlag durchgereicht werden.
Selbst hosten ist der Standard, weil die Bibliothek einfach nur Code in deiner eigenen Umgebung ist. Die Enterprise-Stufe von Logfire ergänzt eine selbst gehostete Option auf deinem eigenen Kubernetes-Cluster. Für den Datenschutz zählen drei Flüsse. Der Modellanbieter bekommt Prompts und Tool-Ergebnisse, also stehen dessen Auftragsverarbeitungsbedingungen und Region an erster Stelle. Logfire bekommt jeden Span, den du exportierst, also schließe Prompts und Completions dort aus, wo du sie nicht brauchst. Pydantic bietet außerdem einen Data Processing Addendum für die DSGVO, einen SOC-2-Type-2-Bericht auf Anfrage und eine veröffentlichte Liste der Unterauftragsverarbeiter.
Die Region ist auf jedem Tarif eine Einstellung, die du prüfen solltest. Die Tarifmatrix setzt bei jedem gehosteten Tarif, von Personal bis Enterprise Cloud, ein Häkchen bei EU- oder US-Datenregion. Enterprise Dedicated bietet eine beliebige Google-Cloud-Region, und Self-hosting hält die Daten dort, wo du sie betreibst. Die Preisseite sagt nicht, welche Region ein neues Projekt standardmäßig bekommt, also prüfe das, bevor du personenbezogene Daten schickst. Die allgemeinere Frage zur Datenresidenz bei Modell-APIs behandelt ein eigener Artikel.
Wo es zu kurz greift
Das größte Risiko ist Veränderung – und das Changelog ist offen darüber. Die 2.0-Linie durchlief sieben Betas zwischen dem 20. Mai und dem 10. Juni 2026, bevor das stabile Release am 23. Juni kam. Die Breaking Changes kommen in zwei Gruppen: Entfernungen, die die Deprecation-Warnungen von V1 nicht ankündigen konnten, und Änderungen, vor denen V1 gewarnt hat. Entfernt wurden unter anderem die Outlines-Integration und ihre Extras, und `ModelProfile` wurde von einer Dataclass zu einem TypedDict. Eine Migration ist eine echte Aufgabe, kein Versionssprung.
Auch kleinere Releases kommen häufig. Version 2.51.0 erschien am 25. September 2026 und 2.55.0 am 9. Oktober, ein lose gepinntes Projekt sieht also in zwei Wochen mehrere Änderungen. Die Versionsrichtlinie verspricht keine absichtlichen Breaking Changes in kleineren Releases, aber Funktionen in einem Beta-Modul sind ausdrücklich instabil und können sich so ändern, dass bestehender Code bricht. Behandle jeden Import aus einem Beta-Modul wie eine gepinnte Abhängigkeit.
Behalte außerdem die Sicherheitshinweise im Blick. Release 2.52.0 behob ein Problem mit CPU und Speicher im lokalen Tool `web_fetch`, bei dem tief verschachteltes HTML übermäßig viele Ressourcen verbrauchen konnte. Das providereigene Web-Fetching war nicht betroffen. Und schließlich – es ist eine Python-Bibliothek. Teams, die Agenten in TypeScript bauen, brauchen ein anderes Framework, und Durable-Engines bringen Infrastruktur mit, die jemand betreiben oder bezahlen muss.
| Tool | Lizenz | Version, Oktober 2026 | Stärke | Tracing |
|---|---|---|---|---|
| Pydantic AI | MIT | 2.55.0 | Typisierte Abhängigkeiten und geprüfte Ausgabe in Python | Optional, über Logfire oder OpenTelemetry |
| OpenAI Agents SDK | MIT | 0.23.1 | Sehr wenige Primitive: Agenten, Handoffs, Guardrails, Sessions | Standardmäßig an, exportiert an OpenAI, sofern nicht abgeschaltet |
| LangGraph | MIT | 1.2.14 | Explizite Graphen mit Checkpoints, Unterbrechungen und Fehlertoleranz | LangSmith, eine eigene Plattform |
Fazit
Pydantic AI ist mein Standard für ein Python-Team, das seine Daten bereits mit Pydantic modelliert und Agenten will, die typisiert, testbar und leicht neben dem Rest des Dienstes zu betreiben sind. Es ist die falsche Wahl für eine TypeScript-Codebasis, für ein Team, das einen visuellen Graph-Editor als wichtigstes Entwurfswerkzeug will, und für jedes Team, das API-Änderungen zwischen Releases nicht verkraftet. In diesen Fällen passen die Alternativen unten besser.
- Nimm Pydantic AI wenn deine Dienste in Python laufen, deine Daten schon in Pydantic-Modellen stehen und du typisierte Tools und geprüfte Ausgaben willst.
- Nimm das OpenAI Agents SDK, wenn du dich auf OpenAI festgelegt hast und sehr wenige Primitive willst. Schalte Tracing ab oder füge einen eigenen Processor hinzu, bevor echte Kundendaten hindurchlaufen.
- Nimm LangGraph, wenn der Workflow das Produkt ist: expliziter Zustand, Checkpoints und benannte Freigabeschritte. Du schreibst mehr Code und kontrollierst jeden Übergang.
Quellen
- Pydantic-AI-Dokumentation
- pydantic-ai 2.55.0 auf PyPI (veröffentlicht am 9. Oktober 2026)
- pydantic/pydantic-ai auf GitHub: Lizenz, Sterne und README
- Pydantic-AI-Release-Notes: 2.51.0 bis 2.55.0 und der Sicherheitsfix in 2.52.0
- Pydantic-AI-Versionsrichtlinie
- Pydantic-AI-Upgrade-Leitfaden: die V2-Betas und das stabile Release
- Pydantic-AI-Output: Tool-Ausgabe, Wiederholungen und Output-Validatoren
- Pydantic-AI-Abhängigkeiten und RunContext
- Pydantic-AI-Modelle und Anbieter
- Pydantic-AI-Unit-Tests mit TestModel und FunctionModel
- Pydantic-AI-Überblick zu Durable Execution
- Pydantic Logfire: Observability für Pydantic AI
- Pydantic Logfire: Preise
- Pydantic: Sicherheit und Compliance
- OpenAI-Agents-SDK-Dokumentation
- OpenAI-Agents-SDK: Tracing
- openai/openai-agents-python auf GitHub
- openai-agents 0.23.1 auf PyPI
- langchain-ai/langgraph auf GitHub
- langgraph 1.2.14 auf PyPI
- LangGraph-Überblick
- LangGraph-Interrupts
Häufige Fragen
Was kostet Pydantic AI?
Stand Oktober 2026 ist die Bibliothek MIT-lizenziert und kostenlos. Die Rechnung kommt von deinem Modellanbieter und, wenn du Logfire nutzt, von dessen Records: Personal ist bis 10 Millionen Records pro Monat kostenlos, danach wird die Aufnahme an dieser Grenze angehalten. Team kostet 49 $ im Monat, Growth 249 $ im Monat, und Enterprise wird individuell angeboten.
Ist die 2.x-Linie stabil genug für die Produktion?
Ja, mit der üblichen Sorgfalt. Kleinere Releases sollen öffentliche APIs nicht brechen, aber Funktionen in Beta-Modulen können sich ändern, und jede Hauptversion entfernt, was vorher als veraltet markiert war. Sicherheitsfixes für V1 laufen noch mindestens sechs Monate nach dem stabilen 2.0-Release weiter, also plane den Umstieg.
Wie vergleicht es sich mit dem OpenAI Agents SDK und LangGraph?
Das OpenAI Agents SDK ist kleiner und schaltet Tracing standardmäßig ein. LangGraph ist um explizite Graphen mit Checkpoints und Unterbrechungen herum gebaut. Pydantic AI liegt dazwischen: typisierte Abhängigkeiten und geprüfte Ausgaben für Python-Code, mit einem Anbieter-Präfix für etwa zwei Dutzend Anbieter.
Bekommt Logfire meine Prompts?
Nur die Spans, die du exportierst. Die Instrumentierung ist optional, die Doku beschreibt, wie du Prompts und Completions aus den Spans ausschließt, und Pydantic bietet einen Data Processing Addendum, einen SOC-2-Type-2-Bericht auf Anfrage und eine Liste der Unterauftragsverarbeiter.