Blog/LLMOps & Evals
Observability für LLM-Agenten mit OpenTelemetry: Traces, Tokens, PII und Evals
So tracest du LLM-Agenten mit OpenTelemetry: GenAI Semantic Conventions und ihr Status, Span-Baum, Token-Metriken, Sampling, PII, Evals und Tool-Optionen.
Balázs Csorba··12 Min. Lesezeit
- OpenTelemetry
- LLM observability
- AI agents
- Tracing
- Evals
Das Wichtigste in Kürze
- Die OpenTelemetry GenAI Semantic Conventions liegen jetzt in einem eigenen Repository und haben weiter den Status Development. Pinne Versionen und rechne mit umbenannten Attributen.
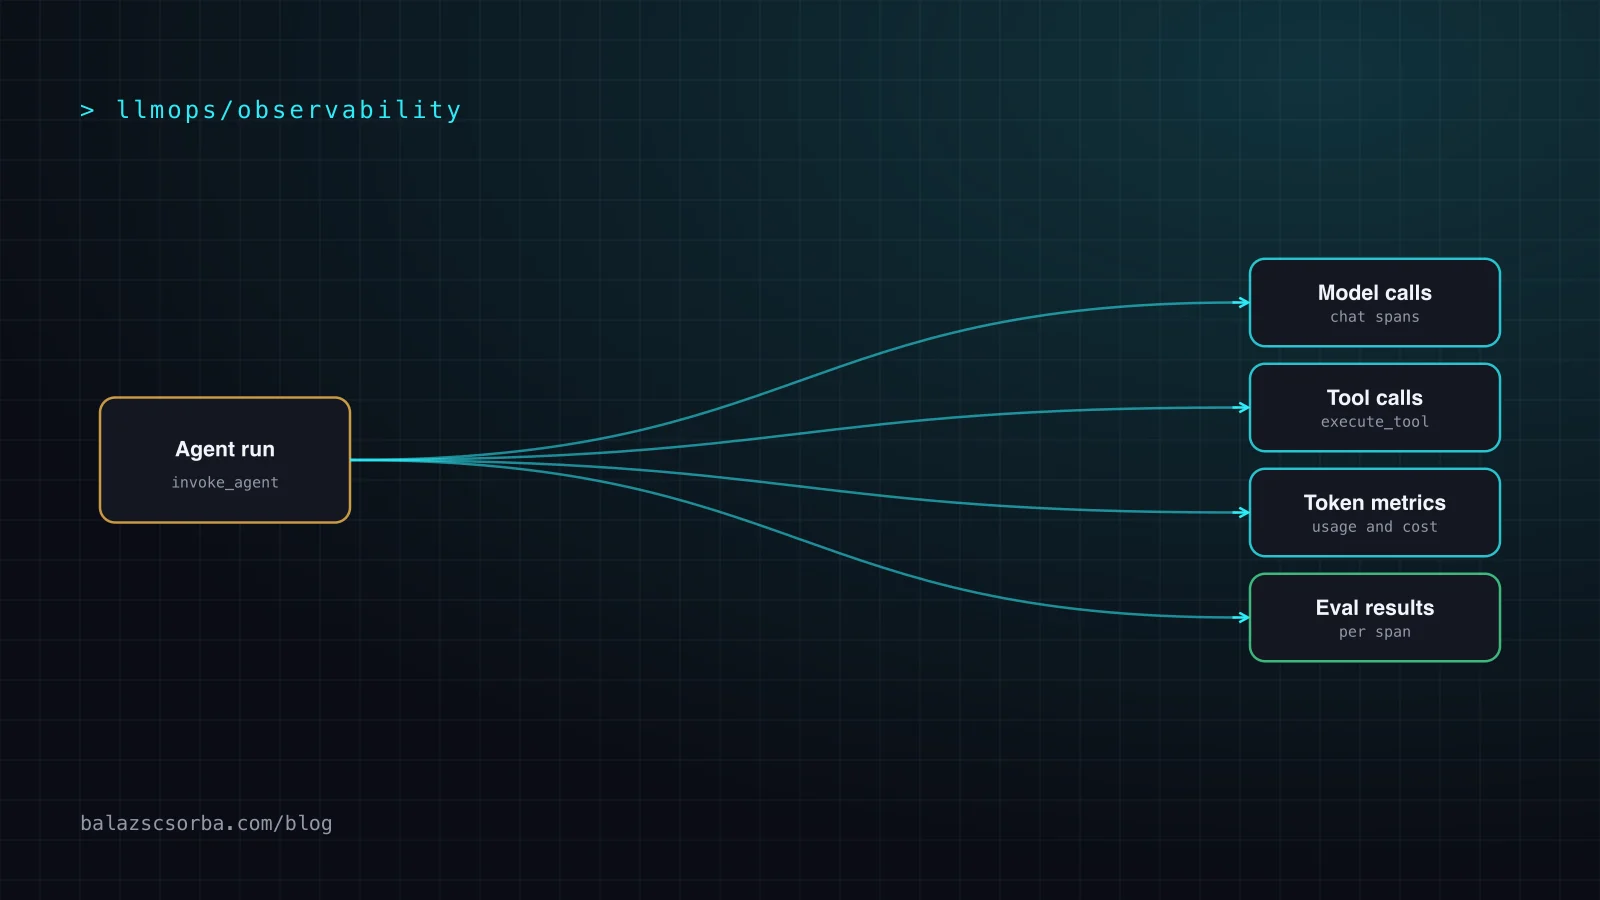
- Bilde einen Agentenlauf als einen Trace ab: ein invoke_agent-Root-Span, chat-Spans für jeden Modellaufruf und execute_tool-Spans für jeden Tool-Aufruf. Erst dieser Baum macht Schleifen und verschwendete Schritte sichtbar.
- Erfasse Token-Zahlen, Modell, Finish Reason und Fehlertyp auf jedem Span, lass aber Prompts, Tool-Argumente und Ergebnisse standardmäßig draußen (in den Conventions sind sie Opt-in) und speichere sie getrennt, wenn du sie brauchst.
- Sample nach Ergebnis, nicht per Münzwurf: Behalte jeden Fehler, jeden langsamen oder teuren Lauf und jeden fehlgeschlagenen Eval, dazu einen kleinen Anteil vom Rest. Denk daran, dass Evals meist erst nach dem Trace fertig sind.
- Jedes OTLP-Backend kann Agenten-Traces annehmen. Die echten Unterschiede sind, wie gut es die gen_ai-Attribute versteht, wo es gehostet wird und was es kostet. Starte mit dem Standard und halte den Exporter austauschbar.
Ein klassischer Web-Request ist ein Aufruf, eine Antwort und ein Stacktrace, wenn etwas kaputtgeht. Ein Agentenlauf ist ein kleines Programm, das das Modell beim Laufen selbst schreibt: Es plant, ruft ein Tool auf, liest das Ergebnis, ruft das Modell erneut auf, versucht es nochmal und läuft manchmal in einer Schleife, bis ein Budget aufgebraucht ist. Wenn so ein Lauf viermal so viel kostet wie nötig oder unbemerkt eine falsche Antwort liefert, zeigen dir Logs verstreute Zeilen, nicht die Form dessen, was passiert ist.
Distributed Tracing ist schon das richtige Werkzeug für die Frage „was ist in welcher Reihenfolge passiert und wie lange hat jeder Teil gedauert“. OpenTelemetry (OTel) ist der herstellerneutrale Weg, Traces zu erzeugen, und hat inzwischen eigene GenAI Semantic Conventions. Sie sind jung, immer noch als Development markiert und gerade umgezogen. Dieser Artikel handelt also genauso davon, was du pinnen und kapseln solltest, wie davon, was du erfassen solltest.
Ich gehe durch die Conventions und ihren echten Status, den Span-Baum eines Agentenlaufs, was auf jeden Span gehört, Token- und Kostenmetriken, Sampling, PII, die Verbindung zu Evals und wie die gängigen Backends dazu passen. Am Ende steht eine Checkliste. Ich setze voraus, dass du weißt, was eine Agent Loop ist.
Warum Agenten Traces brauchen und nicht nur Logs
Drei Fehlerbilder von Agenten sind ohne Trace fast unsichtbar. Schleifen und verschwendete Schritte: Das Modell ruft dasselbe Such-Tool fünfmal mit leicht veränderten Argumenten auf. Stille Verschlechterung: Ein Retrieval-Schritt liefert nichts, das Modell antwortet aus dem Gedächtnis und die Ausgabe wirkt plausibel. Kostendrift: Eine Prompt-Änderung oder ein größeres Tool-Ergebnis bläht den Kontext auf, und jeder spätere Modellaufruf im Lauf wird teurer.
Alle drei sind Eigenschaften eines ganzen Laufs, nicht eines einzelnen Aufrufs. Ein Trace liefert dir den Lauf als Baum mit Zeit, Token-Zahlen und Ergebnis pro Knoten und lässt dich die Fragen stellen, auf die es ankommt: Wie viele Modellaufrufe pro Anfrage im p95, welches Tool schlägt am häufigsten fehl, welcher Schritt dominiert die Latenz. Wenn du nur loggst, baust du aus Korrelations-IDs ein schlechteres Tracing-System nach.
Die GenAI Semantic Conventions: was es gibt und wie stabil es ist
Semantic Conventions sind die vereinbarten Namen für Attribute, Spans und Metriken, damit ein Backend Telemetrie aus jeder Bibliothek versteht. Für GenAI decken sie Modell-Spans (Inference, Embeddings, Retrieval, Memory), Agenten-Spans (create_agent, invoke_agent, invoke_workflow, plan), Tool-Ausführung, Metriken, Events und eine MCP-Convention ab. Providerspezifische Seiten gibt es für Anthropic, OpenAI, AWS Bedrock und Azure AI Inference.
Zwei Fakten zählen, bevor du darauf aufbaust. Erstens sind die Conventions umgezogen: Die Seite auf opentelemetry.io leitet nur noch auf das eigene Repository open-telemetry/semantic-conventions-genai weiter. Zweitens sind sie nicht stabil. Die Übersichtsseite trägt den Status Development, und in der Juli-2026-Auswertung, die ich als unabhängige Quelle genutzt habe, war kein GenAI-spezifisches Attribut, kein Span, keine Metrik und kein Event als Stable markiert (nur gemeinsame Attribute wie error.type sind es). Rechne damit, dass sich Namen zwischen Releases ändern.
Praktisch bedeutet das einen Versionsschalter. Instrumentierungen, die die älteren Conventions unterstützten, liefern standardmäßig weiter die eingefrorene Ausgabe der Version 1.36 und brauchen OTEL_SEMCONV_STABILITY_OPT_IN=gen_ai_latest_experimental, um die neuere Form zu senden. Nicht jedes Framework behandelt diese Variable gleich, also prüfe einen echten exportierten Span, statt der Doku zu vertrauen. Datadog zum Beispiel verlangt die Form ab Version 1.37.
Der Trace-Baum: ein Lauf, ein Trace
Die Conventions definieren die Span-Arten, die du brauchst. Die Wurzel ist ein invoke_agent-Span (Kind INTERNAL bei einem Agenten im selben Prozess, CLIENT bei einem entfernten Agenten-Dienst). Darunter hängt pro Modellaufruf ein chat-Span (benannt nach Operation und angefragtem Modell, Kind CLIENT), pro Tool-Aufruf ein execute_tool-Span (INTERNAL) und, falls dein Agent eine explizite Planungsphase hat, ein plan-Span. Eine mehrstufige Pipeline um Agenten kann einen invoke_workflow-Span nutzen. Retrieval hat einen eigenen Span, benannt nach der Datenquelle.
Zwei Details lohnen sich zum Übernehmen. Der Span-Name eines Modellaufrufs ist die Operation plus das Modell, zum Beispiel chat plus Modellname, das hält die Kardinalität niedrig und das Wasserfall-Diagramm lesbar. Und die Conventions ermutigen ausdrücklich, eigene Tools von Hand mit execute_tool-Spans zu instrumentieren, weil eine Auto-Instrumentierung Tools in deinem Code nicht kennen kann. Für Tools, die MCP-Server aufrufen, kann die MCP-Convention den Trace-Kontext in den Request-Metadaten mitgeben (traceparent, tracestate und baggage), sodass die Serverseite im selben Trace landet. Warum diese Serversicht wichtig ist, steht in MCP-Tool-Design: Lessons Learned.
Noch ein Punkt zur Form: Ein wiederholter Modellaufruf sollte ein Span sein, der alle Wiederholungen umfasst, nicht mehrere, denn die Convention definiert den Span als die logische Operation aus Sicht des Aufrufers. Willst du die Wiederholungen sehen, erfasse sie als Events oder Attribute an diesem Span.
Was auf jedem Span erfasst werden sollte
Der Standard sagt dir, was verfügbar ist, nicht was den Speicherplatz wert ist. Mit diesem Set würde ich anfangen. Die Namen in der zweiten Spalte stammen aus den Conventions, sofern nicht als eigene (custom) markiert.
| Einheit | Zu setzende Attribute | Warum es sich lohnt |
|---|---|---|
| Agentenlauf (invoke_agent) | gen_ai.agent.name, gen_ai.agent.version, gen_ai.conversation.id, error.type, dazu custom: Release, Mandant, Endergebnis | Läufe nach Agentenversion und Session gruppieren, Releases vergleichen, Läufe finden, die in einer Übergabe oder einem Fehler endeten |
| Modellaufruf (chat) | gen_ai.operation.name, gen_ai.provider.name, gen_ai.request.model, gen_ai.response.model, gen_ai.response.finish_reasons, gen_ai.usage.input_tokens, gen_ai.usage.output_tokens, Zahlen für Cache-Read- und Reasoning-Tokens, error.type | Kosten pro Aufruf, Abbrüche (Finish Reason length), Cache-Trefferquote, Modell-Fallbacks, welche Providerfehler dominieren |
| Request-Einstellungen | gen_ai.request.temperature, gen_ai.request.max_tokens, gen_ai.request.reasoning.level, gen_ai.prompt.name, gen_ai.prompt.version | Verhaltensänderungen erklären, Qualität an eine Prompt-Version binden |
| Tool-Aufruf (execute_tool) | gen_ai.tool.name, gen_ai.tool.call.id, gen_ai.tool.type, error.type, dazu custom: lesend oder schreibend, Freigabe erteilt | Fehlerrate und Latenz pro Tool, Schreibaktionen und ihre Freigeber finden |
| Retrieval | gen_ai.data_source.id, dazu custom: Top-k, Trefferzahl, Dokument-IDs ohne Inhalt | Leeres oder schwaches Retrieval erkennen, bevor das Modell es hinter einer flüssigen Antwort versteckt |
| Inhalt | gen_ai.system_instructions, gen_ai.input.messages, gen_ai.output.messages, gen_ai.tool.call.arguments, gen_ai.tool.call.result (alle Opt-in) | Debugging und Testfälle, zum Preis von Datenschutz und Speicher (siehe Abschnitt PII) |
| Evaluation | gen_ai.evaluation.name, gen_ai.evaluation.score.value, gen_ai.evaluation.score.label, gen_ai.evaluation.explanation | Qualitätssignal direkt an dem Span, den es bewertet |
Setze die Attribute, die ein Sampler brauchen könnte, schon beim Erzeugen des Spans. Die Conventions nennen gen_ai.operation.name, gen_ai.provider.name, gen_ai.request.model und die Serveradresse (bei Agenten-Spans zusätzlich gen_ai.agent.name) als die Attribute, die bei der Erzeugung vorliegen SOLLTEN, weil ein Head-Sampler später ergänzte Attribute nicht sehen kann.
Token- und Kostenmetriken
Spans liefern Detail pro Lauf, Metriken liefern günstige, langlebige Trends. Die Conventions definieren Token-Usage-Counter pro Kategorie (Input, Output, Cache Read, Cache Write, Reasoning), aufgeteilt nach Modalität, und beschreiben sie als primäre Instrumente für den Verbrauch und als Näherung für die Kosten. Daneben gibt es Histogramme für die Token-Verteilung pro Operation, gedacht für p95- und p99-Ausreißer und ausdrücklich nicht für Summen oder Kosten. Für Agenten gibt es Histogramme für die Dauer einer Invocation, die Zahl der Inference-Aufrufe und die Zahl der Tool-Aufrufe pro Invocation sowie eine Tool-Ausführungsdauer. Die letzten beiden würde ich zuerst aufs Dashboard legen: Sie zeigen eine Schleife, bevor es die Rechnung tut.
Achte auf die Arithmetik. Die Input-Token-Zahl SOLL gecachte Tokens enthalten, und die Zahlen für Cache Read, Cache Write und Reasoning sind Teilmengen der Input- und Output-Summen. Wer sie als getrennte Posten addiert, zählt doppelt. Die Conventions definieren außerdem kein Preis- oder Kostenattribut, Kosten rechnest du also selbst: Token-Kategorien mal einer Preistabelle pro Antwortmodell, im Backend oder in einer Pipeline-Stufe, und versioniere diese Tabelle. Was du tun kannst, sobald du die Zahlen siehst, steht im Artikel zu LLM-Kosten, Latenz und Prompt Caching.
Halte die Metrik-Dimensionen niedrig in der Kardinalität: Modell, Provider, Agentenname, Operation, Ergebnis. Eine User-ID oder Konversations-ID gehört an einen Span, nicht an eine Metrik, sonst wächst deine Metrikrechnung mit deiner Nutzerbasis.
Sampling: die interessanten Läufe behalten
Agenten-Traces sind größer als normale Web-Traces, und mit Inhaltserfassung können sie viel größer sein. Du wirst samplen. OpenTelemetry unterscheidet Head Sampling (die Entscheidung fällt beim Start des Traces, etwa ein fester Prozentsatz nach Trace-ID) von Tail Sampling (die Entscheidung fällt, nachdem alle oder die meisten Spans bekannt sind, sodass du Traces mit Fehlern oder hoher Latenz immer behalten kannst). Die Dokumentation ist offen bei den Kosten: Tail Sampling ist schwerer zu implementieren und zu betreiben, und die Komponente, die entscheidet, muss zustandsbehaftet sein.
Für Agenten würde ich eine einfache Policy nutzen und die Prozentwerte als Startpunkt zum Nachjustieren verstehen:
- 100 % behalten bei Läufen mit Fehler, Timeout, Übergabe an einen Menschen oder Nutzerbeschwerde.
- 100 % behalten bei Läufen, die bei Kosten, Dauer oder Zahl der Modellaufrufe weit über dem Normalen liegen. Das sind deine Schleifen.
- 100 % behalten bei Läufen, die einen Eval nicht bestanden haben, und bei Läufen in einem Canary-Release.
- Einen kleinen Anteil samplen, sagen wir 5 bis 10 Prozent, vom Rest, damit du eine repräsentative Baseline behältst.
- Raten nicht aus gesampelten Traces ableiten. Berechne Raten und Alarme aus Metriken (den oben genannten Dauer-, Token- und Tool-Call-Instrumenten), nicht durch Zählen gesampelter Traces.
Zwei agentenspezifische Fallen. Ein Lauf kann Minuten dauern, also muss der Tail-Sampler lange genug warten, bevor er entscheidet, und währenddessen jeden Span dieses Laufs im Speicher halten. Und ein Eval-Score kommt meist an, nachdem der Trace abgeschlossen und exportiert ist, kann die Tail-Entscheidung also nicht steuern, außer du bewertest inline. Wenn fehlgeschlagene Evals das Sampling überleben sollen, führe entweder einen billigen Inline-Check bei jedem Lauf aus oder hänge den Score später an und sorge dafür, dass der aussortierte Trace für die markierten Läufe noch verfügbar ist.
PII und sensible Inhalte in Traces
Prompts, Tool-Argumente und Tool-Ergebnisse enthalten, was deine Nutzer und Systeme enthalten: Namen, E-Mail-Adressen, Bestellnummern, Vertragstexte, manchmal Geheimnisse. Die Conventions beziehen klar Stellung. Instruktionen, Eingaben und Ausgaben gelten als sensibel und oft groß, daher SOLLEN Instrumentierungen sie standardmäßig nicht erfassen und ein Opt-in anbieten. Sie beschreiben drei Muster: nichts aufzeichnen (der Standard), Inhalte in Span-Attributen aufzeichnen oder Inhalte extern speichern und nur Referenzen an den Spans ablegen. Das Letzte ist in Produktion das empfohlene Muster, weil externer Speicher eigene Zugriffskontrollen hat.
Daraus ergibt sich ein praktisches Setup:
- Produktions-Standard: nur Metadaten. Modell, Tokens, Finish Reason, Tool-Namen, Fehlertypen, IDs. Erstaunlich viel Debugging funktioniert damit.
- Vorproduktion und Tests: vollständiger Inhalt auf den Spans, weil es keine echten personenbezogenen Daten gibt und du maximale Sichtbarkeit willst.
- Inhalte in Produktion: nur über das Muster mit externem Speicher, für eine gesampelte oder markierte Teilmenge, mit kurzer Aufbewahrung und Zugriff nur für die, die ihn brauchen. Die Conventions erlauben einen In-Process-Hook, der Inhalte vor dem Aufzeichnen ändern oder schwärzen kann, und dieser Hook läuft unabhängig von der Sampling-Entscheidung.
- Vor dem Export schwärzen, nicht im Backend. Eine Verarbeitungsstufe in deiner Telemetrie-Pipeline oder ein In-Process-Hook kann Muster wie E-Mail-Adressen und Kartennummern entfernen. Verlass dich nicht darauf, dass der Anbieter das erledigt, nachdem die Daten dein Netz verlassen haben.
- Pseudonyme IDs nutzen für Nutzer und Konversationen, nie rohe E-Mail-Adressen oder Namen, damit du einen Lauf finden kannst, ohne dass der Trace zum Personendaten-Register wird.
Tool-Argumente verdienen besondere Aufmerksamkeit, weil sie oft der identifizierendste Teil eines Laufs sind und leicht vergessen werden. Wenn deine Traces die EU verlassen oder bei einem US-Anbieter landen, gelten dieselben Regeln wie für die Modell-API selbst, siehe DSGVO und LLM-APIs. Prompt-Inhalt in Traces ist außerdem eine Quelle für Prompt Injection: Ein Trace-Viewer, der nicht vertrauenswürdige Modellausgabe rendert, ist ein Ziel, ein weiterer Grund, den Zugriff eng zu halten.
Traces mit Evals verbinden
Traces sagen dir, was passiert ist, Evals sagen dir, ob es gut war. Am nützlichsten sind sie zusammen. Die Conventions definieren ein gen_ai.evaluation.result-Event mit Evaluationsname, Score-Wert, lesbarem Label, Erklärung und der Response-ID und sagen, dass es dem bewerteten GenAI-Operation-Span untergeordnet sein SOLL oder die Response-ID tragen soll, wenn kein Span verfügbar ist. Ein LLM-Judge oder eine regelbasierte Prüfung, die nachträglich läuft, kann ihr Urteil so direkt auf den bewerteten Knoten schreiben.
Ich nutze diese Verbindung auf drei Arten. Offline: Lass das Eval-Dataset durch denselben instrumentierten Agenten laufen, markiere die Traces mit einer Lauf- oder Release-Kennung (ein eigenes Attribut) und vergleiche Kosten, Schrittzahl und Score pro Release an einem Ort. Online: Bewerte eine Stichprobe der Produktionsläufe und alarmiere bei sinkender Bestehensquote, mit den fehlgeschlagenen Traces einen Klick entfernt. Feedback-Schleife: Wenn ein Produktions-Trace fehlschlägt, kopiere seine Eingabe (und das erwartete Verhalten) ins Testset. Dafür muss der Inhalt erfasst sein, nutze also für die markierten Läufe das Muster mit externem Speicher. Wie du die Evals selbst baust, steht in LLM-Evals für Produkt-Features.
Tool-Optionen
Das Schöne an OTLP: Die Wahl des Backends kommt zuletzt. Das habe ich in der Dokumentation der Anbieter selbst geprüft:
| Tool | Wie es OpenTelemetry annimmt | Gut zu wissen |
|---|---|---|
| Langfuse | OTLP-Endpunkt unter /api/public/otel mit Basic Auth, HTTP/JSON und HTTP/protobuf, kein gRPC. Mappt gen_ai-Attribute, OpenInference und eigene langfuse-Attribute | LLM-spezifische Funktionen obendrauf (Prompt-Verknüpfung, Scoring, Kosten-Tracking), selbst hostbar. Das Repository steht unter MIT, außer den ee-Verzeichnissen mit separater Lizenz |
| Arize Phoenix | Baut auf OpenTelemetry auf, nutzt die OpenInference-Conventions, die OTel ergänzen, lokaler Collector unter /v1/traces | Open Source und selbst gehostet, unter der Elastic License 2.0. Arize AX ist die verwaltete Variante, stark für Experimente und Evals |
| Datadog LLM Observability | OTLP über HTTP/protobuf mit dd-api-key-Header, verlangt die gen_ai-Form ab OpenTelemetry 1.37 | Spans ohne gen_ai-Attribut werden verworfen, laut Doku vergehen einige Minuten, bis Traces erscheinen. Am besten, wenn du schon auf Datadog bist |
| Honeycomb | OTLP über gRPC, HTTP/protobuf und HTTP/JSON, mit API-Key-Header und EU-Endpunkt | Ein allgemeines Trace-Backend: Die Ingest-Doku, die ich gelesen habe, sagt nichts GenAI-Spezifisches, die Ansichten baust du selbst |
Meine Empfehlung: Instrumentiere mit OpenTelemetry und einer eigenen dünnen Helferschicht, exportiere über eine Pipeline-Stufe unter deiner Kontrolle, zum Beispiel einen OpenTelemetry Collector (ein naheliegender Ort für Schwärzen, Sampling und Kostenanreicherung), und wähle das Backend nach Hosting-Modell und nach dem, was dein Team schon betreibt. Wenn Datenresidenz zählt, ist ein selbst gehostetes Langfuse oder Phoenix am leichtesten zu verteidigen. Wenn du schon für eine allgemeine Observability-Plattform zahlst, prüfe, wie gut sie gen_ai-Spans darstellt, bevor du ein weiteres Tool ergänzt. Andere Anbieter, etwa den Grafana-Stack, habe ich nicht geprüft und lasse sie bewusst weg.
Eine Checkliste für den ersten Sprint
In dieser Reihenfolge würde ich vorgehen:
- Wähle das OTLP-Backend und setze eine Pipeline-Stufe unter deiner Kontrolle dazwischen. Schwärzen und Sampling machst du dort.
- Installiere die Instrumentierung für deinen Provider oder dein Framework, pinne die Version und prüfe einen echten exportierten Span gegen die Conventions (inklusive der Variable OTEL_SEMCONV_STABILITY_OPT_IN).
- Füge pro Lauf einen invoke_agent-Root-Span hinzu und manuelle execute_tool-Spans für deine eigenen Tools.
- Setze Modell, Provider, Token-Verbrauch, Finish Reason und Fehlertyp auf jedem Modell-Span, ergänze Agentenversion, Release und eine pseudonyme Konversations-ID.
- Schalte die Inhaltserfassung in Produktion aus und in der Vorproduktion an. Entscheide den Weg über externen Speicher für markierte Läufe.
- Baue drei Dashboards: Modell- und Tool-Aufrufe pro Lauf (p50, p95), Tokens und berechnete Kosten pro Agentenversion, Fehler- und Timeout-Rate pro Tool.
- Ergänze die Sampling-Policy: alle Fehler, Ausreißer und fehlgeschlagenen Evals, ein kleiner Anteil vom Rest.
- Schreibe Eval-Ergebnisse als gen_ai.evaluation.result-Events an die bewerteten Spans und speise fehlgeschlagene Traces zurück ins Testset.
- Füge einen Golden-File-Test hinzu, der fehlschlägt, wenn sich die Form der Instrumentierungsausgabe ändert.
Wenn du mit einem Harness arbeitest, zahlt sich dieselbe Instrumentierung auch dort aus, siehe Harness Engineering für Coding-Agenten.
Wo ich noch nicht zu viel investieren würde
Baue keine tiefe, maßgeschneiderte Analytik auf den exakten Attributnamen eines Standards im Status Development. Baue auf den Konzepten: ein Baum aus Spans mit Token-Zahlen, Ergebnissen und Scores, und halte die Zuordnung von Konzept zu Attributname an einer einzigen Stelle. Die Conventions werden sich weiterbewegen, und die Backends werden aufholen. Ein Team, das jeden Lauf tracet und die Frage „was hat dieser Lauf getan und was hat er gekostet“ beantworten kann, ist weiter als eines, das wartet, bis sich der Standard setzt.
Quellen
- OpenTelemetry: GenAI semantic conventions repository (open-telemetry/semantic-conventions-genai)
- GenAI conventions: overview (status Development)
- GenAI conventions: model spans, execute_tool and content capture
- GenAI conventions: agent spans
- GenAI conventions: metrics
- GenAI conventions: inference token metrics
- GenAI conventions: events (gen_ai.evaluation.result)
- GenAI conventions: Model Context Protocol
- OpenTelemetry docs: GenAI conventions moved notice
- OpenTelemetry docs: Sampling
- John Hodge: The state of the OpenTelemetry GenAI semantic conventions (July 2026)
- Langfuse docs: OpenTelemetry integration
- Langfuse repository and licence
- Arize Phoenix repository
- Arize OpenInference repository
- Datadog docs: OpenTelemetry instrumentation for LLM Observability
- Honeycomb docs: Send data with OpenTelemetry
Häufige Fragen
Was sind die OpenTelemetry GenAI Semantic Conventions?
Sie sind die Standardnamen für Attribute, Spans, Metriken und Events von Generative-AI-Workloads: gen_ai.operation.name, gen_ai.request.model, gen_ai.usage.input_tokens, execute_tool-Spans, invoke_agent-Spans und mehr. Stand Oktober 2026 werden sie im Repository open-telemetry/semantic-conventions-genai gepflegt, und jedes GenAI-spezifische Element ist weiterhin als Development markiert, nicht als Stable.
Wie tracet man einen LLM-Agenten mit OpenTelemetry?
Erzeuge pro Agentenlauf einen Trace. Umschließe den Lauf mit einem invoke_agent-Span, jeden Modellaufruf mit einem chat-Span und jeden Tool-Aufruf mit einem execute_tool-Span, und setze die gen_ai-Attribute für Modell, Token-Verbrauch, Finish Reason und Fehler. Nutze eine Instrumentierungsbibliothek für deinen Provider oder dein Framework, ergänze manuelle Spans für eigene Tools und exportiere per OTLP.
Sollte ich Prompts und Antworten in Traces loggen?
Standardmäßig nicht. Die Conventions stufen Instruktionen, Eingaben und Ausgaben als sensibel und groß ein, weisen Instrumentierungen an, sie ohne Opt-in nicht zu erfassen, und empfehlen in Produktion, Inhalte extern zu speichern und nur Referenzen am Span abzulegen. Erfasse vollständige Inhalte in der Vorproduktion oder für eine gesampelte, zugriffsbeschränkte Teilmenge.
Wie verfolge ich LLM-Token-Verbrauch und Kosten mit OpenTelemetry?
Erfasse gen_ai.usage.input_tokens und gen_ai.usage.output_tokens auf jedem Inference-Span und nutze die Token-Usage-Counter für Dashboards. Die Conventions definieren Token-Zahlen, keine Preise. Die Kosten berechnest du also im Backend oder in der Pipeline aus einer Preistabelle pro Antwortmodell. Gecachte und Reasoning-Tokens sind Teilmengen der Input- und Output-Summen.
Welches Tool ist das beste für LLM-Observability: Langfuse, Phoenix, Datadog oder Honeycomb?
Das hängt davon ab, was du schon betreibst. Langfuse und Arize Phoenix sind auf LLMs ausgerichtet und selbst hostbar, Datadog LLM Observability passt zu Teams, die schon auf Datadog sind, und verlangt gen_ai-Attribute ab OpenTelemetry 1.37, und Honeycomb ist ein allgemeines OTLP-Trace-Backend. Instrumentiere zuerst mit OpenTelemetry, dann bleibt das Backend eine austauschbare Entscheidung.
Wie verbinde ich Traces mit Evals?
Hänge Eval-Ergebnisse an den Span, den sie bewerten. Die GenAI Conventions definieren ein gen_ai.evaluation.result-Event mit Name, Score, Label und Erklärung, das dem bewerteten Span untergeordnet sein soll. Lass Offline-Evals durch denselben instrumentierten Code laufen und mache aus fehlgeschlagenen Produktions-Traces neue Testfälle.