Blog/LLMOps & Evals
Prompting vs. RAG vs. Fine-Tuning vs. Distillation: Entscheidungshilfe für 2026
Fine-Tuning vs. RAG vs. Prompting: was jeder Hebel ändert (Wissen, Verhalten, Format), was er kostet, wer 2026 noch SFT, DPO und RFT anbietet, plus Entscheidungsbaum.
Balázs Csorba··12 Min. Lesezeit
- Fine-tuning
- RAG
- Prompting
- Distillation
Das Wichtigste in Kürze
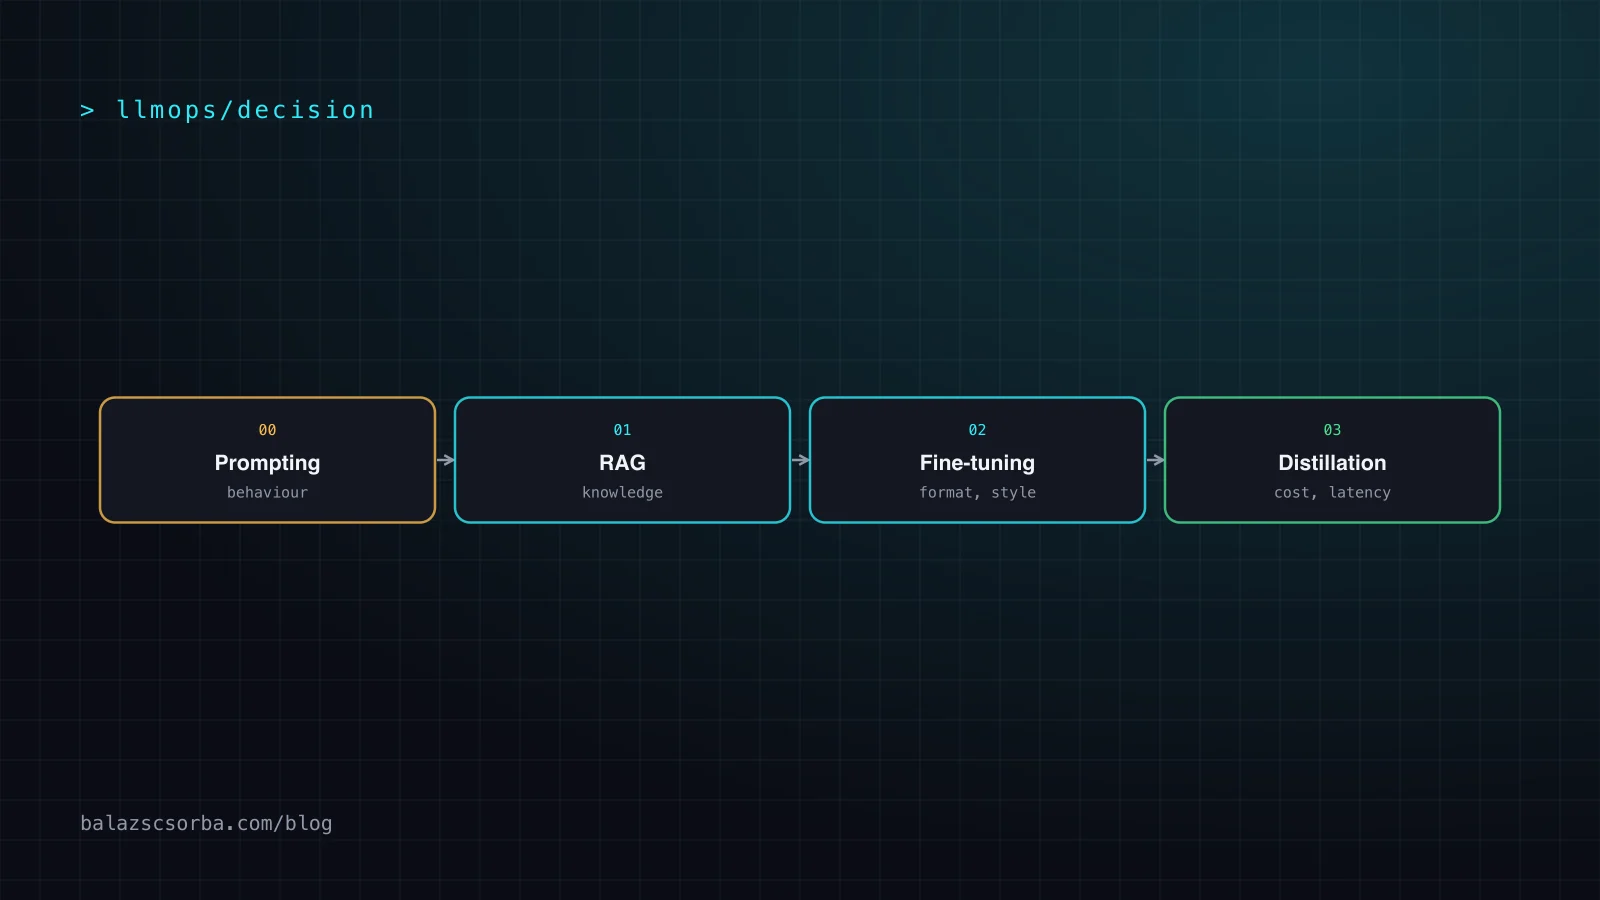
- Jeder Hebel ändert etwas anderes: Prompting ändert Anweisungen, RAG ändert, was das Modell sehen kann, Fine-Tuning ändert Verhalten und Format, Distillation ändert Kosten und Geschwindigkeit.
- Fine-Tuning für Wissen ist der klassische Fehler. Studien zeigen, dass RAG bei neuen Fakten besser abschneidet und Beispiele mit neuem Wissen Halluzinationen erhöhen können.
- Die Anbieterlandschaft hat sich 2026 verschoben: OpenAI fährt seine Fine-Tuning-Plattform herunter (neue Jobs enden am 6. Januar 2027), Google und AWS bieten weiter verwaltetes SFT und RFT.
- Preference Tuning und RFT lohnen sich nur, wenn du Ausgaben ranken oder einen Grader schreiben kannst. Die Evaluation muss also vor dem Trainingslauf existieren.
- Starte mit einem gemessenen Prompt, ergänze Retrieval für Fakten, tune nur ein stabiles, evaluierbares Verhalten und destilliere erst, wenn das Volumen die Kosten sichtbar macht.
Jedes Team, das auf LLMs baut, landet an derselben Weggabelung: Die Antworten sind nicht gut genug, und vier Hebel stehen zur Wahl. Einen besseren Prompt schreiben, Retrieval ergänzen, das Modell feintunen oder ein kleineres destillieren. Oft entscheidet die Mode. Fine-Tuning wirkt wie die seriöse Option und wird deshalb gewählt, um Probleme zu lösen, die es nicht lösen kann.
Die Landkarte hat sich zudem verschoben. Im Mai 2026 hat OpenAI angekündigt, die Self-Service-Fine-Tuning-Plattform herunterzufahren, mit der Begründung, neuere Basismodelle würden Anweisungen und Formate so gut befolgen, dass Prompting jetzt günstiger und schneller sei. Google und AWS bieten weiterhin verwaltetes Tuning an, und offene Modelle kannst du überall tunen. Wenn du diese Optionen zuletzt vor einem Jahr verglichen hast, ist ein Teil deines Bildes veraltet.
Das ist das Framework, das ich mit Kunden nutze. Es trennt die Hebel danach, was sie ändern, vergleicht Kosten, Daten und Pflegeaufwand, listet auf, wer am 2. Oktober 2026 was anbietet, nennt die häufigsten Fehler und endet mit Entscheidungsbaum und Checkliste.
Was jeder Hebel tatsächlich ändert
Am einfachsten fragst du, was an der Ausgabe falsch ist. Es gibt drei Arten von falsch. Das Modell weiß etwas nicht (Wissen). Es tut das Falsche mit dem, was es weiß (Verhalten). Oder es liefert den richtigen Inhalt in der falschen Form (Format). Ein viertes Thema, Kosten und Latenz, steht für sich: Die Ausgabe passt, ist aber zu teuer.
| Hebel | Was er ändert | Benötigte Daten | Laufende Kosten und Pflege | Typischer Fehler |
|---|---|---|---|---|
| Prompting | Anweisungen, Beispiele, Ausgabestruktur für einen Aufruf | Einige Beispiele und ein Eval-Set | Längere Prompts kosten bei jedem Aufruf Tokens; Prompt Caching mildert das | Prompt-Drift, brüchige Randfälle |
| RAG | Was das Modell sehen kann: privates, frisches oder großes Wissen | Ein Dokumentenkorpus und Testanfragen für das Retrieval | Index und Pipeline betreiben; zusätzliche Kontext-Tokens pro Aufruf | Falscher Chunk gefunden, also eine selbstsichere falsche Antwort |
| SFT | Verhalten, Ton, Format, Aufgabenkönnen | Hunderte saubere Paare aus Eingabe und idealer Ausgabe | Neu trainieren, wenn sich Anforderungen oder Basismodell ändern | Overfitting, enge Generalisierung, veraltetes Verhalten |
| Preference Tuning (DPO) | Subjektiver Stil und Gewichtung | Tausende Paare aus bevorzugter und abgelehnter Antwort | Wie SFT, und das Labeling ist der Kostenfaktor | Verrauschte Präferenzen trainieren den falschen Geschmack |
| RFT | Schlussfolgern bei Aufgaben mit prüfbarer Antwort | Dutzende bis Hunderte Prompts plus ein Grader | Grader pflegen; Training wird nach Zeit abgerechnet | Reward Hacking: Das Modell überlistet einen schwachen Grader |
| Distillation | Kosten und Latenz, indem Können in ein kleineres Modell wandert | Lehrer-Ausgaben auf deinem echten Traffic | Neu destillieren, wenn sich Aufgabe oder Lehrer ändern | Der Schüler gleicht den Lehrer nur bei leichten Fällen aus |
Wer 2026 was anbietet
Prüfe vor der Methodenwahl, ob dein Anbieter sie noch verkauft. Das ist der Stand, den ich am 2. Oktober 2026 aus Dokumentation und Ankündigungen der Anbieter verifizieren konnte.
| Anbieter | Überwacht (SFT) | Präferenz | Reinforcement (RFT) | Distillation |
|---|---|---|---|---|
| OpenAI API | GPT-4.1, 4.1-mini, 4.1-nano (wird heruntergefahren) | DPO auf denselben drei Modellen (wird heruntergefahren) | Nur o4-mini (wird heruntergefahren) | Nicht verifiziert |
| Microsoft Foundry | GPT-4.1-Familie und Llama 4 Scout angekündigt | Nicht verifiziert | o4-mini, mit Modell-Gradern (GPT-4.1-Familie) | Nicht verifiziert |
| Google, Gemini | Gemini 3.5 Flash, 3.1 Flash-Lite, 2.5 Pro, 2.5 Flash und Flash-Lite | Gemini 2.5 Flash und Flash-Lite | Pre-GA-Vorschau auf denselben Gemini-Modellen | Über offene Modelle |
| Google, offene Modelle | Gemma, Qwen, Llama; volles Tuning oder LoRA | Nicht verifiziert | Nicht verifiziert | Lehrermodell tunt ein kleineres Schülermodell |
| AWS Bedrock | Amazon Nova und weitere; Claude 3 Haiku in us-west-2 | Nicht verifiziert | Nova 2 Lite, gpt-oss-20B, Qwen3 32B | Ja; Lehrer und Schüler aus derselben Familie |
Drei praktische Folgen. Erstens entscheidet „Welches Modell kann ich tunen?” heute mehr als „Welche Methode?”: Die Frontier-Modelle, die die meisten Teams produktiv nutzen, sind größtenteils nicht tunbar, denn ich habe kein verwaltetes Fine-Tuning für aktuelle Claude- oder GPT-5-Modelle gefunden. Zweitens ist RFT real, aber jung: Google führt es als Pre-GA, und Microsofts eigene RFT-Beiträge empfehlen, mit deterministischen Gradern zu beginnen. Drittens ist der Open-Weight-Weg (LoRA auf Gemma, Qwen oder Llama) der einzige portable, und er bringt die Betriebslast des Hostings mit.
Starte mit Prompting, aber miss es
OpenAIs eigener Optimierungsleitfaden beschreibt die Arbeit als Schleife aus Evals, Prompt Engineering und Fine-Tuning und stellt eine Baseline-Evaluation an den Anfang. Der Reihenfolge stimme ich zu und ergänze eine Regel: Du darfst erst sagen, dass Prompting gescheitert ist, wenn du die starke Version davon probiert hast. Das heißt: klare Aufgabenbeschreibung, ein strukturiertes Ausgabeschema, drei bis zehn echte Beispiele inklusive schwerer Fälle und ein Modell, das für die Aufgabe stark genug ist.
- Lege den Formatvertrag in ein Schema oder einen Structured-Output-Modus, nicht in Fließtext.
- Nimm Few-Shot-Beispiele aus echten Fehlern, keine erfundenen.
- Cache das stabile Präfix. Ein langer, wiederholter Prompt ist vor allem ein Kostenproblem, und Caching löst einen großen Teil davon (siehe Kosten, Latenz und Routing).
- Probiere ein stärkeres Modell, bevor du ein schwächeres tunst. Viele „Fine-Tuning-Probleme” sind Modellgrößen-Probleme.
- Schreibe zuerst das Eval-Set. Ohne es kannst du nicht sagen, ob eine spätere Änderung geholfen hat (siehe Evals für Produkt-Features).
Googles Tuning-Dokumentation zieht dieselbe Linie: Prompting passt zu wenigen gelabelten Daten und schnellem Prototyping, Tuning wirkt am besten bei einem umfangreichen gelabelten Datensatz (empfohlen werden 100 Beispiele oder mehr) und einer Aufgabe, die fortgeschrittenes Prompting nicht löst. Den Vorteil des Tunings nennt sie selbst: höhere Qualität bei deiner Aufgabe und geringere Latenz und Kosten durch kürzere Prompts.
RAG für Wissen, nicht Fine-Tuning
Wenn dem Modell Fakten fehlen, gib sie ihm zur Abfragezeit. Hier passiert der teuerste Fehler, deshalb lohnt sich die Evidenz. In Fine-Tuning or Retrieval? verglichen Ovadia und Kollegen unüberwachtes Fine-Tuning mit RAG und fanden, dass RAG durchgehend besser abschneidet, sowohl bei Wissen, das das Modell im Training gesehen hatte, als auch bei völlig neuem Wissen; Modelle taten sich schwer, neue Fakten per Fine-Tuning überhaupt zu lernen. In Does Fine-Tuning LLMs on New Knowledge Encourage Hallucinations? fanden Gekhman und Kollegen, dass Beispiele mit neuem Wissen langsamer gelernt werden und, einmal gelernt, die Halluzinationsneigung linear erhöhen. Ihr Schluss: Modelle erwerben Faktenwissen hauptsächlich im Pre-Training, und Fine-Tuning lehrt sie, es effizienter zu nutzen.
Die praktischen Gründe wiegen so schwer wie die Forschung. Fakten ändern sich, und ein eingetunter Fakt lässt sich ohne Neutraining weder aktualisieren noch zitieren noch für eine DSGVO-Anfrage löschen. RAG liefert dir Quellen, Berechtigungen pro Dokument und Updates in Minuten. Der Preis ist eine Pipeline, die du gut bauen musst: Chunking, Hybrid-Suche und Reranking, die ich im RAG-Pipeline-Leitfaden und in RAG 2026: hybrid, agentisch oder Long Context behandle.
Ein nützlicher Test: Wenn die richtige Antwort in einem Dokument steht, das dir jemand reichen könnte, ist es ein Retrieval-Problem. Wenn kein Dokument sie enthalten könnte, weil das Problem das Wie der Antwort ist, dann nicht.
Supervised Fine-Tuning für Verhalten und Format
SFT ist das richtige Werkzeug, wenn das Problem konsistentes Verhalten ist. OpenAIs Leitfaden nennt Klassifikation, nuancierte Übersetzung, Inhalte in einem bestimmten Format und das Korrigieren von Fehlern bei der Befolgung von Anweisungen und warnt davor, SFT für völlig neues Wissen zu nutzen. Meine Ergänzungen aus Projekten: strikter Hausstil, Extraktion in ein festes Schema, wo Prompts zu lang werden, und ein 3.000-Token-Prompt, der in die Gewichte komprimiert wird, damit jeder Aufruf günstiger ist.
Daten. Die Zahlen der Anbieter sind klein. OpenAI akzeptierte schon 10 Beispiele und sah Verbesserungen ab 50 bis 100; Googles Leitfaden spricht von Hunderten gelabelter Beispiele; AWS' Fine-Tuning für Claude 3 Haiku nahm zwischen 32 und 10.000 Zeilen. Die Menge ist nicht das Schwierige. OpenAIs Best-Practice-Leitfaden sagt es gut: Wenn dein Modell Grammatik-, Logik- oder Stilprobleme hat, prüfe, ob deine Daten dieselben Probleme haben, und eine kleinere Menge hochwertiger Daten schlägt eine größere Menge minderwertiger. Achte auch auf die Balance: Trainingsdaten mit 60 Prozent Ablehnungen erzeugen ein Modell, das zu oft ablehnt.
Methode. Parameter-effizientes Tuning hält das bezahlbar. Das LoRA-Paper berichtet von etwa 10.000-mal weniger trainierbaren Parametern und rund dreimal weniger GPU-Speicher als beim vollen Fine-Tuning von GPT-3 175B, ohne zusätzliche Inferenz-Latenz. Verwaltete Dienste verbergen das; bei offenen Modellen wählst du selbst zwischen LoRA und vollem Tuning.
Pflege. Ein Fine-Tune ist ein Fork eines bestimmten Basismodells. Wird dieses Modell abgekündigt, trainierst du neu, und deine Trainingsdaten und dein Eval-Set sind die Werte, die überleben. Manche Plattformen ändern auch, wie du zahlst: AWS verlangt Provisioned Throughput, um ein angepasstes Claude 3 Haiku zu betreiben, was aus einem Token-Preis einen Fixposten macht.
Preference Tuning und RFT: nur mit Signal
DPO trainiert auf Paaren: ein Prompt, eine bevorzugte und eine nicht bevorzugte Ausgabe. OpenAI empfiehlt es für Zusammenfassungen mit der richtigen Gewichtung und für Chat mit passendem Ton und Stil, und das Cookbook beziffert den Datenbedarf auf Tausende bis Zehntausende Beispiele. Google empfiehlt, zuerst SFT und danach Preference Tuning auszuführen, und auch OpenAIs Pipeline lässt SFT zuerst den genauen Wortlaut lehren. DPO ist ein Feinschliff für Geschmack, kein Weg, eine Aufgabe beizubringen.
RFT ist von anderer Art: Das Modell erzeugt im Training Antworten, und ein Grader bewertet sie. OpenAIs Dokumentation rät, klein zu starten, mit einigen Dutzend bis wenigen Hundert Beispielen, um zu sehen, ob RFT überhaupt nützt. Es passt zu Aufgaben mit prüfbarem Ergebnis wie Code, der Tests besteht, strukturierte Extraktion mit bekannter Antwort oder eingegrenztes Schlussfolgern. Google bietet String-Match-, Gemini-Autorater- und Code-Execution-Rewards, bis zu 16 kombiniert; AWS nennt im Schnitt 66 Prozent mehr Genauigkeit gegenüber Basismodellen für sein RFT, was eine Herstellerangabe aus ausgewählten Fällen und keine Garantie ist. RFT funktioniert nicht, wo das Modell anfangs keine Fähigkeit hat oder das Signal vage ist, und ein schwacher Grader wird ausgenutzt. Den Grader zu schreiben ist das eigentliche Projekt; er ist eine Evaluation unter anderem Namen, daher gilt mein Leitfaden zu Evals direkt.
Distillation: Kosten und Latenz zurückkaufen
Distillation ist der eine Hebel, der auf die Rechnung zielt. Ein starkes Lehrermodell erzeugt Ausgaben auf deinen echten Eingaben, und ein kleineres Schülermodell wird darauf getunt. AWS beschreibt Bedrock Model Distillation als bis zu fünfmal schneller und bis zu 75 Prozent günstiger als das ursprüngliche große Modell, bei weniger als zwei Prozent Genauigkeitsverlust, besonders für RAG-Anwendungen. Das sind AWS' Zahlen für das eigene Produkt, miss also auf deinen Daten. Die Einschränkungen sind lehrreich: Lehrer und Schüler müssen aus derselben Familie stammen, und AWS rät selbst, den Schüler unverändert zu nutzen, wenn er schon gut genug ist.
Googles Dokumentation für offene Modelle sagt dasselbe von der anderen Seite: Distillation wirkt am besten, wenn der Lehrer dem Schüler deutlich überlegen ist, etwa bei mehrstufigem Schlussfolgern, und bringt weniger, wenn der Schüler schon nahe dran ist oder die Aufgabe kurzes Retrieval ist. Meine Regel: Destilliere nur eine stabile Aufgabe mit echtem Volumen, nachdem eine Evaluation belegt, dass der Schüler den Lehrer erreicht. Geht es dir stattdessen um Routing zwischen einem kleinen und einem großen Modell, siehe typisierte Entscheidungen für LLM-Routing.
Ein Entscheidungsbaum
Die Reihenfolge der Fragen ist der Punkt. Jede ist günstiger auszuprobieren als die nächste, und jede Antwort schließt die teureren Hebel aus.
Zwei Hinweise zum Lesen. Die Hebel lassen sich kombinieren: Ein Produktivsystem ist oft ein getuntes oder gut promptetes Modell, mit Retrieval für Fakten, hinter einem Eval-Gate. Und der Baum beginnt von vorn, sobald sich das Basismodell ändert, denn ein besseres Modell kann den Fine-Tune von gestern überflüssig machen, genau das beobachtet laut eigener Aussage OpenAI.
Fehler, die ich am häufigsten sehe
- Fine-Tuning für Wissen. Das Modell rezitiert deinen Produktkatalog im Training und erfindet in Produktion Preise. Nimm Retrieval.
- Tunen vor dem Messen. Keine Baseline, keine Evaluation, also kann niemand sagen, ob das getunte Modell besser ist. Bei ungetesteten Fällen ist es oft schlechter.
- Schmutzige Trainingsdaten. Beispiele, die aus früheren Modellausgaben oder uneinheitlichen menschlichen Antworten stammen, lehren die Uneinheitlichkeit.
- Ein schwaches Modell tunen, um eine schlechte Aufgabendefinition zu retten. Wenn zwei Menschen sich über die richtige Antwort uneinig sind, behebt keine Methode das.
- Den Lebenszyklus des Basismodells ignorieren. Der Fine-Tune stirbt mit seinem Basismodell, und 2026 kann der Anbieter Tuning ganz einstellen.
- Kein Regressions-Set. Tuning für ein Verhalten kann andere still beschädigen, auch Sicherheitsverhalten.
- Thinking in einer getunten Aufgabe aktiviert lassen. Google rät, das Thinking-Budget auf 0 (bzw. das Level auf minimal bei Gemini 3 und höher) zu setzen, was Leistung verbessern und Kosten senken kann.
Checkliste für Evaluation und Pflege
Welchen Hebel du auch ziehst, dieselbe Disziplin gilt. Das ist die Checkliste, die ich in eine Pull-Request-Vorlage für jede Änderung an Prompts, Retrieval oder Modellen legen würde.
- Friere ein Eval-Set aus echtem Traffic ein, inklusive Fehlern und Randfällen, bevor du etwas änderst.
- Halte die Baseline für aktuellen Prompt und Modell fest, mit Qualität, Latenz und Kosten pro Aufgabe.
- Ändere einen Hebel nach dem anderen und führe das ganze Set erneut aus, nicht nur die Fälle, die du gerade angesehen hast.
- Führe ein Regressions-Set für Verhalten, die du nicht verlieren darfst: Ablehnungen, Sicherheit, Formatierung.
- Versioniere Trainingsdaten, Grader- oder Judge-Prompt und die Basismodell-Kennung neben dem getunten Modell.
- Lege einen Trigger für Neutraining fest: Abkündigung des Basismodells, Drift im Eval-Score oder eine geänderte Anforderung.
- Berechne den Break-even: Kosten für Tuning und Hosting gegen die Tokens, die du pro Monat sparst.
Was ich tun würde
Bei einem neuen LLM-Feature würde ich in Woche eins das Eval-Set bauen, in Woche zwei einen guten Prompt erreichen und Retrieval ergänzen, sobald Fakten zählen. Fine-Tuning würde ich erst erwägen, wenn danach ein stabiles Verhalten weiter scheitert, und nur auf einer Plattform, bei der ich davon ausgehe, dass sie es in zwei Jahren noch anbietet. Heute zeigt das auf Google, AWS oder offene Modelle statt auf eine geschlossene API, die sich zurückzieht. RFT würde ich nur mit einem deterministischen Grader probieren und Distillation nur, wenn die Monatsrechnung groß genug ist, um das Projekt zu bezahlen.
Für die meisten europäischen B2B-Produkte bringen Prompting plus Retrieval plus eine gute Evaluation 90 Prozent des Nutzens. Das ist ein Urteil aus meinen Projekten, keine gemessene Zahl, und dein Eval-Set sollte es überstimmen. Die Kunst ist zu erkennen, welche Art von falsch du vor dir hast.
Quellen
- OpenAI community: OpenAI self-serve fine-tuning availability (wind-down announcement)
- Tessl: OpenAI is shutting down self-serve fine-tuning
- OpenAI API docs: Model optimization
- OpenAI API docs: Supervised fine-tuning
- OpenAI API docs: Direct preference optimization
- OpenAI API docs: Reinforcement fine-tuning
- OpenAI API docs: Fine-tuning best practices
- OpenAI Cookbook: Choosing between SFT, DPO and RFT
- Google Cloud: Introduction to tuning (Gemini)
- Google Cloud: About supervised fine-tuning for Gemini models
- Google Cloud: About preference tuning for Gemini models
- Google Cloud: Reward functions for reinforcement learning fine-tuning
- Google Cloud: Supervised and distillation fine-tuning for open models
- AWS: Fine-tuning for Claude 3 Haiku in Amazon Bedrock is now generally available
- AWS: Amazon Bedrock now supports reinforcement fine-tuning
- AWS: Amazon Bedrock Model Distillation (preview announcement)
- AWS: Bedrock reinforcement fine-tuning adds open-weight models
- Microsoft Foundry blog: What is new in Foundry fine-tuning, April 2026
- Microsoft: Announcing new fine-tuning models and techniques in Azure AI Foundry
- Ovadia et al.: Fine-Tuning or Retrieval? Comparing Knowledge Injection in LLMs
- Gekhman et al.: Does Fine-Tuning LLMs on New Knowledge Encourage Hallucinations?
- Hu et al.: LoRA: Low-Rank Adaptation of Large Language Models
Häufige Fragen
Soll ich RAG oder Fine-Tuning verwenden?
Nimm RAG, wenn Fakten fehlen oder sich ändern, und Fine-Tuning, wenn Verhalten, Ton oder Ausgabeformat das Problem sind. Fine-Tuning ist ein schlechter Weg, Wissen hinzuzufügen: Eine Studie von 2023 fand, dass RAG sowohl bei vorhandenem als auch bei neuem Wissen besser abschneidet, und eine Studie von 2024 zeigte, dass Beispiele mit neuen Fakten langsam gelernt werden und nach dem Lernen Halluzinationen erhöhen.
Wann lohnt sich Fine-Tuning?
Wenn ein getesteter Prompt mit Beispielen bei einem stabilen, klar definierten Verhalten weiter scheitert, du einige hundert gute Beispiele hast und das Ergebnis messen kannst. Typische Gewinne sind strikte Ausgabeformate, Klassifikation, ein einheitlicher Ton und kürzere Prompts bei hohem Volumen.
Gibt es OpenAI Fine-Tuning 2026 noch?
Nur für Organisationen, die es schon genutzt haben. OpenAI hat Entwicklern im Mai 2026 mitgeteilt, dass die Plattform heruntergefahren wird: Neue Organisationen können keine Jobs anlegen, und am 6. Januar 2027 endet die Job-Erstellung für alle. Bestehende Fine-Tunes laufen, bis ihr Basismodell abgekündigt wird.
Was ist der Unterschied zwischen SFT, DPO und RFT?
Supervised Fine-Tuning (SFT) trainiert auf Paaren aus Eingabe und idealer Ausgabe. Direct Preference Optimization (DPO) trainiert auf einer bevorzugten und einer abgelehnten Antwort pro Prompt. Reinforcement Fine-Tuning (RFT) lässt das Modell Antworten erzeugen, die ein Grader bewertet, was zu Aufgaben mit prüfbarem Ergebnis passt.
Was ist Distillation und wann sollte ich sie nutzen?
Bei der Distillation erzeugt ein stärkeres Lehrermodell Trainingsdaten für ein kleineres Schülermodell. Nutze sie bei stabilen Aufgaben mit hohem Volumen, wenn ein günstigeres Modell auf deinem Evaluationsset mit dem Lehrer gleichzieht und echtes Geld spart. AWS rät, das Schülermodell unverändert zu nutzen, wenn es bereits gut genug ist.
Wie viele Beispiele brauche ich für Fine-Tuning?
Die Anbieter nennen kleine Startwerte: OpenAI akzeptierte mindestens 10 und sah Verbesserungen ab 50 bis 100 Beispielen, Google empfiehlt etwa 100 oder mehr gelabelte Beispiele. DPO braucht meist deutlich mehr, laut OpenAI Tausende. Qualität und Abdeckung von Randfällen zählen mehr als die reine Zahl.