Blog/LLMOps & Evals
Claude Opus 5.5 holt Platz 1 bei Artificial Analysis – die eigentliche Story ist medium
Claude Opus 5.5 erreicht 58 Punkte im Artificial Analysis Intelligence Index, fünf Punkte Vorsprung. Spannender ist, was Effort medium pro Aufgabe bringt.
Balázs Csorba··8 Min. Lesezeit
- Claude Opus 5.5
- Artificial Analysis
- LLM benchmarks
- LLM cost
Das Wichtigste in Kürze
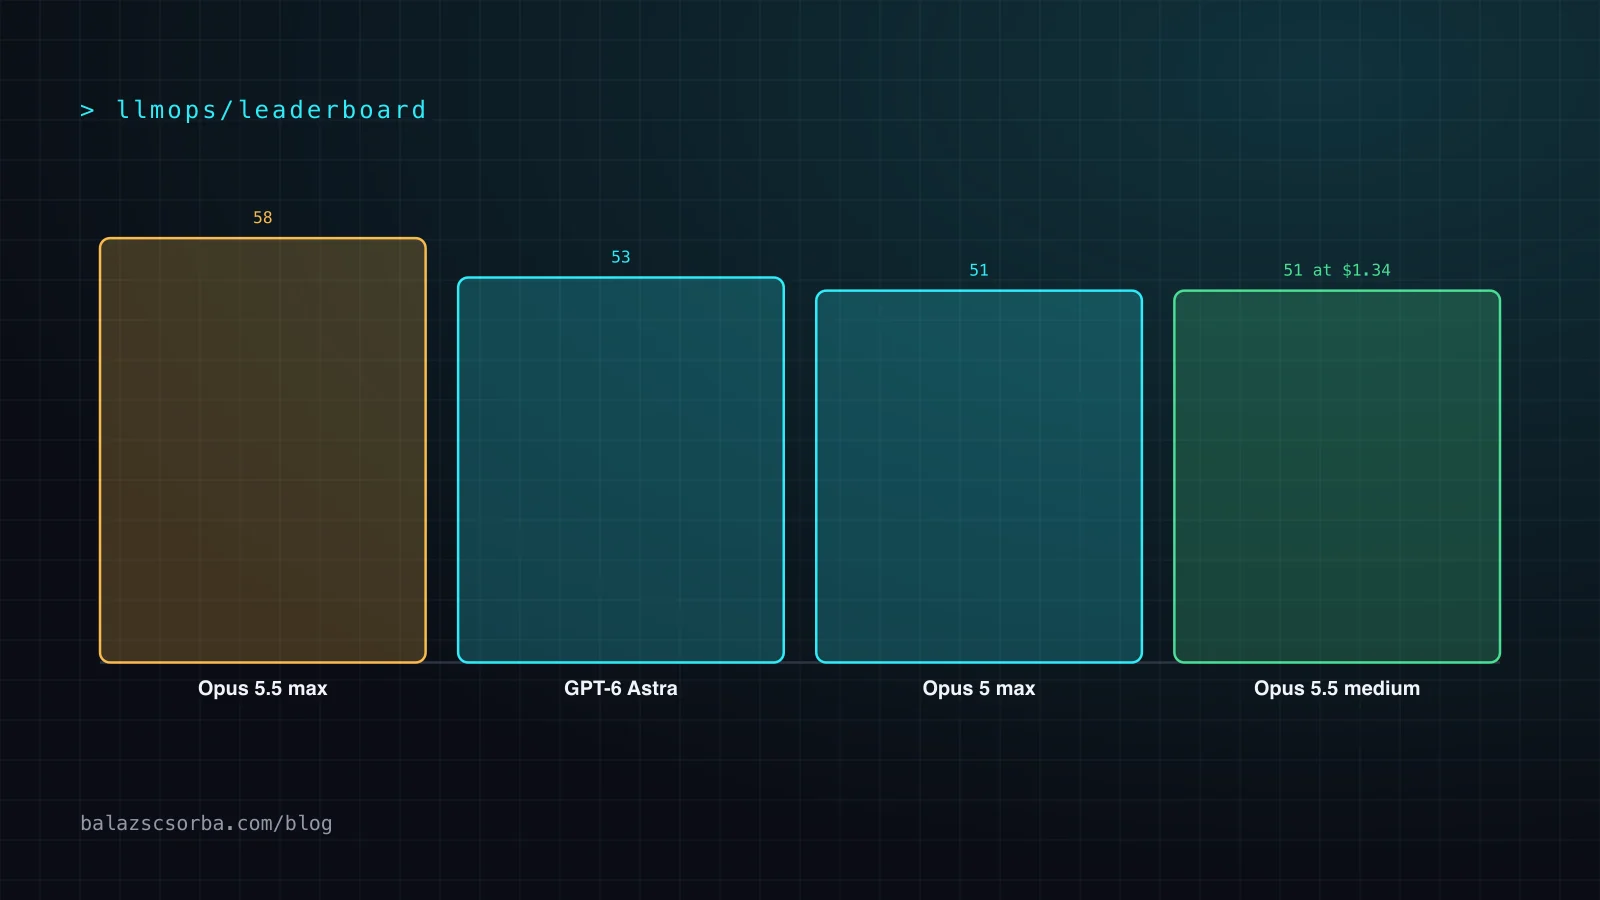
- Claude Opus 5.5 mit Effort max erreicht 58 Punkte im Artificial Analysis Intelligence Index v4.3.2, Platz eins von 211 Modellen und fünf Punkte vor GPT-6 Astra und Claude Fable 5.1 mit je 53.
- Mit Effort medium erreicht Opus 5.5 51 Punkte, genauso viel wie Opus 5 mit Effort max, für 1,34 $ statt 5,86 $ pro Aufgabe: rund 77 % günstiger beim gleichen Wert.
- Vier seiner fünf Effort-Stufen liegen auf der Frontier aus Intelligenz und Kosten pro Aufgabe von Artificial Analysis.
- Der Haken sind Gesprächigkeit und Latenz: rund 119.000 Output-Tokens pro Aufgabe mit Effort max und eine gemeldete Time to First Token von 682,71 Sekunden, gegenüber 13,20 Sekunden bei medium.
- Die Preise sind auf 4 $ und 20 $ pro Million Tokens gefallen, Cache-Lesezugriffe um 60 % auf 0,20 $. Effort medium plus gecachter Prefix ist deshalb der sinnvolle Standard für die Produktion.
Claude Opus 5.5 ist die neue Nummer eins im Leaderboard von Artificial Analysis, und zwar nicht um einen Rundungsfehler. Mit der höchsten Effort-Stufe erreicht es 58 Punkte im Artificial Analysis Intelligence Index, fünf Punkte vor den nächsten Modellen – der höchste Wert, den der Index je gemessen hat. Diese Schlagzeile hast du vermutlich schon gesehen.
Sie ist nicht der interessante Teil. Der steht weiter unten auf derselben Seite: Mit Effort medium erreicht Opus 5.5 genau den Wert, den das Flaggschiff der letzten Generation mit Effort max erreicht hat, für weniger als ein Viertel der Kosten pro Aufgabe. Dieser Artikel geht das Leaderboard, die Zahlen pro Benchmark, die Effizienzdaten und den Haken durch, alles so, wie Artificial Analysis es zum 28. September 2026 veröffentlicht hat. Am Ende steht, was ich deswegen in einem Produktions-Setup tatsächlich ändern würde.
Was der Artificial Analysis Intelligence Index misst
Artificial Analysis ist ein unabhängiges Benchmarking-Unternehmen, das dieselben Evaluierungen gegen jedes große Modell laufen lässt und Intelligenz, Geschwindigkeit und Preis nebeneinander veröffentlicht. Sein Intelligence Index ist eine einzige zusammengesetzte Zahl. Version 4.3.2 kombiniert zehn Evaluierungen: AA-Briefcase, GDPval-AA, AutomationBench-AA, Terminal-Bench 4.0, SciCode, Humanity's Last Exam, GDP.pdf, CritPt, AA-Omniscience und AA-LCR. Die Mischung setzt auf agentische Aufgaben und Wissensarbeit statt auf Trivia: Büroarbeit, Arbeit im Terminal, wissenschaftliches Programmieren, Reasoning über langen Kontext und einen Wissenstest, der Halluzinationen berücksichtigt.
Zwei Eigenschaften machen ihn nützlicher als das Launch-Diagramm eines Anbieters. Dieselbe Harness testet jedes Modell, die Zahlen sind also über Anbieter hinweg vergleichbar. Und der Index erscheint neben Kosten pro Aufgabe, verbrauchten Output-Tokens und Geschwindigkeit. Man sieht also, was ein Score kostet, und das zeigen Diagramme der Anbieter selten. Behalte beides für den Rest des Artikels im Kopf, denn die Effizienz-Geschichte gibt es nur wegen der zweiten Eigenschaft.
Das Leaderboard: 58 Punkte und fünf Punkte Vorsprung
Artificial Analysis hat seine Evaluierung am 22. September 2026 unter dem Titel Claude Opus 5.5 takes the top spot veröffentlicht. Opus 5.5 mit Effort max erreicht 58 und liegt damit auf Platz eins von 211 Modellen im Index, der Median liegt bei 26. Dahinter teilen sich GPT-6 Astra und Claude Fable 5.1 mit 53 den zweiten Platz, und Claude Opus 5, das Modell, das Opus 5.5 ablöst, kommt auf 51 und landet auf Platz elf.
Fünf Punkte sind in einem zusammengesetzten Index eine große Lücke. Zum Vergleich: Zwischen Opus 5 und dem geteilten zweiten Platz liegen insgesamt zwei Punkte. Der Bericht von OfficeChai spricht von fünf Punkten Vorsprung auf GPT-6 Astra, und das ist die faire Lesart: Es ist ein neuer Höchstwert, kein Gleichstand, den das Rauschen entschieden hat.
Woher die Punkte kommen
Ein zusammengesetzter Wert kann einen einzelnen Ausreißer-Benchmark verstecken, deshalb zählen die Zahlen pro Evaluierung mehr als die Summe. Artificial Analysis meldet für Opus 5.5 mit Effort max Folgendes:
- Humanity's Last Exam: 61,4 %, gegenüber einem bisherigen Bestwert von 59,1 %.
- SciCode: 66,9 %, gegenüber einem bisherigen Bestwert von 63,1 %.
- Terminal-Bench 4.0: 59,6 %, gleichauf mit GPT-6 Astra auf Effort xhigh und 11 Punkte über Opus 5.
- AA-Briefcase: ein Elo von 1822, 143 Punkte über Claude Fable 5.1.
- GDPval-AA v2.1: 1.846, also 111 über Fable 5.1 und 138 über Opus 5.
Das Muster ist breit, nicht punktuell. Die größten Zuwächse gibt es bei der Wissensarbeit (AA-Briefcase und GDPval-AA, beide rund um realistische Büroaufgaben gebaut) und bei der Arbeit im Terminal, also dort, wo Coding-Agenten ihre Zeit verbringen. Terminal-Bench ist die einzige Stelle, an der es nicht allein vorne liegt: GPT-6 Astra zieht gleich. Wenn deine Workload eine Agentenschleife ist, die eine Shell steuert, lautet die ehrliche Zusammenfassung „geteilter Bestwert“, nicht „Bestwert“.
Die eigentliche Schlagzeile ist Effort medium
Opus 5.5 bietet fünf Effort-Stufen: low, medium, high, xhigh und max. Der Effort steuert, wie viel das Modell vor der Antwort nachdenken darf, und damit, für wie viele Output-Tokens du bezahlst. Artificial Analysis hat alle fünf gemessen. Die Indexwerte sind 42 bei low, 51 bei medium, 54 bei high, 56 bei xhigh und 58 bei max.
Jetzt lege zwei dieser Zahlen nebeneinander. Opus 5 mit Effort max erreicht 51 bei 5,86 $ pro Aufgabe. Opus 5.5 mit Effort medium erreicht ebenfalls 51, bei 1,34 $ pro Aufgabe, und steht damit auf Platz acht des gesamten Leaderboards. Gleicher Wert, pro Aufgabe rund 77 % günstiger, also ungefähr ein Faktor 4,4. Diesen Satz würde ich auf die Launch-Folie schreiben, und er steht nicht auf der Launch-Folie.
Artificial Analysis merkt außerdem an, dass vier der fünf Effort-Stufen auf seiner Frontier aus Intelligenz und Kosten pro Aufgabe liegen. Einfach gesagt: Bei vier der fünf Stufen bekommst du von keinem anderen gemessenen Modell mehr Punkte fürs selbe Geld. Die Stufenleiter ist kein Marketing; jede Stufe nach oben bringt echte Punkte, und du kannst wählen, wo auf der Kurve du sitzen willst.
| Modell und Stufe | Indexwert | Platz | Kosten pro Aufgabe | Output-Tokens, ganzer Index | Output-Geschwindigkeit |
|---|---|---|---|---|---|
| Claude Opus 5.5, max | 58 | 1 von 211 | 5,98 $ | 260 Mio. | 95,5 Tokens/s |
| Claude Opus 5.5, medium | 51 | 8 | 1,34 $ | 38 Mio. | 81,7 Tokens/s |
| Claude Opus 5, max | 51 | 11 | 5,86 $ | 140 Mio. | 60,5 Tokens/s |
Der Haken: Tokens und Wartezeit
Jetzt der Teil, den die Schlagzeile weglässt. Opus 5.5 mit Effort max ist das gesprächigste Modell an der Spitze der Tabelle. Artificial Analysis zählt rund 119.000 Output-Tokens pro Index-Aufgabe, gegenüber rund 73.000 bei Opus 5, rund 78.000 bei Fable 5.1 und rund 27.000 bei GPT-6 Astra. Über den ganzen Index hat es 260 Millionen Output-Tokens verbraucht, das Median-Modell 88 Millionen. Dass es bei den Kosten pro Aufgabe mit Opus 5 gleichauf liegt, liegt nur am gesunkenen Preis pro Token, nicht daran, dass es weniger nachdenkt.
Die zweite Rechnung ist die Zeit. Die Modellseite für Effort max meldet eine Time to First Token von 682,71 Sekunden, also mehr als elf Minuten, bis das erste Token ankommt, obwohl die Output-Geschwindigkeit mit 95,5 Tokens pro Sekunde höher ist als bei Opus 5. Für Effort medium meldet dieselbe Seite 13,20 Sekunden. Für einen Hintergrundjob sind elf Minuten in Ordnung. Für alles, wobei ein Benutzer zusieht, ist das keine Einstellung, sondern ein Ausfall.
Die Preissenkung und warum Caching jetzt mehr zählt
Opus 5.5 kostet 4 $ pro Million Input-Tokens und 20 $ pro Million Output-Tokens, 20 % weniger als die 5 $ und 25 $ von Opus 5, laut der Modellübersicht von Claude und der Modellseite von Artificial Analysis. Cache-Lesezugriffe sind noch stärker gefallen, um 60 %, von 0,50 $ auf 0,20 $ pro Million Tokens, und Schreibzugriffe in den Fünf-Minuten-Cache von 6,25 $ auf 5 $. Das Kontextfenster umfasst eine Million Tokens.
Nach den Cache-Zahlen solltest du handeln. Ein lang laufender Agent schickt bei jedem Zug seinen Verlauf erneut, und ein gesprächigeres Modell lässt diesen Verlauf schneller wachsen. Bei 0,20 $ pro Million gecachter Tokens ist ein stabiler Prefix fast gratis, ein ungecachter ist zwanzigmal teurer. Wenn du deinen Prompt-Prefix noch nicht stabilisiert hast, erklärt der Leitfaden zu Prompt-Caching und Routing, wie das geht, und auf Opus 5.5 ist die Ersparnis größer als auf jedem früheren Claude-Modell.
Was ich damit tatsächlich machen würde
Das Leaderboard sagt dir, welches Modell am stärksten ist. Es sagt dir nicht, welche Stufe du fahren sollst, und genau dort liegt das Geld. In dieser Reihenfolge würde ich vorgehen:
- Medium zum Standard machen. Es zieht mit dem bisherigen Flaggschiff gleich, für ein Viertel der Kosten, und antwortet in Sekunden statt Minuten. Die meisten interaktiven Features sollten hier anfangen.
- Max für Arbeit reservieren, auf die niemand wartet: nächtliche Analysen, große Refactorings durch einen Coding-Agenten, das Erzeugen von Evals. Die Tokens explizit budgetieren, denn 119.000 Output-Tokens pro Aufgabe summieren sich.
- Nach Regel eskalieren, nicht nach Gefühl. Zuerst medium laufen lassen und erst auf high oder max wechseln, wenn eine Prüfung fehlschlägt, mit einer vorab aufgeschriebenen Eskalationsbedingung. Ein kleines Modell für typisierte Entscheidungen wie im Artikel über Jev-Routing ist ein günstiger Weg, diese Entscheidung zu treffen.
- Aggressiv cachen. Mit einem um 60 % niedrigeren Preis für Cache-Lesezugriffe ist ein stabiler Prefix jetzt die größte einzelne Ersparnis bei langen Agenten-Sitzungen.
- Vor dem Wechsel die eigenen Evals erneut laufen lassen. Opus 5.5 medium mit dem vergleichen, was heute läuft, auf demselben bewerteten Set; der Leitfaden zu Evals zeigt, wie man eines an einem Nachmittag baut.
Hinter allen fünf Punkten steckt dasselbe Muster: Die Effort-Stufe ist jetzt eine Produktentscheidung, kein Modelldetail. Das Team, das sie pro Feature wählt, bekommt die Qualität des letzten Flaggschiffs für einen Bruchteil der letzten Rechnung. Das Team, das alles auf max lässt, bezahlt für Antworten nach elf Minuten. Wenn du Hilfe bei dieser Entscheidung für ein echtes System willst: Auf der Seite KI-Entwicklung beschreibe ich, wie ich das angehe.
Quellen
- Artificial Analysis: Claude Opus 5.5 takes the top spot on the Artificial Analysis Intelligence Index (22. September 2026)
- Artificial Analysis: Modellseite Claude Opus 5.5 (max)
- Artificial Analysis: Modellseite Claude Opus 5.5 (medium)
- Artificial Analysis: Modellseite Claude Opus 5 (max)
- Artificial Analysis: Modell-Leaderboard und Intelligence Index
- OfficeChai: Claude Opus 5.5 creates a 5-point lead over GPT-6 Astra
- Claude API-Dokumentation: Models overview, Kontextfenster und Preise (Stand September 2026)
Häufige Fragen
Was ist der Artificial Analysis Intelligence Index?
Ein zusammengesetzter Wert, den Artificial Analysis veröffentlicht, ein unabhängiges Benchmarking-Unternehmen, das dieselben Evaluierungen auf jedem großen Modell laufen lässt. Version 4.3.2 kombiniert zehn Evaluierungen, darunter Terminal-Bench 4.0, SciCode, Humanity's Last Exam, GDPval-AA und AA-Omniscience, und erscheint neben Kosten pro Aufgabe, Output-Tokens und Geschwindigkeit.
Welches Modell ist die Nummer eins im Leaderboard von Artificial Analysis?
Stand 28. September 2026 ist es Claude Opus 5.5 mit Effort max, mit einem Wert von 58 im Intelligence Index. GPT-6 Astra und Claude Fable 5.1 folgen mit 53, Claude Opus 5 mit Effort max kommt auf 51. Artificial Analysis hat das Ergebnis am 22. September 2026 veröffentlicht.
Ist Claude Opus 5.5 im Betrieb teurer als Opus 5?
Mit Effort max kostet es pro Aufgabe ungefähr gleich viel, 5,98 $ gegenüber 5,86 $, weil der niedrigere Token-Preis die rund 1,6-mal so vielen Output-Tokens ausgleicht. Mit Effort medium erreicht es den Max-Wert von Opus 5 für 1,34 $ pro Aufgabe und ist bei gleicher Qualität also deutlich günstiger.
Welche Effort-Stufe von Opus 5.5 sollte ich in der Produktion nutzen?
Für interaktive Features mit medium anfangen: Die Stufe erreicht 51 im Index, und Artificial Analysis meldet eine Time to First Token von 13,20 Sekunden. High, xhigh und max für Hintergrundarbeit reservieren, bei der mehr als zehn Minuten Latenz akzeptabel sind, nach einer vorab festgelegten Regel eskalieren und die Wahl mit dem eigenen Eval-Set bestätigen.
Wie stark haben sich die Preise von Opus 5.5 geändert?
Input und Output sind um 20 % gefallen, von 5 $ und 25 $ auf 4 $ und 20 $ pro Million Tokens. Cache-Lesezugriffe sind um 60 % gefallen, von 0,50 $ auf 0,20 $ pro Million Tokens, und Schreibzugriffe in den Fünf-Minuten-Cache von 6,25 $ auf 5 $. Ein stabiler, gecachter Prompt-Prefix ist damit mehr wert als auf jedem früheren Claude-Modell.