Blog/Retrieval és keresés
A RAG-index frissen tartása: növekményes indexelés, CDC és blue/green újrabeágyazás
A RAG-index frissen tartása: elavulási keret, változáskövetés, CDC Postgresből Debeziummal, törlések, jogosultságok, blue/green csere és költség.
Balázs Csorba··frissítve ·8 perc olvasás
- RAG
- Change data capture
- PostgreSQL
- Vector databases
- Data freshness
A lényeg röviden
- Adjon minden forrásnak percekben megadott elavulási keretet, és ehhez mérje a késést; az „előbb-utóbb konzisztens” nem tesztelhető követelmény.
- Sok forráshoz elég a vízszintjel és a tartalom-hash; a Postgresből logikai dekódolással és Debeziummal végzett CDC azokhoz a forrásokhoz való, ahol percek számítanak, a replikációs slotjait pedig felügyelni kell.
- A törlések és a jogosultságváltozások azok a változások, amelyeket az indexelők elmulasztanak: az Azure AI Search dokumentációja szerint az indexelők nem követik a törléseket, a GDPR szerinti törlésnek pedig indokolatlan késedelem nélkül kell megtörténnie.
- A modellváltás miatti újrabeágyazás egy alias mögötti új gyűjteménybe való, egyetlen API-hívással átkapcsolva és visszalépéshez megtartva; pgvectorban párhuzamosan építse az indexeket.
- A token az olcsó rész: 100 millió token újrabeágyazása millió tokenenként 0,02 dolláron kb. 2 dollár; a valódi költség a fejlesztés, a visszatöltési idő és a helyesség.
A növekményes indexelés RAG-hoz az a réteg, amely az első bejárás után is igaznak tartja az indexet: az új dokumentumokat feldarabolja és beágyazza, a módosultakat lecseréli, a törölteket eltávolítja, a jogosultságváltozások pedig eljutnak az indexbe, mielőtt valaki olyan dokumentumot látna, amelyet nem lenne szabad. A legtöbb RAG-prototípus kihagyja, mert az első bemutató egy statikus mappát használ. Az éles korpuszok egész nap változnak, és egy asszisztens, amely a múlt heti árlistát vagy egy visszavont szabályzatot idéz, rosszabb annál, amelyik bevallja, hogy nem tudja.
Ez a cikk az elavulási keretről, a vízszintjelekkel és hash-ekkel végzett változáskövetésről, a Postgresből végzett változásrögzítésről (CDC), a törlésekről és jogosultságváltozásokról, a blue/green cserével végzett teljes újraindexelésről, az újrabeágyazás költségéről, és arról szól, mikor túlzás a CDC. A darabolást, a visszakeresést és az újrarangsorolást a RAG-folyamatok: darabolás, hibrid keresés és újrarangsorolás tárgyalja; a verziók és árak 2026 októberi állapotot tükröznek.
Mit jelent a friss: elavulási keret
A friss forrásonként mért számot jelent, nem érzést. Írja le minden forrásra, hány perc alatt kell egy változásnak eljutnia az indexbe: talán öt a készletszintekhez, egy óra a termékleírásokhoz, egy nap az archivált kézikönyvekhez, és azonnal a visszavont hozzáférésekhez. Ezeket a számokat semmilyen szabvány nem írja elő; abból következnek, mibe kerül egy rossz válasz. Ezután mérje a tényleges késést a forrásbeli véglegesítéstől az indexbe írásig, és riasszon, ha átlépi a keretet.
A keretből az is kiderül, milyen mechanizmus kell. A napi keretet egy éjszakai söprés teljesíti; az ötperces kerethez gyakori bejárás vagy események kellenek; a jogosultságokra vonatkozó másodperces keret általában azt jelenti, hogy a hozzáférést lekérdezéskor és az indexben is ellenőrizni kell. Az index felosztása segít. Spryker- és Pimcore-alapú katalógusokban az ár és a készlet egész nap változik, a hosszú leírások ritkán, így az illékony skalármezők metaadatként frissíthetők anélkül, hogy a mellettük lévő szöveget újra be kellene ágyazni.
Változáskövetés vízszintjelekkel és hash-ekkel
A legtöbb forráshoz nem kell adatbázisnapló, csak megbízható módja annak, hogy kiderüljön, mi változott az utolsó futás óta. A vízszintjel a klasszikus minta: jegyezze meg a legnagyobb feldolgozott updated_at értéket, és legközelebb az e fölötti sorokat kérje le. Az Azure AI Search újrahasznosítható változásészlelési szabályként nevezi meg, ütemezett indexelői pedig 5 percenként és 24 óránként között futhatnak (Azure AI Search). Használjon monoton növekvő oszlopot, tartson kis átfedési ablakot, és tegye idempotenssé az írásokat, mert az órák és a hosszú tranzakciók régebbi időbélyeggel véglegesülő sorokat hoznak létre.
A tartalom-hash kiegészíti a vízszintjelet. A beágyazandó szöveget hash-elje, ne az egész sort, és hagyja ki az újrabeágyazást, ha a hash nem változott; így egy árfrissítés csak a metaadatot érinti. Ugyanez az ötlet kisebb léptékben fájlokra és repókra is működik, ahol fájlonként egy hash dönti el, mit kell újradarabolni, ahogy a RAG kódon leírja. Mindkettő gyenge pontja a törlés: egy már nem létező sor sosem jelenik meg a módosult sorokra irányuló lekérdezésben.
A söpréshez az elcsúszás elleni védelem is kell. Hetente egyszer vesse össze a forrásazonosítók teljes listáját az indexben lévő azonosítókkal: ami az indexben van, de a forrásban nincs, az elmulasztott törlés, ami a forrásban van, de az indexben nincs, az elmulasztott beszúrás. Ez az összevetés olcsó, minden más mechanizmus hibáit elkapja, és az eredménye egy szám, amely a késés mellé ugyanarra a műszerfalra kerülhet.
Változásrögzítés Postgresből
A változásrögzítés a táblák lekérdezgetése helyett az adatbázis write-ahead naplójából olvassa a véglegesített változásokat, így a beszúrások, módosítások és törlések egyaránt másodperceken belül eseményként érkeznek. Postgresben a mechanizmus a logikai dekódolás, „az adatbázis tábláin végzett összes tartós változás koherens, könnyen érthető formátumba történő kinyerése”, amely replikációs slotokra és egy kimeneti bővítményre épül (PostgreSQL). Egy publikáció határozza meg, mely táblák tartoznak bele (CREATE PUBLICATION), a sémaváltozásokat viszont nem replikálja, így a DDL külön feladat (korlátozások).
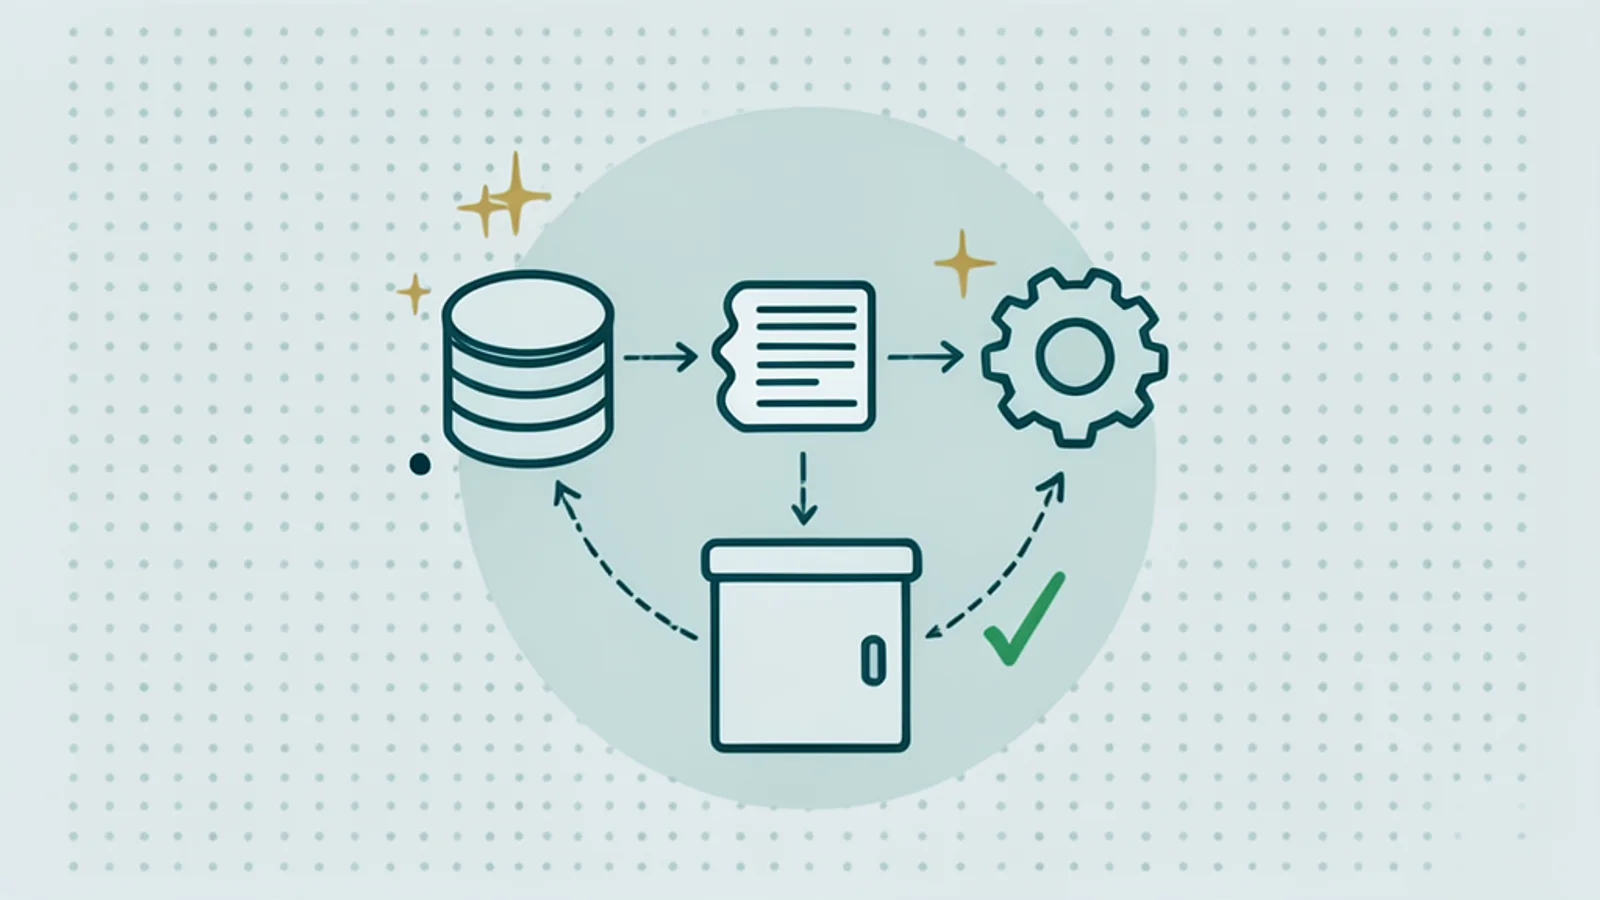
A feldolgozás szokásos módja a Debezium. A PostgreSQL-csatlakozójához wal_level=logical és elegendő WAL-küldő és replikációs slot kell, a dokumentációja pedig egyenesen fogalmaz a kockázatról: a replikációs slotok kiesés alatt is megtartanak minden WAL-t, amelyre a Debeziumnak szüksége van, ezért felügyelni kell őket, hogy elkerülje a lemez megtelését és a katalógus felfúvódását (Debezium). A módosítási események csak REPLICA IDENTITY FULL mellett tartalmazzák az előző oszlopértékeket; egy heartbeat-intervallum akkor is mozgásban tartja a slotot, ha a rögzített táblák csendesek, egy jelzőtábla pedig teljes újraindexelés helyett célzott visszatöltést indít.
-- Postgres side of CDC: scope, slot health and lag
ALTER TABLE products REPLICA IDENTITY FULL;            -- update events carry old values too
CREATE PUBLICATION rag_sources FOR TABLE products, product_texts, document_acl;

-- WAL retained by each slot: alert long before the disk fills
SELECT slot_name, active, wal_status,
       pg_size_pretty(pg_wal_lsn_diff(pg_current_wal_lsn(), confirmed_flush_lsn)) AS behind
FROM pg_replication_slots;
A Postgres elérhetővé teszi a késésriasztáshoz szükséges számokat: a pg_replication_slots minden slotnál mutatja a megerősített pozíciót és a WAL-állapotot, a max_slot_wal_keep_size pedig korlátozza, mennyi WAL-t tarthat meg egy slot, mielőtt érvénytelenné válik (PostgreSQL). A jelenlegi WAL-pozíció és a slot megerősített pozíciója közötti különbségre riasszon, jóval mielőtt eléri ezt a korlátot. A rendszerek között amúgy is áramló rendelési és katalógusadatokra ugyanazok az outbox- és idempotenciaminták érvényesek, lásd rendelésszinkron a webshop és az ERP között.
Törlések és jogosultságváltozások
A törlések és a jogosultságváltozások azok a változások, amelyeket az indexelők a leggyakrabban elmulasztanak, és éppen ennek a kettőnek vannak jogi következményei. Az Azure AI Search egyértelműen fogalmaz: az indexelő nem követi az objektumok törlését az adatforrásokban, ezért logikai törlési stratégia kell, és a szabályt a legelső indexelő futástól alkalmazni kell, különben a törölt dokumentumok az indexben maradnak (Azure AI Search). A GDPR 17. cikke szerint a személyes adatokat indokolatlan késedelem nélkül törölni kell, ha a törlés esedékes (GDPR), és az ilyen adatok darabjait tartalmazó vektorindex is ide tartozik.
Mindkettőt kezelje kifejezetten. Minden darabon tárolja a forrás- és dokumentumazonosítót, hogy egy törlés egyetlen hívással eltávolíthassa egy dokumentum összes darabját; ahol van, dolgozza fel a CDC törlési eseményeit; és futtasson rendszeres egyeztetést, amely eltávolítja azokat a darabokat, amelyek forrása már nem létezik. A hozzáférés-szabályozáshoz a jogosultsági állapotot tartsa az indexben a szöveg és a vektorok mellett, a jogosultságváltozásokat pedig önálló eseményként továbbítsa. Az Azure AI Search ma már az indexben tárolja az ACL-metaadatokat, és 2026-ban a SharePoint-indexelőjéhez futásonkénti növekményes ACL-szinkront adott hozzá (Azure AI Search).
Teljes újraindexelés és blue/green csere
Néhány változás nem alkalmazható növekményesen: egy új beágyazó modell, új darabolási stratégia vagy új indexkonfiguráció azt jelenti, hogy minden vektor megváltozik. Ezt kezelje migrációként, blue/green cserével. A Qdrant pontosan erre az esetre dokumentálja az aliasokat, a vektorverziók közötti váltásra „a neurális háló új verziójára való frissítéskor”, az aliasmódosításokat egyetlen műveleti kérésként küldve (Qdrant); az Elasticsearch aliasai ugyanezt a célt szolgálják, és leállás nélküli újraindexelés módjaként dokumentáltak (Elastic).
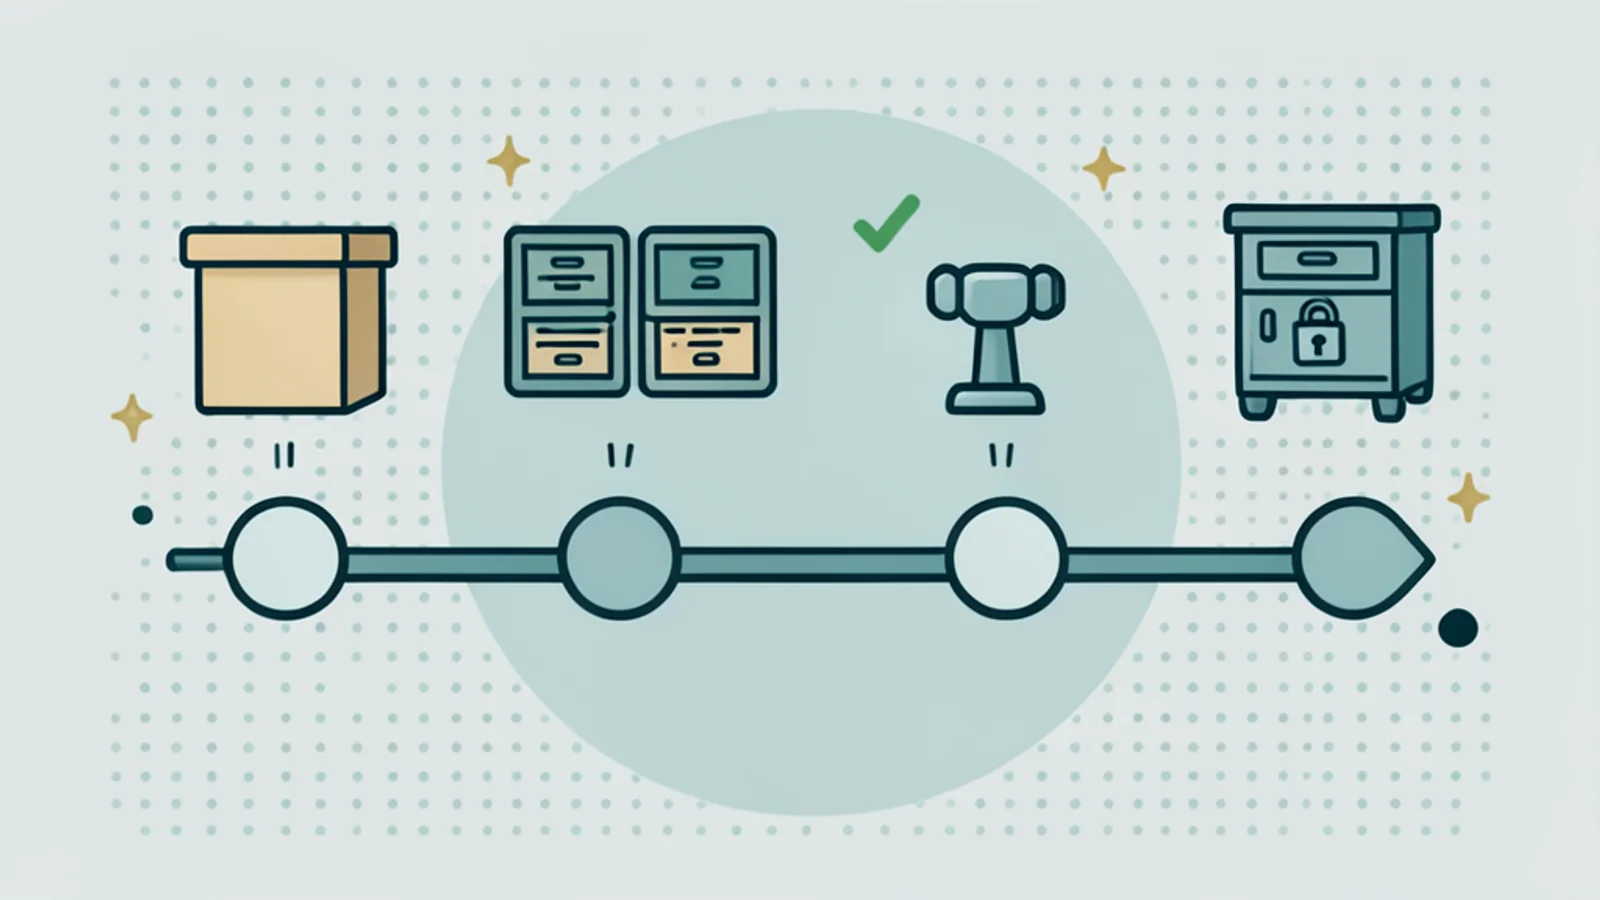
A sorrend mindenhol ugyanaz: építse fel az új gyűjteményt az új modellel, miközben a régi kiszolgál, töltse fel a forrásból, a visszatöltés alatt az új változásokat írja mindkettőbe, kapcsolja át az aliast, és a régi gyűjteményt tartsa meg csak olvashatóként, amíg az új élesben át nem megy a visszakeresési kiértékelésén. A dokumentáció az aliashívást írja le, nem a terhelés alatti tranzakciós garanciáit, ezért az átkapcsolást előbb egy tesztkörnyezeti másolaton próbálja ki. pgvectorban ennek megfelelője egy új oszlop vagy tábla, egy CREATE INDEX CONCURRENTLY paranccsal épített index, hogy az írások ne blokkolódjanak, és váltás az alkalmazás konfigurációjában (pgvector).
A pgvector két gyakorlati megjegyzést tesz: az indexépítés jóval gyorsabb, ha a HNSW-gráf befér a maintenance_work_mem keretbe, és az m = 16, valamint az ef_construction = 64 alapértékek észszerű kezdést jelentenek az új indexhez. A célmodell kiválasztása külön döntés, ezt a beágyazó modell kiválasztásáról szóló cikk tárgyalja.
Az újrabeágyazás költsége
A token az olcsó rész. 2026 októberében az OpenAI a text-embedding-3-small modellt millió tokenenként 0,02, a text-embedding-3-large modellt 0,13 dollárért kínálja (OpenAI), a Voyage a voyage-4-lite-ot 0,02, a voyage-4-et 0,06 dollárért millió tokenenként, kötegelt kedvezménnyel (Voyage). Egy 100 millió tokenes korpusz újrabeágyazása így nagyjából 2–13 dollár API-díj. Ez listaárakkal végzett számítás, nem árajánlat, és minden máshoz képest csekély.
A valódi költségek máshol vannak: órákig tartó visszatöltés sebességkorlátok mellett, egy kettős írási ablak, amelynek helyesnek kell lennie, többlettárhely, amíg két index létezik, és egy visszakeresési kiértékelés az új modellel az átkapcsolás előtt. A saját Nuxt-oldalamon, ahol LLM-funkciókat futtatok egy kis korpuszon, mindent újra beágyazni triviális, és éppen ezért nem a tokenszámla az ok a CDC megépítésére; hanem a frissesség, a törlések és a jogosultságok.
Teljes újrabeágyazás előtt egy rövidítést érdemes megvizsgálni. Egyes szolgáltatók olyan modellcsaládokat írnak le, amelyek tagjai közös beágyazási teret használnak, ami lehetővé tenné, hogy először a lekérdezési oldalt frissítse; mielőtt erre támaszkodna, ellenőrizze az ilyen állítást a szolgáltató saját dokumentációjában és a kiértékelő készletével, mert az összeférhetetlen modellek vektorainak keverése észrevétlenül rontja a visszakeresést.
Mikor túlzás a CDC
A CDC túlzás, ha az elavulási keret órák vagy egy nap, ha a forrás egy SaaS-rendszer adatbázis-hozzáférés nélkül, vagy ha a csapatban senki sem fogja figyelni a replikációs slotokat. Egy éjszakai vagy óránkénti söprés vízszintjelekkel, tartalom-hash-ekkel és törlési egyeztetéssel egyszerűbb, könnyebben átlátható, és a legtöbb dokumentumgyűjteményhez elég. SaaS-forrásoknál a webhookok jelentik az eseményutat: ellenőrizzen egy titkot, 10 másodpercen belül válaszoljon, ellenőrizze az esemény típusát, kérje újra az elmaradt kézbesítéseket, és a kézbesítési azonosító alapján deduplikáljon, ahogy a GitHub útmutatója leírja (GitHub).
| Mechanizmus | Jellemző elavulás | Észleli a törlést | Észleli a jogosultságváltozást | Üzemeltetési teher |
|---|---|---|---|---|
| Éjszakai teljes újraindexelés | akár egy nap | igen, újraépítéssel | igen, újraépítéssel | alacsony, de nagy méretnél drága |
| updated_at söprés | perctől óráig | nem, egyeztetés kell | csak ha az ACL-sorokon van időbélyeg | alacsony |
| Tartalom-hash összevetés | futásonként | igen, ha a teljes listát összeveti | nem | alacsony |
| CDC logikai dekódolással | másodpercek | igen, törlési események | igen, ha az ACL-táblák publikáltak | magas: slotok, késés, séma |
| Bejövő webhookok | másodpercek | ha a forrás küldi | ha a forrás küldi | közepes: újrapróbálás, dedup |
Ellenőrzőlista egy naprakész indexhez
- Forrásonként határozzon meg elavulási keretet, és ehhez mérje a késést.
- Minden darabon tárolja a forrásazonosítót, a dokumentumazonosítót, a tartalom-hash-t és a jogosultságokat.
- Csak akkor ágyazzon be újra, ha a beágyazott szöveg változott; egyébként a metaadatot frissítse.
- A törléseket és jogosultságváltozásokat kifejezetten továbbítsa, és a törlést végig tesztelje.
- CDC esetén riasszon a replikációs slotok késésére és a megtartott WAL-ra.
- Tartson rendszeres söprést, amely elkapja, amit az események elmulasztottak.
- A modellváltást alias mögötti blue/green migrációként végezze, visszalépési lehetőséggel.
Ha a RAG-rendszerének helyesnek kell maradnia, miközben a mögöttes adatok egész nap változnak, nézze meg a MI-mérnöki munkámat. Ugyanennek a problémának a termékadat-oldalát a Pimcore ERP delta szinkron tárgyalja.
Források
- PostgreSQL docs: logical decoding concepts
- Debezium docs: PostgreSQL connector
- PostgreSQL docs: CREATE PUBLICATION
- PostgreSQL docs: pg_replication_slots
- Azure AI Search: changed and deleted blobs
- Azure AI Search: scheduling indexers
- Qdrant docs: collections and aliases
- Elastic docs: aliases
- pgvector on GitHub
- GDPR Article 17
- OpenAI API pricing
- Voyage AI docs: pricing
Gyakori kérdések
Hogyan tartsam naprakészen a RAG-indexet?
Kövesse, mely forrásrekordok változtak, vízszintjellel, tartalom-hash-sel vagy változásrögzítéssel (CDC), csak ezeket darabolja és ágyazza be újra, a törléseket és jogosultságváltozásokat kifejezetten továbbítsa, és futtasson rendszeres söprést, amely elkapja, amit az eseményút elmulasztott. A késést forrásonkénti elavulási kerethez mérje.
Mi a változásrögzítés (CDC) a RAG-ban?
A változások olvasása az adatbázis naplójából a táblák lekérdezgetése helyett. Postgresben a logikai dekódolás elérhetővé teszi a véglegesített beszúrásokat, módosításokat és törléseket, a Debezium pedig ezekből eseményeket készít, amelyeket egy indexelő másodperceken belül feldolgozhat. Replikációs slotok kellenek hozzá, amelyek a feldolgozásig megtartják a WAL-t, és felügyelni kell őket.
Hogyan jutnak el a törlések a vektorindexbe?
Csak ha elküldi őket. Sok indexelő nem követi a forrásbeli törléseket, ezért használjon CDC-ből származó törlési eseményeket, az indexelő által olvasott logikai törlésjelzőt, vagy rendszeres egyeztetést, amely eltávolítja azokat a darabokat, amelyek forrásazonosítója már nem létezik. A személyes adatokat a GDPR szerint indokolatlan késedelem nélkül törölni kell.
Hogyan ágyazzak be újra új modellel leállás nélkül?
Építsen új gyűjteményt az új modellel, miközben a régi kiszolgál, töltse fel, az új változásokat írja mindkettőbe, majd egyetlen hívással kapcsoljon át egy aliast az új gyűjteményre, a régit pedig tartsa meg csak olvashatóként a visszalépéshez. pgvectorban párhuzamosan hozza létre az új indexet, és konfigurációban váltson.
Mennyibe kerül egy korpusz újrabeágyazása?
2026 októberében millió tokenenként 0,02–0,13 dolláros beágyazási API-árakkal 100 millió token újrabeágyazása nagyjából 2–13 dollár. A valódi költség a visszatöltési idő, a sebességkorlátok, az átkapcsolás fejlesztése és a keresési minőség újraellenőrzése az új modellel.