Blog/RAG és keresés
Termelési RAG pipeline lépésről lépésre: chunkelés, hibrid keresés, újrarangsorolás
Építs RAG pipeline-t lépésről lépésre: parse, chunkelés, pgvector, BM25 plusz vektorok RRF-fel, újrarangsorolás, hivatkozások és retrieval evalek.
Balázs Csorba··10 perc olvasás
- RAG
- Hybrid search
- Chunking
- Reranking
- pgvector
A lényeg röviden
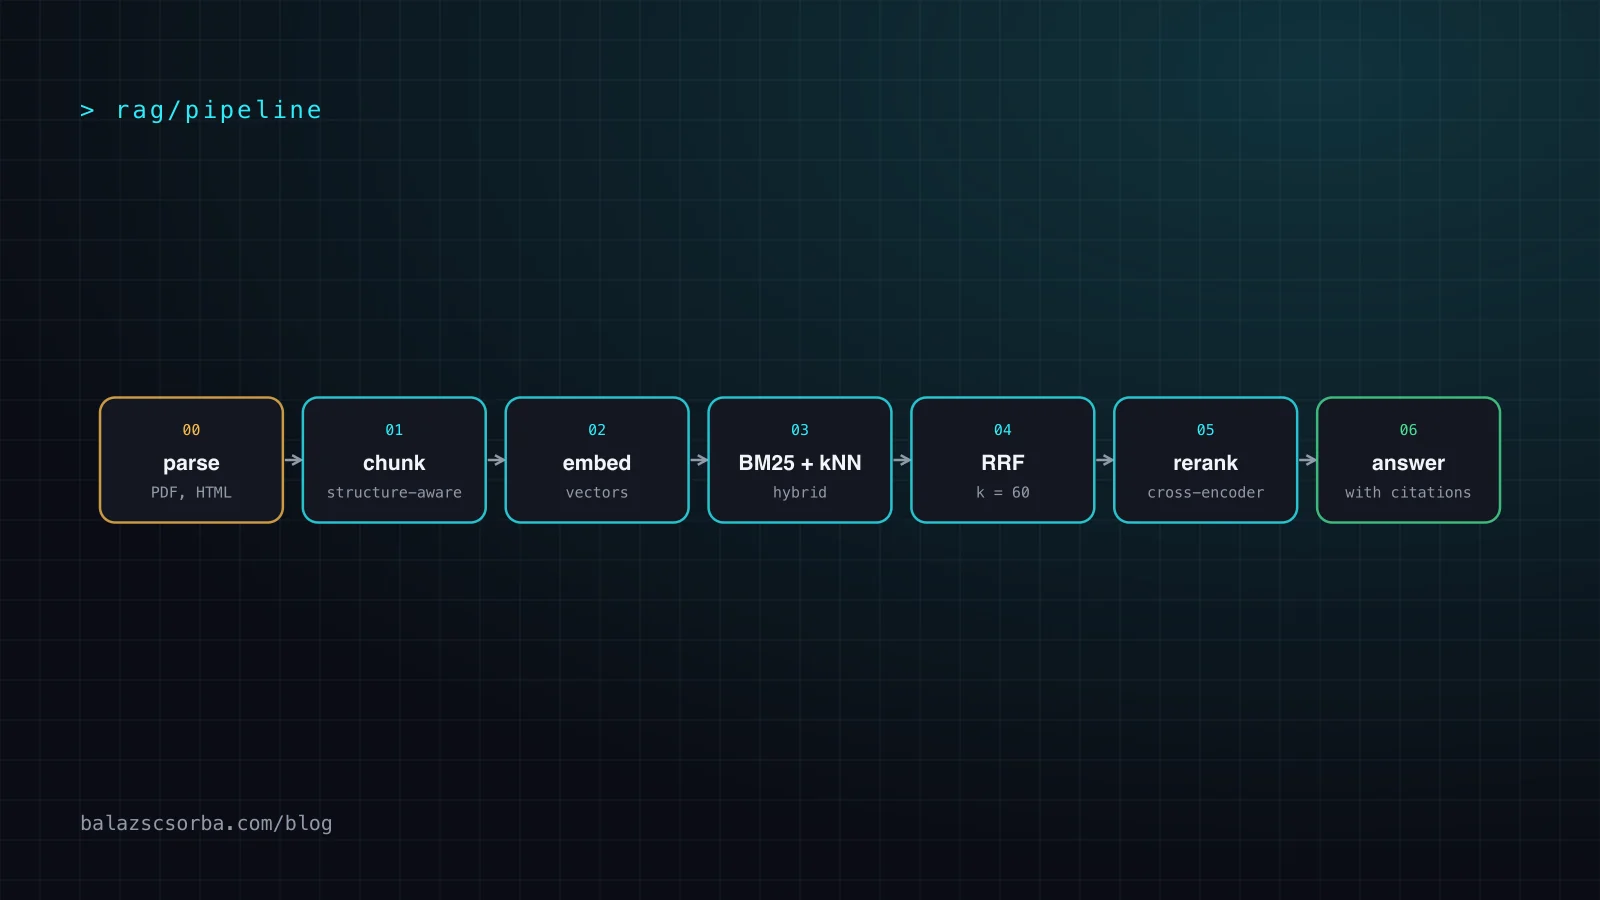
- A RAG pipeline-nek van egy offline fele (parse, chunk, embed, index) és egy online fele (keresés, fuzió, újrarangsorolás, generálás), amelyek egy indexet osztanak.
- A néhány száz tokenes, szerkezet tudatos chunkek cím- és heading útvonal fejléccel erős alapértelmezés; a Chroma szerint a 800/400 tokenes alapértelmezés a leggyengébb.
- A hibrid keresés párhuzamosan futtatja a BM25-öt és a vektorkeresést, és Reciprocal Rank Fusionnel fuzionálja őket: score = az 1 / (60 + rank) összege.
- A kontextuális embeddingek és a BM25 fölé tett cross-encoder reranker 5.7%-ról 1.9%-ra csökkentette az Anthropic top-20-as retrieval hibaarányát.
- A retrievalt (recall@k, MRR, nDCG) külön mérd a generálástól (hűség a forráshoz), és a jogosultságokat a retrieval queryen belül kényszerítsd ki.
A RAG pipeline azoknak a lépéseknek a lánca, amelyek a dokumentumaidat kereshető chunkekké alakítják, és amikor egy kérdés érkezik, megkeresik azt a néhány részletet, amelyre egy nyelvi modellnek szüksége van, hogy bizonyítékokra építve válaszoljon. A retrieval-augmented generationt (RAG) 2020-ban Lewis et al. vezette be: olyan modellek leírásaként, amelyek az előzetesen betanított parametrikus és nem parametrikus memóriát kombinálják, vagyis egy generátort és egy idegrendszeri retrievert egy sűrű vektorindex fölött.
Ez a cikk végigvisz egy termelési pipeline-t, szakaszonként: parse, chunkelés, embeddingek és egy HNSW index, hibrid BM25 plusz vektorkeresés, összefésülve Reciprocal Rank Fusionnel (működő kóddal), cross-encoderes újrarangsorolás, generálás hivatkozásokkal, és azok a metrikák, amelyek megmondják, melyik szakasz hibázik. Ha még mindig azon tanakodsz, kell-e egyáltalán retrieval, először olvasd el a RAG 2026-ban: hibrid retrieval, ügynöki keresés vagy egymillió tokenes kontextus cikket.
Mi az a RAG pipeline?
A RAG pipeline-nek két fele van, amelyek egy indexet osztanak: az egyik az offline indexelési út, amely parse-ol, chunkel, embeddingel és tárolja a dokumentumokat, a másik az online lekérdezési út, amely keres, fuzionál, újrarangsorol és generál. A legtöbb minőségi probléma az offline felben kezdődik, noha csak a válaszokban mutatkozik meg.
Minden szakásznak egy feladata van, és mindegyik külön mérhető. Ez a szétválasztás akkor számít, ha egy válasz hibás, mert az ok négy különböző helyen lehet: egy chunk, amit soha nem hoztak létre (parse), egy chunk, ami létezik, de nem került vissza (retrieval), egy chunk, ami visszakerült, de a küszöb alá került a rangsorban (fuzió vagy újrarangsorolás), vagy egy helyes chunk, amit a modell figyelmen kívül hagyott (generálás). Ha csak a végső választ méri, ezeket nem tudod megkülönböztetni.
Hogyan parse-oljunk és chunkeljünk dokumentumokat?
Parse-olj dokumentumokat tiszta szöveggé, megőrizve a szerkezetet és a metaadatokat, majd bontsd őket a saját szerkezetük mentén néhány száz tokenes chunkekre, amelyek önmagukban is értelmesek. A chunkelés a legolcsóbb szakasz, amit meg lehet változtatni, és az egyik legbefolyásolóbb.
Parse: tartsd meg a szerkezetet és a metaadatokat
- A PDF-ek többhasábos elrendezésben elveszítik az olvasási sorrendet, és minden oldalon megismétlik a fej- és láblécet. Vedd le az ismétlődéseket, és nézz meg szemmel egy mintát a kinyert oldalakból, mielőtt bármit tovább hangolnál.
- A táblák összeomlatták a naiv splittereket. Egy „4.2” értéket tartalmazó cella a sor- és oszlopfejléce nélkül semmit nem jelent, tehát a kis táblákat vagy egészen Markdownként tartsd meg, vagy írj egy sort táblasoronként, ami megismétli az oszlopneveket.
- A metaadatok minden chunkon helyük van: dokumentumazonosító, cím, heading útvonal, forrás URL, utolsó módosítás dátuma, nyelv, és azok a csoportok, amelyek olvashatják. Az indexeléskor eltárolt hozzáférési szabályok teszik lehetővé a későbbi jogosultság szerinti szűrést.
- Tartalom hash dokumentumonként lehetővé teszi, hogy csak a megváltozottakat indexeld újra.
Chunkelési stratégiák összehasonlítása
| Stratégia | Hogyan oszt | Előny | Hátrány |
|---|---|---|---|
| Fix tokenméret | Minden N token, gyakran átfedéssel | Triviális, kiszámítható méret | Középen vágja el a mondatokat és a táblákat; az átfedés duplikálja a szöveget |
| Rekurzív / szerkezet tudatos | Címsorok, aztán bekezdések, aztán mondatok, méretkorlátig | A chunkok követik a szerző szerkezetét | Tiszta parse-ra van szükség; egyenetlen chunkméretek |
| Szemantikus | Ott törik, ahol a mondatok közötti embedding hasonlóság csökken | Témailag összefüggő chunkok | További embeddingköltség indexeléskor; nehezebb hibakeresni |
| Kontextuális fejlécek | A fenti bármelyik, plusz egy előre fűzött cím, heading útvonal vagy modell által írt összefoglaló | A chunkok önmagukban is kereshetők | A modell által írt kontextus chunkonként egy hívásba kerül |
A legjobb nyilvános összehasonlás, amit ismerek, a Chroma Evaluating Chunking Strategies for Retrieval anyaga (Smith és Troynikov, 2024. július). Token szinten mérte a recallt, a precisiont és az IoU-t, és azt találta, hogy a 200 tokenes, átfedés nélküli rekurzív karakter splitter következetesen jól teljesített, míg az akkori OpenAI Assistants alapértelmezés – 800 tokenes chunkek 400 token átfedéssel – kissé az átlag alatti recallt és a legrosszabb értékeket adta a többi metrikán. A hasznos rész az ő következtetésük: „A chunkelési stratégia megválasztása jelentősen hatással lehet a retrieval teljesítményére.” A számokat kiindulópontnak vedd, és mérj a saját dokumentumaidon.
Az Anthropic Contextual Retrieval cikke a kontextuális fejlécek legerősebb változata: egy modell 50–100 tokent ír, amely elhelyezi az adott chunkot a dokumentumában, és ezt a szöveget ágyazás és BM25 indexelés előtt fűzik oda. A saját tesztjükben ez a top-20-as retrieval hibaarányt 5.7%-ról 3.7%-ra, BM25-tel együtt 2.9%-ra csökkentette, egyszeri költséggel körülbelül $1.02 millió dokumentumtokenenként, prompt caching használatával. Az alapértelmezettem olcsóbb: szerkezet tudatos darabolás néhány száz tokenen, determinisztikus fejléccel (cím és heading útvonal), és modell által írt kontextus csak akkor, ha a retrieval evalek azt mutatják, hogy a chunkok emiatt buknak el.
Milyen vektorindexet használjak?
A legtöbb csapatnak elég egy HNSW index abban az adatbázisban, amit amúgy is futtat. A pgvector HNSW és IVFFlat indexeket ad a PostgreSQLhez, így a vektorok, a teljes szövegű és a hozzáférésvezérlő oszlopok egy táblában és egy tranzakcióban vannak.
A HNSW (Malkov és Yashunin, 2016) többrétegű közelségi gráfot épít, és a durva rétegektől a finomak felé keresi, ami nagyjából logaritmikus skálázódással működik. Ez közelítő: egy kevés recallt cserél sok sebességre. A pgvectorban a HNSW jobb lekérdezési teljesítményt ad, mint az IVFFlat, de lassabban épül; az építési paraméterek alapértékei m = 16 és ef_construction = 64, a lekérdezéskori jelöltlista, azaz az hnsw.ef_search alapértéke 40.
-- One table for vectors, full-text and permissions (pgvector + Postgres FTS)
CREATE EXTENSION IF NOT EXISTS vector;

CREATE TABLE chunks (
  id           bigserial PRIMARY KEY,
  doc_id       text NOT NULL,
  allowed      text[] NOT NULL,          -- groups that may read this chunk
  heading_path text,
  content      text NOT NULL,
  embedding    vector(1024),             -- match your embedding model
  tsv          tsvector GENERATED ALWAYS AS (to_tsvector('english', content)) STORED
);

CREATE INDEX ON chunks USING hnsw (embedding vector_cosine_ops);
CREATE INDEX ON chunks USING gin (tsv);
CREATE INDEX ON chunks USING gin (allowed);

-- Vector leg of the hybrid query, filtered by the user's groups
SET hnsw.iterative_scan = relaxed_order;
SELECT id FROM chunks
WHERE allowed && $1::text[]
ORDER BY embedding <=> $2
LIMIT 50;
Az iterative_scan sor a jogosultságok miatt fontos. A pgvector README figyelmeztet, hogy közelítő indexeknél „a szűrő az indexkeresés után kerül alkalmazásra”: ha egy feltétel a sorok 10%-ára illeszkedik, a HNSW 40-es alapértékű ef_search mellett csak körülbelül 4 illeszkedő sort ad vissza. Az iteratív indexkeresések (0.8.0-tól) addig keresnek tovább, amíg elég sor nem illeszkedik. Az embedding modellnél az Anthropic tesztjei szerint a Voyage és a Gemini embeddingjei teljesítettek a legjobban, de csináld a saját összehasonlításodat, és jegyezd meg, hogy modellváltáskor az egész korpuszt újra kell ágyazni.
Hogyan működik a hibrid keresés BM25-tel és vektorokkal?
A hibrid keresés párhuzamosan futtat egy lexikális BM25 lekérdezést és egy vektorlekérdezést, majd összefésüli a két ranglistáját. A Reciprocal Rank Fusion (RRF) a legegyszerűbb, robusztus összefesülés, mert a rangokat használja, és figyelmen kívül hagyja a nyers pontszámokat, amelyek nem összehasonlíthatók.
A vektorok a jelentésre illeszkednek, tehát megtalálják a parafrázisokat, de gyengék a pontos tokeneken: hibakódok, SKU-k, alkatrészszámok, nevek és verziósztringek. A BM25 pontos kifejezésekre illeszkedik, jobban súlyozza a ritka kifejezéseket, a gyakran ismétlődő kifejezések hatását viszont telíti. Az Elasticsearch alapértelmezett hasonlatszámításként BM25-öt használ, k1 = 1.2 és b = 0.75 értékekkel. Egy megjegyzés a Postgres felhasználóinak: a beépített ts_rank és ts_rank_cd függvények nem BM25-ök. A PostgreSQL dokumentáció szerint nem „használnak globális információt”, tehát nincs inverz dokumentumgyakoriság. Ez jó kiindulás; ha számít a lexikális minőség, használj keresőmotort vagy egy BM25 kiterjesztést erre a szálra.
Az RRF a Cormack, Clarke és Büttcher (SIGIR 2009) munkájából származik. Minden dokumentum az összes listában kapott 1 / (k + rank) összegét kapja, k = 60 értékkel – ezt az értéket a szerzők egy pilot vizsgálat során rögzítették, és az ezt követő validációban nem változtatták meg. A kísérleteikben az RRF következetesen felülmúlta az egyedi rendszereket és a szokásos Condorcet Fuse módszert is.
// Reciprocal Rank Fusion (Cormack et al., 2009) – TypeScript
type Hit = { id: string }

export function reciprocalRankFusion(lists: Hit[][], k = 60, limit = 50) {
  const scores = new Map<string, number>()
  for (const list of lists) {
    list.forEach((hit, index) => {
      const rank = index + 1 // ranks start at 1
      scores.set(hit.id, (scores.get(hit.id) ?? 0) + 1 / (k + rank))
    })
  }
  return [...scores.entries()]
    .sort((a, b) => b[1] - a[1])
    .slice(0, limit)
    .map(([id, score]) => ({ id, score }))
}

// const fused = reciprocalRankFusion([bm25Top50, vectorTop50])Mindkét szálból több jelöltet vegyél, mint amennyit meg akarsz tartani, például 50-et, hogy egy olyan dokumentum is előtűnjön, amelyet az egyik retriever 30., a másik 5. helyre rangsorolt. A pgvector README ugyanazokat a két összefésülési lehetőséget mutatja, mint ez a cikk: RRF, vagy egy cross-encoder a kombinált jelöltek fölött.
Hogyan működik az újrarangsorolás és a hivatkozott generálás?
Az újrarangsorolt jelölteket futtasd át egy cross-encoderen, adj át a modellnek csak néhány legjobb chunkot, és követelj hivatkozásokat plusz egy kifejezett „a források nem mondják meg” választ. Az újrarangsorolás precizitást vásárol, a hivatkozások pedig ellenőrizhetővé teszik a választ.
Újrarangsorolás cross-encoderrel
Egy embedding modell bi-encoder: a queryt és minden chunkot külön kódolja. A cross-encoder a queryt és egy chunkot együtt olvas, és relevanciapontszámot ad ki. A Sentence Transformers dokumentáció összefoglalja a cserekérdést: „A Cross-Encoders jobb eredményeket érnek el, mint a Bi-Encoders”, de nem állítanak elő embeddingeket, így nem tudnak korpuszt keresni. A szokásos válasz a retrieve-then-rerank: olcsón körülbelül 100 jelöltet szerzel be, aztán a cross-encoderrel minden párt pontozol. Az Anthropic Contextual Retrieval tesztjei egy rerankert tettek a kontextuális embeddingek és a BM25 fölé, és a top-20 hibaarányt 1.9%-ra csökkentették. Az újrarangsorolás jelöltenként egy modellfuttatást jelent, ezért korlátozd a jelöltek számát, és figyeld a késleltetést.
Generálás hivatkozásokkal és egy „nem tudom” válaszszal
Adj minden chunknak azonosítót és címet, tartsd kicsin a darabszámot, és a legerősebb chunkokat tedd elölre. A „Lost in the Middle” tanulmány (Liu et al., 2023) szerint a teljesítmény akkor a legmagasabb, ha a releváns információ a kontextus elején vagy a végén van, középen viszont romlik. Szólj a modellnek, hogy csak a forrásokból válaszoljon, és akkor is mondja ki, ha nincs bennük a válasz, majd ezt a viselkedést teszteld megválaszolatlan kérdésekkel.
Ha Claude-ot használsz, a Citations funkció elvégzi a könyvelést: kapcsold be a citations opciót a dokumentumblokkokon, és a válasz pontosan azokra a részletekre mutat, amelyeket használt, a visszaadott cited_text pedig nem számít bele a kimeneti tokenekbe. Két részlet a dokumentációból: ha konkrét mondatokat akarsz idézni az RAG chunkekből, tedd minden chunkot külön sima szöveges dokumentumba; és a citations nem kombinálható strukturált kimenettel (az API 400-as hibát ad).
Hogyan értékeljük ki a RAG pipeline-t?
Értékeld külön a retrievalt és a generálást. A retrieval címkézett releváns chunk halmazon kap rangsorolási metrikákat; a generálás hűség- és helyességvizsgálatot a visszakeresett kontextuson és egy referencia válaszon.
| Metrika | Szakasz | Mit mér | Mire van szükség |
|---|---|---|---|
| Recall@k | Retrieval | A releváns chunkok aránya, amelyek a top k-ban megjelennek | Releváns chunkazonosítók kérdésenként |
| MRR | Retrieval | Az első releváns chunk 1 / rangjának átlaga | Releváns chunkazonosítók kérdésenként |
| nDCG@k | Retrieval | Lépcsőzetes relevancia, pozíció szerint súlyozva, az ideális sorrendhez normalizálva | Lépcsőzetes relevancia címkék |
| Hűség a forráshoz | Generálás | A válasz állításai, amelyeket a visszakeresett kontextus alátámaszt | Egy LLM grader, referencia nélkül |
| Kontextus recall | Retrieval, értékelt | Hogy a visszakeresett kontextus alátámasztja-e a referencia választ | Egy referencia válasz |
Az Anthropic „failure rate” értéke egyszerűen 1 minus recall@20. A generáláshoz a RAGAS a hűséget így definiálja: „a válaszban lévő, a visszakeresett kontextus által alátámasztott állítások száma / a válaszban lévő állítások teljes száma”, 0 és 1 között. Építs egy gold setet valódi felhasználói kérdésekből, címkézd be az azonosítókat, amelyek megválaszolják őket, és vegyél be kérdéseket, amikre nincs válasz a korpuszban, meg olyanokat, amelyeket a tesztfelhasználó nem láthat. Futtasd újra a retrieval metrikákat minden chunkelés-, embedding- vagy fuzióváltoztatáskor; olcsók és determinisztikusak. A modell által értékelt metrikákat emberi címkékkel kell validálni, erről szól az evals LLM termékfunkciókhoz cikk.
A pipeline üzemeltetése, és mikor nem érdemes építeni
A RAG pipeline egy adatrendszer: kell hozzá inkrementális újraindexelés, törlés, jogosultság szerinti szűrés és verziózott index. Egy kis korpusznál lehet, hogy egyáltalán nem érdemes felépíteni.
- Indexelj újra inkrementálisan. Hasonlítsd össze a tartalom hash-eket, csak a megváltozott dokumentumokat chunkeld újra, és töröld a törölt dokumentumok chunkjeit. A törölt oldalak elavult chunkjei a magabiztosan rossz válaszok gyakori forrásai.
- Verziózd az indexet. Új embedding modell vagy új chunkelési stratégia teljes újraépítést jelent. Építsd az új indexet a régi mellé, futtasd mindkettőn a retrieval evaleket, aztán válts.
- Szűrj jogosultságot a retrievalen belül. Alkalmazd a felhasználó csoportjait a BM25 és a vektorlekérdezésben is. A generálás után szűrni túl késő: a modell már elolvasta a szöveget.
- Figyeld a frissességet. Tárold az utolsó módosítás dátumát, mutasd meg a hivatkozások mellett, és jelezz azoknál a forrásoknál, amelyeknél megszakadt a szinkronizálás.
Mikor ne építs: az Anthropic tanácsa szerint 200 000 token alatti tudásbázisnál (körülbelül 500 oldal) „bevéhető egyszerűen a teljes tudásbázis” a promptba, a prompt caching pedig lent tartja a költséget. Kódalapoknál azok az ügynökök, amelyek grep-pel és fájlolvasással keresnek, gyakran index nélkül is jól boldogulnak. Az pedig, ami mindenre aggregál („hány szerződés jár le idén”), adatbázis lekérdezés, nem top-k retrieval. Ezeknek a lehetőségeknek a mérlege a RAG 2026-ról szóló stratégiai cikk témája, a hosszú prompthoz tartozó költségoldal pedig a prompt caching, routing és batchelés cikkben van.
RAG pipeline checklist
- Nézz szemmel a parse kimenetére egy PDF- és táblamintán, mielőtt bármit más beállítanál.
- Tárolj metaadatot minden chunkon: dokumentumazonosító, heading útvonal, forrás URL, utolsó módosítás dátuma, engedélyezett csoportok.
- Kezdd szerkezet tudatos chunkekkel, néhány száz token mérettel, plusz cím- és heading útvonal fejléccel.
- Futtasd a BM25-öt és a vektorkeresést párhuzamosan, körülbelül 50-50 jelölttel, és fuzionáld őket RRF-fel (k = 60).
- Újrarangsorolj cross-encoderrel, és csak a legjobb néhány chunkot add tovább, a legerősebbekkel elöl.
- Követelj hivatkozásokat és kifejezett választ arra, hogy „nincs a forrásokban”, és teszteld mindkettőt.
- Mérd a recall@k-t és az MRR-t egy címkézett gold seten minden retrieval módosításnál; a hűséget külön ellenőrizd.
- Kényszeríts ki a jogosultságokat a retrieval query-ben, iteratív indexkeresésekkel, ha HNSW indexet szűrsz.
- Verziózd az indexet és építsd újra egymás mellett, ha az embedding modell vagy a chunkelés változik.
Ha egy termékbe építed a retrievalt, és szeretnéd, hogy valaki más is átnézze a pipeline-t vagy az evaleket, nézd meg az AI fejlesztés oldalt.
Források
- Lewis et al., Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks (2020)
- Cormack, Clarke and Büttcher, Reciprocal Rank Fusion outperforms Condorcet and individual Rank Learning Methods (SIGIR 2009)
- Malkov and Yashunin, Efficient and robust approximate nearest neighbor search using HNSW graphs
- pgvector README
- Elasticsearch: similarity settings (BM25 default)
- PostgreSQL: controlling text search (ranking)
- Chroma: Evaluating Chunking Strategies for Retrieval (2024)
- Anthropic: Introducing Contextual Retrieval (2024)
- Sentence Transformers: Cross-Encoders
- Liu et al., Lost in the Middle: How Language Models Use Long Contexts (2023)
- Claude docs: Citations
- RAGAS: Faithfulness metric
Gyakori kérdések
Mekkora chunkméretet használjak RAG-nél?
Kezdd néhány száz tokenes, szerkezet tudatos chunkekkel, címsoroknál és bekezdéseknél vágva, a dokumentum címével és heading útvonalával a végén. A Chroma 2024-es chunkelési tanulmánya szerint a 200 tokenes, átfedés nélküli rekurzív splitter következetesen jól teljesített, míg a 400 token átfedéssel járó 800 tokenes chunkek a leggyengébbek voltak. Utána mérd a recall@k-t a saját dokumentumaidon, mielőtt bármit módosítanál.
Miért Reciprocal Rank Fusiont használni, és nem a BM25- és vektorscore-okat összeadni?
A BM25 score-ok korlátlanok és a korpusztól függenek, a vektorhasonlóságok más skálán mozognak, így összeadáskor az egyik retriever uralkodik. A Reciprocal Rank Fusion figyelmen kívül hagyja a nyers score-okat, és 1 / (k + rank) értékeket summáz a listákon át, k = 60 értékkel (Cormack et al., 2009). Azok a dokumentumok kerülnek előre, amelyeket mindkét retriever magasan rangsorol, és nincs szükség score kalibrálásra.
A PostgreSQL teljes szöveges keresése ugyanaz, mint a BM25?
Nem. A ts_rank és ts_rank_cd függvények figyelembe veszik a kifejezés gyakoriságát, a közelséget és a dokumentum szerkezetét, de a dokumentáció szerint nem használnak globális információt, így nincs bennük inverz dokumentumgyakoriság, mint a BM25-ben. A hibrid keresés lexikális szálához jó kiindulás; ha számít a lexikális rangsorolás minősége, használj keresőmotort vagy egy BM25 kiterjesztést.
Hogyan szűröm a RAG eredményeket jogosultságok szerint a pgvectorral?
Tárold az engedélyezett csoportokat minden chunkon, és alkalmazd őket a vektor- és a teljes szövegű lekérdezés WHERE zarányékában is. HNSW esetén a pgvector a szűrőt az indexkeresés után alkalmazza, így egy szelektív szűrő túl kevés sort adhat vissza; kapcsold be az iteratív indexkereséseket (hnsw.iterative_scan, pgvector 0.8.0 és újabb), hogy az index addig keressen tovább, amíg elég sor nem illeszkedik.