Blog/LLMOps és értékelés
Tipizált döntések LLM routingra és triázsra: kalibrált konfidencia Jevvel
Tipizált döntések az LLM routingban: Choice, Score és igen-valószínűség válaszok kalibrált konfidenciával, küszöbökkel és átadással embernek, Jevvel.
Balázs Csorba··10 perc olvasás
- LLM routing
- Classification
- Calibration
- OpenRouter
- Human in the loop
A lényeg röviden
- A tipizált döntés előre rögzíti a válasz típusát: egy opció egy zárt halmazból, egy szint egy rendezett skálán, vagy annak valószínűsége, hogy egy állítás igaz.
- A TypeSafe Jev modellje az OpenRouter alpha decisions API-ján keresztül csak tipizált válaszokat ad valószínűségekkel; prózát nem állít elő, és meg sem tudja magát magyarázni.
- 2026. szeptemberében a typesafe/jev-1.13 modell 32,000 tokenes kontextussal és $0.042 millió input tokenenkénti árral fut, az output ingyenes.
- A konfidencia egy második tengely: magas konfidenciánál cselekszol, alacsonynál emberhez routingolsz, és azokat a kérdéseket, amelyeknek a valószínűsége 0,3 és 0,7 közé esik, átírod.
- A kalibrálás sok válaszon át érvényes, nem egyetlen elemen, ezért a küszöbök egy címkézett mintából jönnek, az automatikusan alkalmazott döntéseket pedig így is naplózni kell.
Az LLM routing az a pont egy rendszerben, ahol a szoftver eldönti, hogy egy elem melyik úton indul el: melyik queue-ba kerül egy ticket, melyik modell dolgozza fel a kérést, melyik review findingot kell először elolvasnia egy embernek. A legtöbb csapat ezt úgy valósítja meg, hogy feltesz egy kérdést egy chat modellnek, majd parszolja a visszaírt prózát. Ez addig működik, amíg ezerszer le nem futtatod, és észre nem veszed, hogy ugyanaz az elemfajta kedden más választ kap, mint hétfőn.
Ez a bejegyzés ugyanerre a feladatra egy másik alakot ír le: a tipizált döntést, amelyben a modell egy előre definiált halmazból egy értéket ad vissza egy konfidenciaszámmal együtt, és soha nem egy mondatot. Ezt a TypeSafe Jev modelljével csinálom az OpenRouter decisions API-n keresztül, hogy a példák konkrétak legyenek, de a minta (tipizált válaszok, explicit küszöbök, az alacsony konfidencia emberhez kerül) minden olyan osztályozóra érvényes, amit egy munkafolyamat elé teszel.
Mi a tipizált döntés az LLM routingban?
A tipizált döntés olyan válasz, amelynek a típusát a modell inputja előtt rögzíted: egy opció egy zárt halmazból, egy pozíció egy rendezett skálán, vagy annak valószínűsége, hogy egy állítás igaz. A hívónak soha nem kell szabad szöveget parszolnia, és minden válasz összevethető minden más, ugyanarra a kérdésre adott válasszal.
A Jev, a TypeSafe modellje, amely az OpenRouteren fut, teljes egészében erre az ötletre épül. A dokumentációja „strukturált döntésmodellnek” nevezi, amely „gyors, strukturált döntéseket hoz software-ben”, és egyértelműen kimondja, hogy „nem állít elő gondolatmenet-nyomokat, magyarázatokat vagy szabad szöveget”, és „nem közvetlen helyettesítője egy chat modellnek” (OpenRouter Jev docs). Az OpenRouter magyarázata System One modellnek nevezi – Daniel Kahneman gyors, mintázatfelismerő gondolkodási módja után –, és az early access kiadás dátumát 2026. szeptember 15-re teszi (What is Jev?).
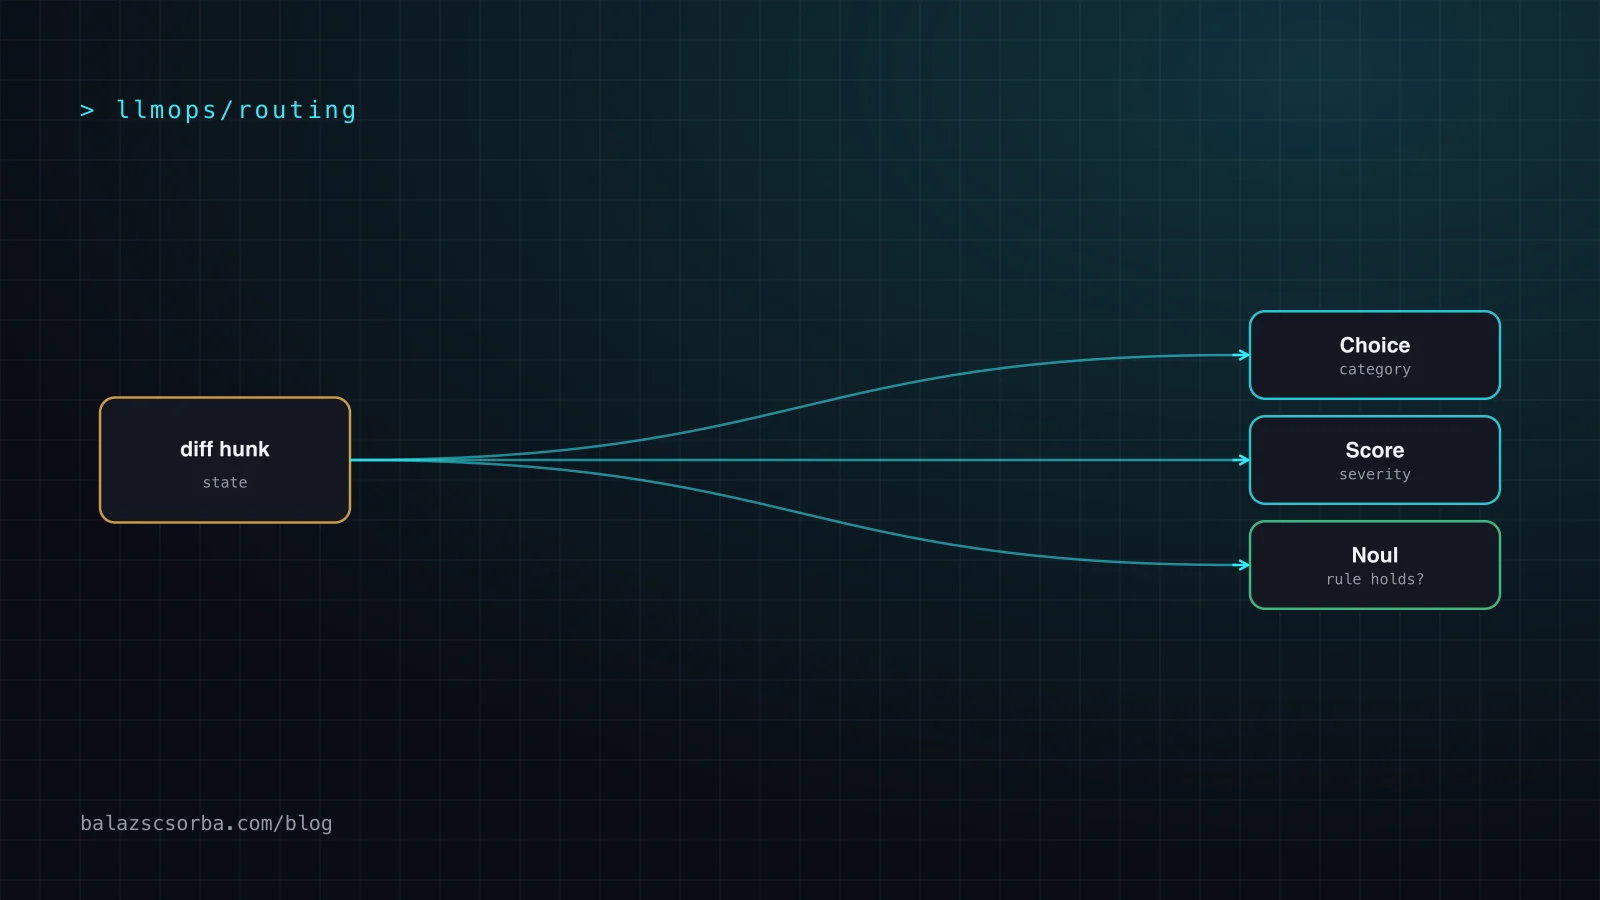
A Jev háromféle kérdésre válaszol, amit a skill fájlom a három primitívnek nevez:
- Choice: egy opció egy rögzített halmazból. Minden opciót leképezel arra, mit jelent, és a válasz minden opcióhoz hordoz egy valószínűséget.
- Score: egy értékelés rendezett szinteken, rossztól jó felé írva. Az OpenRouter magyarázata tíz szintre korlátozza a skálát. A válasz egy valószínűséggel súlyozott pozíció a szintindexek mentén.
- Noul: annak valószínűsége, hogy egy állítás igaz. Nincs külön konfidenciamező, mert a valószínűség maga a válasz.
A fegyelem, amit ez rákényszerít, a hasznos rész. Nem kérdezheted meg, „mit gondolsz erről a változásról?”. El kell döntened, milyen ítéletek lehetségesek, le kell írnod, mit jelent mindegyik, és el kell fogadnod, hogy a modell ezek közül választ, és megmondja, mennyire biztos.
Hogyan működik a Jev decisions API?
A hívó egy JSON kérést küld a state mezővel (az értékelendő dolog) és egy megnevezett questions térképpel; az API egy tipizált answers térképet ad vissza a tokenfelhasználással és a költséggel együtt. A végpont POST https://openrouter.ai/api/alpha/decisions, és ahogy az útvonal mondja, alpha API, tehát számolj a séma megváltozásával.
2026. szeptemberében a modellazonosító typesafe/jev-1.13, 32 000 tokenes kontextussal, az ára $0.042 millió input tokenenként, az outputra $0 (OpenRouter Jev docs). Az OpenRouter magyarázata végigszámol egy háromkérdéses hívást, 447 input tokennel, ami $0.000019-be kerül, körülbelül a cent két ezredrésze. Csak OpenRouter kulcs kell, külön TypeSafe fiók nem. Nincsenek hangolható sampling paraméterek.
Ez egy request minden három primitívvel, a saját skill fájlomból:
{
  "state": "<the thing being judged: a diff hunk, a ticket, a plan>",
  "questions": {
    "layer": {
      "type": "choice",
      "instructions": "Which layer does this defect belong to?",
      "criteria": {
        "domain": "Business rules and entities",
        "application": "Use-case orchestration",
        "infrastructure": "Persistence, HTTP, framework wiring"
      }
    },
    "risk": {
      "type": "score",
      "instructions": "How risky is this change to ship?",
      "criteria": [
        "Cosmetic, no behaviour change",
        "Behavioural but well covered by tests",
        "Behavioural with thin coverage",
        "Touches money, auth, or data integrity"
      ]
    },
    "crosses": {
      "type": "noul",
      "instructions": "This change introduces a cross-module dependency.",
      "criteria": {
        "true": "Reaches into another module's internals",
        "false": "Stays inside its module or goes through a facade"
      }
    }
  }
}
És a visszatérő válasz alakja:
{
  "answers": {
    "layer":   { "type": "choice", "choice": "application", "confidence": 0.75,
                 "probabilities": { "domain": 0.11, "application": 0.84, "infrastructure": 0.05 } },
    "risk":    { "type": "score", "score": 1.99, "confidence": 0.99,
                 "probabilities": { "0": 0, "1": 0.01, "2": 0.99 },
                 "legend": { "0": "...", "1": "...", "2": "..." } },
    "crosses": { "type": "noul", "noul": 0.96 }
  },
  "usage": { "input_tokens": 476, "output_tokens": 70, "cost": 0.00002 }
}
Két részlet fontos, amikor ezt olvasod. Első: a state lehet string, objektum vagy tömb, és a strukturált kontextus objektumként jobban működik, mint ha egy mondatba lapítjuk. Másod: a score a szintindexek mentén interpolál: az 1,99 egy négyszintű skálán éppen a 2. szint alatt van („Behavioural but thin coverage”). Olvasd a legend alapján, sosem százalékként.
Kiszélesítés elemenként, nem kérdésenként
Az egy hívásban szereplő kérdések nem zavarják egymást, és az inputot csak egyszer fizeted ki. Ezért a szabály a skillemben: elemenként egy kiszélesítő hívás. Add át az elemet state-ként, és ugyanabban a kérésben kérdezd meg, ami csak kellhet róla. Ugyanannyiba kerül, mint egyetlen kérdés, csökkenti a késleltetést, és összhangban tartja a válaszokat, mert mindegyik ugyanahhoz az inputhoz számított. A találgatásból hozzáadott kérdések elég olcsók ahhoz, hogy biztonság kedvéért beletejük.
Miért a konfidencia egy második tengely?
A válasz megmondja, mit választott a modell; a konfidencia megmondja, hogy cselekedhetsz-e anélkül, hogy egy ember ránéz. Egy magabiztos rossz válasz és egy bizonytalan jó válasz azonosnak látszik, ha csak az answer mezőt olvasod, tehát az a router, amely eldobja a konfidenciát, a válasz leghasznosabb részét dobja el.
A „kalibrált” itt pontos jelentéssel bír. Az OpenRouter magyarázata szerint, ha a Jev 0,8-at jelent, az ilyen válaszok körülbelül 80%-ában jogos, de „csak akkor, ha sok válaszon át átlagolunk. Egyetlen válasz még mindig lehet hibás”. Ez a kalibrálás szokásos definíciója a gépi tanulásban, ahol a modern neurális hálózatokról tudjuk, hogy túl magabiztosak, ha nem kalibráljuk őket kifejezetten (Guo et al., 2017). Ez azt jelenti, hogy a konfidencia a döntések egy populációjának tulajdonsága, és pontosan így használja egy router.
A skill fájlom működő szabályai rövidek:
- Magas konfidenciánál cselekedj, alacsonynál routingolj. A
confidence < 0.6jellegű alsó küszöb egy döntési szabály, amelyet le lehet írni, át lehet nézni és meg lehet változtatni. Az alatta lévő elemek egy emberi queue-ba mennek, nem a kukába. - A középső tartományban lévő Noul azt jelenti, hogy rossz a kérdés. A 0,3 és 0,7 közötti valószínűség általában azt mondja, hogy az állítás kétértelmű volt. Élesítsd az utasítást, vagy adj
true/falsekritériumokat, ahelyett hogy a számnak hinnél. - A valószínűség nem engedély. A modell rendez és jelöl. Ami emberi felelősség, az marad embernél.
Hogyan válasszuk ki a küszöböt
Az alsó küszöböt ne találgasd, mérd ki. Az OpenRouter saját Jev tutorialja egy kis mintát címkéz a marketplace hirdetésekből, megnézi, hová esnek a helyes és a hibás válaszok, majd olyan küszöböt választ, amelynek mindkét oldalon van tartaléka, „mert az egyedi valószínűségek futások között mozognak”. A saját 24 hirdetéses mintáján 0,8 volt a legalsó küszöb nulla hibás elutasítással (How to use Jev). Ugyanez a módszer működik a te adataidon: néhány tucat kézzel címkézett elem, kérdésenként egy küszöb, és újraellenőrzés, amikor a kérdések változnak. Ez a címkézett halmaz egy kis eval, és ugyanoda való, mint a többi evals LLM termékfunkciókhoz.
Hová illik a tipizált döntés: triázs, kockázatértékelés és routing
A tipizált döntés akkor érdemli ki a helyét, ha ugyanazt az ítéletet sok elemen alkalmazzuk, és az elemek közötti elcsúszás hiba lenne. Ha ugyanazt az utasítást kétszer megírnád, ez már jelölt.
Ezek az alkalmazások a saját ügynökskilleimben, amelyeket a skillek munkafolyamata részletesebben leír:
- A review findingok triázsa. Add át a diff hunkot
state-ként, és egy hívásban kérdezz egy Choice-ot a finding taxonómiára, egy Score-ot a súlyosságra és Noul-okat a repository saját szabályaira (modulhatárok, a response envelope alakja, nyers query használata). Rendezj súlyosság szerint, az alacsony konfidenciájú findingokat külön sorold fel „emberi figyelést igényel” jelöléssel, és soha ne a döntés döntse el, mi megy ki. Ha az ügynökök több pull requestet termelnek, mint amennyit az emberek elolvasni tudnak, ez a rendezés egy válasz a review szűk keresztmetszetére. - Kockázatértékelés egy diffen vagy egy backlogin. Ugyanaz a rendezett skála minden fájlra vagy minden ticketre. A kézzel hozott ítéletek éppen ilyen hosszú, ismétlődő listánál csúsznak el a legjobban.
- Munka routingolása. Egy Choice azokra az utakra, amelyen egy feladat végighaladhat, ahol a konfidencia dönti el, hogy az ügynök továbbmegy-e vagy kérdez.
- Egy terv terheléspróbája. Add át a tervet
state-ként, és kérdezd meg, kell-e új modul, átlép-e modulhatárt, és mekkora. A válaszok azt döntik el, mit kérdezzünk embertől, nem azt, mit építsünk.
A routing lépés maga néhány sor. Ez pszeudokód, nem az a helper, amit használok:
# pseudo-code: sort review findings with one fan-out call each
for finding in findings:
    a = decide(state=finding.hunk, questions=REVIEW_QUESTIONS)
    ambiguous = 0.3 <= a["crosses"]["noul"] <= 0.7
    if a["category"]["confidence"] < FLOOR or ambiguous:
        needs_human.append(finding)
    else:
        sorted_findings.append((a["severity"]["score"], finding))
sorted_findings.sort(reverse=True)
Ugyanez az alak modell routerként is működik: az egyszerű kéréseket kis modellhez, a nehézeket nagy modellhez vagy emberhez küldjük. Ez a felhasználás a caching és a batchelés mellett ott van, ahol az LLM költségét és késleltetését csökkentjük.
Döntésmodell vagy strukturált kimenetet adó általános LLM?
Egy általános LLM szigorú kimeneti sémával szintén adhat tipizált választ, és meg is tudja magát magyarázni. Egy dedikált döntésmodell tipizált választ ad valószínűségekkel, hívásonként sokkal olcsóbban, és semmit sem tud megmagyarázni. Melyik a jobb, attól függ, kell-e a magyarázat vagy a szám.
Az általános modell strukturált kimenete kiforrott. A Claude API az output_config.format mezőn keresztül JSON sémát kényszerít ki (Claude structured outputs), az AI SDK pedig Output.choice segédet ad enum választáshoz (AI SDK structured data). Amit ezek adnak, az egy jól formált válasz. Amit nem adnak alapból, az egy kalibrált valószínűség: a modell által a saját JSON-jébe írt konfidenciaszám generált szöveg, és addig kalibrálatlannak tekinteném, amíg nem mértem össze címkékkel.
| Szempont | Döntésmodell (Jev) | Általános LLM + strukturált kimenet |
|---|---|---|
| Kimenet | Csak Choice, Score vagy Noul | Bármilyen JSON séma, kívánt esetén prózával |
| Magyarázat | Nincs, szándékosan | Elérhető, hasznos az auditnyomhoz |
| Konfidencia | Valószínűség opcióként és egy konfidenciamező | Nem natív; az önbevallott számokat validálni kell |
| Ár (2026. szept.) | $0.042/M input, $0 output | Az input és az output is számlázandó |
| Kontextus | 32 000 token | A jelenlegi nagy modelleknél körülbelül 1M tokenig |
| Hangolási gombok | Nincsenek sampling paraméterek | Temperature, promptok, példák |
| API érettsége | Alpha végpont | Általánosan elérhető |
| Legjobban erre | Sok ismétlődő ítélet küszöbbel | Kevés hívás, amelynek okra vagy szabad szöveges mezőre van szüksége |
A kettő jól kombinálható. Hadd a döntésmodell rendezzen ezer elemet, majd kérj egy általános modelltől, hogy magyarázza el azt a húszat, amelyben nem volt biztos, vagy add át azokat a húszat egy embernek.
Mikor ne használj döntésmodellt
Ne használj tipizált döntésmodellt semmi olyasmire, aminek szövegre van szüksége, egyedi hívásokra, amelyekre a kontextus már válaszol, vagy olyan döntésekre, amelyekért egy ember felel. Az őszta korlátai a tervezés részei.
- Nincs próza, nincs kód, nincs ok. Fizikailag nem tudja őket előállítani. Ha a kimenetet olyan valaki olvassa, aki rákérdez, „miért?”, akkor másik komponens kell.
- Egyedi ítéletek. Egy hálózati körút nem javítás ahhoz képest, hogy elolvasod a fájlt magad előtt. Az érték a térfogattal és az ismétlődéssel jön.
- Csak azt a state-et látja, amit átadsz. Nincs repository hozzáférés, nincs memória a hívások között, nincs lehetőség utánanézni valaminek. Egy homályos state magabiztos választ ad a rossz kérdésre, és a válaszban semmi nem mondja el.
- A számok így is hitelesnek látszanak. A szemétként érkező bemenet különösen veszélyes, ha a kimenet numerikus, mert a 0,93 megbízhatónak olvasa, függetlenül attól, hogy volt-e értelme a bemenetnek.
- Alpha API. Az útvonalban alpha szerepel. Tedd a saját interfész mögé, hogy egy séma-változás csak egy fájlt érintsen, és tarts fenntartási utat (egy emberi queue is jó), ha kiesik.
- Architektúra- és designértések. A modell arra használd, hogy eldöntsd, mit kérdezz a tulajdonostól, aztán kérdezz.
Gyakorlati ellenőrzőlista a tipizált LLM routinghoz
- Előbb a zárt halmaz. Opciók, mindegyikhez egy soros jelentés, vagy rendezett szintek rossztól jóig.
- Adj át strukturált state-et. Egy megnevezett mezőket tartalmazó objektumot, nem egy összefoglaló bekezdést.
- Egy kiszélesítő hívás elemenként. Ugyanabban a kérésben kérdezd meg, ami csak kellhet.
- Címkézz néhány tucat elemet, és minden küszöböt úgy válassz, hogy mindkét oldalon legyen tartaléka.
- Routingolj, ne dobd el. Az alacsony konfidencia és a középső tartományban lévő Noul-ok az elemmel együtt emberi queue-ba mennek.
- Írd át a kétértelmű kérdéseket, ahelyett hogy egy 0,5-nek hinnél.
- Naplózd minden döntést a konfidenciájával, és spot-checkeld az automatikusan alkalmazottakat.
- Tedd a alpha API-t egy funkció mögé, fenntartási úttal.
- A felelősség maradjon embernél. Egy valószínűség nem engedély.
Ha triázst vagy routingot építesz egy ügynök munkafolyamatába, és szeretnél egy második szempárral ránézni, nézd meg az AI engineering & MCP szerverek oldalt.
Források
- OpenRouter: Jev dokumentáció (decisions API, modellazonosító, kontextus, árak, limitek)
- OpenRouter: What is Jev? TypeSafe's decision model explained (kalibrálás, primitívek, kiadás)
- OpenRouter: How to use Jev (request és response példa, a küszöbök megválasztása)
- Guo, Pleiss, Sun és Weinberger: On Calibration of Modern Neural Networks (2017)
- Claude API: Structured outputs
- AI SDK: Generating structured data
Gyakori kérdések
Mit jelent a kalibrált konfidencia egy LLM osztályozónál?
Egy osztályozó akkor kalibrált, ha a megadott valószínűségek összhangban vannak azzal, hogy milyen gyakran igazad van: a 0,8 konfidenciával adott válaszok körülbelül 80%-a helyes. A tulajdonság sok válaszon át érvényes átlagosan, tehát egyetlen válasz továbbra is lehet hibás. Ezért használ egy router a konfidenciát annak eldöntésére, mely elemeket nézze át egy ember.
Használhatok helyette egy normál chat modellt JSON kimenettel osztályozóként?
Igen. Az általános modell strukturált kimenete jól formált tipizált választ ad, és tartalmazhat indoklást is, ami auditoknál hasznos. Amit viszont alapból nem ad, az egy kalibrált valószínűség; a modell által a saját JSON-jébe írt konfidenciaszám generált szöveg, és ellenőrizni kell címkézett adatokkal, mielőtt rá alapozol egy döntést.
Hogyan válasszak konfidencia-küszöböt az emberhez routingoláshoz?
Címkézz kézzel néhány tucat valódi elemet, futtasd át őket az osztályozón, és nézd meg, hová esnek a helyes és a hibás válaszok. Válassz olyan küszöböt, amelynek mindkét oldalon van tartaléka, mert az egyedi valószínűségek futások között mozognak, és ellenőrizd újra, valahányszor a kérdések vagy a bemeneti formátum megváltozik.
Élesben használható-e az OpenRouter decisions API?
2026. szeptemberében a végpont a /api/alpha/decisions útvonalon van, és az OpenRouter alpha API-ként írja le, tehát a request vagy response sémája megváltozhat. Tedd egy funkció mögé a kódodban, naplózd minden hívást, és tarts fenntartási utat, például egy emberi review sort, ha kiesik vagy megváltozik.