Blog/LLMOps és értékelés
LLM evals termékfunkciókhoz: a valódi trace-ektől a CI kapuig
Az LLM evals teszthalmazzá alakítja a benyomást: hibaelemzés valódi trace-eken, grader választás, validált LLM-as-judge, pass^k és CI kapu.
Balázs Csorba··8 perc olvasás
- LLM evals
- LLM-as-judge
- Error analysis
- CI
A lényeg röviden
- Az LLM evals tesztek a modell viselkedésére: rögzített inputhalmaz, egy grader minden kimenetre, és egy score, amit minden prompt-, modell- és kódváltozáson összehasonlítasz.
- Kezdd a hibaelemzéssel körülbelül 100 valódi trace-en, csoportosítsd a jegyzeteket megszámolt hibaforma-taxonómiába, és csak utána válassz metrikát vagy írj judge-ot.
- A legolcsóbb gradert használd, amely megbízhatóan elkapja a hibát: kódot mindent, ami szabállyal ellenőrizhető, LLM-as-judge-ot a mérlegelési kérdésekre, embert a judge kalibrálására.
- Adj minden judge-nak egy hibaformát és egy bináris minősítést, majd validáld 100–200 emberi címkés példán, mielőtt bármit is rá gate-elsz.
- A pass@k azt kérdezi, hogy k kísérletből legalább egy sikerül-e, a pass^k azt, hogy mindegyik; a mindig működő funkciókat pass^k-kal mérd.
Az LLM evals automatizált tesztek azokhoz a funkciókhoz, amelyek nyelvi modelleken épülnek: egy rögzített inputhalmaz, egy grader, amely minden kimenetre pass vagy fail felett dönt, és egy score, amit minden prompt-, modell- és kódváltozáson végigkövetsz. Leváltják azt a „ez jól néz ki” ellenőrzést, amely az első demónál működik, és onnantól nem, hogy egy funkciónak vannak valódi felhasználói és egy második fejlesztője.
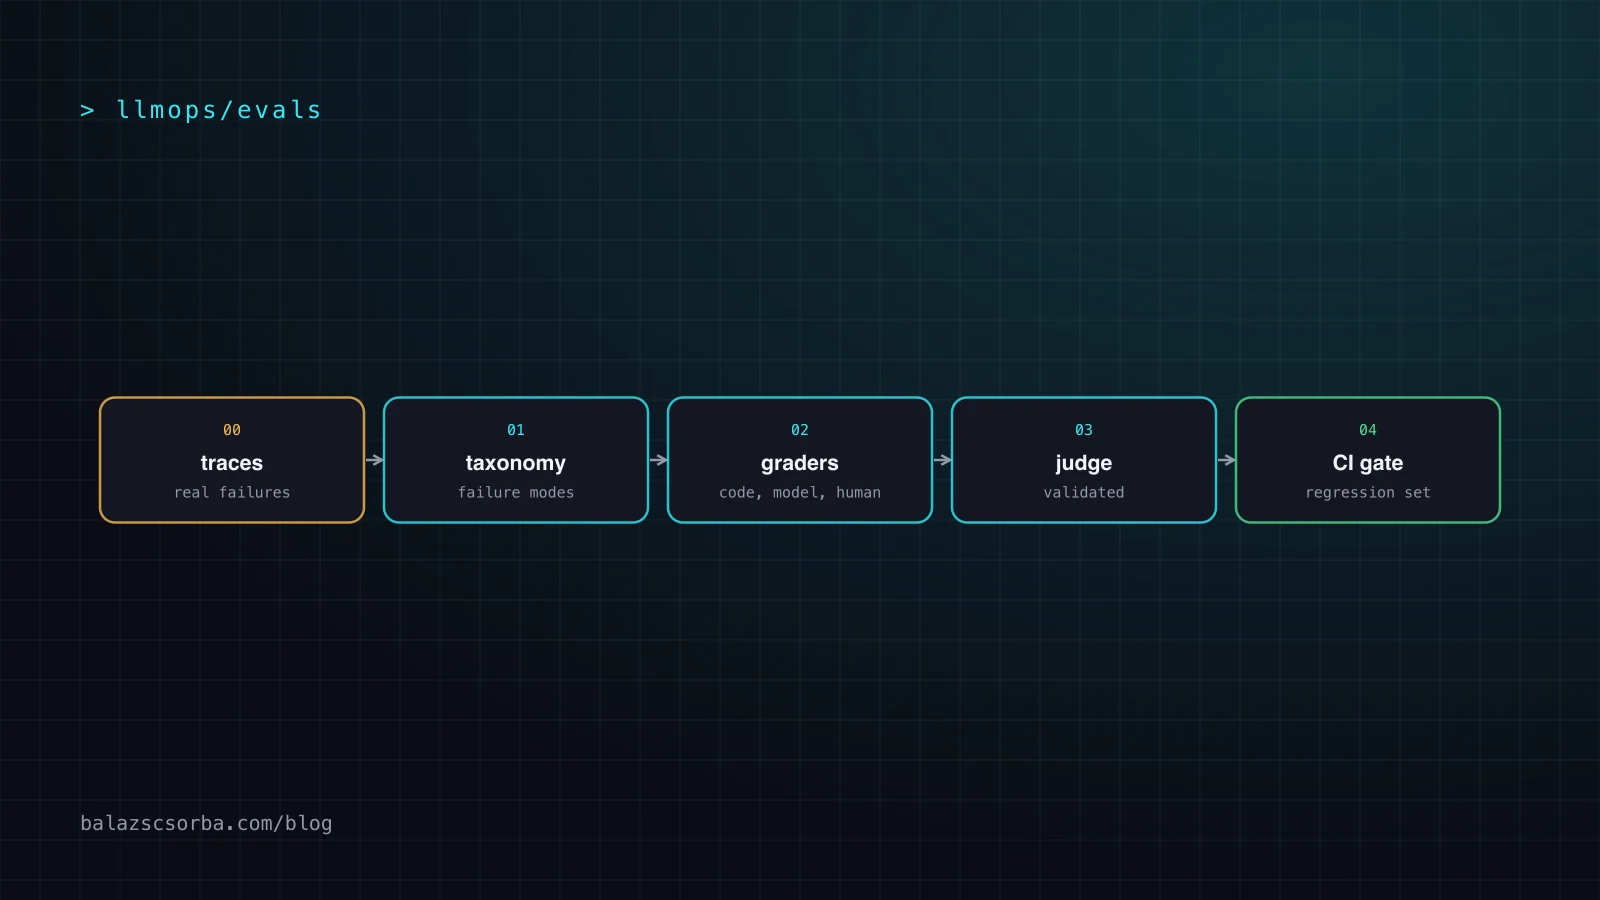
Ez a cikk egy olyan utat mutat, amely a gyakorlatban is állja a helyét: olvasd el kézzel a valódi trace-eket, alakítsd át, amit találtál, hibaformák taxonómiájává, válassz minden hibáhozhoz a legolcsóbb gradert, amely ki tudja mutatni, validáld az LLM-as-judge-okat emberi címkékkel, mérd a megbízhatóságot pass^k-kal és pass@k-kal is, majd futtasd az eredményt regressziós teszthalmazként a CI-ban.
Miért kell az LLM funkcióknak az evals?
Mert a modell kimenetei futásról futásra változnak, és minden apró prompt-átírás egy esetet megjavíthat, miközben három másikat tönkretesz, amelyekre nem néztél. Rögzített teszthalmaz nélkül ezt csak a felhasználóktól tudod meg.
A unit tesztek feltételezik, hogy egy függvény ugyanarra a bemenetre ugyanazt a kimenetet adja. Egy LLM funkció nem adja, és a hibái ritkán összeomlások: egy összefoglaló, amely kihagyja az egyetlen fontos mondatot, egy support válasz, amely kitalál egy visszatérési szabályt, egy osztályozó, amely egy modellfrissítés után elcsúszik. Az evals ezeket összehasonlítható számokká alakítják. Az Anthropic „Demystifying evals for AI agents” cikke (2026. január) szándékosan kicsinek mondja a kezdést: „20–50 egyszerű feladat valódi hibákból remek kiindulópont”. Nem benchmark kell, hanem azok az esetek, amelyek már elmentek mellé.
Hogyan kezdjük? Hibaelemzés valódi trace-eken
Kezdd azzal, hogy trace-eket olvasol, nem azzal, hogy metrikákat választasz. Nézz meg körülbelül 100 valódi interakciót, írj minden problémáról egy szabad szöveges jegyzetet, majd csoportosítsd a jegyzeteket egy kis hibaforma-taxonómiába, és számold meg őket.
Hamel Husain evals FAQ-ja (2026. szeptemberben frissítve) a kutatásmódszertani szavakkal írja le a módszert. Nyílt kódolás: a címkékírók szabad szöveges jegyzeteket írnak arról, mi ment rosszul az egyes trace-ekben. Axiális kódolás: a jegyzeteket hibaforma-taxonómiába csoportosítjuk és megszámoljuk. Körülbelül 100 változatos trace-tel javasol kezdeni, és azt írja: „mielőtt az ügynököt hibajavaslatokra kéred, nézz át legalább 30 trace-et magad”, a fejlesztési időre pedig „60–80%-ot hibaelemzésre és értékelésre” számít. A számok számítanak: megmutatják, melyik hiba érdemel először gradert.
Két szervezeti pont ugyanebből a FAQ-ból. Nevezz ki egy „jószándékú diktátort”, egy doménszakértőt, aki végül dönt arról, mi számít jónak, hogy a címkék konzisztensek maradjanak. És számíts rá, hogy a kritériumaid elmozdulnak: ezt nevezi Shankar et al. criteria driftnek, azt a megfigyelést, hogy „a felhasználóknak kritérium kell a kimenetek értékeléséhez, de a kimenetek értékelése segít a felhasználóknak kritériumot definiálni”. Olvasd el újra a trace-eket, miután létrejött a taxonómia; meg fog változni.
Milyen gradert használjunk: kód, modell vagy ember?
A legolcsóbb gradert használd, amely megbízhatóan kimutatja a hibát: kódot mindent, ami szabállyal ellenőrizhető, LLM-as-judge-ot a mérlegelési kérdésekre, embert pedig a judge kalibrálására és arra, amit az automatikus graderek nem tudnak eldönteni.
| Grader | Erős benne | Gyenge benne | Mire használd |
|---|---|---|---|
| Kód (assertionök, sémák, regex, SQL) | Gyors, olcsó, objektív, reprodukálható, könnyen debuggolható | Törékeny az érvényes változatokkal szemben; nincs árnyalat | Formátum, kötelező mezők, tiltott stringek, eszközhívás argumentumai, pontos válaszok |
| LLM-as-judge | Rugalmas, skálázható, kezeli az árnyalatokat | Nem determinisztikus, drágább a kódnál, kalibrálni kell | Hangnem, hűség a forráshoz, hogy egy szabályzatot követtek-e |
| Ember | Gold standard minőség, egyezik a szakértői ítélettel | Drága és lassú | A judge tanítóadatainak címkézése, szúrópróbák, vitás esetek |
A táblázat erősségei és gyengeségei azok, amelyeket az Anthropic felsorol az evals cikkében. Egy további szabály ugyanonnan egy egész osztálynyi flaky tesztet megelőz: azt értékeld, „amit az ügynök előállított, nem az utat, amelyen haladt”. Az az ügynök, amely más sorrendű eszközhívásokkal ugyanoda jut, átmenjen. Ha a kimenet egy fix választás (egy kategória, egy prioritás, egy útvonal), teljesen elhagyhatod a szabad szöveget, és pontos egyezést értékelhetsz; ezt a mintát írja le a típusos döntések próza helyett cikk.
Hogyan építsünk megbízható LLM-as-judge-ot?
Adj minden judge-nak egyetlen hibaformát és egy bináris pass/fail minősítést, majd mérd a true positive rate és a true negative rate értékét az emberi címkékhez képest, mielőtt bízol a számaira.
A bináris minősítések Husain szavával „tisztább gondolkodást és következetesebb címkézést kényszerítenek ki”, mint az 1–5 skálák, ahol a szomszédos pontok különböző emberek számára különböző dolgot jelentenek. Egy judge hibaformánként tartja röviden a promptot és debuggolhatóvá a minősítést:
You are grading one failure mode: UNSUPPORTED_POLICY_CLAIM.

FAIL if the answer states a refund, shipping or warranty rule
that does not appear in the provided policy excerpts.
PASS otherwise, including when the answer says the policy
does not cover the question.

Policy excerpts:
{excerpts}

Answer:
{answer}

Reply with JSON: {"reason": "one sentence", "verdict": "PASS" | "FAIL"}
Ezután validáld. Husain azt javasolja, hogy hibaformánként 100–200 példát címkélj, és oszd szét őket: 10–20% few-shot példaként a judge promptban, 40–45% fejlesztési halmazként a prompt finomítására, 40–45% visszatartott teszthalmazként. Mérd a true positive rate értékét (az emberek által hibának jelölt kimenetek közül hányat jelölt hibának a judge is) és a true negative rate értékét (az átmenő esetek közül hányat engedett át a judge is). A nyers egyezés elrejti azt a judge-ot, amely akkor is mindent átenged, ha a hibák ritkák.
Az ismert torzításokat érdemes tesztelni. Az MT-Bench tanulmány (Zheng et al., 2023) azt találta, hogy az erős LLM judge-ok „80% feletti egyezést” érnek el az emberi preferenciákkal, de dokumentálta a pozíciós, a terjedelmességi és az önmagát előnyben részesítő torzítást is. Ha a judge két kimenetet hasonlít össze, cseréld fel a sorrendjüket, és nézd meg, hogy a minősítés tartja-e a helyét.
Mi a különbség a pass@k és a pass^k között?
A pass@k annak a valószínűsége, hogy k kísérletből legalább egy sikerül; a pass^k annak a valószínűsége, hogy mindegyik sikerül. A pass@k olyan eszközökhöz illik, ahol a felhasználó újrapróbálhat vagy kiválaszthatja a legjobb választ; a pass^k olyan funkciókhoz, amelyeknek mindig működniük kell.
Az Anthropic a pass@k-t úgy definiálja, mint „annak a valószínűségét, hogy egy ügynök k kísérletből legalább egy helyes megoldást kap”, a pass^k-t pedig mint „annak a valószínűségét, hogy mind a k próbálkozás sikerül”. A pass^k-t a τ-bench (Yao et al., 2024) vezette be, amely azt találta, hogy még az erős function calling ügynökök is inkonzisztensek voltak: a gpt-4o a feladatok kevesebb mint felénél sikerült, a pass^8 pedig a retail területen 25% alatt maradt. A két metrika gyorsan szétválik. Például, ha a próbálkozások függetlenek, és mindegyik 90%-ban sikeres: a pass@5 = 1 − 0.1⁵ ≈ 99.999%, a pass^5 = 0.9⁵ ≈ 59%. Az a support bot, amely tízből kilencszer ad helyes választ ugyanarra a kérdésre, egy látványos hányad felhasználónál téved. Futtasd le minden eval esetet többször, és mindkét számot írd le.
Hogyan futtassuk az evals-t a CI-ban?
Oszd szét a suite-ot egy regressziós teszthalmazra, amelynek közel 100%-on kell maradnia, és egy képességi teszthalmazra, amelynek szabad elbuknia; a regressziós teszthalmazt futtasd minden változásnál, és erre gate-eld a merge-eket.
- A regressziós tesztek tartják azokat az eseteket, amelyek már működnek. Az Anthropic útmutatása szerint „közel 100%-os pass rate”-et kell érniük; a zuhanás bug.
- A képességi tesztek tartják azokat az eseteket, amelyeket működővé akarsz tenni. „Alacsony pass rate-tel kell indulniuk”, majd átkerülnek a regressziós teszthalmazba, ha megbízhatóan átmennek.
- Minden élesbeli hiba egy eset lesz. A trace a várt viselkedésével kerül a halmazba, még a javítás megírása előtt, ugyanolyan szellemben, mint egy regressziós teszt, amelynek el kell buknia, ha a javítást visszavonjuk; ezt a harness engineering kódoló ügynökökhöz cikk írja le.
- Ami nincs teszt alatt, azt pineld be: modellazonosító, hőmérséklet, ahol az API engedi, a judge prompt verziója, és az ügynökös evalsnál a végrehajtási környezet.
Ez az utolsó pont nem pedanteria. Az Anthropic Quantifying infrastructure noise in agentic coding evals cikke (2026. február) azt találta, hogy a Terminal-Bench 2.0-en a legjobban és a legrosszabbul felszerelt konfiguráció között 6 százalékpont volt a különbség, ugyanazzal a modellel és ugyanazzal a harnessszel. Ha a CI-futtatóid mérete megváltozik, az ügynököd pass rate-e elmozdulhat úgy, hogy egyetlen kódsor sem változott. Azonos infrastruktúrán hasonlíts össze futásokat, és a kis különbségekkel gyanakodva járj el.
Mikor vezetnek félre az evals-t
Az evals akkor vezetnek félre, ha a metrika generikus, a judge nincs validálva, a teszthalmaz elavult, vagy a zaj nagyobb, mint az a különbség, amit olvasol.
- Generikus metrikák. A kész „segítőkészség” vagy „koherencia” score ritkán illeszkedik a hibaformáidhoz. Husain: „A generikus értékelések időt pazarolnak és hamis biztonságot adnak, ha minőségi mérőszámként használod őket.”
- Egy validálatlan judge. Egy judge, amely önmagával egyezik, nem mond semmit. TPR és TNR nélkül, visszatartott címkékén, a score a judge véleménye.
- Telítettség. Egy 100%-on álló képességi teszthalmaz már nem mér haladást. Vidd át az eseteit a regresszióba, és írj nehezebbeket új trace-ekből.
- Túl kevés próbálkozás. Néhány dozen esettel és egy futással egy-két pontnyi kilengés zaj is lehet. Ismételd a futásokat, és nézd meg az egyes eseteket, amelyek átbillentek.
- Az átiratok kihagyása. Az Anthropic tanácsa nyers: „Nem tudod, hogy a gradereid jól dolgoznak-e, ha nem olvassad el az átiratokat.”
LLM evals ellenőrzőlista
- Olasz meg körülbelül 100 valódi trace-et, ezekből legalább 30-at magad, és írj minden problémáról szabad szöveges jegyzetet.
- Csoportosítsd a jegyzeteket hibaformákba és számold meg őket; először a leggyakoribbakra építs gradereket.
- Nevezz ki egy minőségfelelőst, aki végül dönt a címkékről.
- Ahol egy szabály elég, ott használj kód gradert, a mérlegelési kérdésekre tartsd az LLM-as-judge-ot.
- Hibaformánként egy bináris judge, TPR-vel és TNR-vel validálva egy visszatartott, címkézett halmazon.
- Futtasd le minden esetet többször, és írj pass^k-t azokra a funkciókra, amelyeknek mindig működniük kell.
- Tartsd a regressziós teszthalmazot közel 100%-on, és erre gate-eld a merge-eket; a képességi teszthalmaz hadd bukjon.
- Vidd minden élesbeli hibát esetté, még a javítás megírása előtt.
- Pineld be a modellt, a promptokat és az infrastruktúrát, hogy egy score-változás viselkedésváltozást jelentsen.
Ha egy LLM funkcióhoz adsz evals-t, és segítséget szeretnél az első suite felépítéséhez, nézd meg az AI engineering oldalt.
Források
- Anthropic: Demystifying evals for AI agents (2026)
- Hamel Husain: LLM evals FAQ (2026. szeptemberben frissítve)
- Shankar et al., Who Validates the Validators? (2024)
- Zheng et al., Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena (2023)
- Yao et al., τ-bench: A Benchmark for Tool-Agent-User Interaction (2024)
- Anthropic: Quantifying infrastructure noise in agentic coding evals (2026)
Gyakori kérdések
Hogyan kezdjem az LLM evals megírását?
Először olvasz el körülbelül 100 valódi trace-et, és írj minden problémáról egy szabad szöveges jegyzetet, majd csoportosítsd a jegyzeteket egy kis hibaforma-taxonómiába, és számold meg őket. Az Anthropic evals cikke ugyanezt másik oldalról fogalmazza meg: 20–50 egyszerű feladat valódi hibákból remek kiindulópont. A metrikák, amelyeket a hibaformák ismerete előtt választasz, általában a rosszat mérik.
Mi az LLM-as-judge, és hogyan bízhatok benne?
Az LLM-as-judge egy modellhívás, amely egy másik modell kimenetét értékel egy rubrika alapján. Adj minden judge-nak egyetlen hibaformát és egy bináris pass/fail minősítést, majd validáld: címkélj hibaformánként 100–200 példát, tartsd vissza belőlük néhányat few-shot halmazként, és mérd a true positive rate és a true negative rate értékét a saját címkéidhez képest, mielőtt egy merge-et rá gate-elnél.
Mi a különbség a pass@k és a pass^k között?
A pass@k annak a valószínűsége, hogy k kísérletből legalább egy sikerül, és olyan eszközökhöz illik, ahol a felhasználó újrapróbálhat vagy választhat. A pass^k annak a valószínűsége, hogy mind a k kísérlet sikerül, és olyan funkciókhoz illik, amelyeknek mindig működniük kell. A tau-bench papír vezette be a pass^k-t, miután megállapította, hogy az erős function calling ügynökök az ismételt futások során inkonzisztensek voltak.
Érdemes-e LLM evals-okat futtatni a CI-ban?
Igen, de oszd szét őket. Tartsd közel 100%-on a már megértett hibákból épített regressziós teszthalmazt, mert az ottani zuhanás valódi regresszió, és tartsd mellette a külön képességi teszthalmazt, amelynek szabad elbuknia. Számolj a zajjal is: az Anthropic a Terminal-Bench 2.0-en 6 százalékpontos különbséget mért a legjobban és a legrosszabbul felszerelt futtatókon, ugyanazzal a modellel és harnessszel.
Mikor vezetnek félre az LLM evals-ok?
Amikor a metrika generikus, a judge-ot soha nem validálták emberi címkékhez képest, a feladathalmaz elavult, vagy a futások közötti zaj nagyobb, mint a különbség, amit olvasol. Két százalékpont egy flaky futtatón nem jel. Előbb javítsd a mérést, és csak utána cselekedj a szám alapján, és azt értékeld, amit az ügynök előállított, nem az utat, amelyen haladt.