Blog/LLMOps és értékelés
Prompt caching és modell-routing: LLM költség és késleltetés csökkentése
A prompt caching, a kisebb modellre routing és a batch API-k csökkentik az éles LLM költségét és késleltetését. Így használd mindegyiket.
Balázs Csorba··9 perc olvasás
- Prompt caching
- Model routing
- LLM cost
- Latency
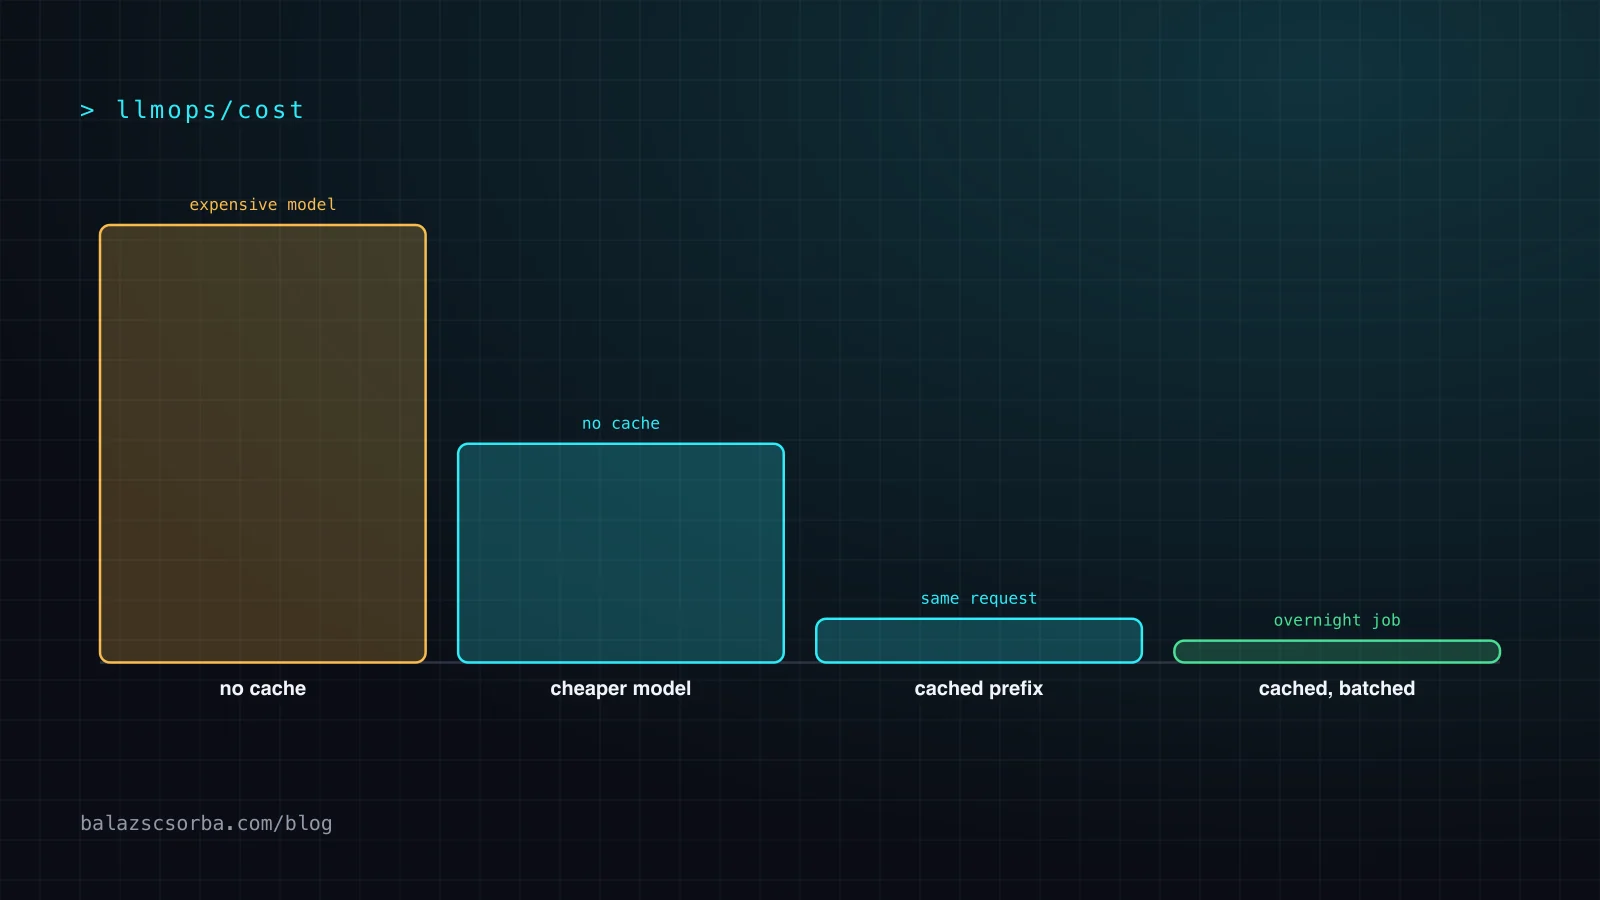
A lényeg röviden
- A prompt caching prefix caching: a szolgáltató pontos bájtsorozatot ment el, és az azt azonosan kezdő későbbi kéréseket az input ár 0,1-szereséért szolgálja ki, Opus 5.5-en 0,05-szereséért.
- A sorrend legyen eszközök, system prompt, előzmény, kérés. Bármi, ami az előzmény fölött változik, kitolja az egész beszélgetést a cache-ből.
- Az írás felárazott: az ötperces cache az input ár 1,25-szerese, az egyórás cache a 2-szerese, legfeljebb négy breakpointtal.
- A modellválasztás a második emelő: 2026. szeptemberben az Opus 5.5 millió tokenenként $4 és $20, a Sonnet 5 $2 és $10.
- A batch API-k körülbelül a feléért számláznak, ezért megérik minden olyan munkánál, amely nem a felhasználóra vár, és minden költségváltozást újra ellenőrizni kell az eval suite-tel.
A prompt caching egy élesben futó LLM funkció legnagyobb egyetlen költségemelője, és nagyrészt elpazarlják azok az alkalmazások, amelyek minden kérésnél ugyanazt a nagy prefixet küldik el. A routing, a batchelés és a funkciónkénti költségmérleg kitölti a képet. Ez a cikk elmagyarázza a mechanizmust, a 2026. szeptemberi számokat, amelyeket ellenőrizni kell, és a sorrendet, amelyben alkalmazni kell őket.
A rövid változat: a promptodat megelőző hosszú, stabil prefix töredékáron fut számlázva; a többi költséget az dönti el, melyik modell fut, és hányszor naponta. Tedd stabilná a prefixet, válts kisebb modellre, mérd az eredményt funkciónként, és a legtöbb költségproblémája érdektelenné válik.
Hová megy valójában a pénz?
Majd minden olyan alkalmazásban, amelyet én árszámoltam, az input tokenek dominálnak, és az input tokeneken belül a system prompt, az eszközdefiníciók és a beszélgetés előzménye minden hívásban megismétlődik. Egy support asszisztens, amelynek 12 000 token utasításai és eszközei vannak, és amelyet naponta 2 000 kérdéssel szólítanak meg, naponta 24 millió azonos tokent küld. Ebben a számban nincs munka.
A második költséghajtó a modellválasztás, és nagyobb emelő, mint az emberek általában várják. 2026. szeptemberben a közzétett árak millió input és output tokenenként: Claude Opus 5.5 $4 és $20, Claude Fable 5.1 $10 és $50, Claude Sonnet 5 $2 és $10, Claude Haiku 4.5 $1 és $5, 200K kontextusablakkal. Az a funkció, amely Opus 5.5-ön fut, és a Sonnet 5-ön is átmegy az evals-ain, éppen a felére csökkentette az input- és az outputköltségét, promptváltoztatás nélkül.
Hogyan működik a prompt caching
A prompt caching prefix caching. A szolgáltató elmenti a prompt prefixed pontos bájtsorozatát, és ha egy későbbi kérés ugyanezzel a sorozattal kezdődik, a tárolóból szolgálja ki azt a részt ahelyett, hogy újrafeldolgozná. A prefixnek identikusnak kell lennie, és kiderül, hogy ez az egész mérnöki feladat: az élesben előforduló legtöbb „cache-lemma” olyan kérés, amely egy időbélyegben, egy user ID-ben, egy véletlen seedben vagy egy átrendezett eszközlistában tér el.
A Claude prompt caching dokumentációja legfeljebb négy cache breakpointot, egy visszatekintést az utolsó 20 blokkra és legalább 512 tokent ír elő az 5.x modelleken. Az írás felárazva számlázódik: az ötperces cache az input ár 1,25-szerese, az egyórás cache a 2-szerese. Az olvasás az input ár 0,1-szereséért jön vissza, Opus 5.5-en 0,05-szereséért. Így egy gecachelt prefix Sonnet 5-ön $0.20 millió tokenenként kerül $2 helyett.
Két invalidálási szabály okozza a legtöbb fájdalmat. Egyetlen karakter módosítása a prefix közepén érvénytelenít mindent, ami utána következik, tehát a prefixek a gyakorlatban csak bővíthetők. Az eszközdefiníciók megváltoztatása pedig az egész cache-t érvényteleníti, ezért egy éjszakai eszközséma-változás megduplázhatja egy funkció költségét, észrevétlenül, amíg valaki észre nem veszi.
A sorrendre érvényes szabály, ami ebből következik, az, amit meg kell jegyezni: eszközök, aztán system prompt, aztán előzmény, aztán a kérés. Ha egy kérésenkénti értéket, például az aktuális időbélyeget az előzmény fölé teszel, minden hívásban kitolod az egész beszélgetést a cache-ből.
A TTL megválasztása: öt perc vagy egy óra
Az ötperces cache-et az input ár 1,25-szereséért írjuk, az egyóraseket a 2-szereséért, majd 0,1-szereséért olvassuk (Opus 5.5-en 0,05-szereséért). A számolás dönt. Ha a prefixedet az ablakon belül többször öt alkalommal olvassák újra, az ötperces cache nyer, mert az írási felárat az ötödik olvasás visszahívja. Egy interaktív funkciónál, amelyre egy dokumentumra érkező kérdéssorozat jellemző, ez a szokásos eset.
Az egyórás cache másféle terheléshez való: stabil, de ritkán használt prefix, például nagy dokumentáció egy olyan funkció mögött, amelynek naponta néhány felhasználója van, vagy egy éjszakai batch job. Egyszer megfizetni a 2-szerest, hogy ne dolgozz fel újra 512 tokent óránként, megéri; azért fizetni, ha egy tokenstreamet tíz másodpercenként olvasnak újra, nem.
Az OpenAI prompt caching útmutatója ugyanannak az érmének a másik oldala: ott 1 024 tokentől automatikusan cache-elnek, az olvasások GPT-5.6-tól 0,1-szereséért számlázódnak, és a gecachelt tartalom 30 percig megmarad. Nem kapsz breakpointokat, szóval ott a sorrend az egyetlen, amit befolyásolni tudsz, és a 30 perces ablak eleve kizárja a hosszú életű cache-eket.
| Cache opció | Írás ára | Olvasás ára | Mire a legjobb |
|---|---|---|---|
| Claude 5 perces cache | az input ár 1,25-szerese | 0,1-szerese, Opus 5.5-en 0,05-szerese | Interaktív funkciók, egy prefixre érkező kérdéssorozatok |
| Claude 1 órás cache | az input ár 2-szerese | 0,1-szerese, Opus 5.5-en 0,05-szerese | Nagy, stabil prefixek, amelyeket ritkán használnak, vagy éjszakai jobok |
| OpenAI automatikus cache | Nincs felár, automatikusan 1 024 tokentől | 0,1-szeres GPT-5.6-tól, 30 perces megőrzés | OpenAI sessionök, ahol a prompt sorrendje az egyetlen, amit befolyásolhatsz |
| Nincs caching | Nem alkalmazható | Teljes input ár | A minimum hossz alatti prefixek, vagy teljesen dinamikus promptok |
Routing a legkisebb működő modellre
A második emelő az, hogy nem fizetsz minden kérésért a legnagyobb modellért. A minta ez: futtasd a legolcsóbb modellt, amely el tudja végezni a munkát, és csak akkor eszkalálj, ha nem elég biztos. Ehhez kell egy konfidenciajel, és mindenre, ami nem egyszerű osztályozás, könnyebb ezt egy külön, kicsi, típusos döntést hozó modelltől kérni, mint a prózából árnyékoló fordulatokat keresni. Ez az a megközelítés, amelyet élesben használok, és amelyet a típusos döntések routinghoz és triázshoz cikkben írok le: egy kicsi, kalibrált modell válaszolja meg, hogy elég jó-e az olcsó út, és a drága modell akkor fut, ha nem.
A szabályok, amelyek miatt a routing működik, nem látványosak. Definiáld az eszkalálási feltételt, mielőtt bármit mérsz, hogy utólag ne tudd racionalizálni a küszöböt. Naplózd az eszkalálások arányát: a növekvő szám azt jelenti, hogy az olcsó modell vagy a prompt megváltozott, nem azt, hogy nehezebb lett a forgalom. És tartsd azonosnak a válaszkontraktust minden modell között, különben egy downgrade viselkedésváltozássá válik, amit a felhasználók észrevétnek.
A várható munka batchelése
A harmadik emelő mindenre vonatkozik, ami nem a felhasználóhoz szól. A batch API-k sok kérést fogadnak el, hosszabb ablakban futtatják őket, és körülbelül a felével az áron számláznak, ami összefoglalások, osztályozás, kinyerés és értékelési futások esetén nagy kedvezmény. A költsége a késleltetés: egy batch jobt órában mérnek, nemezredmásodpercben.
A gyakorlati felosztás egyszerű. Amire a felhasználó vár, szinkronban fut, cachinggel és routinggal. Ami sorba állítható, batchként fut: éjszakai összefoglalók, új dokumentumok címkézése, egy eval suite pontozása egy release előtt, egy backlog feltöltése. A Claude oldalon a kedvezmény a standard ár 50%-a, így az 50 millió input tokent feldolgozó éjszakai job egy nagy költségtételből mértékadóvá válik.
Az ügynökhurok az az eset, ahol ez érdekessé válik, mert egy hosszú ügynökhurok minden iterációban újraküldi a teljes előzményét. A prefix gecachelése olcsóvá teszi az egyes iterációkat; ha a hurkot úgy lehet átrendezni, hogy a független lépések egy batchként, nem pedig szekvenciális fordulóként futnak, a megtakarítás még nagyobb.
Költségmérleg funkciónként
A kérésenkénti költség alig mond valamit; a szám, amely számít, az a költség sikeres eredményenként, funkciónként bontva. Négy metrika funkciónként elég az induláshoz: input- és output tokenek kérésenként, cache-találati arány, p95 késleltetés, és azoknak a kéréseknek az aránya, amelyek a nagyobb modellre eszkaláltak. Az a funkció, amely megkétszerezte a cache-találati arányát és az eszkalálási arányát, nem az a nyereség, amelynek a tokenoszlop láttatja.
A műszert hetente az eval suite-tel szemben olvasd, nem a múlt heti számokkal szemben. Az a költségcsökkentés, amely csendben megváltoztatja a kimenet minőségét, regresszió, és az egyetlen módja, hogy ezt tudjuk, ugyanazt a pontozott halmazt futtatni mindkét konfiguráción. Az evals cikk leírja, hogyan építsd fel ezt a suite-ot anélkül, hogy egy hetet töltenél el vele.
A kompromisszumok, és mikor nem érdemes
A prompt caching nem ingyenes a komplexitás szempontjából. A cache-barát promptnak bájtstabilnak kell lennie, ami korlátozza a personalizációt és minden dinamikus tartalmat; az invalidálási szabályok elsőre visszafelé értelmesek; és a megtakarítás csak akkor materializálódik, ha a prefix elég hosszú ahhoz, hogy számítson, ami Claude-nál legalább 512 tokent jelent. Ez alatt inkább route-olj: az erőfeszítést a kisebb modell kiválasztásába tedd.
A routing fordított kompromisszumot jelent: hozzáad egy második modellt, egy második hibaformahalmazt és egy további késleltetési ugrást, és csak akkor fizetődik be, ha az olcsó út elég gyakran talál. A batch API-k akkor érdemesek, ha van térfogat, és feleslegesek egy alacsony forgalmú funkciónál. Ha a funkciódat naponta 50 kérés szolgálja ki, egyik sem számít sokat, és ugyanannak a délutánnak a jobb felhasználása maga a funkció.
LLM költség és késleltetés ellenőrzőlista
- Naplózd a tokeneket kérésenként, funkciónként bontva gecachelt inputra, friss inputra és outputra.
- Rendezd a promptot így: eszközök, system, előzmény, kérés, és tartsd mindent, ami változik, az előzmény alatt.
- Jelöld meg a cache breakpointokat kifejezetten, és nézd a találati arányt naponta; egy csendes zuhanás séma- vagy sablonváltozás.
- A TTL-t az olvasási mintából válaszd ki: öt perc a lüktető interaktív használatra, egy óra a ritka, de drága prefixekre.
- Az eszközdefiníciók változását költségeseményként kezeld, mert érvénytelenítik az egész cache-t.
- Először a legolcsóbb modellt futtasd, és egy előre definiált konfidenciajelre eszkalálj.
- Vidd át a nem interaktív munkát batch API-kre, és fogadd el az órák késleltetést.
- Kövesd az eszkalálási arányt és a p95 késleltetést a költség mellett, hogy egy olcsó regresszió ne bújjon el.
- Minden konfigurációváltozás után futtasd újra az eval suite-ot, mielőtt megünnepelted a megtakarítást.
Ez az egész ugyanabba a beszélgetésbe tartozik, mint az eval suite és az ügynökhurok tervezése; ha olyan funkciót építesz, amelynek mindhárom kell, az AI engineering oldal leírja, hogyan sorrendezem a munkát.
Források
Gyakori kérdések
Mennyit takarít meg a prompt caching?
A gecachelt olvasások az input ár 0,1-szereséért számlázódnak, Claude Opus 5.5-en 0,05-szereséért, míg az első írás az ötperces cache esetén az input ár 1,25-szerese, az egyórás cache esetén a 2-szerese. Tehát az a prefix, amelyet az ablakon belül többször öt alkalommal olvasnak újra, már megtérül, egy erősen újrahasznált prefix pedig tizedét fizeti annak, ami cache nélkül lenne.
Miért nem talál soha a prompt cache-om?
Szinte mindig azért, mert a prefix két kérés között nem bájtban azonos: egy időbélyeg, egy user ID, egy véletlen seed, egy átrendezett eszközlista vagy egyetlen átírt karakter az utasításokban. Nézd meg azt is, hogy minden dinamikus elem az előzmény alatt van-e, és jegyezd, hogy az eszközdefiníciók megváltozása az egész cache-t érvényteleníti, így egy éjszakai sémafrissítés megduplázhatja a költséget, amíg észre nem veszik.
Az 5 perces vagy az 1 órás cache-t használjam?
Az ötperces cache-t lüktető interaktív terhelésekhez, ahol sok kérdés perceken belül ugyanazt a dokumentumot vagy ugyanazt a system promptot használja, mert a kisebb írási felár körülbelül öt olvasás után megtérül. Az egyórás cache-t stabil, de ritkán használt prefixhez, például egy nagy dokumentumhalmazhoz, amely alacsony forgalmú funkció mögött van, vagy egy éjszakai jobhoz, ahol jobb egyszer megfizetni a kétszerest, mint óránként újrafeldolgozni a prefixet.
Hogyan csökkentsem az LLM költséget minőségromlás nélkül?
Ebben a sorrendben: stabilizáld a prompt prefixet és gecacheld, majd vidd át a funkciót arra a legkisebb modellre, amely átmegy az eval suite-teden, azután a maradék nehéz eseteket egy előre definiált konfidenciajellel irányítsd nagyobb modellre, végül minden nem interaktív munkát tedd batch API-re. Futtasd újra a pontozott teszthalmazt minden változás után, mert az az olcsóbb konfiguráció, amely megváltoztatja a kimenetet, regresszió, nem megtakarítás.
Hat a caching a késleltetésre?
Csökkenti az első token idejét, mert a gecachelt prefixet nem dolgozzák fel újra, de a hatás csökken, ahogy a beszélgetés nő, mert a nem gecachel rész hosszabb lesz. A késleltetést általában jobban kezeli egy kisebb modell és az, hogy a választ streamelve adjuk a felhasználónak, míg a caching főként költséget csökkent, és mérsékelt késleltetésnyereséget hoz az első tokenen.