Blog/RAG és keresés
RAG 2026-ban: hibrid retrieval, ügynöki keresés vagy egymillió tokenes kontextus?
RAG 2026-ban: mikor nyer a hibrid keresés, mikor illik az ügynöki keresés, és mit ér az egymillió tokenes kontextus kérésenként.
Balázs Csorba··8 perc olvasás
- RAG
- Long context
- Agentic search
- Hybrid search
- Contextual retrieval
A lényeg röviden
- A RAG 2026-ban azt jelenti, hogy egy gyorsítótárazott hosszú kontextus, a hibrid retrieval és az ügynöki keresés között választunk; mindegyik más helyzetben nyer.
- Az Anthropic ajánlása: 200 000 token alatti tudásbázisnál (kb. 500 oldal) az egészet cachinggel együtt tedd be a promptba.
- Egy 200 000 tokenes prefix Claude Opus 5.5-ön a 2026. szeptemberi listaárakkal cache nélkül $0.80, cache-ből olvasva $0.04.
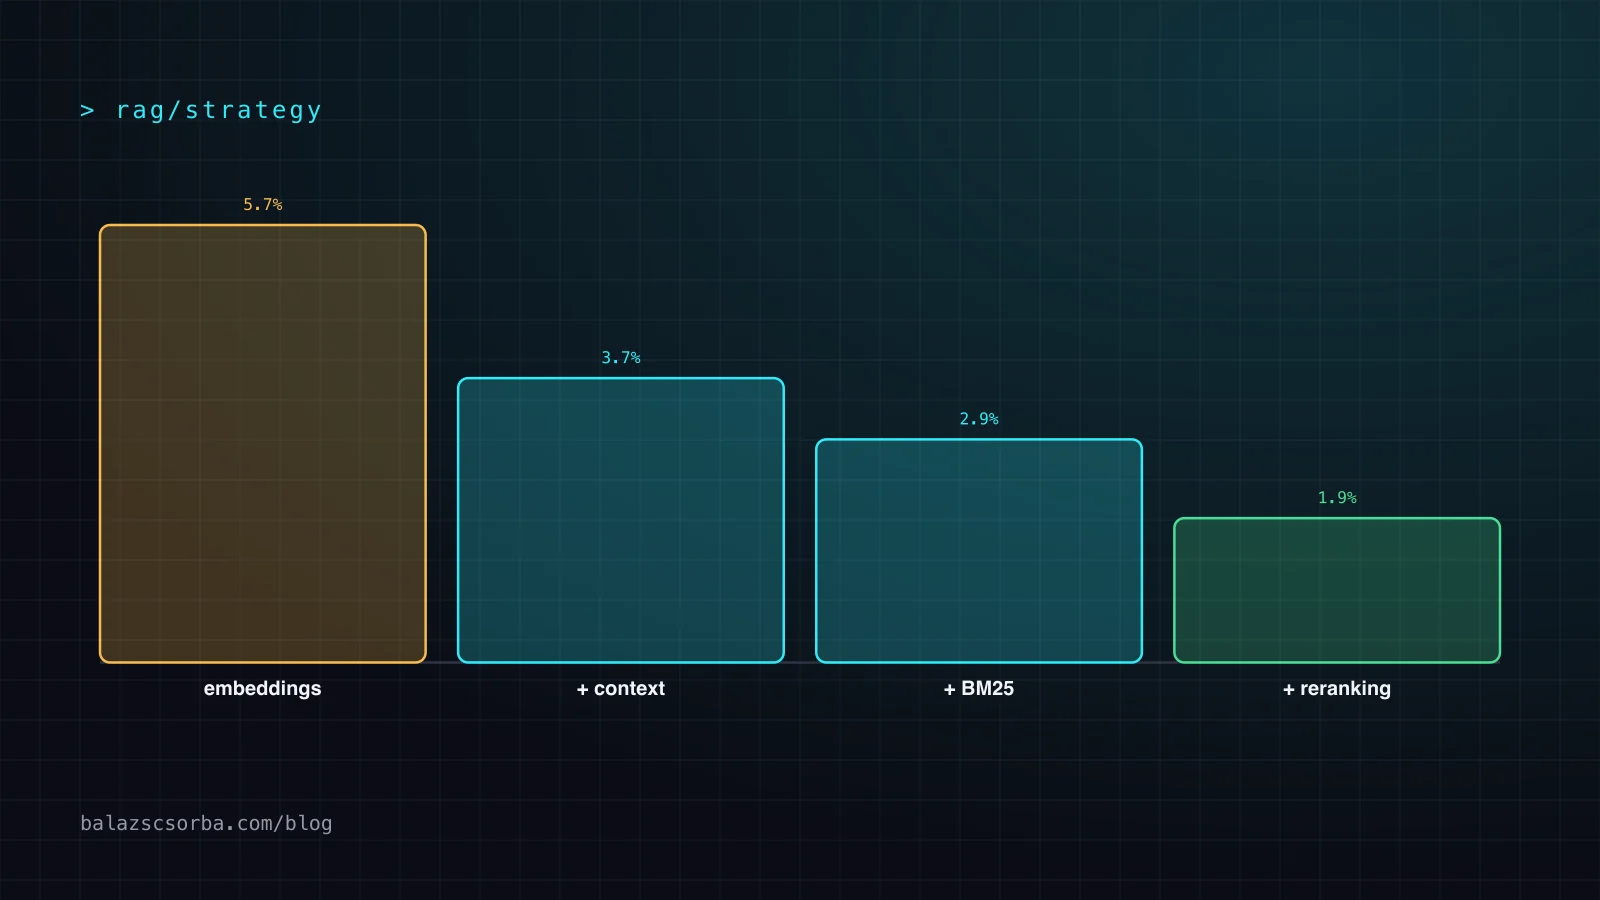
- A kontextuális embeddingek, a BM25 és az újrarangsorolás 5.7%-ról 1.9%-ra csökkentik az Anthropic top-20-as retrieval hibaarányát.
- Az ügynöki keresés a kódalapokhoz hasonló, állandóan változó, strukturált korpuszokhoz illik, de kérdésenként több tokent és nagyobb késleltetést jelent.
A RAG 2026-ban már nem egyetlen architektúra. A retrieval-augmented generation ma azt jelenti, hogy három mód közül kell választani, hogyan adunk egy modellnek tudást: betesszük az egészet egy egymillió tokent befogadó kontextusablakba, egy hibrid keresési pipeline-pal előkeressük a megfelelő chunkeket, vagy egy ügynököt eszközökkel iteratívan keresni hagyunk. Mindegyik más helyzetben nyer, a rossz választás pedig minden kérésnél vagy pontosságban, vagy pénzben fizet.
Ez a stratégiai rész: mikor illik az egyes megközelítés, mit ér kérdésenként, hol bukik el, és hogyan értékeljük ki a döntést. A megvalósításhoz magához (parse, chunkelés, BM25, Reciprocal Rank Fusion, újrarangsorolás, hivatkozások) lásd a termelési RAG pipeline-t, lépésről lépésre.
Mi a három módja annak, hogy tudást adjunk egy LLM-nek?
A három lehetőség a hosszú kontextus (mindent elküldünk), a retrieval (a legjobb chunkeket küldjük egy indexből) és az ügynöki keresés (a modell addig hívja a kereső eszközöket, amíg elég nem lesz). Abban különböznek, hogy ki dönti el, mit olvas a modell: senki, egy rangsoroló függvény, vagy maga a modell.
- Hosszú kontextus. A teljes tudásbázis a promptba kerül, általában egy prompt cache mögé. Nincs index, nincs chunkelés, nincs retrieval hiba. 2026 szeptemberében a jelenlegi Claude modellek (Opus 5.5, Sonnet 5, Fable 5.1) egymillió tokenes kontextusablakot kapnak.
- Hibrid retrieval. A dokumentumokat előre chunkelik és indexelik; minden kérdésen BM25 és vektorkeresés fut, az eredményeket fuzionálják és újrarangsorolják, majd a legjobb chunkeket küldik el. Kérdésenként egy retrieval forduló.
- Ügynöki keresés. A modell eszközöket kap, például grep, fájlolvasás, kereső API vagy SQL-végpont, és a találtak alapján dönti el, mit nézzen meg legközelebb. Kérdésenként több forduló.
Mikor veri le az egymillió tokenes kontextus a RAG-et?
A hosszú kontextus akkor veri le a retrievalt, ha a teljes tudásbázis kényelmesen belefér, és ritkán változik. Az Anthropic maga is azt írja, hogy 200 000 token alatt, körülbelül 500 oldal esetén „bevéhető egyszerűen a teljes tudásbázis” a promptba.
Az árargumentum megváltozott. 2026 szeptemberében a Claude 4.6 és az újabb modellek a teljes egymillió tokenes ablakot szokásos díjszámmal számlázzák; a díjszámlázási oldal így fogalmaz: „a 900k tokenes kérés ugyanazon tokenárral számolódik, mint egy 9k tokenes kérés”. Némi számolás a listaárakkal: egy 200 000 tokenes prefix Claude Opus 5.5-ön ($4 per million input tokens) $0.80 egy cache nélküli kérésenként, és $0.04, ha $0.20 per million árban a prompt cache-ből olvassuk. Sonnet 5-ön ($2 input, $0.20 cache reads) a cache-ből olvasás ugyanúgy $0.04. Ennyi ár mellett a retrieval stack kihagyása komoly opció.
A pontossági argumentum még nem érte utol. A Chroma Context Rot tanulmánya (2025. július, 18 modell) megállapította, hogy „a modellek nem egyenletesen használják a kontextusukat; inkább úgy válik, hogy a teljesítményük egyre megbízhatatlanabb, minél hosszabb az input”, és hogy akkor romlik gyorsabban, ha a kérdés és a válasz kevés szót oszt. A régebbi „Lost in the Middle” eredmény ugyanebbe az irányba mutat: egy hosszú kontextus közepén lévő információt rosszabbul használják, mint a legelején vagy a legvégén lévőt. A hosszú kontextus tehát megszünteti a retrieval hibákat, de figyelmetelvonást tesz hozzá. Akkor működik a legjobban, ha a kérdések szélesek („foglalj össze minden visszatérítési szabályunkat ezekben a dokumentumokban”), és a legrosszabb tűs keresésekre nagy, ismétlődő korpuszokban.
Miért még mindig a hibrid retrieval az alapértelmezett nagy korpuszoknál?
Amikor egy korpusz jóval meghaladja azt, ami a kontextusba belefér, vagy a kérdések pontos utánanézést igényelnek, a retrieval továbbra is a legmegbízhatóbb és legolcsóbb opció. A legerősebb közzétett recept kontextuális chunkeket kombinál BM25-tel és embeddingekkel, meg egy rerankerrel.
Az Anthropic Contextual Retrieval bejegyzése megmérte, mit ér az egyes rétegek a top-20-as retrieval hibaarányán. Ha a beágyazás előtt minden chunk elejére egy rövid, modell által írt kontextust teszünk („contextual embeddings”), 5.7%-ról 3.7%-ra ment. Kontextuális BM25-tel 2.9%, rerankerrel 1.9%, összesen 67%-os csökkenés. Az egyszeri előkészítési költség prompt cache használatával körülbelül $1.02 volt millió dokumentumtokenenként.
Két dolog teszi ezt alapértelmezetté. Először is a kérdésenkénti költség kicsi és állandó: egy embedding hívás, két indexkeresés, egy rerank, és néhány ezer tokenes prompt. Másodszor a retrieval lépés átvizsgálható. Logolhatod, mely chunkek jöttek vissza, kiszámíthatod a recallt a címkézett kérdéskészlettel, és a query-ben ki tudod kényszeríteni a jogosultságokat. Egymillió tokenes prompthoz egyik sem igaz.
Mi az ügynöki keresés, és mikor veri le a vektorokat?
Az ügynöki keresés keresőeszközöket ad a modellnek, és hagyja iterálni: lekérdez, olvas, finomít, lekérdez újra. Egy vektorindexet akkor ver le, ha a korpusz állandóan változik, erős a szerkezete (útvonalak, azonosítók, sémák), és ha a kérdéshez több ugrás kell.
A kódoló ügynökök a legtisztább esetek. Az ügynöki keresési minta közösségi leírása idézi Anthropic Cat Wu-ját a Claude Code-ról: „Kezdetben használtunk is vektor embeddingeket. Ezeket valóban nehéz karbantartani, mert folyamatosan újra kell indexelni őket… A Claude nagyon jó az ügynöki keresésben.” Egy kódalap minden commitban változik, az azonosítók pontos stringek, amiket a grep megbízhatóan megtalál, és az ügynök végigkövetheti az importot egyik fájltól a másikig. Egy index mindig egy kicsit elavult lenne, a még nem commitolt változásokkal együtt.
Ugyanez a leírás őszintén felsorolja a költségeket: több token az iterációk során, magasabb késleltetés az összetett kérdéseknél, gyengébb szemantikus illesztés („authentication” kontra „login”), és kellően erős modellek igénye. Az ügynöki keresés a leállási döntést is a modellre bízza, ezért keretet kell adni; a mechanikája itt van: az ügynökhurok magyarázva. Pragmatikus köztes megoldás, ha az ügynöknek adunk egy hibrid kereső eszközt a saját eszközei közé. Így szemantikus visszakeresést kap, amikor kell, egyébként pontos találatokat.
Hogyan hasonlítanak össze a költségek és a késleltetés a három megközelítésnél?
A retrievalnek kérdésenként a legkisebb és a legkiszámíthatóbb a költsége; a hosszú kontextus csak addig olcsó, amíg meleg a cache; az ügynöki keresés a legdrágább és a legingadozóbb. A táblázat minőségi, kivéve ahol konkrét ár szerepel.
| Szempont | Hosszú kontextus | Hibrid retrieval | Ügynöki keresés |
|---|---|---|---|
| Megépítés | Legkisebb | Legnagyobb: parse, index, evals | Közepes: eszközök és keretek |
| Bemeneti tokenek kérdésenként | A teljes korpusz (pl. 200K: $0.04 cache-ből, $0.80 cache nélkül Opus 5.5-ön) | Néhány ezer | Minden fordulóval nő |
| Késleltetés | Alacsony meleg cache mellett, magas hideg cache mellett | Alacsony: egy retrieval forduló | Legmagasabb: több modell- és eszközhívás |
| Frissesség | A prompt újraépítése, a cache újraírása | A megváltozott dokumentumok újraindexelése | Mindig aktuális |
| Jogosultságok | Egy prompt hozzáférési szintenként | Szűrés a query-ben | Az eszközök kényszerítik ki |
| Jellemző hiba | Figyelmetelvonás, a középen kimaradó részletek | A releváns chunk nem kerül vissza | Túl korán leáll, vagy körbe-körbe jár |
A prompt caching teszi életképessé a hosszú kontextusos oszlopot, és a részletei (5 perces kontra 1 órás cache, mi invalidálja) döntik el a valódi számlát. Ezekről szól az LLM költség és késleltetés csökkentése cachinggel, routinggal és batcheléssel cikk.
A mérleg: hol bukik el mindegyik megközelítés
Mindegyik lehetőségnek van egy hibamódja, amelyet a többi elkerül. Jól választani annyit jelent, tudni, melyik hiba tűnik fel először a felhasználóidnak.
- A hosszú kontextus méreten, jogosultságokon és pontosságon bukik el. Akkor áll le, ha a korpusz kinővi az ablakot, nem tud különböző jogosultságú felhasználókat egy gyorsítótárazott prompthoz kiszolgálni, és a tűs kérdések szenvednek a context rot miatt.
- A hibrid retrieval csendben bukik el. Ha a megfelelő chunk nincs a top k-ban, a modell a rosszakkal válaszol, és ugyanúgy magabiztosan hangzik. Ezt csak egy retrieval metrika fogja meg.
- Az ügynöki keresés a költségen és a leálláson bukik el. A tokenek minden fordulóval nőnek, és a modell leállhat az első hihető találat után, vagy folytathatja a keresést, noha már megvan a válasza.
- Egyik sem kezeli az aggregálást. A „Hány rendelést küldtünk el késve az elmúlt negyedévben” egy SQL lekérdezés. Adj a modellnek lekérdező eszközt dokumentumok helyett.
Hogyan értékeljük ki a döntést?
Értékeld a retrievalt külön a generálástól, ugyanazzal a címkézett kérdéskészlettel minden lehetőséghez. Ha csak a végső válaszokat értékeled, nem tudod megkülönböztetni a retrieval hibáját a generálási hibától.
Gyűjts néhány dozen valódi kérdést, címkézd be azokat a részleteket, amelyek megválaszolják őket, és vegyél be olyan kérdéseket is, amire nincs válasz. A retrievalnél mérd a recall@k értéket (az Anthropic hibaaránya 1 minus recall@20). A hosszú kontextusnál, ahol nincs retrieval lépés, nézd meg, hogy a válasz a megfelelő részletre hivatkozik-e. Ügynöki keresésnél logold az eszközhívásokat, és mérd, hogy egyáltalán a megfelelő fájlt vagy sort olvasta-e meg, plusz a fordulók és a tokenek számát. Ezután értékeld a válaszokat egy validált graderrel. A grader építésének és validálásának módszere itt van: evals LLM termékfunkciókhoz.
Döntési checklist
- Számold meg a korpuszt tokenben a szolgáltató tokenizálójával, nem oldalban vagy szavakban.
- ~200K token alatt és stabil: először próbáld a hosszú kontextust prompt cachinggel, és mérd a válaszminőséget.
- Különböző felhasználók különböző dokumentumokat látnak: retrievalt használj, a query-ben jogosultsági szűréssel.
- Nagy vagy növekvő korpusz: hibrid retrieval kontextuális chunkekkel, BM25 plusz vektorokkal, és egy rerankerrel.
- Kód vagy strukturált fájlok, amik folyamontan változnak: ügynöki keresés grep-pel, olvasással és fordulókerettel.
- Számlálási és aggregációs kérdések: adj a modellnek SQL- vagy API-eszközt, nem dokumentumokat.
- Logold, mit olvasott a modell minden válasznál: chunkazonosítók, fájlok vagy a cache prefix verziója.
- Értékeld külön a retrievalt és a válaszokat egyetlen címkézett kérdéskészlettel, minden változtatás előtt és után.
Ha egy termékhez választasz ezek között, és szeretnéd átbeszélni, nézd meg az AI fejlesztés oldalt.
Források
- Anthropic: Introducing Contextual Retrieval (2024)
- Chroma: Context Rot – How Increasing Input Tokens Impacts LLM Performance (2025)
- Liu et al., Lost in the Middle: How Language Models Use Long Contexts (2023)
- Claude docs: Pricing (hosszú kontextus, prompt caching, tokenizer)
- Claude docs: Models overview
- Awesome Agentic Patterns: Agentic search over vector embeddings
Gyakori kérdések
Kell még RAG, ha a modellek egymillió tokenes kontextusablakot kapnak?
Gyakran igen. A hosszú kontextus jól működik kis, stabil tudásbázisoknál, és az Anthropic azt javasolja, hogy 200 000 token alatt mindent küldjünk el. A teljesítmény viszont egyre megbízhatatlanabb a bemenet növekedésével (a Chroma Context Rot tanulmánya), egy gyorsítótárazott prompt nem tud eltérő jogosultságú felhasználókat kiszolgálni, és a nagy korpuszok így is kilógnak az ablakból. Nagy léptékben a retrieval továbbra is az olcsóbb és átvizsgálhatóbb opció.
Mi a különbség az ügynöki RAG és a klasszikus RAG között?
A klasszikus RAG kérdésenként egy retrieval lépést futtat: végigkeresi az indexet, kiveszi a legjobb chunkeket, generál. Az ügynöki RAG keresőeszközöket ad a modellnek, és több fordulóban hagyja eldönteni, mit nézzen meg legközelebb, amíg elég nem lesz. Jobban kezeli a több ugrásból álló kérdéseket és a változó korpuszokat, de több tokent használ, késleltetést ad hozzá, és fordulókeretet igényel.
Mennyibe kerül az egész tudásbázist a promptba tenni?
A 2026. szeptemberi Claude listaárakkal egy 200 000 tokenes prompt Opus 5.5-ön ($4 per million input tokens) $0.80 egy cache nélküli kérésenként, és $0.04, ha a prompt cache-ből olvassuk ($0.20 per million). A Claude 4.6 és az újabb modellek a teljes 1M ablakot szokásos díjszámmal számlázzák. Az első kérés a 5 perces cache írási felárát fizeti, ami 1.25x.
Miért használnak a kódoló ügynökök grep-et vektorkeresés helyett?
A kódalap minden commitban változik, így a vektorindex mindig egy kicsit elavult, az azonosítók pedig pontos stringek, amiket a grep megbízhatóan megtalál. Az Anthropic Cat Wu szerint a Claude Code eleinte embeddingeket használt, de azok újraindexelése nehézkes volt, az ügynöki keresés viszont jól működött. A csere az, hogy a szinonimák illesztése gyengül, és kérdésenként több token fogy.