Blog/Webfejlesztés
llms.txt vagy Markdown content negotiation: mit töltenek le valójában az ügynökök
Az llms.txt javaslat, a Markdown content negotiation fejléc. Mit töltenek le a MI-ügynökök, mit mutatnak a naplók, és hogyan működik mindez Nuxttal és nginxszel.
Balázs Csorba··9 perc olvasás
- llms.txt
- Content negotiation
- AI agents
- Nuxt
A lényeg röviden
- Az llms.txt egy kézzel írt Markdown-index a webhely gyökerében; a formátum 2. verziója 2026 augusztusában változott, maga a formátum pedig szándékosan laza marad.
- A content negotiation más mechanizmus: a kliens Accept: text/markdown fejlécet küld, a szerver Content-Type: text/markdown fejléccel válaszol, és hozzáadja a Vary: Accept fejlécet.
- Az Ahrefs szerint a közzétett llms.txt fájlok 97 %-a egyáltalán nem kapott kérést, a beérkező kérések 96 %-a pedig botoktól jött, élen SEO audit eszközökkel.
- Elég a buildidőben generált Markdown-másolat minden oldalról és a preferált kérések átírása az nginxben, hogy mindkettőt kiszolgáld, és ugyanezek a fájlok táplálják a /llms.txt-et és a /llms-full.txt-et.
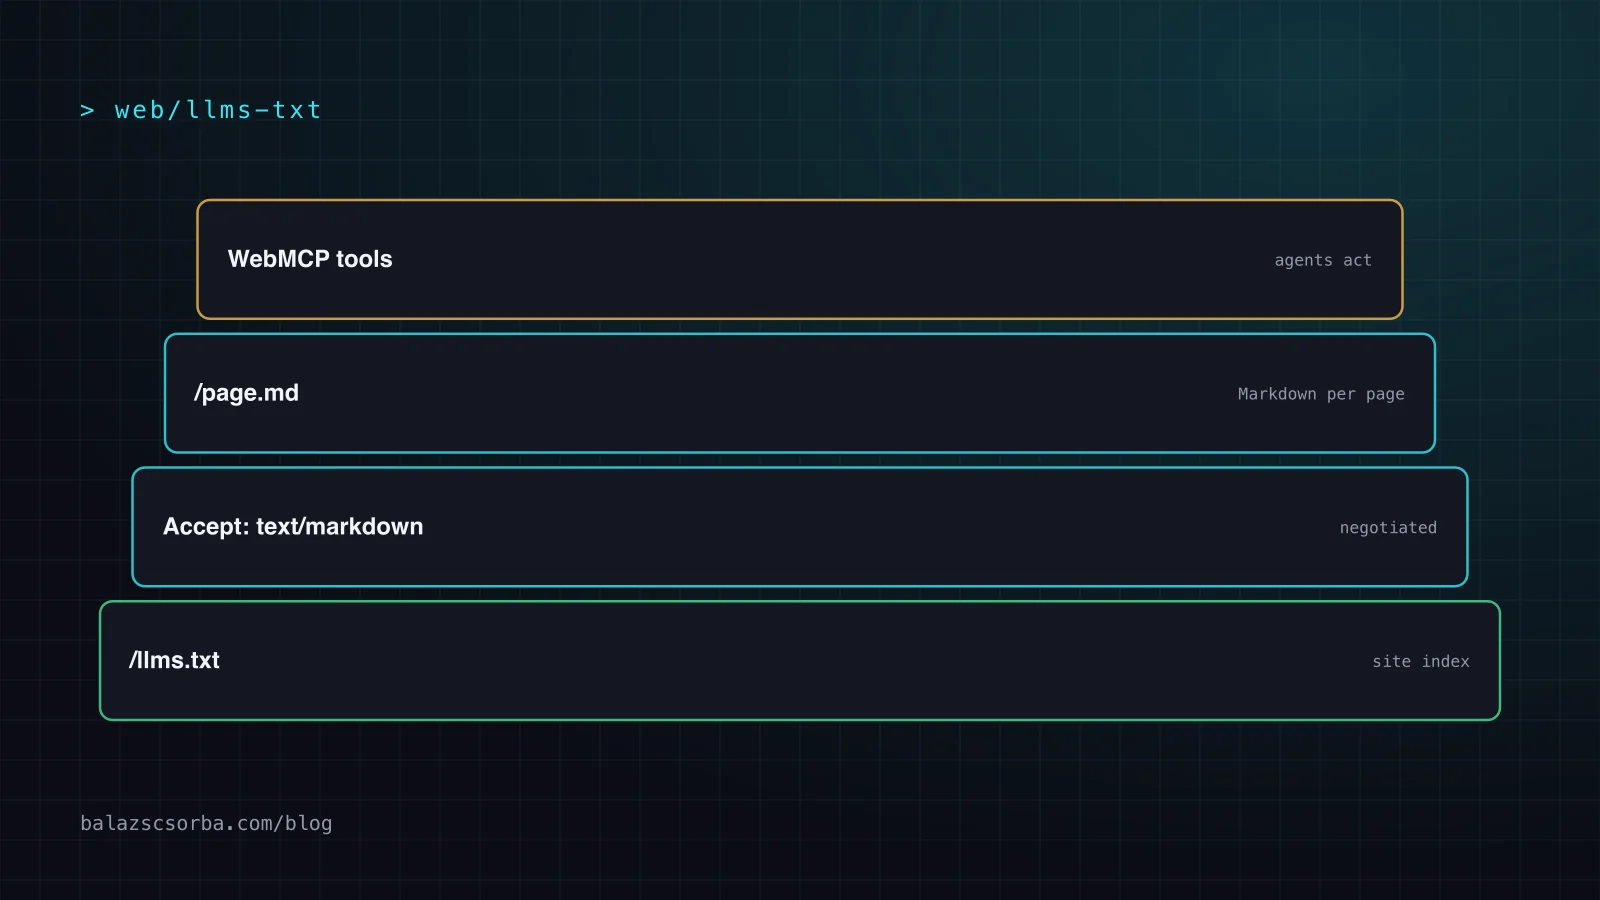
- Az llms.txt, a Markdown válaszok és a WebMCP rétegek, nem versenytársak: egy index, egy oldal olcsó reprezentációja, és a lehetőség, hogy a webhelyen cselekedj.
Az llms.txt egy Markdown-fájl egy webhely gyökerében, amely elmondja a nyelvi modelleknek, mi van az oldalon, és hol találhatók az oldalainak tiszta, csak szöveges változatai. A Markdown content negotiation egy másik mechanizmus ugyanerre a célra: ugyanaz az URL Markdownnal válaszol HTML helyett, ha a kliens Accept: text/markdown fejlécet küld. Mindkettőt gyakran „AI SEO"-ként adják el, és az ügynökök tényleges lekéréseire vonatkozó bizonyítékok vékonyabbak a marketingnél.
Ez a bejegyzés összeveti a kettőt, összefoglalja a közzétett naplóelemzéseket, és végigmegy azon, hogyan valósítja meg ezt a webhely mindkettőt egy statikus Nuxt buildben, sima nginx mögött, CDN funkció nélkül. Megkapod az nginx konfigurációt, a build lépést és egy ellenőrzőlistát.
Mi az llms.txt, és mi változott a 2. verzióban?
Az llms.txt Jeremy Howard javaslata egy webhely Markdown-indexére, amely a /llms.txt útvonalon kiszolgálódik, és az oldalak Markdown-másolataira hivatkozik. Az 1. verzió 2024. szeptember 3-án jelent meg, a 2. verzió 2026. augusztus 10-én követte (llmstxt.org).
A formátum szándékosan laza. A webhely nevét tartalmazó H1 az egyetlen kötelező rész. Utána egy blockquote következik rövid összefoglalóval, opcionális szabad szöveggel és tetszőleges számú H2 szakasszal, mindegyik egy Markdown-linkekből álló listával. Az „Optional" nevű szakasz konvenció szerint az a lista, amelyet az ügynök átugorhat, ha rövidebb kontextusra van szüksége. A javaslat egy tiszta Markdown-másolatot is kér minden oldalról, akár page.md, akár page.html.md néven, és index.md-et az olyan URL-ekhez, amelyeknek nincs fájlneve.
A v2 változásai gyakorlatiak, nem elviek:
- Felfedezés linkrelációkon keresztül. A
rel="alternate" type="text/markdown"egy oldalról a Markdown-másolatára mutat, arel="describedby"pedig arra az llms.txt-re, amely lefedi. - Mindkét URL-stílus megengedett:
.mdhozzáfűzve, vagy a kiterjesztés lecserélve. - Az alútvonalak kapnak saját fájlt; „the most specific file applies".
- Egyszerűbb használati modell: az ügynökök megnézik vagy átkutattják az llms.txt-et, majd követik a szükséges linkeket. Az „Optional" szakasz már nem hordoz gépi jelentést.
Érdemes megjegyezni, hogy a javaslat egyáltalán nem használ HTTP content negotiationt. Ismert útvonalakon lévő fájlokra és linkekre támaszkodik.
Hogyan működik a Markdown content negotiation?
A kliens az Accept request fejlécben sorolja fel a kívánt médiatípusokat, a szerver pedig kiválaszt egy reprezentációt ugyanarról az erőforrásról. Ha a kliensnél a text/markdown elöl van, egy ezt támogató szerver Markdownnal válaszol, Content-Type: text/markdown fejléccel, és hozzáadja a Vary: Accept-et, hogy a cache-ek a két verziót külön tartsák.
A Cloudflare 2026 februárjában zónafeaturként szállította, Markdown for Agents néven (changelog). Ha egy request hordozza az Accept: text/markdown-et, a Cloudflare lekéri az HTML-t az originről, átalakítja, és Markdownot ad vissza (Cloudflare dokumentáció). A dokumentált részletek akkor is hasznosak, ha nem használsz Cloudflare-t:
- Egy
x-markdown-tokensfejléc becsüli a Markdown méretét tokenekben, azx-original-tokensa HTML-ét. A dokumentáció példaoldala 12 345-ről 725 tokenre esik. - A
Varymegkapja azAccept-et; azETagés aLast-Modifiedeltűnik, mert a feltételes kéréseket átalakított válaszoknál nem lehet kiszolgálni. - Ha az origin nem állít be
Content-Signal-t, az alapértékai-train=yes, search=yes, ai-input=yes. - Az origin válasza nem lehet nagyobb 2 MB-nál, és a featurehez Pro, Business vagy Enterprise csomag kell.
Akkora tokenmegtakarítás a legkomolyabb érv a Markdown mellett. Az az ügynök, amely fetch eszközzel olvassa az oldalad, minden hívásnál fizet a navigációért, a scriptekért, az inline SVG-ért és az osztálynevekért. A Markdown-másolat a tartalom és semmi más.
Mit töltenek le valójában a MI-ügynökök?
A közzétett bizonyítékok szerint a kódoló ügynökök egyre gyakrabban kérnek Markdownot, az llms.txt-et pedig alig olvassa bárki. Mindkét eredményhez fenntartás tartozik, de ugyanabba az irányba mutatnak.
Az llms.txt-et szinte senki nem olvassa. Az Ahrefs 2026. májusi forgalommal rendelkező 137 210 domain szervernaplóit elemezte (Ahrefs, 2026. június). Körülbelül 38 000 közülük, azaz 28 %-uk közzétett llms.txt-et, de e fájlok 97 %-a nulla kérést kapott. A beérkező kérések 96 %-a botoktól jött, élen SEO audit eszközökkel; a MI-retrieval botok 1,1 %-ot tettek ki. Azokhoz az llms.txt fájlokhoz, amelyek nem léteznek, pedig nulla kérés érkezett MI-botoktól: az Ahrefs szavával, „they never go looking".
Néhány ügynök valóban elküldi az Accept: text/markdown-et. A Checkly 2026. februári, hét kódoló ügynököt vizsgáló tesztje három olyan ügynököt talált, amelyek először Markdownot kérnek: Claude Code (text/markdown, text/html, */*), a Cursor és az OpenCode. Az OpenAI Codex, a Gemini CLI, a GitHub Copilot és a Windsurf általános HTML- vagy wildcard fejléceket küldött (Checkly). Az ügynökverziók gyorsan változnak, úgyhogy ezt pillanatképnek vedd.
Egy webhely naplói. A Cloudflare feature-jének egyetlen webhelyen végzett vizsgálata 44 nap alatt (2026. március 7. és 2026. április 19. között) 1 421 Markdown kérést számolt, ezek közül 500-at az Anthropic infrastruktúrájából, 639-et headless Chrome-ból (Suganthan). A szerző egyértelműen kijelenti, ez „nem bizonyítja, hogy a MI-crawlek a markdownot preferálják a HTML-lel", és azt sem, hogy a kiszolgálás javítja a hivatkozásokat. Egy webhelyről van szó; ne általánosíts.
Az én értelmezésem: azok a crawlek, amelyek kereső- és tanítóindexeket építenek, HTML-t töltenek le, ahogy mindig. Azok az ügynökök, amelyek valós időben egy felhasználó kedvéért cselekszenek, különösen a fetch eszközt használó kódoló ügynökök, ott érik meg a Markdown. Ennek a webhelynek a forgalmi számait nem publikálom, ezért itt nincs is ilyen.
| Mechanizmus | Hogyan találja meg egy ügynök | Mit ad vissza | Bizonyíték a használatra |
|---|---|---|---|
/llms.txt | Ismert útvonal, vagy rel="describedby" | Az oldalak indexe összefoglalókkal | Gyenge: az Ahrefs mintájában a fájlok 97 %-a olvasatlan |
page.md másolat | Link az llms.txt-ből, vagy ismert kiterjesztés | Egy oldal Markdownként | Csak akkor, ha valami rá hivatkozik |
Accept: text/markdown | Ugyanaz az URL, request fejléc | Egy oldal Markdownként | Néhány kódoló ügynök küldi (Checkly, 2026. február) |
rel="alternate" link | Az HTML headben | Mutató a .md másolatra | Új az llms.txt v2-ben; még nincs adat |
| WebMCP eszközök | A böngészőben az oldal regisztrálja | Tipizált eszközeredmények | Chrome origin trial; korai szakasz |
Hogyan valósítja meg ezt a webhely Nuxttal és nginxszel
Ez a webhely buildidőben Markdown-másolatot generál minden oldalról, egy .md URL-en szolgálja ki, és az nginxben átírja a Markdownot preferáló kéréseket arra a másolatra. Ugyanezek a fájlok táplálják a /llms.txt-et és a /llms-full.txt-et.
A build lépés: a generált HTML átalakítása
Miután a nuxt generate kiírta a statikus HTML-t, egy posztbuild szkript (scripts/build-agent-files.mjs) kiolvassa minden oldal <main> elemét, és a Turndown könyvtárral átalakítja. Az, hogy a kész HTML-t alakítjuk át, külön Markdown-források tartása helyett, azt jelenti, hogy a Markdown mindig pontosan azt mondja, amit az oldal mond. A tényleges munkát néhány szabály végzi:
- A scriptek, stílusok, SVG, canvas, gombok és űrlapok eltűnnek. Ezért minden diagram ezen a webhelyen teljes szöveges leírást hordoz a feliratában: a Markdown-másolat csak szavakat tart meg.
- A linkek és a képek abszolút URL-ekké válnak, hogy egy modell kontextusába illesztett másolat is valamire mutasson.
- A szöveg azt követi, amit a képernyőolvasó felolvas: az
aria-hiddenjelölésű elemek kiesnek, a vizuálisan rejtett szöveg megmarad. - Minden fájl rövid fejléccel indul: az oldal leírásával, a kanonikus web URL-jével, a nyelvével és a többi nyelvi változattal, blogbejegyzéseknél pedig a szerzővel, a dátumokkal és a kulcsszavakkal.
Ugyanez a futás írja a /llms.txt-et is: szakaszokkal a weblapokról, a blogbejegyzésekről (dátumokkal és kulcsszavakkal), a német és a magyar változatról, valamint egy „Optional" listáról, a /llms-full.txt-et pedig minden angol oldal teljes tartalmával.
Az nginx rész: content negotiation CDN nélkül
Két map blokk dönti el, hogy egy kérés Markdownot akar-e, és melyik HTML-oldalhoz tartozik egy Markdown fájl:
# Accept: text/markdown listed first, or present without text/html
map $http_accept $bc_md {
  default                             "";
  "~*^\s*text/markdown"               1;
  "~*^(?!.*text/html).*text/markdown" 1;
}

# The HTML page a Markdown copy belongs to (sent as its canonical URL)
map $uri $bc_md_page {
  default                  "";
  "/index.md"              /;
  "~^(?<p>/.+)/index\.md$" $p;
  "~^(?<p>/.+)\.md$"       $p;
}
Az HTML location átírja a kérést a .md fájlra, ha a map egyezett, és mindkét location Vary: Accept-et küld:
location ~ \.md$ {
  default_type text/markdown;
  add_header Link "<https://balazscsorba.com$bc_md_page>; rel=\"canonical\"";
  add_header Vary "Accept";
  try_files $uri =404;
}

location / {
  if ($bc_md) {
    rewrite ^/$ /index.md last;
    rewrite ^/(de|hu)$ /$1/index.md last;
    rewrite ^(/[a-z0-9/-]*[a-z0-9])$ $1.md last;
  }
  add_header Vary "Accept";
  try_files $uri $uri/index.html $uri/ =404;
} A Markdown-válaszon lévő Link: rel="canonical" fejléc visszairányítja a keresőket a HTML oldalra, így a másolat nem versenyez vele duplikált tartalomként. Érdemes ismerni egy nginx csapdát: amint egy location saját add_header-t állít be, egyet sem örököl a server blockból. A webhely a biztonsági headereit egy include fájlban tartja, és minden olyan locationbe behúzza, amely headert ad.
A felfedezés és az engedélyek jelei
- Minden oldal headje linkel a
/llms.txt-re; egy kis plugin (app/plugins/agent-links.ts) hozzáad egyrel="alternate" type="text/markdown"linket a Markdown-másolatra a legfelső szintű oldalakon. - A
robots.txtengedélyezi az összes crawlert, felsorolja a MI user agenteket, és utal az llms.txt-re. A Content Signals sor (search=yes, ai-input=yes, ai-train=yes) kommentként marad, mert az RFC 9309 szerinti validátorok, mint a Lighthouse, elutasítják az ismeretlen direktívákat; a géppel olvasható engedély a/.well-known/tdmrep.json(W3C TDMRep). - A WebMCP-s böngészőügynökök meghívhatnak egy
get_page_contenteszközt, amely ugyanazt a Markdown-másolatot kéri leAccept: text/markdownfejléccel. Ezt a réteget a WebMCP útmutató tárgyalja.
Az ügynökökkel használható webhely rétegei
Gondolj ezekre a mechanizmusokra úgy, mint különböző közönséggel rendelkező rétegekre, nem pedig versenytársakra. Mindegyik olcsó egy statikus webhelyen, és mindegyik másfajta klienst szolgál ki.
Tradeoffok és buktatók
A költségek kicsiek, de valósak: a cache-elés, a duplikált tartalom, és egy header parser, amely inkább heurisztika, mint a HTTP negotiation teljes implementációja.
- A cache-eknek tiszteletben kell tartaniuk a
Vary: Accept-et. Enélkül egy CDN vagy proxy Markdownot adhat a böngészőnek, HTML-t az ügynöknek. Nézd meg az origin és a kliens közötti összes cache réteget. - Az nginx map figyelmen kívül hagyja a q-értékeket. Azt illeszti, ami „Markdown elöl", vagy „Markdown HTML nélkül". Ez lefedi a Checkly által rögzített headereket, de egy olyan kliens, amely
text/html;q=0.1, text/markdown-et küld, HTML-t kap. Ha kell, a teljes parser az alkalmazáskódba való. - Duplikált URL-ek. A
.mdmásolat ugyanannak a tartalomnak a második URL-je. A kanonikusLinkfejléc kezeli a keresőket; a másolatokat ne tedd be a sitemapbe. - Elcsúszás a verziók között. A kézzel karbantartott Markdown elavul. A megépített HTML-ből generálva a probléma megszűnik, egy build lépés árán.
- Ne várd, hogy az llms.txt mozgassa a rangsorokat. Az Ahrefs adatai szerint szinte senki nem olvassa. Azért publikáld, mert olcsó, és hasznos azoknak az eszközöknek, amelyek mégis olvassák, nem rangsorolási fogadásként.
Ellenőrzőlista: llms.txt és Markdown az ügynökökhöz
- Generálj Markdownot a renderelt HTML-ből, oldalanként egy fájlt, abszolút linkekkel.
- Írd le szavakkal minden diagramot; az átalakítók ledobják az SVG-t és a canvas-t.
- Szolgáld ki a másolatokat
text/markdownként egy kanonikusLinkfejléccel a HTML-re. - Negotiálj a
Acceptfejléccel ugyanazon az URL-en, és mindkét reprezentáción küldjVary: Accept-et. - Publikáld az
/llms.txt-et egy összefoglaló blockquote-tel, oldalanként egy linkkel és egy „Optional" listával. - Adj
rel="alternate" type="text/markdown"linkeket az HTML headbe, ahogy az llms.txt v2 javasolja. - Írd le az engedélyeket a robots.txt-ben és egy géppel olvasható fájlban, például a TDMRepben.
- Mérd a saját naplóidat, mielőtt bármit állítanál az ügynökforgalomról.
A következő réteg az, hogy az ügynökök ne csak olvassanak, hanem cselekedjenek: lásd a WebMCP útmutatót egy valódi webhelyen, és a boltokhoz az agentikus commerce protokollok összehasonlítását. Ha ezt a saját webhelyeden akarod beállítani, nézd meg az AI engineering oldalt.
Források
- llmstxt.org: The /llms.txt file (javaslat, 2. verzió)
- llmstxt.org: Changes from v1 to v2
- Cloudflare changelog: Markdown for Agents (2026. február 12.)
- Cloudflare docs: Markdown for Agents
- Ahrefs: 137K site elemezve, az llms.txt fájlok 97 %-át senki nem olvassa (2026. június)
- Checkly: The current state of content negotiation for AI agents (2026. február)
- Suganthan: a Cloudflare Markdown for Agents követése egy webhelyen
Gyakori kérdések
Kell-e még 2026-ban llms.txt?
Jóval kevésbé, mint a javaslat megjelenésekor. Az Ahrefs 2026. májusában 137 210 forgalommal rendelkező domain szervernaplóit elemezte, és azt találta, hogy körülbelül 28 %-uk tett közzé llms.txt-et, de e fájlok 97 %-a nulla kérést kapott, a beérkező kérések 96 %-a pedig botoktól jött, élen SEO audit eszközökkel. Egy rövid llms.txt keveset kerül; a mérhető forgalom a Markdown content negotiationnál van.
Hogyan működik a Markdown content negotiation?
A kliens az Accept request fejlécben felsorolja a kezelni tudó médiatípusokat, és ha a text/markdown elöl jön, egy ezt támogató szerver ugyanarra az URLre Markdownot ad vissza HTML helyett. Két fejléc teszi helyessé: a Content-Type: text/markdown a válaszban, és a Vary: Accept, hogy a cache-ek a HTML- és a Markdown-verziót külön tartsák. Minden, ami ezután jön, heurisztika, nem teljes HTTP negotiation.
Mit szolgáljon ki egy ügynökökkel használható webhely?
Három réteg. Minden oldal Markdown-reprezentációja, hogy a text/markdownot kérő kliens tiszta szöveget kapjon markup helyett. Egy index, például a /llms.txt és a /llms-full.txt, amely megmondja, mi van az oldalon, és hol a tiszta verziók. És deklarált eszközök, például WebMCP, ha azt akarod, hogy az ügynök a webhelyen cselekedjen, ne csak olvasson. Mindegyik olcsó egy statikus webhelyen, és másfajta klienst szolgál ki.
Segít az llms.txt a MI-keresőben való láthatóságon?
Rangsorolási eszközként nincs bizonyítva, és a forgalmi adatok ellene szólnak annak, hogy erre fogadjunk. A mérhető a tokenköltség és a parse-hiba: a Cloudflare dokumentációja egy példaoldalt mutat, amely 12 345-ről 725 tokenre esik, ha Markdownként szolgálják ki. Ez nyereség annak az ügynöknek, amely olvassa az oldalad, nem pedig garancia a hivatkozásra.
Hogyan szolgáljak ki Markdownot egy Nuxt oldalról?
Generálj buildidőben minden oldalról egy Markdown-másolatot a HTML mellé, majd az nginxben írd át azokat a kéréseket, amelyek Accept fejléce a text/markdownot preferálja, arra a fájlra, és mindig Vary: Accept fejléccel válaszolj. Ez a webhely pontosan ezt teszi, és ugyanezek a generált fájlok táplálják a /llms.txt-et és a /llms-full.txt-et is. A kész HTML átalakítása a Turndownnal azt tartja meg, hogy a Markdown pontosan azt mondja, amit az oldal.