Blog/Webfejlesztés
Denial of wallet: nyilvános LLM-végpontok védelme egy Nuxt-alkalmazásban
Visszaélés és elszabaduló költség megállítása egy nyilvános Nuxt LLM-útvonalon: auth, rate limit, promptkorlát, tokenkeret, Turnstile és költéskorlát.
Balázs Csorba··14 perc olvasás
- Nuxt
- LLM security
- Rate limiting
- OWASP
- Cost control
A lényeg röviden
- Egy nyilvános LLM-útvonal használat alapján fizetős API, mögötte a te bankkártyáddal; az OWASP ezt az LLM10:2025 Unbounded Consumption kockázatként tartja nyilván.
- A modellhívás elé session kell, és soha ne legyen általános proxy: a szerver választja a modellt, a system promptot és a max_tokens értéket.
- A kéréseket felhasználónként és IP-nként közös tárban korlátozd, a tokeneket pedig külön, mert egy kérés ezerszer annyiba kerülhet, mint egy másik.
- A hívás előtt foglalj tokenkeretet, utána pedig számold el a tényleges felhasználással, atomi számlálóval.
- A szolgáltatói költéskorlát az utolsó biztosíték, nem a vezérlés: egyszerre minden felhasználónak kikapcsolja a funkciót, és nem azonnal lép érvénybe.
Egy nyilvános weboldal LLM-funkciója használat alapján fizetős API, mögötte a te fizetési adataiddal. Egy kapcsolatfelvételi asszisztens, egy termékkereső vagy egy „foglald össze az oldalt” gomb mind egy szerveroldali útvonalban végződik, amely szöveget továbbít egy modellnek, és tokenenként fizet. Ha ez az útvonal bárkinek, bármennyiszer, bármilyen bemenetre válaszol, nem az a kérdés, hogy valaki ingyenes modell-API-ként használja-e, hanem csak az, hogy mikor.
Ez a cikk az LLM-funkciók Nuxtban való szállításának költség- és visszaélési oldala. Az OWASP LLM10:2025 Unbounded Consumption kockázatát egy Nuxt- és Nitro-alkalmazás konkrét rétegeire fordítja le: session, kérés- és tokenkorlát, promptméret-korlát, felhasználónkénti keret, Cloudflare Turnstile, valamint az OpenAI és az Anthropic költéskorlátai, átírható kóddal.
Mi az a denial of wallet?
Az OWASP az Unbounded Consumption kockázatot úgy írja le, hogy egy LLM-alkalmazás „túlzott és ellenőrizetlen inferenciát” enged a felhasználóknak, ami szolgáltatásmegtagadáshoz, anyagi veszteséghez, modell-lopáshoz és romló szolgáltatáshoz vezet. A denial of wallet ennek költségközpontú változata: a támadó túlzott mennyiségű műveletet generál, hogy kihasználja a felhőalapú AI-szolgáltatások használat alapú díjazását, és fenntarthatatlan költséget okoz. Ehhez semminek sem kell leállnia; maga a számla a kár.
Az LLM-útvonalak két okból sebezhetőbbek a hagyományos API-útvonalaknál. A kérésenkénti költség változó és nagy: egy hosszú beszélgetést küldő és hosszú választ kérő kérés nagyságrendekkel többe kerülhet, mint egy egysoros kérdés. A kimenet pedig közvetlenül hasznos a támadónak, így egy nyitott chat-végpontot akkor is megéri szkriptből hívni, ha semmi köze a termékedhez.
Milyen visszaélési minták érik a nyilvános LLM-útvonalakat?
Az OWASP-bejegyzés hét példát sorol fel. Egy tipikus Nuxt-funkcióra vetítve ezek néhány mintára szűkülnek, mindegyikhez egy fő védekezéssel:
| Minta | Hogyan néz ki | Fő védekezés |
|---|---|---|
| Potyautas proxy (denial of wallet) | Szkriptek ingyenes modell-API-ként használják az útvonalat; a termékhez nem kapcsolódó promptok | Session, rögzített system prompt, felhasználónkénti tokenkeret |
| Ismételt kérések | Magas kérésszám néhány fiókból vagy IP-ről | Rate limit az edge-en és felhasználónként |
| Változó hosszúságú bemenetek áradata, folyamatos bemenet-túlcsordulás | Hatalmas body, bemásolt dokumentumok, egyre hosszabb előzmények | Body-méretkorlát, sémaellenőrzés, tokenszám-korlát |
| Erőforrás-igényes kérések | Nagyon hosszú kimenet, eszközhurkok, nehéz reasoning | Szerveroldali max_tokens, lépéskorlát, időkorlát |
| Modellkinyerés és funkcionális replikáció | Szisztematikus kérések, amelyek tanítóadatként gyűjtik a kimenetet | Mennyiségi korlát, logprobs nélkül, anomáliafigyelés |
Van egy hatodik minta, amelyet az OWASP nem nevez meg, de minden csapat találkozik vele: a saját magunk okozta fogyasztás. Egy korlát nélküli retry-hurok, egy újra és újra eszközöket hívó ágens vagy egy kliensoldali hiba, amely minden billentyűleütésnél a teljes előzményt elküldi, pontosan úgy égeti a keretet, mint egy támadó. Ugyanezek a korlátok ezt is elkapják.
Hogyan néz ki a többrétegű védelem?
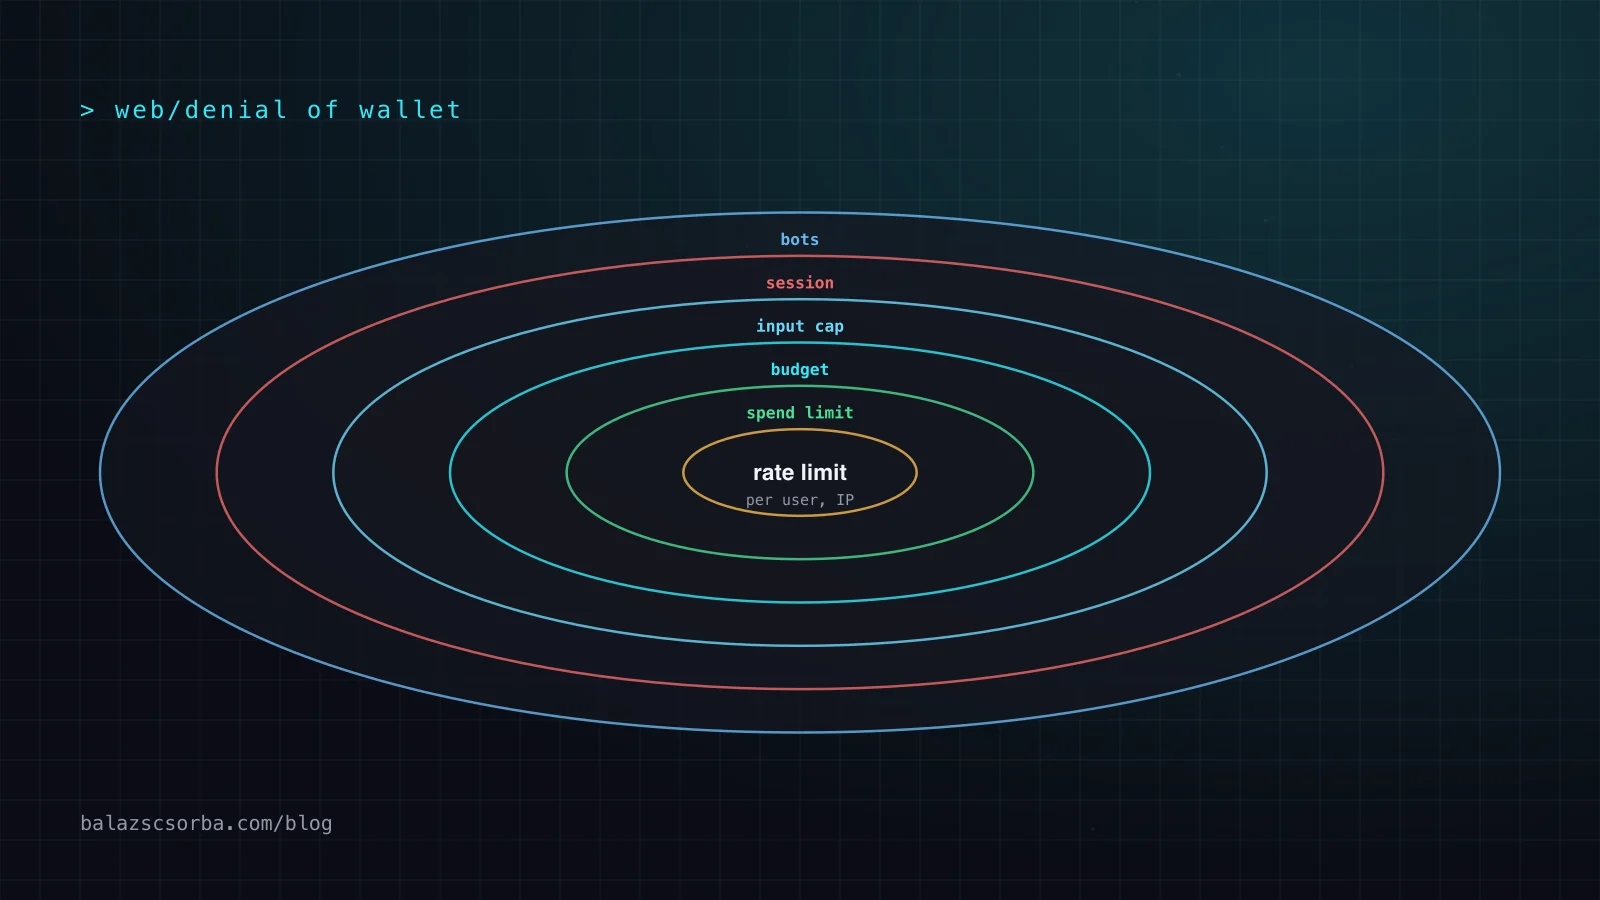
Egyetlen védekezés sem elég, mert mindegyik mást mér. A rate limiter kéréseket számol, a méretkorlát bájtokat, a keret tokeneket, a költéskorlát pedig pénzt. A legolcsóbbtól a legdrágábban kiértékelhetőig rendezem őket, hogy az elutasított forgalom a lehető legkevesebbe kerüljön:
Miért a hitelesítés az első?
Minden más korlátnak szüksége van egy identitásra, amelyhez kötődhet. Session nélkül az egyetlen kulcs az IP-cím, az pedig gyenge. A nuxt-auth-utils esetén a requireUserSession(event) visszaadja a sessiont, vagy 401-gyel válaszol, így a handler első sora eldönti, megtörténhet-e egyáltalán a modellhívás. Ha egy funkciónak bejelentkezés előtt is működnie kell, például egy termékkeresőnek, botellenőrzés után adj ki könnyű, anonim sessiont, és adj neki sokkal kisebb keretet, mint egy bejelentkezett vásárlónak.
A második szabály: soha ne szállíts általános proxyt. Ha a kliens választhatja meg a modellt, a system promptot, a max_tokens értéket vagy az eszközöket, a végpontod egy kerülőúton elérhető nyitott modell-API. A kliens üzenetet küld, legfeljebb egy beszélgetés-azonosítót; minden mást a szerver dönt el. Így az API-kulcs is a szerveren marad, ahogy az LLM-funkciók szállítása Nuxtban cikkben leírtam.
Hogyan korlátozz felhasználónként és IP-nként?
A nuxt-security modul olyan rate limitert ad, amely alapból globálisan be van kapcsolva: IP-nként 150 kérés 300 000 ms alatt, LRU-cache-ben tárolva, túllépéskor 429 Too Many Requests válasszal. Útvonalanként a routeRules segítségével hangolható, tárolóként pedig bármely unstorage-driver használható. A saját dokumentációja őszinte a korlátokról: a beépített rate limiter „nem alkalmas összetett éles alkalmazásokhoz”, és infrastruktúra-szintű megoldásokat ajánl.
Egy LLM-útvonalnál ez három módosítást jelent. Használj közös tárat, mert a memóriabeli LRU-cache példányonként külön él, és minden deploynál nullázódik. A modellútvonalon sokkal szigorúbb korlátot állíts be, mint az oldal többi részén. És határozd meg helyesen a kliens IP-jét: a h3 getRequestIP függvénye csak kifejezett bekapcsolás után olvassa az X-Forwarded-For fejlécet, mert annak bal szélső eleme kliensbemenet; Cloudflare mögött a nuxt-security ipHeader opciója a cf-connecting-ip fejlécre is mutathat.
// nuxt.config.ts (illustrative)
export default defineNuxtConfig({
  modules: ['nuxt-security', 'nuxt-auth-utils'],
  security: {
    rateLimiter: {
      driver: { name: 'redis', options: { url: process.env.REDIS_URL } },
      ipHeader: 'cf-connecting-ip', // only if Cloudflare sits in front
    },
  },
  routeRules: {
    '/api/chat': {
      security: {
        rateLimiter: { tokensPerInterval: 20, interval: 60_000 },
        requestSizeLimiter: { maxRequestSizeInBytes: 32_000 },
      },
    },
  },
})
Ez a limiter IP-alapú. A felhasználónkénti korlát a handlerbe való, a requireUserSession után, a felhasználói azonosítóval mint kulccsal. Hogy ott melyik algoritmus fut, kevésbé fontos, mint hogy következetesen használj egyet; a kompromisszumok az Upstash dokumentációja szerint:
| Algoritmus | Erősség | Gyengeség |
|---|---|---|
| Fix ablak | Tárolásban és számításban nagyon olcsó | Az ablakhatárokon átszivárognak a csúcsok; új ablak kezdetén roham |
| Csúszó ablak | Megoldja a határproblémát | Több tárolás és számítás; közelítés |
| Token bucket | Kisimítja a csúcsokat; nagyobb kezdeti csúcsot enged | Több állapotot kell átlátni |
Az Anthropic saját API-ja token bucketet használ, amely folyamatosan töltődik vissza a korlátig ahelyett, hogy fix időközönként nullázódna; ésszerű minta egy chat-funkcióhoz, ahol a felhasználók hullámokban gépelnek.
Hogyan korlátozd a prompt méretét és a kimenetet?
A kéréskorlát semmit sem mond arról, mennyibe kerül egy-egy kérés. A bemenetet három lépésben korlátozd. Először a bájtokat: a nuxt-security request size limitere a maxRequestSizeInBytes felett 413 Payload Too Large választ ad, az alapérték 2 000 000; egy chatüzenethez néhány kilobájt elég. Aztán a formát: a bodyt a readValidatedBody és egy, az üzenethosszt korlátozó séma segítségével ellenőrizd. Végül a tokeneket: hívás előtt számolj.
A legnagyobb rés általában a beszélgetés előzménye. Ha a kliens minden körben a teljes beszélgetést elküldi, a támadó tetszőleges hosszúságú, kitalált előzményt küldhet. Az előzményt a szerveren tárold, a beszélgetés-azonosítóhoz kötve, és vágd le rögzített számú körre vagy tokenre. Az Anthropic tokenszámláló végpontja ingyenes, saját, az üzenetkészítéstől független rate limitje van, és becslést ad a bemeneti tokenekre, ami egy korláthoz elég.
A kimenetet a szerveren beállított max_tokens korlátozza. Fontos, mit csinál és mit nem: az Anthropic rate limitjeinél a kimeneti tokeneket keletkezésükkor számolják, és a max_tokens nem számít bele a percenkénti kimeneti tokenek számításába. Kérésenkénti költségplafon, nem sebességszabályozás, ezért a következő szakasz kerete továbbra is kell.
// server/api/chat.post.ts (illustrative)
import { z } from 'zod'

const Body = z.object({
  conversationId: z.string().uuid(),
  message: z.string().min(1).max(4000),
})
const MAX_INPUT = 12_000   // tokens, after history trimming
const MAX_OUTPUT = 800     // the server decides, never the client

export default defineEventHandler(async (event) => {
  const { user } = await requireUserSession(event)          // 401 without a session
  const body = await readValidatedBody(event, Body.parse)    // 400 on bad or long input

  const history = await loadHistory(user.id, body.conversationId, { maxTurns: 10 })
  const messages = [...history, { role: 'user', content: body.message }]

  const { input_tokens } = await anthropic.messages.countTokens({ model: MODEL, system: SYSTEM, messages })
  if (input_tokens > MAX_INPUT) throw createError({ statusCode: 413, statusMessage: 'Conversation too long' })

  const reserved = input_tokens + MAX_OUTPUT
  const key = await reserveTokens(user.id, reserved)          // null when the daily budget is spent
  if (!key) throw createError({ statusCode: 429, statusMessage: 'Daily limit reached' })

  let used = 0
  try {
    const res = await anthropic.messages.create({ model: MODEL, system: SYSTEM, messages, max_tokens: MAX_OUTPUT })
    const u = res.usage
    used = u.input_tokens + (u.cache_creation_input_tokens ?? 0) + (u.cache_read_input_tokens ?? 0) + u.output_tokens
    await saveTurn(user.id, body.conversationId, body.message, res.content)
    return res.content
  } finally {
    await settleTokens(key, reserved, used)                   // refund the unused part
  }
})
Hogyan érvényesíts felhasználónkénti tokenkeretet?
A keret az a védekezés, amely ténylegesen korlátozza a költséget: token felhasználónként naponta, vagy anonim sessiononként óránként. Az általam használt minta: foglalás, majd elszámolás. Hívás előtt foglald le a legrosszabb esetet, vagyis a megszámolt bemenetet plusz a max_tokens értéket. Ha a foglalás túllépné a keretet, utasítsd el 429-cel. Hívás után számolj el a válaszban szereplő tényleges felhasználással, és írd vissza a különbözetet. Így ugyanannak a felhasználónak a párhuzamos kérései sem tudnak túlkölteni, mert mindegyik már lefoglalta a részét.
A számlálónak atominak kell lennie. Egy getItem, majd setItem a Nitro-tárban olvasás-módosítás-írás, és két párhuzamos kérés is kiolvashatja a régi értéket. A Redis INCRBY egy lépésben adja vissza az új összeget, így az ellenőrzés és a foglalás nem kerülhet versenyhelyzetbe:
// server/utils/budget.ts (illustrative, ioredis)
const DAILY_TOKENS = 200_000

export async function reserveTokens(userId: string, n: number) {
  const key = `llm:budget:${userId}:${new Date().toISOString().slice(0, 10)}`
  const total = await redis.incrby(key, n)
  if (total === n) await redis.expire(key, 60 * 60 * 48)
  if (total > DAILY_TOKENS) { await redis.decrby(key, n); return null }
  return key
}

export async function settleTokens(key: string, reserved: number, used: number) {
  if (reserved > used) await redis.decrby(key, reserved - used)
}
Elszámoláskor minden bemeneti tokent számolj. Prompt caching mellett az Anthropic input_tokens mezője csak az utolsó cache-töréspont utáni tokeneket tartalmazza; a teljes bemenet cache_read_input_tokens + cache_creation_input_tokens + input_tokens. Hogy a cache-elt tokeneket alacsonyabb árukon súlyozod-e, termékdöntés; egy egyszerű tokenkeretet könnyebb elmagyarázni a felhasználóknak. A cache-elés és a routing költségoldaláról a prompt caching és model routing cikkben írtam.
Hová illik a CAPTCHA és a Turnstile?
A botellenőrzés megdrágítja az automatizálást, de nem korlátozza a költséget. Ott használom, ahol identitás keletkezik, például egy anonim chat-session kiadása előtt, nem minden üzenetnél. A Cloudflare Turnstile esetén a Siteverify API-n keresztüli szerveroldali ellenőrzés kötelező, mert a kliensoldali widget önmagában semmit sem véd: a token hamisítható, minden token 300 másodpercig érvényes, és csak egyszer ellenőrizhető, az újrafelhasználást timeout-or-duplicate hibával utasítja el.
// server/api/session/anonymous.post.ts (illustrative)
export default defineEventHandler(async (event) => {
  const { token } = await readBody<{ token: string }>(event)
  const r = await $fetch<{ success: boolean }>('https://challenges.cloudflare.com/turnstile/v0/siteverify', {
    method: 'POST',
    body: { secret: useRuntimeConfig().turnstileSecret, response: token, remoteip: getRequestIP(event) },
  })
  if (!r.success) throw createError({ statusCode: 403 })
  await setUserSession(event, { user: { id: crypto.randomUUID(), tier: 'anonymous' } })
  return { ok: true }
})Mit fognak meg a szolgáltatói költéskorlátok?
Mindkét nagy szolgáltató lehetővé teszi a havi költés korlátozását, és érdemes azon az összegen alul beállítani, ami már fájna. De ismerd a viselkedését: ezek a korlátok a hatókörükben minden forgalmat leállítanak, minden felhasználónak, amíg a hónap le nem jár, vagy meg nem emeled őket.
| Szempont | Claude API (Anthropic) | OpenAI API |
|---|---|---|
| Saját korlát | Szervezeti spend limit a tier-plafon alatt; saját költés- és rate limit workspace-enként | Hard spend limit szervezetenként vagy projektenként; csak értesítő spend alertek |
| Válasz eléréskor | HTTP 400 invalid_request_error, „You have reached your specified API usage limits” | HTTP 429 organization_spend_limit_exceeded vagy project_spend_limit_exceeded kóddal |
| Beépített plafon | Havi tier-plafon: Start 500, Build 1000, Scale 200 000 USD; 429 enforced_spend_limit_reached, retry-after nélkül | Havi használati korlát usage tierenként |
| Megkötés | Az alapértelmezett workspace-re nem állítható workspace-korlát | „Enforcement is not instantaneous”; a rögzített költés kissé túllépheti a korlátot |
Két gyakorlati következmény. Minden nyilvános funkció kapjon saját Anthropic-workspace-t vagy OpenAI-projektet saját kulccsal és korláttal, hogy egy elszabadult chatbot ne állíthassa le a belső eszközeidet. És kezeld kifejezetten a költéskorlát-válaszokat: az SDK-k automatikusan újrapróbálják a 429-es hibákat, az Anthropic szerint pedig az újrapróbálás a hozzáférés visszaállásáig sikertelen. Fordítsd le barátságos „átmenetileg nem elérhető” állapotra, és riassz valakit.
Mit figyelj és mire riassz?
Az OWASP ajánlásai között szerepel az átfogó naplózás anomáliafelismeréssel és a fokozatos leépülés (graceful degradation). Egy Nuxt-alkalmazásban ez funkciónként néhány mérőszámot jelent, a felhasználói és a beszélgetés-azonosítóval naplózva:
- Token felhasználónként naponta, riasztással, ha a legnagyobb felhasználó messze a medián felett van. A potyautasok itt bukkannak fel először.
- Elutasítások rétegenként: 401, 413 és 429 óránként. Ha hirtelen megnő a keret miatti 429-ek száma, valaki tapogatózik.
- Bemeneti token kérésenként, eloszlásként, nem átlagként. A hosszú farok azt jelzi, hogy túl lazák az előzmény- vagy méretkorlátok.
- Napi költség funkciónként egy alapvonalhoz mérve, a szolgáltatónál beállított spend alerttel jóval a hard limit alatt.
Előbb fokozd le, mint hogy leállítanád. Ha a költés átlép egy küszöböt, először az anonim felhasználókat kapcsold ki, aztán a bejelentkezetteket tedd át kisebb modellre, a fizető ügyfeleknek pedig tartsd életben a funkciót. Ez sokkal jobb hibamód, mint amikor a szolgáltatói korlát egyszerre mindent lekapcsol. A számok mögötti hívások nyomkövetéséről az LLM-ágensek observabilityje cikkben írtam.
Ellenőrzőlista egy nyilvános LLM-útvonalhoz
- Az API-kulcs csak a szerver runtime configjában van; a kliens soha nem látja.
- Az útvonal sessiont követel; anonim session csak szerveroldalon ellenőrzött botszűrés után jár.
- A modell, a system prompt, az eszközök és a
max_tokensa szerveren rögzítettek. - Kéréskorlát IP-nként az edge-en és felhasználónként a handlerben, közös tárban.
- Body-méretkorlát, sémaellenőrzés, szerveroldali előzmény és tokenszám-korlát a hívás előtt.
- Napi tokenkeret felhasználónként, atomi foglalással és elszámolással.
- Korlátos újrapróbálás, eszközlépés és időkorlát, hogy a saját kódod ne kerülhessen hurokba.
- Funkciónként külön szolgáltatói workspace vagy projekt, spend alerttel és hard limittel.
- Riasztás felhasználónkénti tokenkiugrásokra, elutasítási csúcsokra és napi költségre, plusz leépülési terv.
A költséggel való visszaélés a kockázat egyik fele; a másik az, hogy mit kezd a modell az ellenséges bemenettel. Erről a prompt injection elleni védekezés cikkben írtam.
Források
- OWASP GenAI Security Project: LLM10:2025 Unbounded Consumption
- Nuxt Security: Rate Limiter middleware
- Nuxt Security: Request Size Limiter middleware
- nuxt-auth-utils: README (GitHub)
- h3: request utilities (getRequestIP, readValidatedBody)
- Upstash: Ratelimiting algorithms
- Cloudflare Turnstile: Validate the token
- Claude Platform Docs: Rate limits and spend limits
- Claude Platform Docs: Token counting
- OpenAI API Docs: Spend limits
- OpenAI API Docs: Rate limits
Gyakori kérdések
Mi az a denial of wallet?
A denial of wallet olyan támadás egy használat alapján fizetős szolgáltatás ellen, amelynek célja nem a leállás, hanem a költség. Az OWASP az LLM10:2025 Unbounded Consumption példájaként említi: a támadó annyi műveletet generál, hogy a szolgáltató számlája fenntarthatatlanná válik.
Elég a nuxt-security rate limitere egy LLM-végponthoz?
Jó első réteg, de a saját dokumentációja szerint a beépített rate limiter nem alkalmas összetett éles alkalmazásokhoz. Kéréseket számol, nem tokeneket, és az alapértelmezett LRU-cache szerverpéldányonként külön él. Egészítsd ki edge-oldali korláttal és felhasználónkénti tokenkerettel egy közös tárban, például Redisben.
IP vagy felhasználó szerint korlátozzak?
Mindkettő szerint. Az IP-korlát a bejelentkezés előtt is elérhető útvonalakat védi, és tompítja az egyszerű elárasztást. A költség szempontjából a felhasználónkénti korlát számít, mert sok jóhiszemű felhasználó osztozhat egy IP-n, egy támadó pedig sok IP-t váltogathat.
Hogyan korlátozzam a promptok hosszát?
Korlátozd a request body méretét, ellenőrizd az üzenet hosszát sémával, a beszélgetés előzményét a szerveren tárold ahelyett, hogy a klienstől fogadnád el, és a modellhívás előtt ellenőrizd a tokenszámot. A kimenetet a szerveren beállított max_tokens korlátozza.
Megvédenek a szolgáltatói költéskorlátok a visszaéléstől?
Csak végső esetben. Az OpenAI hard limitje és az Anthropic spend limitje elérésekor leállítja a szervezet, projekt vagy workspace teljes forgalmát, így a támadó mindenkinek megbénítja a funkciót. Az OpenAI azt is jelzi, hogy a betartatás nem azonnali, és a költés kissé túllépheti a korlátot.