Blog/LLMOps és értékelés
LLM-ügynökök megfigyelhetősége OpenTelemetryvel: trace-ek, tokenek, PII és eval
Így trace-eld az LLM-ügynököket OpenTelemetryvel: GenAI semantic conventions és státuszuk, span-fa, token-metrikák, sampling, PII, eval és eszközök.
Balázs Csorba··12 perc olvasás
- OpenTelemetry
- LLM observability
- AI agents
- Tracing
- Evals
A lényeg röviden
- Az OpenTelemetry GenAI semantic conventions külön repóba költözött, és továbbra is Development státuszú, ezért rögzítsd a verziókat, és számíts attribútum-átnevezésekre.
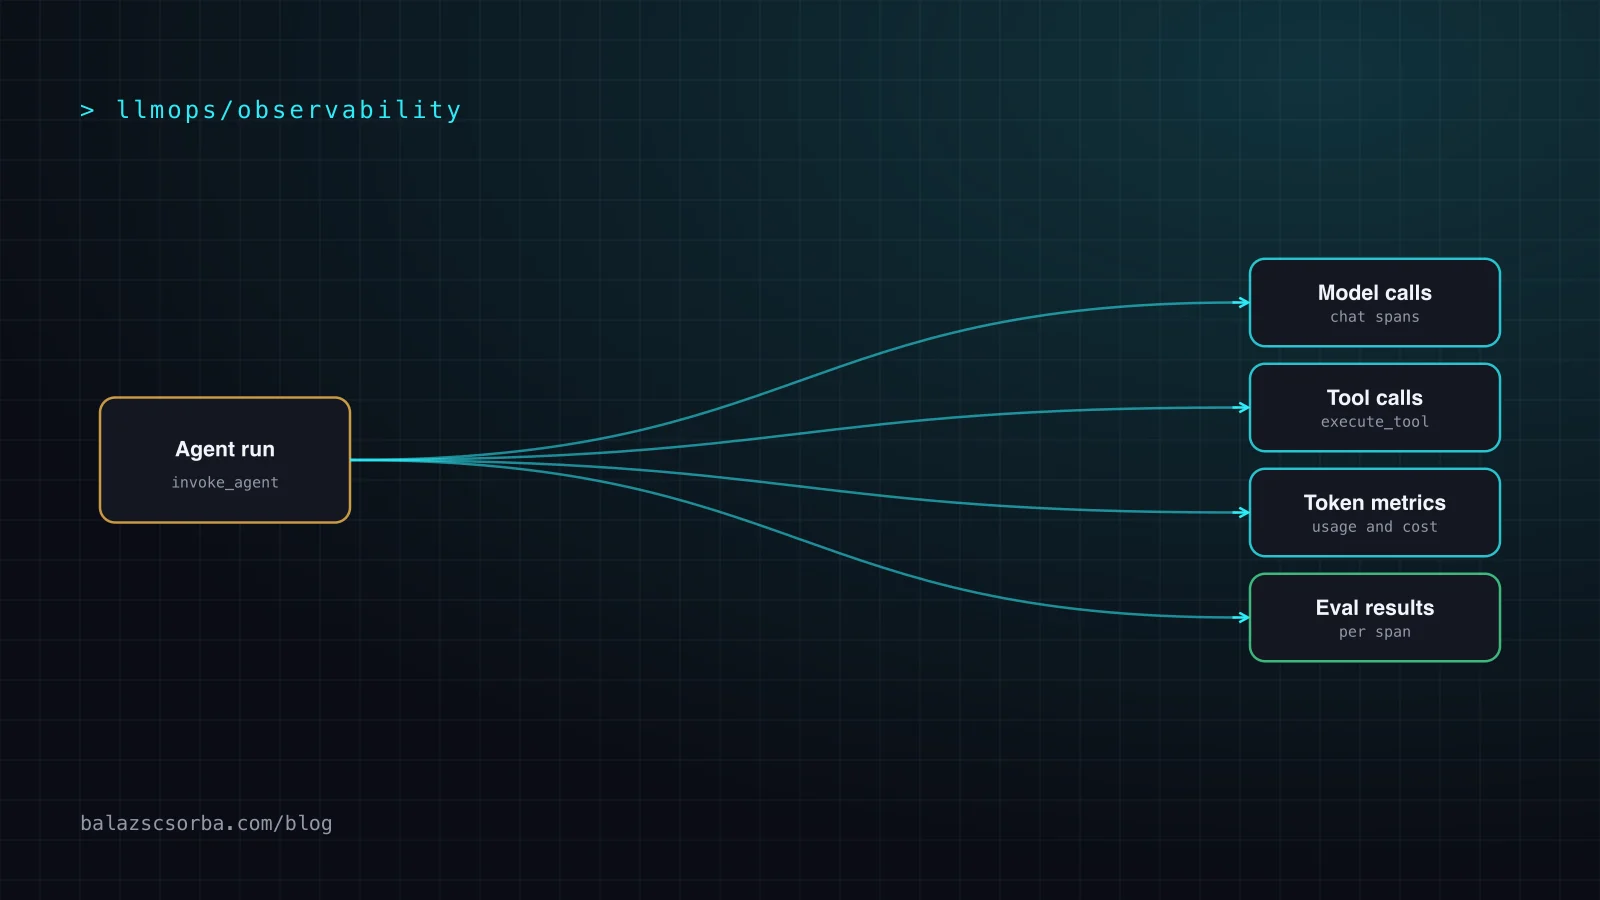
- Egy ügynökfuttatás legyen egy trace: egy invoke_agent gyökér-span, minden modellhíváshoz egy chat span, minden eszközhíváshoz egy execute_tool span. Ettől a fától válnak láthatóvá a ciklusok és a felesleges lépések.
- Minden spanen rögzítsd a token-számokat, a modellt, a finish reasont és a hibatípust, de a promptokat, az eszköz-argumentumokat és az eredményeket alapból hagyd ki (a conventions szerint opt-in), és ha kellenek, tárold őket külön.
- Eredmény alapján mintavételezz, ne érmefeldobással: tarts meg minden hibát, minden lassú vagy drága futást és minden megbukott evalt, a többiből pedig egy kis részt. Ne feledd, hogy az eval általában a trace után készül el.
- Bármely OTLP-backend fogadhat ügynök-trace-eket, az igazi különbség az, mennyire érti a gen_ai attribútumokat, hol fut és mennyibe kerül. Indulj a szabványból, és tartsd cserélhetően az exportert.
Egy klasszikus webes kérés egy hívás, egy válasz, és ha elromlik, egy stack trace. Az ügynökfuttatás egy kis program, amelyet a modell menet közben ír: tervez, hív egy eszközt, elolvassa az eredményt, újra hívja a modellt, újrapróbál, és néha ciklusban forog, amíg el nem fogy a keret. Ha egy ilyen futás négyszer annyiba kerül a kelleténél, vagy csendben rossz választ ad, a logok szétszórt sorokat mutatnak, nem a történés alakját.
A „mi történt, milyen sorrendben, és mennyi ideig tartott az egyes rész” kérdésre a distributed tracing már most is a megfelelő eszköz. Az OpenTelemetry (OTel) a gyártófüggetlen módja a trace-ek előállításának, és mostanra saját GenAI semantic conventions készletet kapott. Fiatalok, még Development jelölésűek, és épp most költöztek, ezért ez a cikk legalább annyira arról szól, mit érdemes verzióhoz kötni és mit becsomagolni, mint arról, mit érdemes rögzíteni a telemetriában.
Végigmegyek a conventions valós státuszán, egy ügynökfuttatás span-fáján, azon, hogy mi kerüljön az egyes spanekre, a token- és költségmetrikákon, a samplingen, a PII-n, az evalokhoz való kapcsolaton, és azon, hogyan illeszkednek a gyakori backendek. A végén ellenőrzőlista van. Feltételezem, hogy tudod, mi az az agent loop.
Miért kellenek az ügynököknek trace-ek, nem csak logok
Az ügynökök három hibamintája trace nélkül szinte láthatatlan. Ciklusok és felesleges lépések: a modell ötször hívja ugyanazt a kereső eszközt kissé eltérő argumentumokkal. Csendes romlás: egy retrieval lépés semmit sem ad vissza, a modell emlékezetből válaszol, és a kimenet hihetőnek tűnik. Költségsodródás: egy prompt-módosítás vagy egy nagyobb eszközeredmény felfújja a kontextust, és a futás minden későbbi modellhívása drágább lesz.
Mindhárom egy egész futás tulajdonsága, nem egyetlen hívásé. A trace fa alakban adja a futást, csomópontonként idővel, token-számokkal és kimenettel, és lehetővé teszi a lényeges kérdéseket: hány modellhívás jut egy kérésre p95-ön, melyik eszköz hibázik a legtöbbet, melyik lépés viszi a késleltetést. Ha csak logolsz, korrelációs azonosítókból építesz egy rosszabb tracing rendszert.
A GenAI semantic conventions: mi van, és mennyire stabil
A semantic conventions az attribútumok, spanek és metrikák megegyezett nevei, hogy egy backend bármelyik könyvtár telemetriáját megértse. A GenAI-hoz lefedik a modell-spanokat (inference, embeddings, retrieval, memory), az ügynök-spanokat (create_agent, invoke_agent, invoke_workflow, plan), az eszközvégrehajtást, a metrikákat, az eseményeket és egy MCP-konvenciót. Provider-specifikus oldalak vannak az Anthropichoz, az OpenAI-hoz, az AWS Bedrockhoz és az Azure AI Inference-hez.
Két tény számít, mielőtt rájuk építesz. Először: a conventions elköltöztek, az opentelemetry.io oldala már csak átirányít a külön open-telemetry/semantic-conventions-genai repóra. Másodszor: nem stabilak. Az áttekintő oldal Development státuszt visel, és a független forrás, amelyet használtam, 2026. júliusi állapot szerint egyetlen GenAI-specifikus attribútumot, spant, metrikát vagy eseményt sem talált Stable jelöléssel (csak a közös attribútumok, például az error.type azok). Számíts rá, hogy a nevek változnak a kiadások között.
Gyakorlatban ez egy verziókapcsoló. Azok az instrumentációk, amelyek a régebbi conventions-t támogatták, alapból a befagyasztott 1.36-os kori kimenetet adják, és az újabb alakhoz az OTEL_SEMCONV_STABILITY_OPT_IN=gen_ai_latest_experimental beállítás kell. Nem minden framework kezeli egyformán ezt a változót, ezért ne a dokumentációban bízz, hanem nézz meg egy valódi exportált spant. A Datadog például az 1.37-es vagy újabb alakot várja.
A trace-fa: egy futás, egy trace
A conventions definiálja a szükséges span-fajtákat. A gyökér egy invoke_agent span (INTERNAL kind egy folyamaton belüli ügynöknél, CLIENT egy távoli ügynökszolgáltatásnál). Alatta modellhívásonként egy chat span (a művelet és a kért modell nevével, CLIENT kind), eszközhívásonként egy execute_tool span (INTERNAL), és ha az ügynöködnek külön tervezési fázisa van, egy plan span. Az ügynökök körüli többlépéses pipeline használhat invoke_workflow spant. A retrievalnek saját spanje van, az adatforrás nevével.
Két részletet érdemes átvenni. A modellhívás span-neve a művelet és a modell, például a chat plusz a modell neve, ami alacsonyan tartja a kardinalitást és olvashatóvá teszi a vízesés-nézetet. A conventions pedig kifejezetten arra biztat, hogy a saját eszközeidet kézzel instrumentáld execute_tool spanekkel, mert egy automatikus instrumentáció nem ismerheti a kódodban futó eszközöket. Az MCP-szervereket hívó eszközöknél az MCP-konvenció a kérés metaadataiban viheti a trace-kontextust (traceparent, tracestate és baggage), így a szerveroldal ugyanabba a trace-be kerül. Hogy miért fontos ez a szerveroldali kép, azt az MCP-eszköztervezési tanulságok cikk mutatja.
Még egy pont az alakról: egy újrapróbált modellhívás egyetlen span legyen, amely az összes újrapróbálkozást lefedi, ne több, mert a convention a spant a hívó szemszögéből látott logikai műveletként definiálja. Ha látni akarod az újrapróbálkozásokat, rögzítsd őket eseményként vagy attribútumként ezen a spanen.
Mit rögzíts az egyes spanekre
A szabvány megmondja, mi érhető el, azt nem, mi éri meg a tárhelyet. Ezzel a készlettel indulnék. A második oszlop nevei a conventions-ből valók, hacsak nincs jelölve, hogy saját (custom).
| Egység | Beállítandó attribútumok | Miért éri meg |
|---|---|---|
| Ügynökfuttatás (invoke_agent) | gen_ai.agent.name, gen_ai.agent.version, gen_ai.conversation.id, error.type, saját: release, tenant, végeredmény | Futások csoportosítása ügynökverzió és session szerint, release-ek összevetése, az átadással vagy hibával végződő futások megtalálása |
| Modellhívás (chat) | gen_ai.operation.name, gen_ai.provider.name, gen_ai.request.model, gen_ai.response.model, gen_ai.response.finish_reasons, gen_ai.usage.input_tokens, gen_ai.usage.output_tokens, cache-olvasási és reasoning token-számok, error.type | Hívásonkénti költség, csonkolás (finish reason length), cache-találati arány, modell-fallbackek, mely provider-hibák dominálnak |
| Kérésbeállítások | gen_ai.request.temperature, gen_ai.request.max_tokens, gen_ai.request.reasoning.level, gen_ai.prompt.name, gen_ai.prompt.version | Viselkedésváltozások magyarázata, a minőség egy prompt-verzióhoz kötése |
| Eszközhívás (execute_tool) | gen_ai.tool.name, gen_ai.tool.call.id, gen_ai.tool.type, error.type, saját: olvasó vagy író, jóváhagyás megtörtént | Eszközönkénti hibaarány és késleltetés, az író műveletek és jóváhagyóik megtalálása |
| Retrieval | gen_ai.data_source.id, saját: top-k, találatok száma, dokumentumazonosítók tartalom nélkül | Az üres vagy gyenge retrieval észrevétele, mielőtt a modell egy gördülékeny válasz mögé rejtené |
| Tartalom | gen_ai.system_instructions, gen_ai.input.messages, gen_ai.output.messages, gen_ai.tool.call.arguments, gen_ai.tool.call.result (mind opt-in) | Hibakeresés és tesztesetek, adatvédelmi és tárhelyköltség árán (lásd a PII szakaszt) |
| Értékelés | gen_ai.evaluation.name, gen_ai.evaluation.score.value, gen_ai.evaluation.score.label, gen_ai.evaluation.explanation | Minőségi jelzés pontosan azon a spanen, amelyet értékel |
Azokat az attribútumokat, amelyekre egy samplernek szüksége lehet, a span létrehozásakor állítsd be. A conventions a gen_ai.operation.name, gen_ai.provider.name, gen_ai.request.model attribútumot és a szervercímet (ügynök-spanoknál a gen_ai.agent.name-et is) említi olyanként, amelynek létrehozáskor rendelkezésre KELL állnia, mert egy head sampler nem látja a később hozzáadottakat.
Token- és költségmetrikák
A spanek futásonkénti részletet adnak, a metrikák olcsó, hosszú életű trendeket. A conventions kategóriánként (input, output, cache read, cache write, reasoning) definiál token usage számlálókat, modalitás szerint bontva, és a fogyasztás elsődleges műszereinek, illetve a költség közelítésének nevezi őket. Mellettük hisztogramok vannak a műveletenkénti token-eloszlásra, p95 és p99 kiugrók keresésére szánva, és kifejezetten nem összegekre vagy költségre. Az ügynökökhöz van hisztogram az invokáció időtartamára, az invokációnkénti inference-hívások és eszközhívások számára, valamint egy eszközvégrehajtási időtartam. Az utolsó kettőt tenném fel először a dashboardra: a ciklust megmutatják, mielőtt a számla megtenné.
Figyelj a számtanra. Az input token-szám a cache-elt tokeneket is TARTALMAZZA, a cache read, cache write és reasoning számok pedig az input és output összegek részhalmazai. Ha külön tételként összeadod őket, duplán számolsz. A conventions emellett nem definiál ár- vagy költségattribútumot, a költséget tehát te számolod: a token-kategóriák szorozva egy válaszmodell szerinti árlistával, a backendben vagy egy pipeline-lépésben, és verziózd az árlistát. Hogy mit tegyél, ha már látod a számokat, azt az LLM költség, késleltetés és prompt caching cikk tárgyalja.
A metrika-dimenziók maradjanak alacsony kardinalitásúak: modell, provider, ügynöknév, művelet, kimenet. A felhasználó- vagy beszélgetésazonosító spanre való, nem metrikára, különben a metrikaszámlád a felhasználóbázissal együtt nő.
Sampling: az érdekes futásokat tartsd meg
Az ügynök-trace-ek nagyobbak a szokásos webes trace-eknél, tartalomrögzítéssel pedig sokkal nagyobbak lehetnek. Mintavételezni fogsz. Az OpenTelemetry megkülönbözti a head samplinget (a döntés a trace elején születik, például trace-azonosító szerinti fix százalék) és a tail samplinget (a döntés azután születik, hogy az összes vagy a legtöbb span ismert, így a hibás vagy nagy késleltetésű trace-eket mindig megtarthatod). A dokumentáció őszinte a költségről: a tail sampling nehezebben valósítható meg és üzemeltethető, és a döntést hozó komponensnek állapottartónak kell lennie.
Ügynökökhöz egy egyszerű szabályrendszert használnék, a százalékokat pedig kiindulópontnak tekinteném, amit finomhangolni kell:
- 100%-ot tarts meg a hibás, időtúllépéses, emberi átadással végződő vagy felhasználói panasszal jelzett futásokból.
- 100%-ot tarts meg a költségben, időtartamban vagy modellhívás-számban a megszokott fölött messze járó futásokból. Ezek a ciklusaid.
- 100%-ot tarts meg a megbukott evalú futásokból és a canary release futásaiból.
- Egy kis részt mintavételezz, mondjuk 5-10 százalékot, a többiből, hogy legyen reprezentatív alapvonalad.
- Ne mintavételezett trace-ekből számolj arányokat. Az arányokat és riasztásokat metrikákból (a fent említett időtartam-, token- és eszközhívás-műszerekből) számold, ne a mintavételezett trace-ek számolásából.
Két ügynök-specifikus csapda. Egy futás percekig tarthat, ezért a tail samplernek elég sokáig kell várnia a döntéssel, és közben a futás minden spanjét memóriában kell tartania. Az eval pontszám pedig általában azután érkezik, hogy a trace lezárult és exportálódott, így nem tudja irányítani a tail döntést, hacsak nem inline értékelsz. Ha azt akarod, hogy a megbukott evalok túléljék a mintavételezést, vagy futtass minden futásra egy olcsó inline ellenőrzést, vagy csatold később a pontszámot, és gondoskodj róla, hogy a megjelölt futások kimintázott trace-e még elérhető legyen.
PII és érzékeny tartalom a trace-ekben
A promptok, az eszköz-argumentumok és az eszközeredmények azt tartalmazzák, amit a felhasználóid és a rendszereid: neveket, e-mail-címeket, rendelésszámokat, szerződésszövegeket, néha titkokat. A conventions egyértelműen állást foglal. Az utasítások, bemenetek és kimenetek érzékenynek és gyakran nagynak számítanak, ezért az instrumentációk alapból NEM rögzíthetik őket, és opt-int kell kínálniuk. Három mintát írnak le: semmit sem rögzíteni (ez az alapértelmezés), a tartalmat span-attribútumokban rögzíteni, vagy a tartalmat külön tárolni, és a spanekre csak hivatkozást tenni. Ez utóbbi az ajánlott minta élesben, mert a külső tárnak saját hozzáférés-szabályozása van.
Ebből gyakorlati felállás következik:
- Éles alapértelmezés: csak metaadat. Modell, tokenek, finish reason, eszköznevek, hibatípusok, azonosítók. Meglepően sok hibakeresés megoldható ezzel.
- Élesítés előtt és tesztekben: teljes tartalom a spanekre, mert nincs valódi személyes adat, és maximális átláthatóságot akarsz.
- Tartalom élesben: csak a külső tárolós mintán át, egy mintavételezett vagy megjelölt részhalmazra, rövid megőrzéssel és csak azoknak elérhetően, akiknek kell. A conventions megengedi a folyamaton belüli hookot, amely rögzítés előtt módosíthatja vagy kitakarhatja a tartalmat, és ez a hook a sampling-döntéstől függetlenül lefut.
- Exportálás előtt takarj ki, ne a backendben. A telemetria-pipeline egy feldolgozó lépése vagy egy folyamaton belüli hook eltávolíthat mintákat, például e-mail-címeket és kártyaszámokat. Ne a szolgáltatóra bízd, miután az adat elhagyta a hálózatodat.
- Használj pszeudonim azonosítókat a felhasználókhoz és beszélgetésekhez, soha nyers e-mail-címet vagy nevet, hogy meg tudj találni egy futást anélkül, hogy a trace személyes adatok nyilvántartásává válna.
Az eszköz-argumentumok külön figyelmet érdemelnek, mert gyakran a futás leginkább azonosító része, és könnyű megfeledkezni róluk. Ha a trace-eid elhagyják az EU-t, vagy egy amerikai szolgáltatóhoz kerülnek, ugyanazok a szabályok érvényesek, mint magára a modell-API-ra, lásd a GDPR és az LLM API-k cikket. A trace-ekben lévő prompt-tartalom emellett prompt injection forrás is: egy megbízhatatlan modellkimenetet megjelenítő trace-néző célpont, ez is ok a szoros hozzáférés-szabályozásra.
Trace-ek összekötése evalokkal
A trace megmondja, mi történt, az eval megmondja, hogy jó volt-e. Együtt a leghasznosabbak. A conventions definiál egy gen_ai.evaluation.result eseményt az értékelés nevével, pontszámmal, olvasható címkével, magyarázattal és a válaszazonosítóval, és azt mondja, hogy az értékelt GenAI-művelet span alá KELL tartoznia, vagy ha nincs span, a válaszazonosítót kell hordoznia. Egy utólag futó LLM-bíró vagy szabályalapú ellenőrzés így közvetlenül az értékelt csomópontra írhatja az ítéletét.
Három módon használom ezt az összekötést. Offline: az eval-adathalmazt ugyanazon az instrumentált ügynökön futtatom, a trace-eket futás- vagy release-azonosítóval (saját attribútum) címkézem, és egy helyen hasonlítom össze a költséget, a lépésszámot és a pontszámot release-enként. Online: az éles futások egy mintáját pontozom, és riasztok az eső sikerességi arányra, a megbukott trace-ekkel egy kattintásra. Visszacsatolás: ha egy éles trace megbukik, a bemenetét (és az elvárt viselkedést) átmásolom a tesztkészletbe, ehhez rögzített tartalom kell, ezért a megjelölt futásokra a külső tárolós mintát használom. Magukat az evalokat az LLM eval termékfunkciókhoz cikk tárgyalja.
Eszközök
Az OTLP szép tulajdonsága, hogy a backend választása a végére marad. Amit a szolgáltatók saját dokumentációjában ellenőriztem:
| Eszköz | Hogyan fogad OpenTelemetryt | Jó tudni |
|---|---|---|
| Langfuse | OTLP-végpont a /api/public/otel címen basic authtal, HTTP/JSON és HTTP/protobuf, gRPC nincs. Leképezi a gen_ai attribútumokat, az OpenInference-et és a saját langfuse attribútumait | LLM-specifikus funkciók a tetejére (prompt-kapcsolás, scoring, költségkövetés), saját szerveren futtatható. A repó MIT licencű, kivéve az ee könyvtárakat, amelyek külön licenc alatt vannak |
| Arize Phoenix | OpenTelemetryre épül, az OpenInference konvenciókat használja, amelyek az OTel-t egészítik ki, helyi kollektor a /v1/traces címen | Nyílt forráskódú és saját üzemeltetésű, Elastic License 2.0 alatt. Az Arize AX a menedzselt változat, erős kísérletekhez és evalokhoz |
| Datadog LLM Observability | OTLP HTTP/protobuf felett dd-api-key fejléccel, az OpenTelemetry 1.37 vagy újabb gen_ai alakot várja | A gen_ai attribútum nélküli spanokat eldobja, a dokumentáció szerint néhány percbe telik, mire a trace-ek megjelennek. A legjobb, ha már Datadogon vagy |
| Honeycomb | OTLP gRPC, HTTP/protobuf és HTTP/JSON felett, API-kulcs fejléccel és EU-végponttal | Általános trace-backend: az általam olvasott ingest-dokumentáció nem említ GenAI-specifikusat, a nézeteket magad építed |
Az ajánlásom: instrumentálj OpenTelemetryvel és egy saját vékony segédréteggel, exportálj egy általad irányított pipeline-lépésen át, például egy OpenTelemetry Collectoron (kézenfekvő hely a kitakarásnak, a samplingnek és a költség-dúsításnak), a backendet pedig a hosztolási modell és az alapján válaszd, mit üzemeltet már a csapatod. Ha az adatrezidencia számít, egy saját üzemeltetésű Langfuse vagy Phoenix védhető meg a legkönnyebben. Ha már fizetsz egy általános observability platformért, nézd meg, mennyire jól jeleníti meg a gen_ai spanokat, mielőtt újabb eszközt adsz hozzá. Más szolgáltatókat, például a Grafana-stacket, nem ellenőriztem, és szándékosan kihagyom.
Ellenőrzőlista az első sprintre
Ebben a sorrendben haladnék:
- Válaszd ki az OTLP-backendet, és tegyél közé egy általad irányított pipeline-lépést. A kitakarást és a samplinget ott végezd.
- Telepítsd az instrumentációt a providerhez vagy a frameworkhöz, rögzítsd a verzióját, és vess össze egy valódi exportált spant a conventions-szel (az OTEL_SEMCONV_STABILITY_OPT_IN változóval együtt).
- Adj futásonként egy invoke_agent gyökér-spant, a saját eszközeidhez pedig kézi execute_tool spanokat.
- Minden modell-spanen állítsd be a modellt, a providert, a token-használatot, a finish reasont és a hibatípust, és add hozzá az ügynökverziót, a release-t és egy pszeudonim beszélgetésazonosítót.
- Élesben kapcsold ki a tartalomrögzítést, élesítés előtt kapcsold be. Döntsd el a külső tárolós utat a megjelölt futásokra.
- Építs három dashboardot: modell- és eszközhívások futásonként (p50, p95), tokenek és számolt költség ügynökverziónként, hiba- és időtúllépési arány eszközönként.
- Add hozzá a sampling-szabályt: minden hiba, kiugró érték és megbukott eval, a többiből egy kis rész.
- Írd az eval-eredményeket gen_ai.evaluation.result eseményként az értékelt spanekre, és táplálj vissza megbukott trace-eket a tesztkészletbe.
- Adj hozzá egy golden-file tesztet, amely elbukik, ha az instrumentáció kimenetének alakja megváltozik.
Ha harness-szel dolgozol, ugyanez az instrumentáció ott is megtérül, lásd a harness engineering kódoló ügynököknek cikket.
Hol nem fektetnék még sokat
Ne építs mély, egyedi analitikát egy Development státuszú szabvány pontos attribútumneveire. A fogalmakra építs: spanek fája token-számokkal, kimenetekkel és pontszámokkal, a fogalom és az attribútumnév közötti leképezést pedig tartsd egy helyen. A conventions tovább fog mozogni, a backendek pedig felzárkóznak. Az a csapat, amely minden futást trace-el, és meg tudja válaszolni, hogy „mit csinált ez a futás és mibe került”, előrébb jár annál, amely arra vár, hogy a szabvány megszilárduljon.
Források
- OpenTelemetry: GenAI semantic conventions repository (open-telemetry/semantic-conventions-genai)
- GenAI conventions: overview (status Development)
- GenAI conventions: model spans, execute_tool and content capture
- GenAI conventions: agent spans
- GenAI conventions: metrics
- GenAI conventions: inference token metrics
- GenAI conventions: events (gen_ai.evaluation.result)
- GenAI conventions: Model Context Protocol
- OpenTelemetry docs: GenAI conventions moved notice
- OpenTelemetry docs: Sampling
- John Hodge: The state of the OpenTelemetry GenAI semantic conventions (July 2026)
- Langfuse docs: OpenTelemetry integration
- Langfuse repository and licence
- Arize Phoenix repository
- Arize OpenInference repository
- Datadog docs: OpenTelemetry instrumentation for LLM Observability
- Honeycomb docs: Send data with OpenTelemetry
Gyakori kérdések
Mik az OpenTelemetry GenAI semantic conventions?
A generatív AI munkaterhelések szabványos attribútum-, span-, metrika- és eseménynevei: gen_ai.operation.name, gen_ai.request.model, gen_ai.usage.input_tokens, execute_tool és invoke_agent spanok és még sok más. 2026 októberében az open-telemetry/semantic-conventions-genai repóban karbantartják őket, és minden GenAI-specifikus elem továbbra is Development jelölésű, nem Stable.
Hogyan trace-eljek egy LLM-ügynököt OpenTelemetryvel?
Futtatásonként hozz létre egy trace-t. A futtatást fogd be egy invoke_agent spanba, minden modellhívást egy chat spanba, minden eszközhívást egy execute_tool spanba, és állítsd be a gen_ai attribútumokat a modellre, a token-használatra, a finish reasonra és a hibákra. Használj instrumentációs könyvtárat a providerhez vagy a frameworkhöz, a saját eszközökhöz adj kézi spanokat, és OTLP-n exportálj.
Naplózzam a promptokat és a válaszokat a trace-ekben?
Alapból ne. A conventions az utasításokat, bemeneteket és kimeneteket érzékenynek és nagynak tekinti, azt várja az instrumentációktól, hogy opt-in nélkül ne rögzítsék őket, élesben pedig a tartalom külső tárolását javasolja, a spanen csak hivatkozással. A teljes tartalmat élesítés előtt, vagy egy mintavételezett, hozzáférés-korlátozott részhalmazra rögzítsd.
Hogyan követem az LLM token-használatot és költséget OpenTelemetryvel?
Minden inference spanen rögzítsd a gen_ai.usage.input_tokens és gen_ai.usage.output_tokens értékét, a dashboardokhoz pedig használd a token usage számlálókat. A conventions token-számokat definiál, árakat nem, így a költséget te számolod a backendben vagy a pipeline-ban, a válaszmodell szerinti árlistából. A cache-elt és a reasoning tokenek az input és output összegek részhalmazai.
Melyik a legjobb LLM-observability eszköz: Langfuse, Phoenix, Datadog vagy Honeycomb?
Attól függ, mit üzemeltetsz már. A Langfuse és az Arize Phoenix LLM-központú és saját szerveren is futtatható, a Datadog LLM Observability a már Datadogot használó csapatoknak illik, és OpenTelemetry 1.37-től várja a gen_ai attribútumokat, a Honeycomb pedig általános OTLP trace-backend. Előbb instrumentálj OpenTelemetryvel, akkor a backend cserélhető döntés marad.
Hogyan kapcsoljam össze a trace-eket az evalokkal?
Az eval-eredményt azon a spanen helyezd el, amelyet értékel. A GenAI conventions definiál egy gen_ai.evaluation.result eseményt névvel, pontszámmal, címkével és magyarázattal, amelynek az értékelt span alá kell tartoznia. Az offline evalokat ugyanazon az instrumentált kódon futtasd, a megbukott éles trace-ekből pedig csinálj új teszteseteket.