Blog/LLMOps és értékelés
Claude Opus 5.5 az Artificial Analysis élén, de az igazi hír a medium effort
A Claude Opus 5.5 58 pontot ér el az Artificial Analysis Intelligence Indexen, öt ponttal a többiek előtt. A nagyobb hír, mit hoz feladatonként a medium effort.
Balázs Csorba··8 perc olvasás
- Claude Opus 5.5
- Artificial Analysis
- LLM benchmarks
- LLM cost
A lényeg röviden
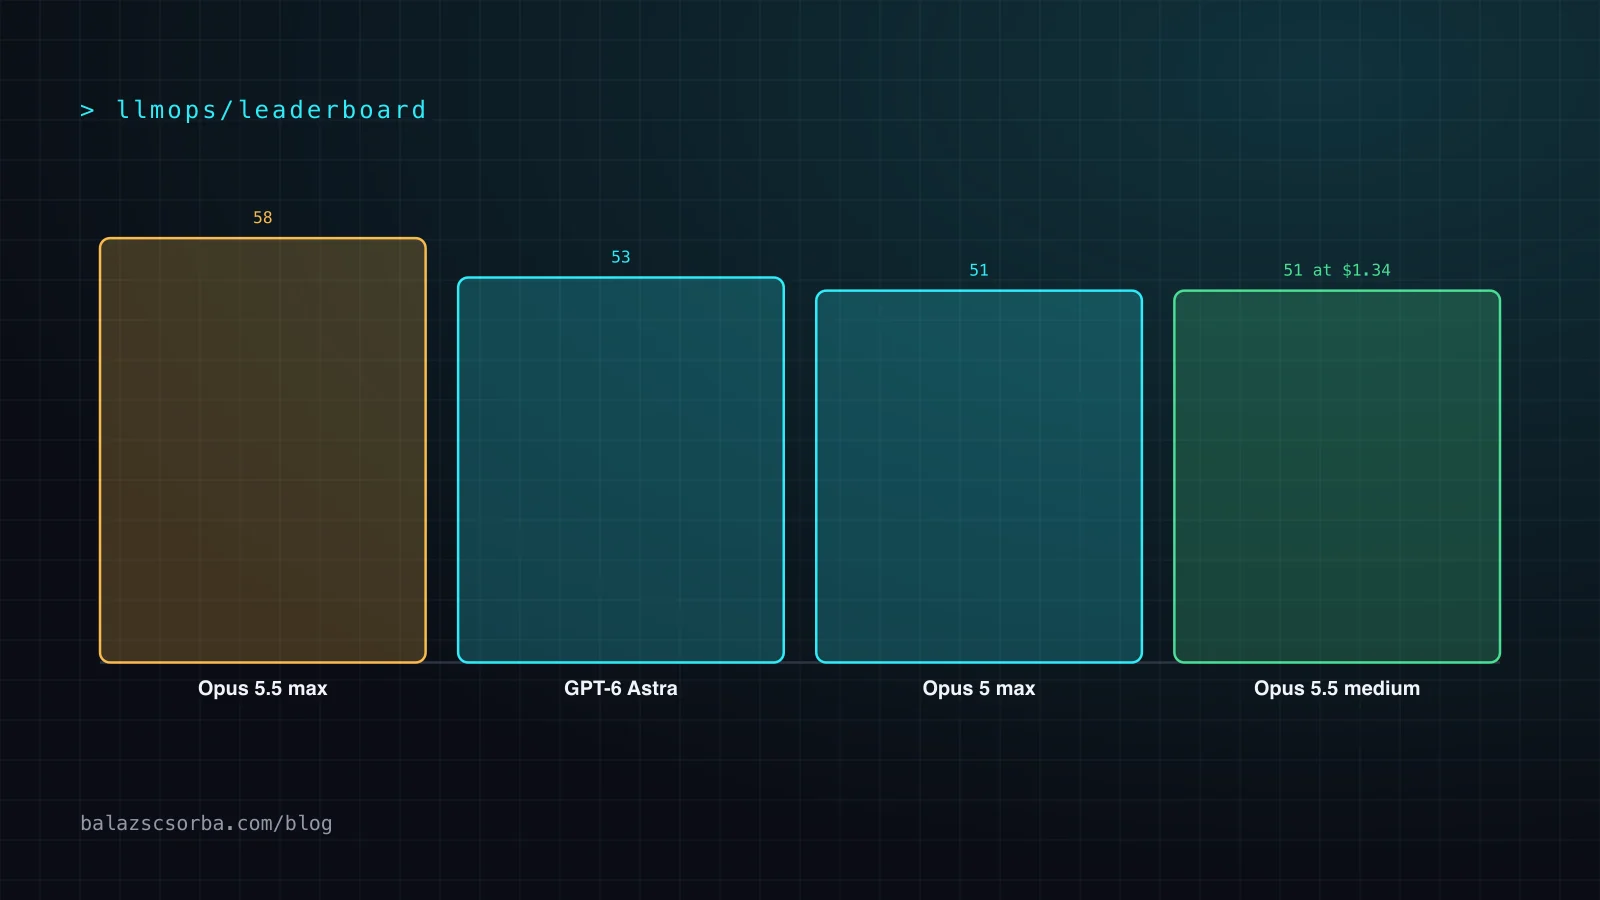
- A Claude Opus 5.5 max effort mellett 58 pontot ér el az Artificial Analysis Intelligence Index v4.3.2-n: 211 modellből az első, öt ponttal az 53 pontos GPT-6 Astra és Claude Fable 5.1 előtt.
- Medium effort mellett az Opus 5.5 51 pontot ér el, ugyanannyit, mint az Opus 5 max effort mellett, de 5,86 dollár helyett feladatonként 1,34 dollárért: azonos pontszám nagyjából 77%-kal olcsóbban.
- Az öt effort-szintből négy rajta van az Artificial Analysis intelligencia–feladatonkénti költség hatékonysági határán.
- A buktató a bőbeszédűség és a késleltetés: max effort mellett feladatonként körülbelül 119 000 output token, és a közölt, első tokenig eltelt idő 682,71 másodperc, szemben a medium 13,20 másodpercével.
- Az árak millió tokenenként 4 és 20 dollárra csökkentek, a cache-olvasás 60%-kal, 0,20 dollárra, így éles környezetben a medium effort és egy gecachelt prefix az ésszerű alapértelmezés.
A Claude Opus 5.5 az új első helyezett az Artificial Analysis ranglistáján, és nem is hajszállal. Maximális effort-szinten 58 pontot ér el az Artificial Analysis Intelligence Indexen, öt ponttal a következő modellek előtt, és ez a legmagasabb pontszám, amit az index valaha mért. Ezt a főcímet valószínűleg már láttad.
Nem ez az érdekes rész. Az érdekes rész ugyanazon az oldalon, lejjebb van: medium effort mellett az Opus 5.5 pontosan annyi pontot szerez, amennyit az előző generáció zászlóshajója maximális effort mellett, a feladatonkénti költség kevesebb mint negyedéért. Ez a cikk végigmegy a ranglistán, a benchmarkonkénti számokon, a hatékonysági adatokon és a buktatón, mindezt az Artificial Analysis 2026. szeptember 28-i adatai szerint, és azzal zárul, mit változtatnék ezek alapján egy éles rendszerben.
Mit mér az Artificial Analysis Intelligence Index
Az Artificial Analysis független benchmarkcég: ugyanazokat az értékeléseket futtatja minden jelentős modellen, és egymás mellett közli az intelligenciát, a sebességet és az árat. Az Intelligence Index egyetlen összetett szám. A 4.3.2-es verzió tíz értékelést von össze: AA-Briefcase, GDPval-AA, AutomationBench-AA, Terminal-Bench 4.0, SciCode, Humanity's Last Exam, GDP.pdf, CritPt, AA-Omniscience és AA-LCR. A súlypont az ügynöki feladatokon és a tudásmunkán van, nem a lexikális kvízkérdéseken: irodai munka, terminálos munka, tudományos kódolás, hosszú kontextusú következtetés és egy tudásteszt, amely a hallucinációt is bünteti.
Két tulajdonsága miatt hasznosabb, mint egy gyártó saját bejelentési grafikonja. Minden modellt ugyanaz a harness futtat, így a számok szolgáltatók között is összevethetők. Az index mellett pedig ott van a feladatonkénti költség, a felhasznált output tokenek száma és a sebesség, vagyis látod, mibe kerül egy pontszám, amit a gyártói grafikonok ritkán mutatnak meg. Mindkettőt tartsd észben a cikk további részében, mert a hatékonysági történet csak a második miatt létezik.
A ranglista: 58 pont és ötpontos előny
Az Artificial Analysis 2026. szeptember 22-én tette közzé az értékelését Claude Opus 5.5 takes the top spot címmel. Az Opus 5.5 max effort mellett 58 pontot ér el, és 211 modellből az első az indexen, ahol a medián modell 26 pontos. Mögötte a GPT-6 Astra és a Claude Fable 5.1 holtversenyben áll 53 ponttal, a Claude Opus 5 pedig, amelyet az Opus 5.5 lecserél, 51 ponttal a tizenegyedik.
Egy összetett indexen öt pont nagy különbség. Összehasonlításképp: az Opus 5 és a holtversenyes második hely között mindössze két pont van. Az OfficeChai beszámolója ötpontos előnyként írta le a GPT-6 Astrával szemben, és ez a korrekt olvasat: ez új csúcspontszám, nem egy holtverseny, amelyet a mérési zaj döntött el.
Honnan jönnek a pontok
Egy összetett szám elrejthet egyetlen kiugró benchmarkot, ezért az értékelésenkénti számok többet mondanak az összegnél. Az Artificial Analysis a következőket közli az Opus 5.5-ről max effort mellett:
- Humanity's Last Exam: 61,4%, a korábbi legjobb 59,1% volt.
- SciCode: 66,9%, a korábbi legjobb 63,1% volt.
- Terminal-Bench 4.0: 59,6%, ugyanannyi, mint a GPT-6 Astráé xhigh effort mellett, és 11 ponttal több az Opus 5-énél.
- AA-Briefcase: 1822-es Elo, 143 ponttal a Claude Fable 5.1 előtt.
- GDPval-AA v2.1: 1846, ez 111-gyel több a Fable 5.1-nél és 138-cal több az Opus 5-nél.
A javulás széles, nem egy-két kiugrásból áll. A legnagyobb előrelépés a tudásmunkában van (az AA-Briefcase és a GDPval-AA is valósághű irodai feladatokra épül), valamint a terminálos munkában, ahol a kódoló ügynökök az idejüket töltik. A Terminal-Bench az egyetlen terület, ahol nem vezet egyedül: a GPT-6 Astra ugyanannyit ér el. Ha nálad egy shellt vezérlő ügynökhurok a munkaterhelés, az őszinte összefoglaló „holtversenyben a legjobb”, nem „a legjobb”.
A medium effort az igazi hír
Az Opus 5.5 öt effort-szintet kínál: low, medium, high, xhigh és max. Az effort azt szabályozza, mennyit gondolkodhat a modell a válasz előtt, és ezzel azt is, hány output tokenért fizetsz. Az Artificial Analysis mind az ötöt lemérte. Az indexpontszámok: low mellett 42, medium mellett 51, high mellett 54, xhigh mellett 56, max mellett 58.
Most tegyünk egymás mellé kettőt ezek közül. Az Opus 5 max effort mellett 51 pontot ér el, feladatonként 5,86 dollárért. Az Opus 5.5 medium effort mellett szintén 51 pontot ér el, feladatonként 1,34 dollárért, és ezzel a nyolcadik a teljes ranglistán. Ugyanaz a pontszám, feladatonként nagyjából 77%-kal olcsóbban, ez körülbelül 4,4-szeres különbség. Ezt a mondatot tenném a bejelentő diára, és nincs rajta a bejelentő dián.
Az Artificial Analysis azt is megjegyzi, hogy az öt effort-szintből négy rajta van az intelligencia és a feladatonkénti költség közötti hatékonysági határon (frontier). Egyszerűbben: ennél a négy szintnél egyetlen más mért modell sem ad magasabb pontszámot ugyanannyi pénzért. A szintek lépcsője nem marketing: minden lépés felfelé valódi pontokat hoz, és te döntöd el, hol állsz meg a görbén.
| Modell és szint | Indexpontszám | Helyezés | Költség feladatonként | Output tokenek, teljes index | Kimeneti sebesség |
|---|---|---|---|---|---|
| Claude Opus 5.5, max | 58 | 1. a 211-ből | 5,98 $ | 260 millió | 95,5 token/s |
| Claude Opus 5.5, medium | 51 | 8. | 1,34 $ | 38 millió | 81,7 token/s |
| Claude Opus 5, max | 51 | 11. | 5,86 $ | 140 millió | 60,5 token/s |
A buktató: tokenek és várakozás
Most jön az, amit a főcím elhallgat. Max effort mellett az Opus 5.5 a legbőbeszédűbb modell a táblázat élén. Az Artificial Analysis indexfeladatonként körülbelül 119 000 output tokent számol, szemben az Opus 5 nagyjából 73 000, a Fable 5.1 nagyjából 78 000 és a GPT-6 Astra nagyjából 27 000 tokenjével. A teljes indexen 260 millió output tokent használt el, a medián modell 88 milliót. Feladatonkénti költségben csak azért van egy szinten az Opus 5-tel, mert csökkent a tokenár, nem azért, mert kevesebbet gondolkodik.
A második költség az idő. A max effortos modelloldal szerint az első tokenig eltelt idő (time to first token) 682,71 másodperc, vagyis több mint tizenegy percet vársz az első tokenre, holott a 95,5 token/s-os kimeneti sebesség gyorsabb az Opus 5-énél. Medium effort mellett ugyanez az oldal 13,20 másodpercet mutat. Egy háttérfeladatnál a tizenegy perc rendben van. Mindennél, amit közben egy felhasználó néz, ez már nem beállítás, hanem üzemzavar.
Az árcsökkentés, és miért számít most még többet a caching
Az Opus 5.5 ára millió input tokenenként 4 dollár, millió output tokenenként 20 dollár, ami 20%-kal kevesebb az Opus 5 árainál (5, illetve 25 dollár), a Claude models overview és az Artificial Analysis modelloldala szerint. A cache-olvasás ennél is nagyobbat esett, 60%-kal, millió tokenenként 0,50 dollárról 0,20 dollárra, az ötperces cache írása pedig 6,25 dollárról 5 dollárra. A kontextusablak egymillió token.
A cache-számok miatt érdemes lépni. Egy hosszan futó ügynök minden körben újraküldi az előzményeit, és egy bőbeszédűbb modellnél ez az előzmény gyorsabban nő. Millió gecachelt tokenenként 0,20 dollárnál egy stabil prefix szinte ingyen van, egy nem gecachelt pedig hússzor drágább. Ha még nem stabilizáltad a prompt prefixedet, a prompt cachingről és routingról szóló útmutató elmagyarázza, hogyan, és Opus 5.5-ön nagyobb a megtakarítás, mint bármelyik korábbi Claude modellen.
Mit csinálnék ezzel a gyakorlatban
A ranglista megmondja, melyik modell a legerősebb. Azt viszont nem, hogy melyik szinten futtasd, pedig a pénz ott van. Ebben a sorrendben haladnék:
- Legyen a medium az alapértelmezés. Hozza az előző zászlóshajót a költség negyedéért, és másodpercek alatt válaszol, nem percek alatt. A legtöbb interaktív funkciónak innen kell indulnia.
- A max maradjon azokra a munkákra, amelyekre senki sem vár: éjszakai elemzések, kódoló ügynökkel futtatott nagy refaktorálások, eval-generálás. A tokenekre szabj explicit keretet, mert feladatonként 119 000 output token gyorsan összeadódik.
- Szabály szerint eszkalálj, ne érzésből. Először medium szinten futtass, és csak akkor lépj high-ra vagy maxra, ha egy ellenőrzés elbukik, az eszkalálás feltételét pedig előre írd le. Egy kis, tipizált döntési modell, mint a Jev routingról szóló cikkben, olcsón meghozza ezt a döntést.
- Cache-elj agresszívan. A 60%-kal olcsóbb cache-olvasás mellett a prefix stabilitása ma a legnagyobb egyedi megtakarítás a hosszú ügynökmunkameneteknél.
- Váltás előtt futtasd újra a saját evaljaidat. Ugyanazon a pontozott készleten hasonlítsd össze az Opus 5.5 mediumot azzal, amit ma futtatsz; az evals útmutató megmutatja, hogyan rakhatsz össze egyet egy délután alatt.
Mind az öt mögött ugyanaz a gondolat áll: az effort-szint ma már termékdöntés, nem modellrészlet. Az a csapat, amelyik funkciónként választja meg, az előző generáció zászlóshajójának minőségét kapja az előző generációs számla töredékéért. Az a csapat, amelyik mindent maxon hagy, tizenegy perces válaszokért fog fizetni. Ha segítség kell ehhez a döntéshez egy valódi rendszerben, az AI fejlesztés oldalon leírom, hogyan közelítem meg.
Források
- Artificial Analysis: Claude Opus 5.5 takes the top spot on the Artificial Analysis Intelligence Index (2026. szeptember 22.)
- Artificial Analysis: Claude Opus 5.5 (max) modelloldal
- Artificial Analysis: Claude Opus 5.5 (medium) modelloldal
- Artificial Analysis: Claude Opus 5 (max) modelloldal
- Artificial Analysis: modell-ranglista és Intelligence Index
- OfficeChai: Claude Opus 5.5 creates a 5-point lead over GPT-6 Astra
- Claude API docs: Models overview, context windows and prices (2026. szeptemberi állapot)
Gyakori kérdések
Mi az az Artificial Analysis Intelligence Index?
Összetett pontszám, amelyet az Artificial Analysis tesz közzé. Ez egy független benchmarkcég, amely minden jelentős modellen ugyanazokat az értékeléseket futtatja. A 4.3.2-es verzió tíz értékelést von össze, köztük a Terminal-Bench 4.0-t, a SciCode-ot, a Humanity's Last Examet, a GDPval-AA-t és az AA-Omniscience-t, és a feladatonkénti költséggel, az output tokenekkel és a sebességgel együtt jelenik meg.
Melyik modell az első az Artificial Analysis ranglistáján?
2026. szeptember 28-i állapot szerint a Claude Opus 5.5 max effort mellett, 58 pontos Intelligence Index-eredménnyel. Utána a GPT-6 Astra és a Claude Fable 5.1 következik 53 ponttal, a Claude Opus 5 max effort mellett 51 pontot ér el. Az Artificial Analysis 2026. szeptember 22-én tette közzé az eredményt.
Drágább futtatni a Claude Opus 5.5-öt, mint az Opus 5-öt?
Max effort mellett feladatonként nagyjából ugyanannyiba kerül, 5,98 dollár az 5,86 dollárral szemben, mert az alacsonyabb tokenár kiegyenlíti, hogy nagyjából 1,6-szor több output tokent használ. Medium effort mellett feladatonként 1,34 dollárért hozza az Opus 5 max effortos pontszámát, vagyis azonos minőségért sokkal olcsóbb.
Melyik Opus 5.5 effort-szintet használjam éles környezetben?
Interaktív funkcióknál kezdj a mediummal: 51 pontot ér el az indexen, és az Artificial Analysis szerint az első tokenig eltelt idő 13,20 másodperc. A high, xhigh és max szintet tartsd meg olyan háttérmunkára, ahol a több mint tízperces késleltetés is elfogadható, előre meghatározott szabály szerint eszkalálj, és a választást a saját eval készleteden erősítsd meg.
Mennyit változtak az Opus 5.5 árai?
Az input és az output ára 20%-kal csökkent, millió tokenenként 5 és 25 dollárról 4 és 20 dollárra. A cache-olvasás 60%-kal lett olcsóbb, millió tokenenként 0,50 dollárról 0,20 dollárra, az ötperces cache írása pedig 6,25 dollárról 5 dollárra, így egy stabil, gecachelt prompt prefix többet ér, mint bármelyik korábbi Claude modellen.