Blog/LLMOps és értékelés
Prompting vs RAG vs fine-tuning vs distillation: döntési útmutató 2026-ra
Fine-tuning vs RAG vs prompting: mit változtat meg mindegyik (tudás, viselkedés, formátum), mennyibe kerül, ki kínál 2026-ban SFT-t, DPO-t és RFT-t, plusz döntési fa.
Balázs Csorba··12 perc olvasás
- Fine-tuning
- RAG
- Prompting
- Distillation
A lényeg röviden
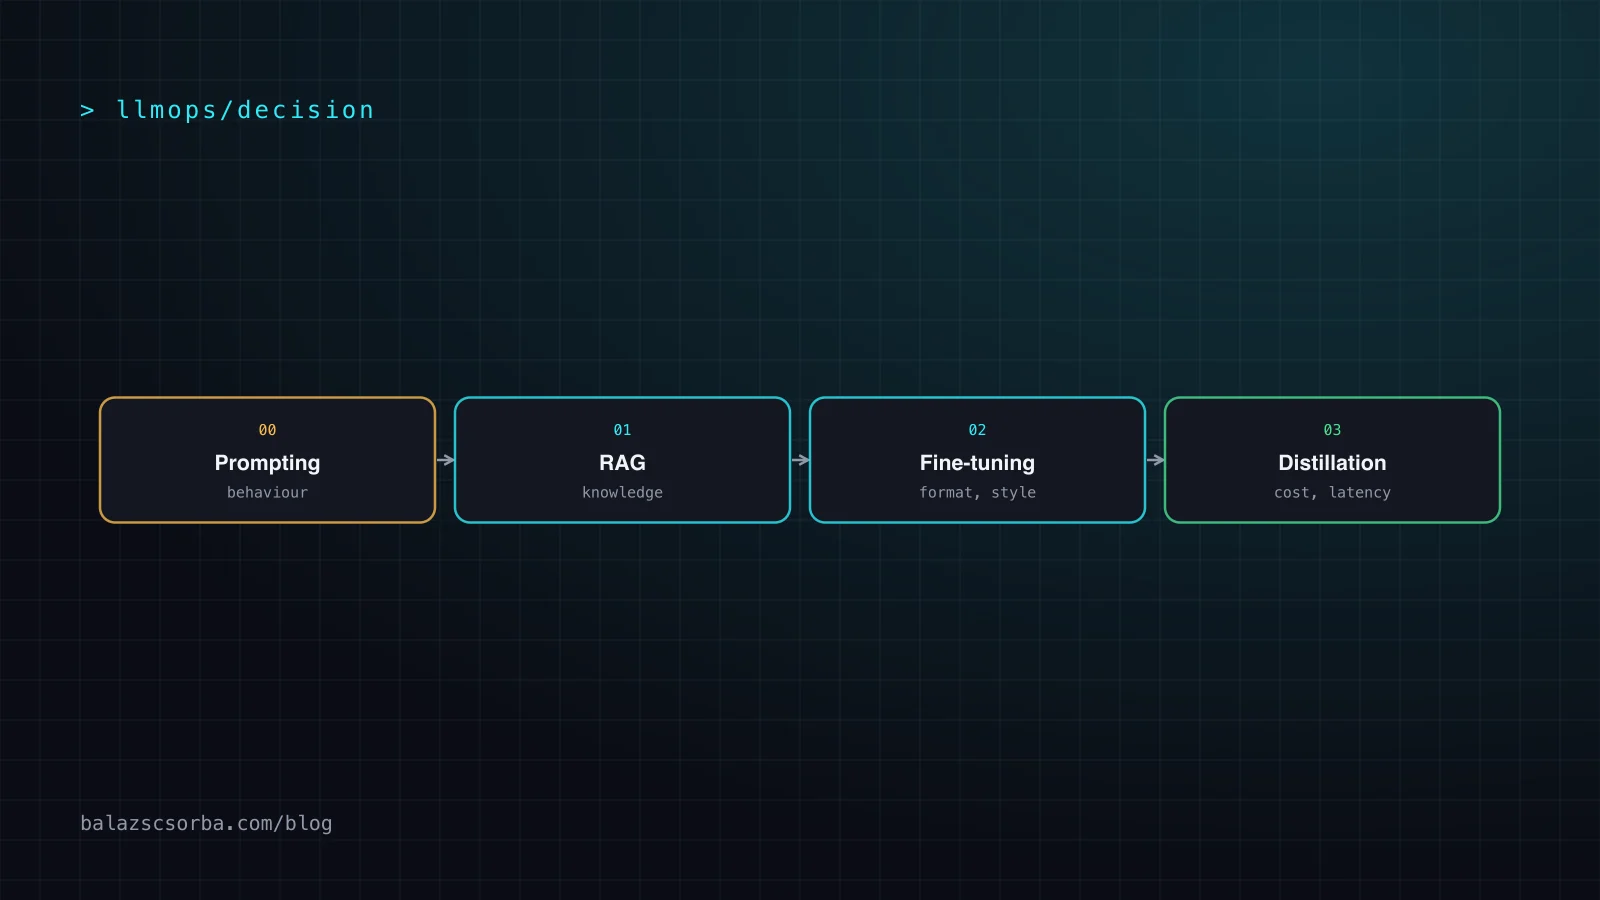
- Minden eszköz mást változtat: a prompting az utasításokat, a RAG azt, amit a modell lát, a fine-tuning a viselkedést és a formátumot, a distillation a költséget és a sebességet.
- A klasszikus hiba a tudás fine-tuningolása. A kutatások szerint új tényeknél a RAG jobb, az új tudást tartalmazó példák pedig növelhetik a hallucinációt.
- 2026-ban átrendeződött a szolgáltatói térkép: az OpenAI leépíti a fine-tuning platformját (új jobok 2027. január 6-ig), a Google és az AWS továbbra is kínál menedzselt SFT-t és RFT-t.
- A preference tuning és az RFT csak akkor térül meg, ha tudsz kimeneteket rangsorolni vagy gradert írni, vagyis az értékelésnek a tanítás előtt léteznie kell.
- Indulj mért prompttal, add hozzá a retrievalt a tényekhez, csak stabil, értékelhető viselkedést finomhangolj, és csak akkor desztillálj, ha a forgalom láthatóvá teszi a költséget.
Minden LLM-ekre építő csapat ugyanahhoz az útelágazáshoz ér: a válaszok nem elég jók, és négy eszköz van az asztalon. Jobb promptot írni, retrievalt hozzáadni, finomhangolni a modellt, vagy egy kisebbet desztillálni. Gyakran a divat dönt. A fine-tuning komoly opciónak tűnik, ezért olyan problémákra is ezt választják, amelyeket nem tud megoldani.
A térkép ráadásul elmozdult. 2026 májusában az OpenAI bejelentette, hogy leépíti az önkiszolgáló fine-tuning platformját, azzal az indoklással, hogy az újabb alapmodellek annyira jól követik az utasításokat és a formátumokat, hogy a prompting mostanra olcsóbb és gyorsabb. A Google és az AWS továbbra is kínál menedzselt tuningot, nyílt modelleket pedig bárhol hangolhatsz. Ha utoljára egy éve hasonlítottad össze ezeket a lehetőségeket, a képed egy része elavult.
Ezt a keretrendszert használom az ügyfeleimnél. Az eszközöket aszerint választja szét, mit változtatnak, összeveti a költséget, az adatigényt és a karbantartást, felsorolja, ki mit kínál 2026. október 2-án, megnevezi a leggyakoribb hibákat, és döntési fával meg ellenőrzőlistával zár.
Mit változtat meg valójában az egyes eszköz
A legegyszerűbb, ha azt kérdezed, mi a baj a kimenettel. Háromféle hiba van. A modell nem tud valamit (tudás). Rosszat csinál abból, amit tud (viselkedés). Vagy a helyes tartalmat rossz formában adja (formátum). Egy negyedik szempont, a költség és a késleltetés, külön áll: a kimenet jó, csak túl drága.
| Eszköz | Mit változtat | Szükséges adat | Működési költség és karbantartás | Tipikus hiba |
|---|---|---|---|---|
| Prompting | Utasítások, példák, kimeneti struktúra egy híváshoz | Néhány példa és egy eval-halmaz | A hosszabb promptok minden híváskor tokent esznek; a prompt caching enyhít ezen | Prompt-drift, törékeny szélső esetek |
| RAG | Amit a modell lát: privát, friss vagy nagy tudás | Dokumentumkorpusz, és a retrieval teszteléséhez kérdések | Az indexet és a pipeline-t üzemeltetni kell; hívásonként extra kontextus-token | Rossz chunk jön elő, így magabiztos téves válasz születik |
| SFT | Viselkedés, hangnem, formátum, feladatkészség | Több száz tiszta bemenet és ideális kimenet pár | Újratanítás, ha változik a követelmény vagy az alapmodell | Túltanulás, szűk általánosítás, elavult viselkedés |
| Preference tuning (DPO) | Szubjektív stílus és hangsúly | Ezernyi preferált és elutasított pár | Mint az SFT, és a címkézés a költség | A zajos preferenciák rossz ízlést tanítanak |
| RFT | Következtetés ellenőrizhető válaszú feladatoknál | Tucatnyi-több száz prompt és egy grader | A grader karbantartása; a tanítást idő alapján számlázzák | Reward hacking: a modell kijátssza a gyenge gradert |
| Distillation | Költség és késleltetés: a tudás kisebb modellbe kerül | Tanár kimenetek a valódi forgalmadon | Újradesztillálás, ha változik a feladat vagy a tanár | A diák csak a könnyű eseteknél éri el a tanárt |
Ki mit kínál 2026-ban
Módszer választása előtt nézd meg, hogy a szolgáltatód még árulja-e. Ez az az állapot, amelyet 2026. október 2-án a szolgáltatók dokumentációjából és bejelentéseiből ellenőrizni tudtam.
| Szolgáltató | Felügyelt (SFT) | Preferencia | Reinforcement (RFT) | Distillation |
|---|---|---|---|---|
| OpenAI API | GPT-4.1, 4.1-mini, 4.1-nano (leépítés alatt) | DPO ugyanezen három modellen (leépítés alatt) | Csak o4-mini (leépítés alatt) | Nem ellenőrzött |
| Microsoft Foundry | GPT-4.1-család és Llama 4 Scout bejelentve | Nem ellenőrzött | o4-mini, modell-graderekkel (GPT-4.1-család) | Nem ellenőrzött |
| Google, Gemini | Gemini 3.5 Flash, 3.1 Flash-Lite, 2.5 Pro, 2.5 Flash és Flash-Lite | Gemini 2.5 Flash és Flash-Lite | Pre-GA előzetes ugyanezeken a Gemini modelleken | Nyílt modelleken keresztül |
| Google, nyílt modellek | Gemma, Qwen, Llama; teljes tuning vagy LoRA | Nem ellenőrzött | Nem ellenőrzött | A tanár modell hangol egy kisebb diák modellt |
| AWS Bedrock | Amazon Nova és mások; Claude 3 Haiku az us-west-2-ben | Nem ellenőrzött | Nova 2 Lite, gpt-oss-20B, Qwen3 32B | Igen; tanár és diák azonos családból |
Három gyakorlati következmény. Először: ma a „melyik modellt hangolhatom?” többet számít, mint a „melyik módszer?”: azok a frontier modellek, amelyeket a legtöbb csapat élesben használ, többnyire nem hangolhatók, mert a jelenlegi Claude- vagy GPT-5-osztályú modellekhez nem találtam menedzselt fine-tuningot. Másodszor: az RFT valós, de fiatal: a Google Pre-GA-ként listázza, a Microsoft saját RFT-posztjai pedig determinisztikus graderekkel javasolják kezdeni. Harmadszor: a nyílt súlyú út (LoRA Gemmán, Qwenen vagy Llamán) az egyetlen hordozható, és a hosting üzemeltetési terhét is magával hozza.
Kezdd promptinggal, de mérd
Az OpenAI saját optimalizálási útmutatója a munkát evalok, prompt engineering és fine-tuning körforgásaként írja le, és az alapvonal-értékelést teszi az elejére. A sorrenddel egyetértek, és hozzáteszek egy szabályt: addig nem mondhatod, hogy a prompting megbukott, amíg ki nem próbáltad az erős változatát. Ez azt jelenti: világos feladatleírás, strukturált kimeneti séma, három–tíz valódi példa a nehéz esetekkel együtt, és egy a feladathoz elég erős modell.
- A formátumszerződést sémába vagy structured output módba tedd, ne folyó szövegbe.
- A few-shot példákat valódi hibákból vedd, ne kitalált esetekből.
- Cache-eld a stabil előtagot. A hosszú, ismétlődő prompt főleg költségprobléma, és a caching nagy részét megoldja (lásd: költség, késleltetés és routing).
- Előbb próbálj erősebb modellt, mielőtt egy gyengébbet hangolnál. Sok „fine-tuning probléma” valójában modellméret-probléma.
- Az eval-halmazt írd meg először. Nélküle nem tudod, hogy egy későbbi változtatás segített-e (lásd: evalok termékfunkciókhoz).
A Google tuning-dokumentációja ugyanezt a határt húzza: a prompting a kevés címkézett adathoz és a gyors prototípusokhoz illik, a tuning akkor a leghatékonyabb, ha nagyobb címkézett adathalmazod van (100 vagy több példát javasol), és a feladatot a fejlett prompting sem oldja meg. A tuning előnyét maga is megnevezi: jobb minőség a feladatodon, kisebb késleltetés és költség a rövidebb promptoknak köszönhetően.
RAG a tudáshoz, nem fine-tuning
Ha a modellből tények hiányoznak, add oda neki a tényeket lekérdezéskor. Itt történik a legdrágább hiba, ezért érdemes kimondani a bizonyítékot. A Fine-Tuning or Retrieval? című tanulmányban Ovadia és társai a felügyelet nélküli fine-tuningot hasonlították össze a RAG-gal, és azt találták, hogy a RAG következetesen jobb, mind a tanítás során látott tudásnál, mind a teljesen új tudásnál; a modellek egyáltalán nehezen tanultak új tényeket fine-tuninggal. A Does Fine-Tuning LLMs on New Knowledge Encourage Hallucinations? című tanulmányban Gekhman és társai azt találták, hogy az új tudást hozó példákat lassabban tanulja meg a modell, és ha már megtanulta, lineárisan nő a hallucinációra való hajlama. Következtetésük: a modellek a ténybeli tudást főleg az előtanítás alatt szerzik, a fine-tuning azt tanítja meg, hogyan használják hatékonyabban.
A gyakorlati érvek ugyanilyen erősek, mint a kutatási érvek. A tények változnak, és egy betanított tényt nem lehet újratanítás nélkül frissíteni, idézni vagy GDPR-kérésre törölni. A RAG forrásokat, dokumentumonkénti jogosultságot és percek alatt megvalósuló frissítést ad. Az ár egy jól megépítendő pipeline: chunkolás, hibrid keresés és reranking, amelyekről a RAG pipeline útmutatóban és a RAG 2026: hibrid, ágens-alapú vagy hosszú kontextus cikkben írok.
Egy hasznos próba: ha a helyes válasz benne van egy dokumentumban, amelyet valaki a kezedbe adhatna, az retrieval-probléma. Ha egyetlen dokumentum sem tartalmazhatná, mert a gond az, hogyan kell válaszolni, akkor nem az.
Supervised fine-tuning viselkedésre és formátumra
Az SFT akkor a jó eszköz, ha a probléma a következetes viselkedés. Az OpenAI útmutatója az osztályozást, az árnyalt fordítást, a meghatározott formátumú tartalom előállítását és az utasításkövetési hibák javítását említi, és óv attól, hogy az SFT-t teljesen új tudásra használd. Projektekből származó kiegészítéseim: szigorú házi stílus, rögzített sémába történő kinyerés ott, ahol a promptok túl hosszúvá válnának, és egy 3000 tokenes prompt súlyokba sűrítése, hogy minden hívás olcsóbb legyen.
Adat. A szolgáltatók által említett számok kicsik. Az OpenAI már 10 példát elfogadott, és 50–100 példától látott javulást; a Google útmutatója több száz címkézett példáról beszél; az AWS Claude 3 Haiku fine-tuningja 32 és 10 000 sor közötti adatot fogadott. A mennyiség nem a nehéz rész. Az OpenAI best practice útmutatója jól fogalmaz: ha a modelled nyelvtani, logikai vagy stílusproblémákkal küzd, nézd meg, hogy az adataidban nincsenek-e ugyanezek, és kevesebb jó minőségű adat többet ér, mint sok rossz. Figyelj az egyensúlyra is: a 60 százalékban elutasítást tartalmazó tanítóadatból túl sokat elutasító modell lesz.
Módszer. A paraméterhatékony tuning megfizethetően tartja ezt. A LoRA-tanulmány nagyjából 10 000-szer kevesebb tanítható paramétert és körülbelül háromszor kevesebb GPU-memóriát említ a GPT-3 175B teljes finomhangolásához képest, plusz inferencia-késleltetés nélkül. A menedzselt szolgáltatások ezt elrejtik; nyílt modelleknél magad választasz a LoRA és a teljes tuning között.
Karbantartás. A fine-tune egy adott alapmodell elágazása. Amikor azt a modellt kivezetik, újratanítasz, és a tanítóadatod meg az eval-halmazod az az érték, amely megmarad. Néhány platform azt is megváltoztatja, hogyan fizetsz: az AWS Provisioned Throughputot kér egy testre szabott Claude 3 Haiku futtatásához, ami a tokenenkénti költséget állandó költséggé alakítja.
Preference tuning és RFT: csak jelzéssel
A DPO párokon tanít: egy prompt, egy preferált és egy nem preferált kimenet. Az OpenAI a megfelelő hangsúlyú összefoglalásra és a jó hangnemű, stílusú chatre ajánlja, a cookbook pedig ezres-tízezres nagyságrendű példát említ adatigényként. A Google azt javasolja, hogy előbb SFT-t, utána preference tuningot futtass, és az OpenAI pipeline-ja is először az SFT-vel tanítja meg a pontos megfogalmazást. A DPO ízlésbeli finomhangolás, nem módja egy feladat megtanításának.
Az RFT más természetű: a modell a tanítás alatt válaszokat generál, és egy grader pontozza őket. Az OpenAI dokumentációja azt tanácsolja, hogy kicsiben kezdj, néhány tucattól néhány százig terjedő példával, hogy lásd, hasznos-e egyáltalán az RFT. Ellenőrizhető eredményű feladatokhoz illik, például teszteken átmenő kódhoz, ismert válaszú strukturált kinyeréshez vagy korlátozott következtetéshez. A Google string-match, Gemini-autorater és kódvégrehajtásos jutalmakat kínál, akár 16-ot kombinálva; az AWS az RFT-jére alapmodellekhez képest átlagosan 66 százalékos pontosságnövekedést közöl, ami kiválasztott esetekből származó gyártói állítás, nem garancia. Az RFT nem működik ott, ahol a modellnek nincs kezdeti képessége vagy homályos a jel, és a gyenge gradert kihasználják. A grader megírása a valódi projekt; egy másik nevű értékelés, ezért az evalokról szóló útmutatóm közvetlenül érvényes.
Distillation: költség és késleltetés visszavásárlása
A distillation az az egy eszköz, amely a számlát célozza. Egy erős tanár modell kimeneteket generál a valódi bemeneteiden, és egy kisebb diák modellt hangolnak rájuk. Az AWS a Bedrock Model Distillationt az eredeti nagy modellnél akár ötször gyorsabbnak és akár 75 százalékkal olcsóbbnak írja le, kevesebb mint két százalék pontosságvesztéssel, főleg RAG-alkalmazásoknál. Ezek az AWS számai a saját termékére, ezért mérj a saját adataidon. A korlátok tanulságosak: a tanárnak és a diáknak azonos családból kell származnia, és az AWS maga is azt tanácsolja, hogy ha a diák már így is jól teljesít, használd változtatás nélkül.
A Google nyílt modellekre vonatkozó dokumentációja ugyanezt mondja a másik oldalról: a distillation akkor működik a legjobban, ha a tanár érdemben erősebb a diáknál, például többlépéses következtetésnél, és kisebb nyereséget hoz, ha a diák már közel jár, vagy a feladat rövid retrieval. Szabályom: csak stabil, valódi forgalmú feladatot desztillálj, miután egy értékelés bizonyítja, hogy a diák eléri a tanárt. Ha ehelyett egy kicsi és egy nagy modell közti routing a célod, nézd meg a típusos döntések LLM-routinghoz cikket.
Döntési fa
A kérdések sorrendje a lényeg. Mindegyiket olcsóbb kipróbálni, mint a következőt, és minden válasz kizárja a drágább eszközöket.
Két megjegyzés az olvasáshoz. Az eszközök kombinálhatók: egy éles rendszer gyakran egy hangolt vagy jól promptolt modell, a tényekhez retrievallal, egy eval-kapu mögött. A fa pedig újraindul, valahányszor az alapmodell változik, mert egy jobb modell feleslegessé teheti a tegnapi fine-tune-t, és az OpenAI szerint pontosan ezt látták.
A leggyakoribb hibák
- Fine-tuning tudásra. A modell a tanítás alatt felmondja a termékkatalógusodat, élesben pedig árakat talál ki. Használj retrievalt.
- Hangolás mérés előtt. Nincs alapvonal, nincs eval, így senki sem mondhatja meg, hogy a hangolt modell jobb-e. A letesztelt eseteken kívül gyakran rosszabb.
- Piszkos tanítóadat. A korábbi modellkimenetekből vagy egymásnak ellentmondó emberi válaszokból másolt példák az ellentmondást tanítják.
- Gyenge modell hangolása egy rossz feladatdefiníció megmentésére. Ha két ember nem ért egyet a helyes válaszban, semmilyen módszer nem segít.
- Az alapmodell életciklusának figyelmen kívül hagyása. A fine-tune az alapmodelljével együtt hal meg, és 2026-ban a szolgáltató akár teljesen meg is szüntetheti a tuningot.
- Regressziós halmaz kihagyása. Egy viselkedésre hangolva csendben más viselkedéseket is károsíthatsz, a biztonságit is.
- Bekapcsolva hagyott thinking egy hangolt feladatnál. A Google azt javasolja, hogy hangolt feladatoknál állítsd a thinking budgetet 0-ra (Gemini 3-tól felfelé a szintet minimálisra), ami javíthatja a teljesítményt és csökkentheti a költséget.
Értékelési és karbantartási ellenőrzőlista
Bármelyik eszközt is húzod meg, ugyanaz a fegyelem érvényes. Ezt az ellenőrzőlistát tenném egy pull request sablonba minden prompt-, retrieval- vagy modellváltoztatáshoz.
- Fagyassz be egy eval-halmazt valódi forgalomból, hibákkal és szélső esetekkel, mielőtt bármit változtatsz.
- Rögzítsd az alapvonalat a jelenlegi promptra és modellre, minőséggel, késleltetéssel és feladatonkénti költséggel.
- Egyszerre egy eszközt változtass, és futtasd újra a teljes halmazt, ne csak azokat az eseteket, amelyeket éppen néztél.
- Tarts regressziós halmazt olyan viselkedésekhez, amelyeket nem veszíthetsz el: elutasítások, biztonság, formázás.
- Verziózd a tanítóadatot, a grader vagy judge promptot és az alapmodell azonosítóját a hangolt modell mellett.
- Állíts be újratanítási triggert: alapmodell kivezetése, az eval-pontszám elcsúszása vagy megváltozott követelmény.
- Számold ki a megtérülést: a tuning és a hosting költsége a havonta megspórolt tokenekkel szemben.
Mit tennék én
Egy új LLM-funkciónál az első héten megépíteném az eval-halmazt, a másodikban jó promptig jutnék, és retrievalt adnék hozzá, amint a tények számítanak. Fine-tuningot csak akkor mérlegelnék, ha ezek után egy stabil viselkedés még mindig hibázik, és csak olyan platformon, amelyről azt várom, hogy két év múlva is kínálja. Ma ez a Google, az AWS vagy a nyílt modellek felé mutat, nem egy visszavonuló zárt API felé. RFT-t csak determinisztikus graderrel próbálnék, distillationt pedig csak akkor, ha a havi számla elég nagy ahhoz, hogy kifizesse a projektet.
A legtöbb európai B2B termékben a prompting plusz a retrieval plusz egy jó értékelés megadja az érték 90 százalékát. Ez a projektjeimből származó megítélés, nem mért szám, és az eval-halmazodnak felül kell bírálnia. A mesterség abban áll, hogy felismerd, milyen fajta hibát látsz magad előtt.
Források
- OpenAI community: OpenAI self-serve fine-tuning availability (wind-down announcement)
- Tessl: OpenAI is shutting down self-serve fine-tuning
- OpenAI API docs: Model optimization
- OpenAI API docs: Supervised fine-tuning
- OpenAI API docs: Direct preference optimization
- OpenAI API docs: Reinforcement fine-tuning
- OpenAI API docs: Fine-tuning best practices
- OpenAI Cookbook: Choosing between SFT, DPO and RFT
- Google Cloud: Introduction to tuning (Gemini)
- Google Cloud: About supervised fine-tuning for Gemini models
- Google Cloud: About preference tuning for Gemini models
- Google Cloud: Reward functions for reinforcement learning fine-tuning
- Google Cloud: Supervised and distillation fine-tuning for open models
- AWS: Fine-tuning for Claude 3 Haiku in Amazon Bedrock is now generally available
- AWS: Amazon Bedrock now supports reinforcement fine-tuning
- AWS: Amazon Bedrock Model Distillation (preview announcement)
- AWS: Bedrock reinforcement fine-tuning adds open-weight models
- Microsoft Foundry blog: What is new in Foundry fine-tuning, April 2026
- Microsoft: Announcing new fine-tuning models and techniques in Azure AI Foundry
- Ovadia et al.: Fine-Tuning or Retrieval? Comparing Knowledge Injection in LLMs
- Gekhman et al.: Does Fine-Tuning LLMs on New Knowledge Encourage Hallucinations?
- Hu et al.: LoRA: Low-Rank Adaptation of Large Language Models
Gyakori kérdések
RAG-ot vagy fine-tuningot használjak?
RAG-ot, ha hiányzó vagy változó tények a gond, fine-tuningot, ha a viselkedés, a hangnem vagy a kimeneti formátum. A fine-tuning rossz módszer tudás hozzáadására: egy 2023-as tanulmány szerint a RAG a meglévő és az új tudásnál is jobb, egy 2024-es pedig azt találta, hogy az új tényeket tartalmazó példákat lassan tanulja meg a modell, és a megtanulásuk után nő a hallucináció.
Mikor éri meg a fine-tuning?
Ha egy letesztelt, példákkal ellátott prompt egy stabil, jól definiált viselkedésnél még mindig hibázik, van néhány száz jó példád, és mérni tudod az eredményt. Tipikus nyereség a szigorú kimeneti formátum, az osztályozás, az egységes hangnem és a rövidebb promptok nagy forgalomnál.
Elérhető még az OpenAI fine-tuning 2026-ban?
Csak azoknak a szervezeteknek, amelyek már használták. Az OpenAI 2026 májusában jelezte a fejlesztőknek, hogy leépíti a platformot: új szervezetek nem hozhatnak létre jobokat, 2027. január 6-án pedig mindenki számára megszűnik a jobok létrehozása. A meglévő finomhangolt modellek addig futnak, amíg az alapmodellt ki nem vezetik.
Mi a különbség az SFT, a DPO és az RFT között?
A supervised fine-tuning (SFT) bemenet és ideális kimenet párokon tanít. A direct preference optimization (DPO) promptonként egy preferált és egy elutasított válaszon. A reinforcement fine-tuning (RFT) során a modell válaszokat generál, amelyeket egy grader pontoz, ez az ellenőrizhető eredményű feladatokhoz illik.
Mi az a distillation, és mikor használjam?
A distillation során egy erősebb tanár modell tanítóadatot generál egy kisebb diák modellnek. Stabil, nagy forgalmú feladatnál használd, ha egy olcsóbb modell az értékelő halmazodon eléri a tanárt, és valódi pénzt spórol. Az AWS azt javasolja, hogy ha a diák modell már így is jól teljesít, maradj annál.
Hány példa kell a fine-tuninghoz?
A szolgáltatók kis kezdőszámokat mondanak: az OpenAI minimum 10 példát fogadott el, és 50–100 példától látott javulást, a Google nagyjából 100 vagy több címkézett példát javasol. A DPO-hoz jellemzően jóval több kell, az OpenAI szerint ezres nagyságrend. A minőség és a szélső esetek lefedettsége többet számít a puszta darabszámnál.