Blog/Biztonság és megfelelés
GDPR LLM adatrezidencia: régióvezérlés, nulla megőrzés, EU-opciók
GDPR LLM adatrezidencia magyarázva: mi távozik a szervereidtől, régióvezérlés first-party és hyperscaler API-kon, nulla megőrzés és minimalizálás.
Balázs Csorba··11 perc olvasás
- GDPR
- Data residency
- LLM API
- Zero data retention
- PII minimisation
- EU hosting
A lényeg röviden
- Négy dolog lépi át a Modell-API felé vezető határt: a prompt, a mellékletek, az identitáskontextus, mint a felhasználó- és tenantazonosítók, és minden telemetria vagy trace, amit raksz rá.
- 2026 szeptemberében a Claude first-party API-jának nincs EU inference-régiója: az inference_geo csak az us vagy a global értéket fogadja el, a workspace földrajza pedig csak az ust. A legjobb elérhető vezérlés a kizárólag amerikai inference.
- Az Amazon Bedrocken és a Google Cloudon az endpoint állítja be a régiót; a regionális Bedrock endpointok garantálják az adatirányítást a Claude Sonnet 4.5-től és az újabbaktól, a globális endpointok dinamikusan route-olnak.
- A zero data retention szervezetenként és funkciónként korlátozott: a Files API, a batch jobok, a kódvégrehajtó konténerek és egyes modellek kimaradnak, a megjelölt sessionök pedig akár két évig megőrizhetők.
- Az adatminimalizálás és az álnevesítés a prompt előtt olcsóbb és erősebb, mint bármelyik régióbeállítás, de az álnevesített adatok a GDPR Article 4(5) szerint továbbra is személyes adatok.
A GDPR LLM munka valójában adatrezidencia-munka, csak középen van egy modell. Amint a szervered promptot küld egy hosztolt modellnek, a személyes adatok elhagyták az adatbázisodat, áthaladtak egy hálózaton, és olyan infrastruktúrára kerültek, amelyet nem te üzemeltetsz, egy olyan megőrzési szabály szerint, amelyet te nem írtál. 2026 szeptemberétől az érdekes kérdés már nem az, hogy ez lehetséges-e – nyilván az –, hanem az, mely útvonalak tartják ténylegesen az EU-n belül a feldolgozást, és mit fizet ez egy-egy megőrzésben, funkcióban és hibakeresésben.
Ez a cikk belülről kifelé járja körül a határt: mi pontosan lépi át, miért nincs a Claude first-party API-jának 2026 szeptemberében bekapcsolható EU-régiója, hogyan lett a hyperscalerek EU-régiói a gyakorlati válasz, mit takarít ki valójában a zero data retention, hogyan zsugorítsd a hasznos terhet, mielőtt elmegy, mikor helyes a saját infrastruktúrán futtatott nyílt súlyú modell, és egy mintaarchitektúra, amit másolhatsz. A szolgáltatók viselkedéséről szóló állítások dátumozottak és forrásoltak; ellenőrizd őket a saját szerződésed szerint, mielőtt bármelyikre támaszkodnál.
Mi távozik valójában a szervereidről, amikor modell-API-t hívsz
Négy dolog utazik, és csak az egyik az a szöveg, amit beírtál. A prompt: a rendszerpromtod, a beszélgetés előzménye, a visszahívott részletek, az eszközeredmények. A mellékletek: a feltöltött fájlok, a képek, a PDF-ek és minden metaadat, ami velük utazik. Az identitáskontextus: egy felhasználóazonosító, egy tenantazonosító, egy sessionazonosító, egy kérésazonosító, valamint a fiók vagy az API-kulcs, amivel hitelesíted magad. És a telemetria, amire nem gondoltál: kérésmetaadatok, késleltetés- és tokenszámok, hibatartalmak, és minden trace vagy span, amit az observability kedvéért raksz rá.
A hibaforma általában nem a prompt. Az a userId, amit a kényelem kedvéért a rendszerpromptba teszel, az a trace, ami a teljes kérés törzsét rögzíti, és az a visszahívott dokumentumrészlet, amelyben még benne van egy e-mail-cím, mert senki nem maszkolta előbb. A szolgáltató mindezt látja. Ami ezután történik, két független beállítástól függ: hol fut az inference, és mennyi ideig őriznek meg bármit.
First-party régióvezérlés, és az EU-opció, ami nincs
Az Anthropic first-party Claude API-ján létezik régióvezérlés, és ez tényleg jól dokumentált. Az adatrezidencia dokumentáció egyértelmű: az inference_geo kérésparaméter pontosan két értéket fogad el, a "global" alapértelmezettet, amelynél az inference bármelyik elérhető földrajzon futhat az optimális teljesítmény és elérhetőség érdekében, és a "us" értéket, amelynél az inference kizárólag amerikai infrastruktúrán fut. Kérésenként vagy workspace alapértelmezésként állíthatod, az allowed_inference_geos segítségével szűkítheted a megengedett értékeket, és a válasz usage.inference_geo mezőjében megnézheted, hol landolt egy hívás. Épp az utolsó részre érdemes tesztet építeni.
Itt jön a meglepetés, és 2026 szeptemberében ez a leghasznosabb tudás, ha EU-adatrezidencia köré tervezel: a first-party API-n nincs EU inference-régió. A workspace földrajza – ez szabja meg, hol tárolják álló helyen az adatokat és hol történik az endpoint feldolgozása –, a workspace létrehozásakor áll be, utána nem változtatható meg, és jelenleg a "us" az egyetlen elérhető érték. A first-party API által kínált legerősebb vezérlés tehát egy választás „bárhol” és „az Egyesült Államokban” között.
Ugyanarról az oldalról két kisebb korlát következik. A inference_geo a Claude 4.6-tól és az újabbaktól támogatott; ha régebbi modellel küldöd el, 400-as választ kapsz. És a kizárólag amerikai inference az alapár 1.1-szerese, az input tokenekre, az output tokenekre, a cache-írásra és a cache-olvasásra egyaránt. A földrajz rögzítése nem ingyenes, csak olcsóbb, mint az a lehetőség, hogy ne tudjád, hová ment az adatod.
A hyperscalerek EU-régiói a gyakorlati út
Ugyanezek a modellek Amazon Bedrocken és Google Cloudon is elérhetők, és ott a földrajzat az endpoint választja ki, nem egy paraméter. Ezeken a platformokon a docs szerint az inference-régiót az endpoint URL-je vagy az inference profil határozza meg, és az inference_geo nem érvényes. Ez megfordítja a feladatot: ahelyett, hogy megkérnéd a szolgáltatót, tartsa a feldolgozást egy adott régióban, egy regionális endpointot szólítasz meg, és a régió követi.
A endpointtípusok közötti különbség fontos, és könnyű elrontani. A modellek áttekintése kimondja: az Amazon Bedrock globális és regionális endpointokat is kínál, a globálisak dinamikusan route-olnak, a regionálisak garantálják az adatirányítást, és ez a garancia a Claude Sonnet 4.5-től és az újabbaktól érvényes. A Google Cloud globális, multiregionális és regionális endpointokat kínál. Ha az EU-adatrezidencia követelmény, nem preferencia, egy globális vagy dinamikusan route-olt endpoint nem adja meg neked; egy regionális igen. Jegyezd meg azt is, hogy itt megváltozik az adatfeldolgozói viszony: a Bedrocken és a Google Cloudon a felhőszolgáltató az adatfeldolgozó, ezért az ő megőrzési és megfelelési dokumentációja az irányadó, nem a first-party API szabályzata.
| Útvonal | Régióvezérlés | Megőrzésvezérlés | Költség vagy korlát |
|---|---|---|---|
| Claude, first-party API | A inference_geo a "us" vagy a "global" értéket fogadja; a workspace földrajza csak "us", tehát nincs EU-régió | Zero data retention kérésre, szervezetenként; egyes funkciók és modellek kimaradnak | A kizárólag amerikai inference az alapár 1.1-szerese |
| Claude Amazon Bedrocken vagy Google Cloudon | Az endpoint állítja be; a regionális Bedrock endpointok garantálják az irányítást a Sonnet 4.5-től és az újabbaktól | A felhőszolgáltató az adatfeldolgozó; olvasd el a megőrzési dokumentációját | A partner regionális árazása; az inference_geo nem érvényes |
| OpenAI API Platform | Európa választható új Project létrehozásakor; a meglévő Projectek nem frissíthetők | Zero data retention az EU-ra konfigurált Projecteken át küldött kérésekre | Csak a jogosult endpointok, és csak új Projectek |
| Saját infrastruktúrán futtatott nyílt súlyú modell | Ahol futtatod, vagyis ahol bérelt GPU-t | A tiéd, végig | A kapacitás, a patchelés és az értékelés a te problémád |
Az OpenAI-nál a 2025. február 5-i, azóta többször frissített Introducing data residency in Europe bejelentés azt írja le, hogyan választanak az API-ügyfelek európai feldolgozást a jogosult endpointokhoz: létrehoznak egy új Projectet az API Platform dashboardon, és Európát választják régiónak. Az ezeken a Projecteken át küldött kéréseket a régión belül dolgozzák fel, zero data retention mellett, vagyis a modellkéréseket és a válaszokat nem tárolják álló helyen. Két fenntartás ugyanarról az oldalról: az európai adatrezidencia csak új Projectekhez konfigurálható, és a jogosult endpointokra vonatkozik, tehát nézd meg a saját endpoint listádat, mielőtt erre építesz. Az OpenAI azt is kimondja, hogy a modelleket alapból nem tanítják ügyféladatokon, kivéve, ha az ügyfél ezt kifejezetten megengedi; az adatokat álló helyen AES-256-tal, átvitel közben TLS 1.2-vel vagy annál újabbal titkosítják, és GDPR szerepekre és felelősségekre adatfeldolgozási mellékletet kínálnak.
Zero data retention és amit a hibakeresésben kifizetsz
A zero data retention a legrosszul értett vezérlés ezen a területen, mert a szolgáltatók úgy írnak le róla, hogy „nem tároljuk az adataidat”, miközben szűkebb értelmet értenek alatta. A Claude API-n a megőrzési dokumentáció szerint a ZDR azt jelenti, hogy a prompteket és a válaszokat a válasz visszaadása után nem tárolják álló helyen. Szervezetenként, kérésre kapcsolható, minden szervezetnek külön be kell kapcsolnia, és van egy funkcióalkalmassági táblázat, amely megmondja, mely endpointokra és funkciókra vonatkozik valójában.
Ebben a táblázatban jelenik meg a mérnöki költség. Az eleve állapotfüggő funkciók nem alkalmasak ZDR-re: a Files API addig őrzi a fájlokat, amíg törölöd őket, a batch feldolgozás 29 napig tartja a jobokat, a kódvégrehajtó konténer 30 napig őriz adatot, a Managed Agents átiratok pedig addig maradnak, amíg törölöd őket. Némelyik inkább „feltételes”, mint tiszta: a strukturált kimenetek 24 óráig cache-elik a JSON sémádat, a prompt caching pedig a cache TTL idejére memóriában tartja a cache-ábrázolásokat. A prompt caching az érdekes eset a költségmunkához, erről bővebben a caching, routing és batching cikkben. Egyes modellek egyáltalán kimaradnak: a kijelölt Covered Models 30 napos megőrzést követelnek, és ZDR alatt nem érhetők el, ha az Anthropic nem engedélyezi.
Két következmény csíp. Először is, a hibakeresés éppen akkor lesz nehezebb, amikor a legjobban kellene. Ha nem tudsz egy beszélgetést visszajátszani a szolgáltatótól, akkor a saját tárolód az egyetlen nyom, vagyis magadnak kell egy maszkolt, minimalizált másolatot megőrizned – és tudnod kell, hogy ez szándékos döntés, nem mellékhatás. Másodszor a ZDR nem abszolút: ahol a törvény megköveteli, megőrzés továbbra is lehetséges, és az automatizált biztonsági és megfelelőségi rendszerek által megjelölt session bemenetei és kimenetei akár két évig megőrizhetők. Olvasd el a kivételekről szóló szakaszt, mielőtt bárkinek megígéred, hogy semmi sem marad meg.
Minimalizálás és álnevesítés a prompt előtt
A legolcsóbb adatvédelmi intézkedés nem a régióbeállítás; az az, hogy nem küldöd el az adatot. A GDPR Article 5(1)(c) cikke az adatminimalizálást úgy fogalmazza meg, hogy a személyes adatoknak „megfelelőnek, relevánsnak és a feldolgozás céljaihoz képest szükséges mértékben korlátozottnak” kell lenniük, és ez az elv a promptra ugyanúgy érvényes, mint az adatbázis oszlopára. Ha a modellnek tudnia kell, hogy egy megrendelés késik, küldd el a megrendelés státuszát, ne a vevő nevét, címét és megrendelési előzményeit.
Az álnevesítés a második emelő, és oda kell figyelni. A GDPR Article 4(5) cikke úgy definiálja, mint olyan feldolgozást, amelyben a személyes adatokhoz további információk felhasználása nélkül már nem lehet konkrét érintettet rendelni, feltéve, hogy ezeket a további információkat külön tárolják, és nem vonatkoznak rájuk olyan technikai és szervezési intézkedések, amelyekkel észszerűen újraazonosítani lehetne. Ez álnevesítés, nem anonimizálás: az adatok a GDPR szerint továbbra is személyes adatok, csak nem olvashatók egy nálad lévő keresés nélkül. Csak a valóban anonimizált adatok esnek ki a rendelet hatóköréből, és ezt a mércét a legtöbb prompt nem éri el.
// Illustrative pattern: resolve identifiers before the prompt, never in it
// PSEUDONYM_KEY comes from the environment, never from a file in the repo.
function buildPrompt(order) {
  const subjectRef = hmac(order.customerId, process.env.PSEUDONYM_KEY)
  return [
    `Customer ${subjectRef}: order ${order.id} is ${order.status}.`,
    `Ship to ${order.region}, carrier ${order.carrier}, ETA ${order.eta}.`,
  ].join('\n')
}
// The mapping subjectRef → customerId lives in your EU store, not in the prompt.
Két gyakorlati szokás dönt a különbségről. Cseréld ki a promptban a stabil azonosítókat egy kulcsolt hivatkozásra, amelyet szerveroldalon fel tudsz oldani, és a kulcsot tartsd a saját tárolódban – ez álnevesítés, és a prompt így már nem egy megnevezett személyről szóló nyom. És távolítsd el a kérés törzsét a saját trace-eidből: naplózz a prompt hashét, a tokenszámát és a modellt, nem a prompt szövegét, ha nincs konkrét okod és megőrzési határidejed. Mindkettő olcsó. Utólag elvégezni nem az.
Mikor helyes saját infrastruktúrán nyílt súlyú modellt futtatni az EU-ban
A self-hosting az egyetlen lehetőség a listán, ahol a régióra és a megőrzésre adott válasz az, hogy „ahová mi mondjuk”. Ha az adat semmilyen konfigurációban sem hagyhatja el az EU infrastruktúrát, vagy a terhelés elég állandó ahhoz, hogy a GPU-k költségét le tudd írni, egy nyílt súlyú modell futtatása a bérelt EU infrastruktúrán megszünteti a szolgáltató kérdését. Nincs határon átívelő inference lehetőség, amit auditálni kellene, mert nincs másik fél.
Amit átvállalsz, az a teljes üzemeltetési teher: kapacitástervezés és tartalék a csúcforgalomra, a runtime és a súlyok patchelése, a GPU tokenenkénti költségének figyelése egy hosztolt API árához képest, és – az a rész, amit a csapatok alábecsülik – az értékelési munka tulajdonlása, mert a minőség mostantól a saját kiszolgálási konfigurációdtól függ, nem egy más által kiadott verziószámtól. Ha már regressziós evaleket futtatsz a CI-ban, megvan hozzá a harness.
A szabályom: a szűk, nagy volumenű, kevésbé egyértelmű munkát futtasd magad – osztályozás, routing, kinyerés, olyan anyag összefoglalása, amelyet már minimalizáltál –, és tarts egy frontier modellt azokra a kérésekre, ahol a minőség tényleg a termék. A határ egy routingdöntés, tehát kódban van a helye, ahol mérni tudod, nem egy wikioldalon.
Egy architektúraminta, amit másolhatsz
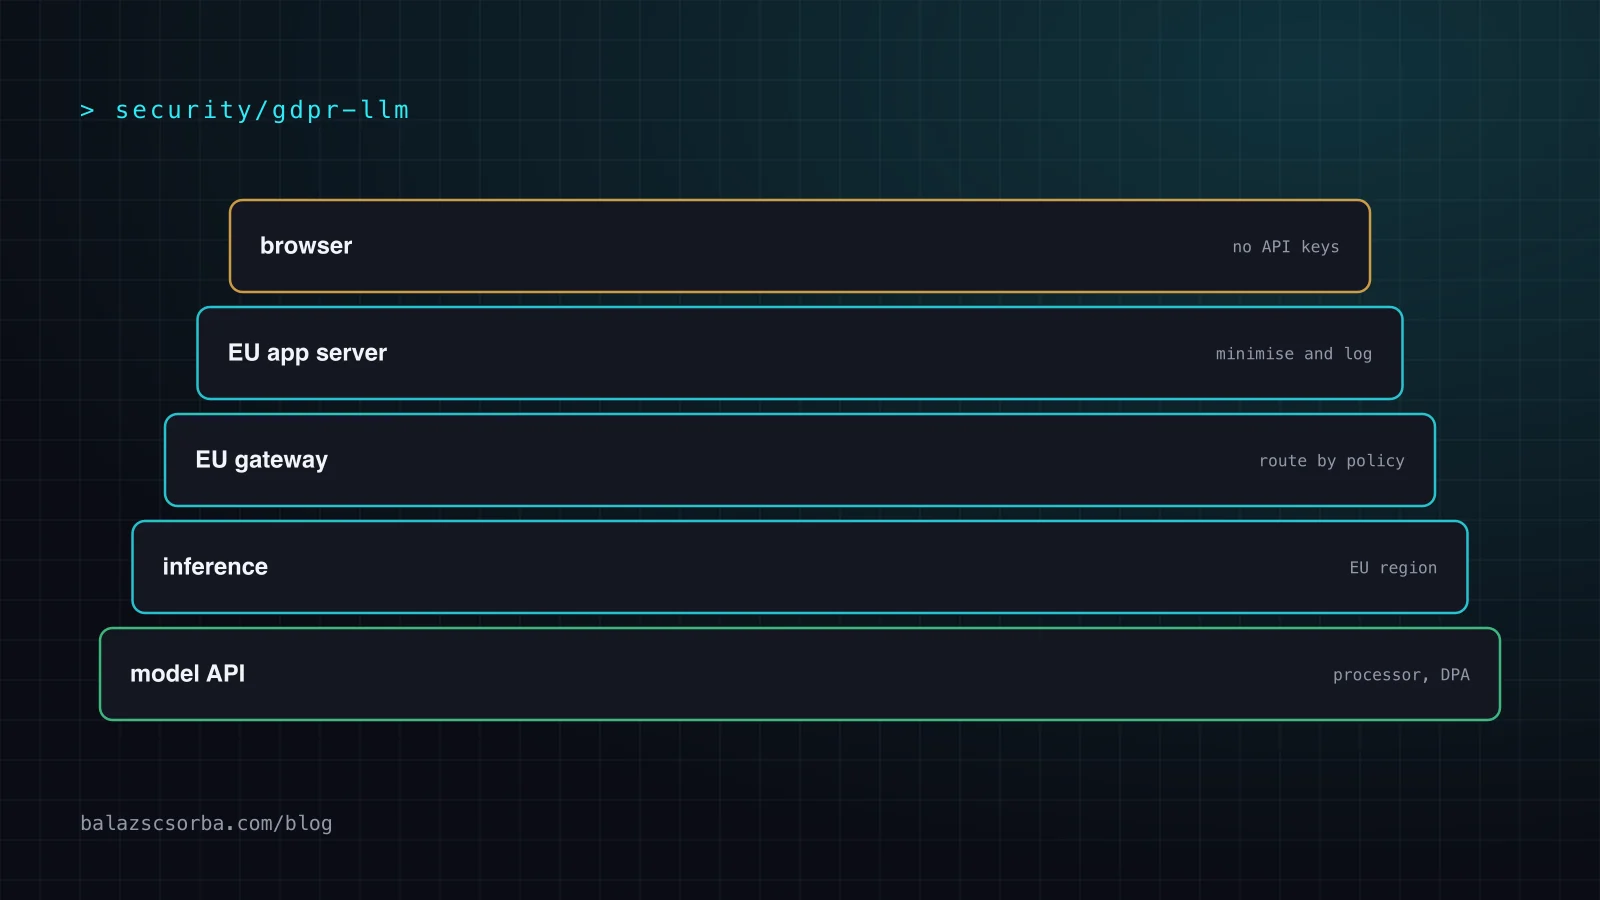
A dizájn, ami akkor is működik, amikor a szolgáltatók változnak, egy gateway az alkalmazásod és minden modell között, a szabály egy helyen. Az alkalmazáskód soha nem tart szolgáltatói kulcsot, és soha nem dönti el, hová mennek az adatok; a saját endpointodat hívja, a gateway pedig osztályozza a kérést, alkalmazza a minimalizálási szabályokat, kiválaszt egy útvonalat, és feljegyzi, mit tett.
Négy tulajdonság tartja meg a gatewayt. A szolgáltatói hitelesítő adatok csak a gatewayben élnek, így a böngésző soha nem tart kulcsot, és a kiszivárgó frontend bundle nem szivárogtat ki semmit. Az útvonalat egy szabályból választod, nem alapértelmezésből, így a „csak EU” egy konfigurációs változtatás egy teszttel a háta mögött. Minden kérés egy audit bejegyzést ad – útvonal, modell, régió, tokenszám, prompt hash –, és csak ezt az egy bejegyzést kell megőrizni. És a minimalizálási lépés a szolgáltatói hívás elé kerül, így a szabályok attól függetlenül érvényesek, melyik útvonal nyer.
Ugyanez a zónagondolkodás ott bukkan fel mindenhol, ahol egy ügynök elérheti az adatot: nem a tiltott célok blocklistje teszi valós határt, hanem az engedélyezett célok allowlistje. Ezt a mintát a kódoló ügynökök sandboxolásában a CI-ban tárgyaltam, és a gateway itt ugyanez az ötlet, csak a másik oldalon egy modellszolgáltatóval. Ha egyet szeretnél a saját stackjeidre, az épp az a munka, amelyet AI mérnökként végzek.
Források
- Claude API dokumentáció: Data residency (inference_geo, workspace geo, pricing)
- Claude API dokumentáció: API and data retention (a zero data retention hatóköre és alkalmassága)
- Claude API dokumentáció: Models overview (platform modellazonosítók, endpointtípusok)
- OpenAI: Introducing data residency in Europe
- Regulation (EU) 2016/679 (General Data Protection Regulation) – EUR-Lex
Gyakori kérdések
Van a Claude-nak EU adatrezidencia lehetősége?
2026 szeptemberében a first-party API-n nincs. Az inference_geo kérésparaméter csak a global értéket fogadja el, amelynél az inference bármelyik elérhető földrajzon futhat, és az us értéket, amelynél kizárólag amerikai infrastruktúrán fut. A workspace földrajza, amely az álló helyen történő tárolást szabályozza, csak az us értéket kínálja, és a workspace létrehozása után nem változtatható meg. Ugyanezek a modellek EU-régiókhoz Amazon Bedrocken vagy Google Cloudon érhetők el, ahol az általad megszólított endpoint határozza meg a régiót.
Mi a különbség az adatrezidencia és a zero data retention között?
Két független kapcsoló. Az adatrezidencia azt válaszolja meg, hol történik a feldolgozás; a zero data retention azt, hogy a válasz visszaadása után tárolnak-e még valamit. Egy szolgáltató adhatja az egyiket a másik nélkül. A Claude API-n a kizárólag amerikai inference adatrezidencia vezérlésként elérhető, amíg nincs EU-régió, a zero data retention pedig szervezetenként kapcsolható, de kizárja az állapotfüggő funkciókat, mint a Files API, a batch feldolgozás és a kódvégrehajtó konténerek.
Megfelel-e a GDPR-nak, ha az adatot álnevesíted, mielőtt elküldöd az LLM-nek?
Nem, és a megkülönböztetés számít. A GDPR Article 4(5) cikke az álnevesítést úgy definiálja, mint olyan feldolgozást, amelyben az adatokhoz külön tárolt további információk nélkül már nem lehet érintettet rendelni. Az így kezelt adatok továbbra is személyes adatok, és a GDPR továbbra is vonatkozik rájuk, tehát megmarad a jogalapod, az adatfeldolgozói szerződéseid és a megőrzési szabályaid. Csak a valóban anonimizált adatok, ami sokkal magasabb mérce, esnek ki a rendelet hatóköréből.
Elérhető-e az OpenAI EU adatrezidencia a meglévő API projektekhez?
Nem, az OpenAI bejelentése szerint. Az európai adatrezidencia úgy kapcsolható be, hogy új Projectet hozol létre az API Platform dashboardon, és Európát választod régiónak, a bejelentés pedig kimondja, hogy az európai adatrezidencia csak új Projectekhez konfigurálható, mert a meglévők a létrehozás után nem frissíthetők. Az ezeken a Projecteken át küldött kéréseket a régión belül, zero data retentiontel dolgozzák fel, és a bejelentés a jogosult endpointokra vonatkozik, ezért nézd meg a saját endpoint listádat, mielőtt erre megtervezel.
Mikor érdemes egy csapatnak saját infrastruktúrán nyílt súlyú modellt futtatni egy API hívása helyett?
Akkor, ha az adatnak minden konfigurációban az EU infrastruktúrán belül kell maradnia, vagy ha a terhelés elég állandó ahhoz, hogy a GPU-k költségét le lehessen írni. Utána a kapacitástervezés, a runtime és a súlyok patchelése, a tokenenkénti GPU-költség és az értékelési munka is a tiéd, mert a minőség mostantól a kiszolgálási konfigurációdtól függ. Egy szokásos felosztás az, hogy a szűk, nagy volumenű munkát, mint az osztályozás, a routing és a kinyerés, magad futtatod, a frontier modellt pedig azokra a kérésekre tartod, ahol a minőség a termék.