Blog/Sicherheit & Compliance
DSFA für einen LLM-Support-Assistenten: ein Beispiel nach Art. 35 DSGVO
Eine DSFA nach Art. 35 DSGVO für einen KI-Assistenten, der Kundenmails mit Bestelldaten beantwortet: wann sie nötig ist, welche Risiken bestehen und wer sie trägt.
Balázs Csorba··12 Min. Lesezeit
- DPIA
- GDPR
- LLM security
- Data protection
- AI Act
Das Wichtigste in Kürze
- Beginne mit dem Hochrisiko-Test, nicht mit dem Wort KI. Art. 35 Abs. 1 DSGVO und die Kriterien der WP29 entscheiden, und ein Feature, das Kundenmails liest und mit Bestelldaten verknüpft, kann mehrere davon zugleich erfüllen.
- In Österreich prüfe zuerst die Whitelist DSFA-AV. Die Kundenverwaltung kann dort ausgenommen sein, aber die Blacklist DSFA-V nennt künstliche Intelligenz. Hol dir deshalb eine rechtliche Einschätzung, bevor du dich auf die Ausnahme verlässt.
- Die LLM-Risiken sind konkret: erfundene personenbezogene Angaben, in einer Kundenmail versteckte Anweisungen, Protokolle beim Anbieter und Übermittlungen außerhalb der EU.
- Gib jeder Maßnahme einen Verantwortlichen und ein Restrisiko. Blende aus, was das Modell nicht braucht, lass jede Antwort von einer Person freigeben und übernimm Aufbewahrungs- und Trainingsregeln aus dem Vertrag, nicht von einer Webseite.
- Der AI Act ersetzt die DSFA nicht. Er bringt eigene Pflichten mit, etwa den Hinweis, dass Menschen mit einem KI-System sprechen, und Hochrisiko-Regeln für gelistete Einsatzfälle wie die Kreditwürdigkeitsprüfung.
Ein Support-Assistent, der Kundenmails liest, die Bestellung nachschlägt und eine Antwort entwirft, klingt nach einer kleinen Funktion. Für den Datenschutz ist sie nicht klein. Die E-Mail ist Freitext, der alles enthalten kann, der Bestelldatensatz enthält personenbezogene Daten, das Modell läuft bei einem Anbieter, und die Ausgabe geht an die Kundschaft zurück. Dieser Artikel durchdenkt eine Datenschutz-Folgenabschätzung (DSFA) genau für diese Funktion – für einen erfundenen Shop – und endet mit der Risikotabelle, die ich der für Datenschutz zuständigen Person vorlegen würde.
Meine Antwort vorab: Mach die Bewertung, bevor die erste Antwort live geht. Die DSGVO verlangt eine DSFA nur, wenn eine Verarbeitung voraussichtlich ein hohes Risiko birgt. Die WP29 empfiehlt sie aber überall dort, wo das unklar ist. In Österreich prüfe zuerst die nationalen Listen. Die Whitelist kann die Kundenverwaltung ausnehmen, während die Blacklist künstliche Intelligenz nennt. Wie du die Verarbeitung beschreibst, entscheidet also, welche Liste greift.
Wann eine DSFA nötig ist
Art. 35 Abs. 1 DSGVO verlangt eine DSFA vor einer Verarbeitung, die voraussichtlich ein hohes Risiko für die Rechte und Freiheiten natürlicher Personen birgt, insbesondere wenn neue Technologien eingesetzt werden. Art. 35 Abs. 3 nennt drei Fälle, in denen eine DSFA insbesondere erforderlich ist: eine systematische und umfassende Bewertung persönlicher Aspekte auf Grundlage automatisierter Verarbeitung, auf die Entscheidungen gestützt werden, die Personen erheblich beeinträchtigen; die umfangreiche Verarbeitung besonderer Kategorien oder strafrechtlicher Daten; und die systematische Überwachung öffentlich zugänglicher Bereiche in großem Umfang. Ein Support-Assistent fällt für sich genommen in keinen dieser Fälle, deshalb wird die Frage zum allgemeinen Hochrisiko-Test.
Die Leitlinien der WP29 WP248 rev.01, angenommen am 4. April 2017 und überarbeitet am 4. Oktober 2017, machen aus diesem Test neun Kriterien. Wenn unklar ist, ob eine DSFA nötig ist, empfiehlt die WP29, trotzdem eine durchzuführen. Vier der neun Kriterien sind hier relevant.
- Sensible Daten oder Daten mit besonders persönlichem Charakter. Die Leitlinien nennen persönliche Dokumente und E-Mails ausdrücklich als Daten, die unter dieses Kriterium fallen können, nicht nur die Kategorien aus Art. 9.
- Abgleich oder Zusammenführung von Datensätzen. Support-E-Mails und Bestelldatensätze werden für unterschiedliche Zwecke erhoben. Sie zusammenzuführen ist der Sinn der Funktion, und das kann über die Erwartungen der Kundschaft hinausgehen.
- Innovative Nutzung neuer Technologie. Die Leitlinien sagen, dass der Einsatz einer neuen Technologie die Notwendigkeit einer DSFA auslösen kann, und eine LLM-Funktion ist für die meisten Support-Teams neue Technologie.
- Umfangreiche Verarbeitung. Das hängt von der Zahl der Personen, der Menge und Bandbreite der Daten, der Dauer der Verarbeitung und ihrer geografischen Ausdehnung ab. Ein Shop mit vielen Kund:innen, langer Aufbewahrung und nationaler Reichweite kann mehrere dieser Faktoren erfüllen.
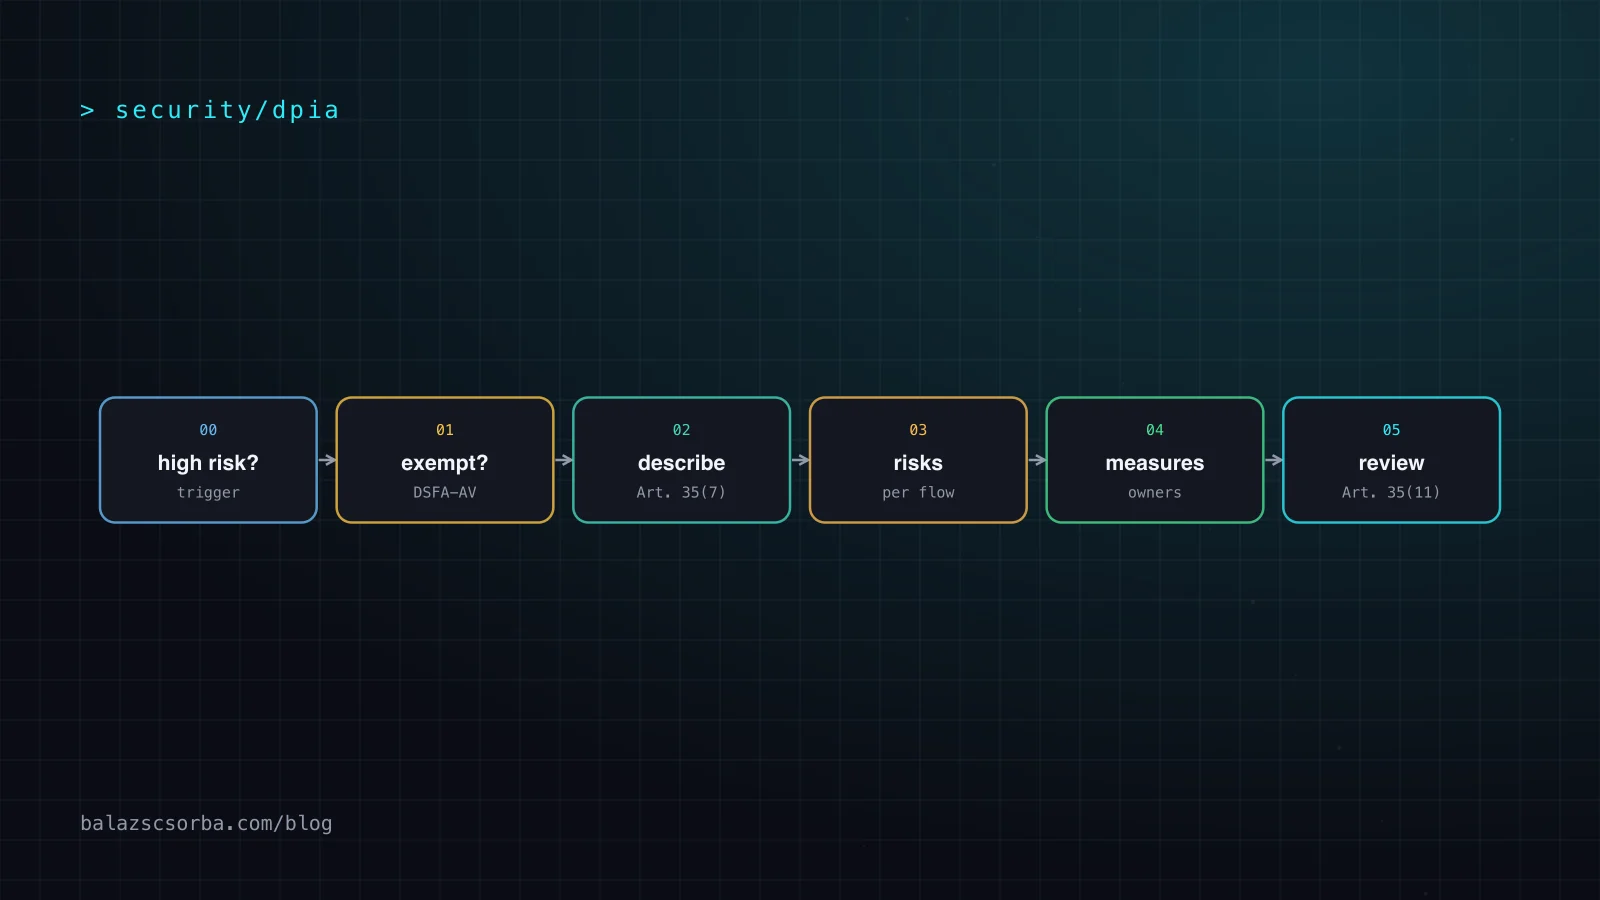
Die Leitlinien sagen, dass eine Verarbeitung, die zwei Kriterien erfüllt, in den meisten Fällen eine DSFA erfordert, und dass manchmal ein einziges Kriterium genügen kann. Nach meiner Lesart erfüllt diese Funktion mindestens drei der vier, die Bewertung ist also kein Grenzfall. Das Ablaufdiagramm unten zeigt die Reihenfolge der Fragen, die ich verwende.
Österreich: Blacklist und Whitelist
Österreich macht die Frage konkret. Nach § 2 Abs. 1 DSFA-V (BGBl. II Nr. 278/2018) ist eine DSFA erforderlich, wenn die Verarbeitung nach Art. 6, 9 und 10 DSGVO rechtmäßig ist und keine Ausnahme nach der DSFA-AV greift. § 2 Abs. 2 nennt sechs Kriterien, und eines genügt. Das Kriterium Z 4 betrifft Verarbeitungen mit neuen oder neuartigen Technologien und nennt künstliche Intelligenz ausdrücklich.
§ 2 Abs. 3 bietet einen zweiten Weg: Zwei oder mehr von fünf Kriterien lösen eine DSFA aus. Sie betreffen die umfangreiche Verarbeitung besonderer Datenkategorien, die umfangreiche Verarbeitung strafrechtlicher Daten, Standortdaten, schutzbedürftige Personen und den Abgleich von Datensätzen. Der Assistent könnte auch das Abgleichkriterium erfüllen.
Die Whitelist ist der Knackpunkt. Die DSFA-AV (BGBl. II Nr. 108/2018) befreit Verarbeitungen aus ihrer Anlage von der DSFA-Pflicht nach Art. 35 Abs. 1 und 5 DSGVO. Ihr Eintrag DSFA-A01 erfasst Kundenverwaltung, Buchhaltung, Logistik und Buchführung. Nach meiner Lesart des deutschen Textes geht es um personenbezogene Daten, die im Rahmen jeglicher Geschäftsbeziehung mit Kunden und Lieferanten verarbeitet werden, und das beschreibt das Support-Postfach eines Shops gut. Der Ausschluss richtet sich an Unternehmen, deren Tätigkeit die Verarbeitung von Daten über Dritte ist, die nicht ihre Kunden sind. Eine E-Mail, die einen Geschenkempfänger nennt, fällt nicht offensichtlich darunter, aber eine Prüfung könnte trotzdem fragen, ob das Postfach solche Daten enthält. Deshalb gehört die Begründung in das Verzeichnis.
Die ehrliche Antwort für einen österreichischen Shop lautet also so: Die Whitelist kann das einfache Support-Postfach abdecken. Der Assistent ist aber mehr als dieses Postfach. Er bringt eine Technologie mit, die die Blacklist nennt, und er schickt personenbezogene Daten an einen Anbieter außerhalb der eigenen Systeme des Shops. Ich würde die Bewertung nicht wegen der Whitelist aussetzen. Ich würde die Begründung für die Ausnahme festhalten, einer Rechtsberatung oder der österreichischen Datenschutzbehörde vorlegen und die volle Analyse trotzdem durchführen, weil die Risiken unten unabhängig davon gelten, welche Liste zutrifft.
Das Beispiel: ein Assistent für ein Support-Postfach
Der Beispiel-Shop verkauft Haushaltswaren online und erhält Support-E-Mails in einem gemeinsamen Postfach. Ein Assistent liest jede neue E-Mail, extrahiert die Bestellnummer, fragt im Bestellsystem Status, Artikel und Versandort ab und bittet einen LLM-Anbieter, eine Antwort in der Sprache der Kundschaft zu entwerfen. Eine Person aus dem Support-Team bearbeitet den Entwurf und schickt ihn ab. Prompts und Entwürfe werden für die Qualitätsprüfung protokolliert. Der Anbieter verarbeitet die Daten in den Vereinigten Staaten. Das ist eine Annahme für dieses Beispiel, und du solltest deinen eigenen Anbieter prüfen.
Zwei Designentscheidungen prägen alles Weitere. Das Modell entwirft nur. Es hat kein Werkzeug, das Mails verschickt, Bestellungen ändert oder eine Rückerstattung auslöst. Und der Prompt enthält die Bestellfelder, die die Antwort braucht, nicht den gesamten Kundendatensatz.
Systematische Beschreibung, Notwendigkeit und Verhältnismäßigkeit
Art. 35 Abs. 7 lit. a und b DSGVO verlangen eine systematische Beschreibung der Verarbeitung und ihrer Zwecke sowie eine Bewertung von Notwendigkeit und Verhältnismäßigkeit. Ich halte das im Verzeichnis der Verarbeitungstätigkeiten nach Art. 30 Abs. 1 fest und schreibe es als strukturierte Daten statt als Fließtext, damit sich der Eintrag vergleichen lässt, wenn sich die Funktion ändert. Ein minimaler Eintrag für das Beispiel sieht so aus:
# one entry per feature: the Article 30 record and the Article 35(7)(a) description
processing: support-email-drafts
purpose: draft a reply to an order enquiry; a person reviews and sends it
legal_basis:
  - Art. 6(1)(b): answering an enquiry about an existing order
prompt_fields:
  - order number, status, items, shipping city
  - email text with card and bank numbers masked
not_in_prompt:
  - full order history, account notes, marketing profile
recipients:
  - LLM provider as processor (Art. 28), documented instructions only
  - transfer to the United States: DPF certification or SCCs (Art. 46)
retention:
  - provider abuse logs: up to 30 days by default (provider documentation)
  - own prompt and draft log: <N> days, set by the data protection officer
review: new provider, new prompt field or any use of emails for training (Art. 35(11))
Aus dem Eintrag folgen drei Dinge. Erstens stützt sich die Beantwortung einer Anfrage zu einer bestehenden Bestellung auf Art. 6 Abs. 1 lit. b DSGVO, der die Verarbeitung abdeckt, die für einen Vertrag oder für Schritte auf Anfrage der betroffenen Person vor Vertragsschluss erforderlich ist. Zweitens ist die Nutzung der Entwürfe zur Qualitätsverbesserung ein anderer Zweck. Dafür braucht es ein berechtigtes Interesse nach Art. 6 Abs. 1 lit. f DSGVO, und der Abwägungstest ist die eigentliche Arbeit. Die Stellungnahme 28/2024 des EDSA zu KI-Modellen beschreibt einen Dreischritt-Test für das berechtigte Interesse, den ich hier anwenden würde: ein rechtmäßiges, klar formuliertes, tatsächliches und gegenwärtiges Interesse festlegen; prüfen, ob die Verarbeitung dafür erforderlich ist; und dann gegen die Rechte der betroffenen Personen abwägen, auch mit Blick darauf, was sie vernünftigerweise erwarten. Drittens muss die Datenschutzerklärung sagen, wann Daten in ein Drittland gehen und welche Garantie gilt, wie Art. 13 Abs. 1 lit. f DSGVO verlangt.
Zwei Sonderfälle brauchen eine eigene Zeile in der Beschreibung. Erstens können E-Mails Gesundheitsdaten oder andere besondere Kategorien enthalten, und eine Bestellung kann sie mittelbar offenlegen. Der EuGH hat in der Rechtssache C-184/20 entschieden, dass eine Verarbeitung, die sensible Informationen mittelbar offenbart, etwa durch Schlussfolgerung oder Verknüpfung, unter Art. 9 Abs. 1 DSGVO fällt. Eine Bestellung für ein Produkt, das einen Gesundheitszustand verrät, kann schon genügen. Deshalb sollte der Prompt keine Produkthistorie über die aktuelle Bestellung hinaus enthalten. Zweitens schützt Art. 22 Abs. 1 DSGVO Personen vor Entscheidungen, die allein auf automatisierter Verarbeitung beruhen und sie erheblich beeinträchtigen. Eine vom Modell getroffene Rückerstattung wäre ein Kandidat dafür. In diesem Design liest eine Person jede Antwort, bevor sie hinausgeht, und das Modell entscheidet nichts.
Risiken für die Menschen, die schreiben
Erfundene personenbezogene Angaben. Ein Modell kann ein Lieferdatum, einen Namen oder eine Adresse nennen, die nicht im Bestelldatensatz steht. Der Bericht der Taskforce ChatGPT des EDSA hält fest, dass der Zweck des Trainings nicht unbedingt korrekte Informationen ist und dass Endnutzer die Ausgaben wahrscheinlich für sachlich richtig halten. Der Grundsatz der Richtigkeit nach Art. 5 Abs. 1 lit. d DSGVO gilt trotzdem. Im Beispiel ist die Abwehr strukturell: Persönliche Angaben im Entwurf stammen nur aus dem Bestelldatensatz im Prompt, und eine Person prüft die Antwort, bevor sie hinausgeht.
Prompt Injection über die E-Mail selbst. Der E-Mail-Text ist nicht vertrauenswürdige Eingabe. OWASP beschreibt indirekte Prompt Injection als den Fall, dass ein LLM Eingaben aus externen Quellen wie Websites oder Dateien akzeptiert. Eine Kundin oder ein Kunde, oder jemand, der eine Nachricht weiterleitet, kann eine Anweisung einfügen, die Regeln zu ignorieren und andere Bestellungen aus derselben Stadt aufzulisten. Die Empfehlungen von OWASP umfassen, externe Inhalte zu trennen und zu kennzeichnen, das Least-Privilege-Prinzip durchzusetzen und für riskante Aktionen eine menschliche Freigabe zu verlangen. Hier hat das Modell gar keinen Zugriff auf die Datensätze anderer Kundschaft, und die bearbeitende Person sieht E-Mail und Entwurf nebeneinander. Zu den breiteren Mustern siehe meine Notiz zur Abwehr von Prompt Injection.
Abfluss über die Ausgabe. Die OWASP-Seite zur Offenlegung sensibler Informationen nennt personenbezogene Daten und Gesundheitsdaten unter den Daten, die über die Ausgabe eines Modells abfließen können, und empfiehlt strenge Zugriffskontrollen nach dem Least-Privilege-Prinzip. Der schlimmste Fall ist eine Antwort an Person A, die die Bestellung von Person B enthält, und das ist eine Verletzung des Schutzes personenbezogener Daten. Art. 32 Abs. 1 lit. b DSGVO verlangt die dauerhafte Vertraulichkeit und Integrität von Verarbeitungssystemen und -diensten. Art. 33 erwartet die Meldung an die Aufsichtsbehörde unverzüglich und möglichst innerhalb von 72 Stunden, nachdem die Verletzung bekannt wurde, wie Erwägungsgrund 85 erläutert. Das Maskieren vor dem Aufruf behandelt meine Notiz zur Schwärzung personenbezogener Daten in LLM-Pipelines.
Aufbewahrung beim Anbieter. Laut der Seite zu den Datenkontrollen von OpenAI werden Protokolle zur Missbrauchsüberwachung (Stand Oktober 2026) standardmäßig bis zu 30 Tage aufbewahrt, und Zero Data Retention braucht die vorherige Genehmigung durch OpenAI. Dieselbe Seite sagt, dass API-Daten seit März 2023 nicht zum Training verwendet werden, außer der Kunde stimmt ausdrücklich zu. Das sind Standardeinstellungen des Anbieters, die sich ändern können, deshalb muss der Vertrag festlegen, welche gilt, nicht die Webseite. Art. 28 Abs. 3 lit. a DSGVO verlangt, dass ein Auftragsverarbeiter nur auf dokumentierte Weisung handelt, auch bei Übermittlungen. Die Leitlinien 07/2020 des EDSA sagen, dass er nicht anders verarbeiten darf, als der Verantwortliche es anweist. Zu den breiteren Optionen siehe meine Notiz zu DSGVO und Datenresidenz bei LLM-APIs.
Übermittlungen. Der Angemessenheitsbeschluss (EU) 2023/1795 der Kommission vom 10. Juli 2023 stellt fest, dass die Vereinigten Staaten für Organisationen, die sich zum EU-US-Datenschutzrahmen zertifiziert haben, ein im Wesentlichen gleichwertiges Schutzniveau gewährleisten. Ist der Anbieter nicht zertifiziert, sind die von der Kommission angenommenen Standardvertragsklauseln nach Art. 46 DSGVO die Rückfalloption, wie Erwägungsgrund 108 beschreibt. Der Angemessenheitsbeschluss kann ausgesetzt, geändert oder aufgehoben werden, wenn der Schutz nicht mehr gewährleistet ist. Deshalb sollten die Klauseln bereitliegen, bevor du sie brauchst.
Training mit Kunden-E-Mails. Die Stellungnahme 28/2024 des EDSA sagt, dass die Frage, ob ein mit personenbezogenen Daten trainiertes KI-Modell anonym ist, im Einzelfall zu beurteilen ist, weil sich personenbezogene Daten aus dem Modell teils direkt oder über Anfragen extrahieren lassen. Sie hält außerdem fest, dass ein Modell, das auf unrechtmäßig verarbeiteten personenbezogenen Daten entwickelt wurde, die Rechtmäßigkeit seines späteren Einsatzes berühren kann, sofern das Modell nicht ordnungsgemäß anonymisiert ist. Die Funktion sollte deshalb keine Kunden-E-Mails für ein Feintuning verwenden. Jeder Plan dazu ist ein neuer Zweck, der eine eigene Bewertung braucht.
Maßnahmen, Verantwortliche und Restrisiko
Die Tabelle listet jedes Risiko mit meiner Einschätzung vor und nach den Maßnahmen sowie der Maßnahme, die die Einschätzung verändert. Verantwortlich sind Rollen statt Namen, damit das Verzeichnis Personalwechsel übersteht. Die Einstufungen sind meine Einschätzung für dieses Beispiel, keine gemessenen Werte.
| Risiko und Grundlage | Vorher | Maßnahme und Verantwortliche | Nachher |
|---|---|---|---|
| Erfundene personenbezogene Angaben im Entwurf (Art. 5 Abs. 1 lit. d) | Hohe Wahrscheinlichkeit, mittlere Auswirkung | Angaben nur aus dem Bestelldatensatz im Prompt; eine Person gibt jede Antwort frei (Support-Leitung, ML-Engineer) | Niedrig |
| Daten von Person B in der Antwort an Person A (Art. 32, Art. 33) | Mittlere Wahrscheinlichkeit, hohe Auswirkung | Abfrage auf den verifizierten Absender beschränkt; Test auf kundenübergreifende Datenlecks vor jeder Freigabe (Backend-Leitung) | Niedrig |
| In der E-Mail versteckte Anweisungen (OWASP LLM01) | Hohe Wahrscheinlichkeit, hohe Auswirkung | Keine Werkzeuge, die Mails verschicken oder Bestellungen ändern; E-Mail-Text als Daten behandeln; Red-Team-Set vor jeder Freigabe (Security-Engineer) | Mittel, bei der Prüfung abgefangen |
| Protokolle und Aufbewahrung beim Anbieter (Art. 28, Art. 5 Abs. 1 lit. e) | Standardmäßig wahrscheinlich, mittlere Auswirkung | Auftragsverarbeitungsvertrag mit dokumentierten Weisungen; schriftlich festgelegte Aufbewahrungsfrist; Zero Data Retention nur mit Genehmigung (Recht und Einkauf) | Niedrig bis mittel |
| Übermittlung an einen Anbieter außerhalb der EU (Art. 13 Abs. 1 lit. f, Art. 46) | Sicher, mittlere Auswirkung | DPF-Zertifizierung prüfen oder Standardvertragsklauseln unterzeichnen; Hinweis zur Übermittlung in der Datenschutzerklärung (Datenschutzbeauftragte:r) | Niedrig, bei Änderung des Angemessenheitsbeschlusses neu prüfen |
| Besondere Kategorien aus der Bestellhistorie abgeleitet (Art. 9 Abs. 1) | Mittlere Wahrscheinlichkeit, hohe Auswirkung | Nur die aktuelle Bestellung kommt in den Prompt; Produkthistorie, die Gesundheit verraten könnte, wird ausgeschlossen (Support-Leitung) | Niedrig |
| E-Mails für das Training verwendet (Art. 6 Abs. 1 lit. f, Stellungnahme 28/2024) | Geringe Wahrscheinlichkeit, hohe Auswirkung | Vertrag schließt Training mit API-Daten aus; kein Feintuning mit E-Mails ohne neue Bewertung (Product Owner) | Niedrig |
Keine Zeile bleibt nach den Maßnahmen hoch. Unter diesen Annahmen ist deshalb keine vorherige Konsultation nach Art. 36 nötig. Zwei Zeilen bleiben über dem Niveau „niedrig“: Prompt Injection und die Aufbewahrung beim Anbieter. Beide würde ich akzeptieren und dokumentieren, mit der Stellungnahme der Datenschutzbeauftragten.
Wie der EU AI Act hineinpasst
Der AI Act ersetzt die DSFA nicht, beide laufen parallel. Die Verordnung gilt nach Art. 113 ab dem 2. August 2026. Für einen Support-Assistenten ist die Transparenzpflicht die, die ich zuerst prüfen würde, so wie Erwägungsgrund 132 sie beschreibt: Menschen sollten darüber informiert werden, dass sie mit einem KI-System interagieren, außer das ist für eine angemessen informierte Person offensichtlich. Zu den Pflichten auf Entwicklerseite siehe meine Checkliste zu Art. 50. Erwägungsgrund 20 betont außerdem KI-Kompetenz für Anbieter, Betreiber und betroffene Personen, und auch darauf sollte man sich vorbereiten.
Hochrisiko-Pflichten sind eine andere Frage. Anhang III Nr. 5 Buchst. b führt KI-Systeme auf, die zur Bewertung der Kreditwürdigkeit natürlicher Personen oder zur Festlegung eines Kreditscores verwendet werden, mit einer Ausnahme für die Betrugserkennung. Ein Support-Assistent steht nicht auf dieser Liste. Die Verordnung (EU) 2026/1744 vom 8. Juli 2026, das Digital-Omnibus-Paket zur KI, verschiebt die Anwendungsdaten der Hochrisiko-Regeln nach Anhang III auf den 2. Dezember 2027 und die für Systeme nach Anhang I auf den 2. August 2028. Ihr Erwägungsgrund 40 hält den 2. August 2026 als allgemeines Anwendungsdatum fest. Die Transparenzpflichten nach Art. 50 hat die Änderung nicht verschoben: Sie gelten seit dem 2. August 2026.
Was ich zuerst tun würde
- Halte Zweck, Prompt-Felder und Aufbewahrung in einem Verzeichnis fest und schick es der für Datenschutz zuständigen Person, bevor der erste Pilot startet.
- Halte die Begründung der Whitelist schriftlich fest und hol dir eine rechtliche Einschätzung zu DSFA-A01 und zu Drittdaten in weitergeleiteten E-Mails.
- Begrenze den Prompt auf die Bestellfelder und eine maskierte E-Mail, und protokolliere nur, was die Qualitätsprüfung braucht.
- Baue ein Red-Team-Set aus echten E-Mails, inklusive eingeschleuster Anweisungen, und mach es zum Teil der Freigabeprüfung.
- Schließe die Auftragsverarbeitungsverträge mit dem Anbieter ab und übernimm die Einstellungen zu Aufbewahrung und Training aus dem Vertrag, nicht von einer Webseite.
- Lege die Auslöser für eine Überprüfung im Verzeichnis fest: einen neuen Anbieter, ein neues Prompt-Feld und jede Nutzung von E-Mails für das Training.
Quellen
- Verordnung (EU) 2016/679 (DSGVO), EUR-Lex
- WP29-Leitlinien zur DSFA, WP248 rev.01 (Seite der Europäischen Kommission)
- WP248 rev.01 als PDF, angenommen am 4. April 2017 und überarbeitet am 4. Oktober 2017
- EDSA-Leitlinien 07/2020 zu den Begriffen Verantwortlicher und Auftragsverarbeiter
- EDSA-Stellungnahme 28/2024 zu KI-Modellen, angenommen am 17. Dezember 2024
- EDSA-Pressemitteilung zur Stellungnahme 28/2024
- EDSA, Bericht über die Arbeit der Taskforce ChatGPT, 23. Mai 2024
- DSFA-V, BGBl. II Nr. 278/2018 (RIS)
- DSFA-AV, BGBl. II Nr. 108/2018 (RIS)
- OWASP Top 10 für LLM-Anwendungen 2025: LLM01 Prompt Injection
- OWASP Top 10 für LLM-Anwendungen 2025: LLM02 Offenlegung sensibler Informationen
- OpenAI, Datenkontrollen auf der OpenAI-Plattform
- Durchführungsbeschluss (EU) 2023/1795 der Kommission zum EU-US-Datenschutzrahmen
- EuGH, Rechtssache C-184/20, OT gegen Vyriausioji tarnybinės etikos komisija
- Verordnung (EU) 2024/1689 (AI Act), EUR-Lex
- Verordnung (EU) 2026/1744 (Digital-Omnibus zur KI), EUR-Lex
Häufige Fragen
Braucht jeder Support-Chatbot eine DSFA?
Nein. Art. 35 Abs. 1 DSGVO verlangt eine DSFA nur, wenn eine Verarbeitung voraussichtlich ein hohes Risiko birgt, und die Kriterien der WP29 helfen bei dieser Entscheidung. Eine Vorlage, die eine Antwort aus einem einzigen Feld füllt, erfüllt womöglich keines davon. Ein Assistent, der E-Mails liest, mit Bestelldaten verknüpft und an einen externen Anbieter schickt, kann mehrere erfüllen. Deshalb lohnt sich die Bewertung, und sie sollte schriftlich festgehalten werden.
Ist in Österreich eine DSFA für KI-Funktionen verpflichtend?
Sie kann es sein. § 2 DSFA-V (BGBl. II Nr. 278/2018) verlangt eine DSFA, wenn eines von sechs Kriterien zutrifft, und das Kriterium Z 4 nennt künstliche Intelligenz ausdrücklich. Verarbeitungen, die die DSFA-AV (BGBl. II Nr. 108/2018) ausnimmt, brauchen keine DSFA, und die Kundenverwaltung steht auf dieser Liste. Ob die Ausnahme auf die konkrete Verarbeitung passt, ist eine Rechtsfrage. Hol dir deshalb eine rechtliche Einschätzung, bevor du dich darauf stützt.
Was muss eine DSFA enthalten?
Art. 35 Abs. 7 DSGVO verlangt vier Dinge: eine systematische Beschreibung der Verarbeitung und ihrer Zwecke, einschließlich eines berechtigten Interesses, falls vorhanden; eine Bewertung von Notwendigkeit und Verhältnismäßigkeit; eine Bewertung der Risiken für die betroffenen Personen; und die geplanten Maßnahmen gegen diese Risiken, einschließlich Garantien und Sicherheit.
Wann muss ich die Aufsichtsbehörde konsultieren?
Nach Art. 36 DSGVO, wenn die DSFA zeigt, dass die Verarbeitung auch nach den geplanten Maßnahmen ein hohes Risiko birgt. Die Konsultation findet statt, bevor die Verarbeitung beginnt.
Ersetzt der EU AI Act die DSFA?
Nein. Der AI Act setzt eigene Pflichten, etwa den Hinweis, dass Menschen mit einem KI-System sprechen, und Hochrisiko-Regeln für gelistete Einsatzfälle. Die DSGVO-Pflicht, das Risiko für die Daten der Menschen zu bewerten, gilt daneben weiter.