Blog/Web-Engineering
Denial of Wallet: öffentliche LLM-Endpunkte in einer Nuxt-App absichern
Missbrauch und ausufernde Kosten auf einer öffentlichen LLM-Route in Nuxt stoppen: Auth, Rate Limits, Prompt-Limits, Token-Budgets, Turnstile, Spend Limits.
Balázs Csorba··14 Min. Lesezeit
- Nuxt
- LLM security
- Rate limiting
- OWASP
- Cost control
Das Wichtigste in Kürze
- Eine öffentliche LLM-Route ist eine nutzungsbasiert abgerechnete API mit Ihrer Kreditkarte dahinter; OWASP führt das Risiko als LLM10:2025 Unbounded Consumption.
- Vor den Modellaufruf gehört eine Session, und nie ein generischer Proxy: Der Server wählt Modell, System-Prompt und max_tokens.
- Anfragen pro Nutzer und pro IP in einem gemeinsamen Speicher begrenzen und Tokens getrennt davon, denn eine Anfrage kann tausendmal mehr kosten als eine andere.
- Vor dem Aufruf ein Token-Budget reservieren und danach mit dem tatsächlichen Verbrauch abrechnen, über einen atomaren Zähler.
- Spend Limits beim Anbieter sind die letzte Sicherung, nicht die Kontrolle: Sie schalten die Funktion für alle Nutzer gleichzeitig ab und greifen nicht sofort.
Eine LLM-Funktion auf einer öffentlichen Website ist eine nutzungsbasiert abgerechnete API mit Ihren Zahlungsdaten dahinter. Ein Kontaktassistent, ein Produktfinder oder ein Button „Seite zusammenfassen“ enden alle in einer Server-Route, die Text an ein Modell weiterreicht und pro Token bezahlt. Wenn diese Route jedem beliebig oft mit beliebiger Eingabe antwortet, ist nicht die Frage, ob jemand sie als kostenlose Modell-API nutzt, sondern nur wann.
Dieser Artikel ist die Kosten- und Missbrauchsseite von LLM-Funktionen in Nuxt. Er übersetzt das OWASP-Risiko LLM10:2025 Unbounded Consumption in konkrete Schichten einer Nuxt- und Nitro-App: Sessions, Anfrage- und Token-Limits, Prompt-Größenlimits, Budgets pro Nutzer, Cloudflare Turnstile und die Spend Limits von OpenAI und Anthropic, mit Code zum Anpassen.
Was ist Denial of Wallet?
OWASP beschreibt Unbounded Consumption als LLM-Anwendung, die Nutzern „übermäßige und unkontrollierte Inferenzen“ erlaubt, was zu Denial of Service, wirtschaftlichen Verlusten, Modelldiebstahl und verschlechtertem Dienst führt. Denial of Wallet ist die kostenorientierte Variante: Ein Angreifer erzeugt übermäßig viele Operationen, um das nutzungsbasierte Abrechnungsmodell von Cloud-KI-Diensten auszunutzen, und verursacht untragbare Kosten. Dafür muss nichts ausfallen; der Schaden ist die Rechnung.
LLM-Routen sind aus zwei Gründen exponierter als gewöhnliche API-Routen. Die Kosten pro Anfrage sind variabel und hoch: Eine Anfrage mit langem Gesprächsverlauf und langer Antwort kann um Größenordnungen mehr kosten als eine einzeilige Frage. Und die Ausgabe ist für den Angreifer direkt nützlich, ein offener Chat-Endpunkt lohnt sich also zum Skripten, auch wenn er mit Ihrem Produkt nichts zu tun hat.
Welche Missbrauchsmuster treffen öffentliche LLM-Routen?
Der OWASP-Eintrag nennt sieben Beispiele. Auf eine typische Nuxt-Funktion übertragen, bleiben wenige Muster mit jeweils einer Hauptmaßnahme:
| Muster | Wie es aussieht | Hauptmaßnahme |
|---|---|---|
| Trittbrett-Proxy (Denial of Wallet) | Skripte nutzen Ihre Route als kostenlose Modell-API; Prompts ohne Bezug zum Produkt | Session, fester System-Prompt, Token-Budget pro Nutzer |
| Wiederholte Anfragen | Hohe Anfragerate von wenigen Konten oder IPs | Rate Limits an der Edge und pro Nutzer |
| Variable-Length Input Flood, Continuous Input Overflow | Riesige Bodies, eingefügte Dokumente, wachsende Verläufe | Body-Limit, Schema-Validierung, Token-Obergrenze |
| Ressourcenintensive Anfragen | Sehr lange Ausgaben, Tool-Schleifen, aufwendiges Reasoning | max_tokens auf dem Server, Schrittlimits, Timeouts |
| Modellextraktion und funktionale Replikation | Systematische Anfragen, die Ausgaben als Trainingsdaten sammeln | Volumenlimits, keine Logprobs, Anomalie-Monitoring |
Ein sechstes Muster benennt OWASP nicht, aber jedes Team erlebt es: selbst verursachter Verbrauch. Eine Retry-Schleife ohne Obergrenze, ein Agent, der immer weiter Tools aufruft, oder ein Client-Bug, der bei jedem Tastendruck den ganzen Verlauf schickt, verbrennen Budget genau wie ein Angreifer. Dieselben Limits fangen das ab.
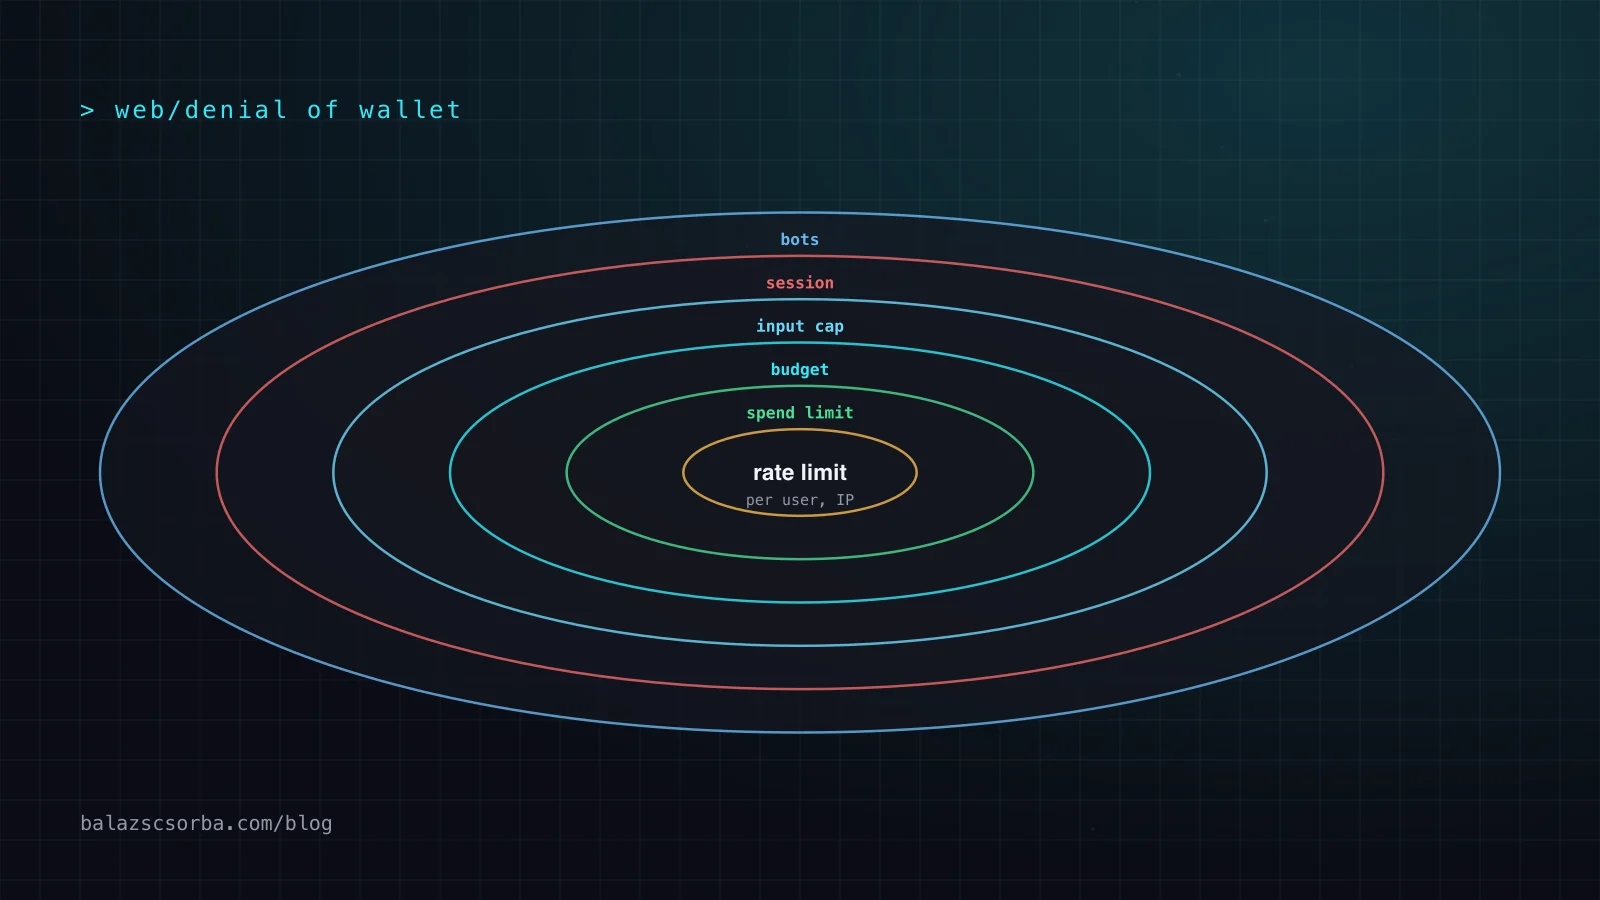
Wie sieht eine mehrschichtige Abwehr aus?
Keine einzelne Maßnahme reicht, weil jede etwas anderes misst. Ein Rate Limiter zählt Anfragen, ein Größenlimit Bytes, ein Budget Tokens und ein Spend Limit Geld. Ich ordne sie von der billigsten zur teuersten Prüfung, damit abgewiesener Verkehr so wenig wie möglich kostet:
Warum kommt die Authentifizierung zuerst?
Jedes andere Limit braucht eine Identität, an der es hängt. Ohne Session ist der einzige Schlüssel die IP-Adresse, und die ist schwach. Mit nuxt-auth-utils liefert requireUserSession(event) die Session oder antwortet mit 401, die erste Zeile des Handlers entscheidet also, ob der Modellaufruf überhaupt stattfinden darf. Für eine Funktion, die vor dem Login funktionieren muss, etwa einen Produktfinder, nach einer Bot-Prüfung eine leichte anonyme Session ausgeben und ihr ein deutlich kleineres Budget geben als einem eingeloggten Kunden.
Die zweite Regel: Nie einen generischen Proxy ausliefern. Wenn der Client Modell, System-Prompt, max_tokens oder Tools wählen kann, ist Ihr Endpunkt eine offene Modell-API mit Umweg. Der Client schickt eine Nachricht und eventuell eine Gesprächs-ID; alles andere entscheidet der Server. So bleibt auch der API-Schlüssel auf dem Server, wie in LLM-Funktionen in Nuxt ausliefern beschrieben.
Wie limitiert man pro Nutzer und pro IP?
Das Modul nuxt-security bringt einen Rate Limiter mit, der standardmäßig global aktiv ist: 150 Anfragen pro 300.000 ms pro IP, gespeichert in einem LRU-Cache, mit 429 Too Many Requests bei Überschreitung. Er lässt sich pro Route über routeRules einstellen, und als Speicher dient jeder unstorage-Treiber. Die eigene Dokumentation ist ehrlich zu den Grenzen: Der eingebaute Rate Limiter sei „nicht für komplexe Produktionsanwendungen geeignet“, empfohlen werden Lösungen auf Infrastrukturebene.
Für eine LLM-Route heißt das drei Anpassungen. Einen gemeinsamen Speicher verwenden, denn ein LRU-Cache im Speicher gilt pro Instanz und wird bei jedem Deploy zurückgesetzt. Auf der Modellroute ein viel engeres Limit setzen als auf dem Rest der Site. Und die Client-IP korrekt ermitteln: getRequestIP aus h3 liest X-Forwarded-For nur nach ausdrücklicher Aktivierung, weil der erste Eintrag Client-Eingabe ist; hinter Cloudflare kann die Option ipHeader von nuxt-security stattdessen auf cf-connecting-ip zeigen.
// nuxt.config.ts (illustrative)
export default defineNuxtConfig({
  modules: ['nuxt-security', 'nuxt-auth-utils'],
  security: {
    rateLimiter: {
      driver: { name: 'redis', options: { url: process.env.REDIS_URL } },
      ipHeader: 'cf-connecting-ip', // only if Cloudflare sits in front
    },
  },
  routeRules: {
    '/api/chat': {
      security: {
        rateLimiter: { tokensPerInterval: 20, interval: 60_000 },
        requestSizeLimiter: { maxRequestSizeInBytes: 32_000 },
      },
    },
  },
})
Dieser Limiter arbeitet pro IP. Das Limit pro Nutzer gehört in den Handler, nach requireUserSession, mit der Nutzer-ID als Schlüssel. Welcher Algorithmus dort läuft, ist weniger wichtig, als überhaupt konsequent einen zu nutzen; die Abwägungen, wie Upstash sie dokumentiert:
| Algorithmus | Stärke | Schwäche |
|---|---|---|
| Festes Fenster | Sehr günstig bei Speicher und Rechenaufwand | Bursts an Fenstergrenzen rutschen durch; Ansturm bei jedem neuen Fenster |
| Gleitendes Fenster | Behebt das Grenzproblem | Mehr Speicher und Rechenaufwand; eine Näherung |
| Token Bucket | Glättet Bursts; erlaubt einen höheren Anfangs-Burst | Mehr Zustand, über den man nachdenken muss |
Anthropics eigene API nutzt einen Token Bucket, der kontinuierlich bis zum Limit aufgefüllt statt in festen Abständen zurückgesetzt wird, ein vernünftiges Vorbild für eine Chat-Funktion, in der Nutzer schubweise tippen.
Wie begrenzt man Prompt-Größe und Ausgabe?
Ein Anfragelimit sagt nichts darüber, was jede Anfrage kostet. Die Eingabe in drei Schritten deckeln. Zuerst Bytes: Der Request Size Limiter von nuxt-security antwortet über maxRequestSizeInBytes mit 413 Payload Too Large, Standard ist 2.000.000; eine Chatnachricht braucht wenige Kilobyte. Dann die Form: den Body mit readValidatedBody und einem Schema prüfen, das die Nachrichtenlänge begrenzt. Dann Tokens: vor dem Aufruf zählen.
Das größte Loch ist meist der Gesprächsverlauf. Schickt der Client bei jedem Zug das ganze Gespräch, kann ein Angreifer einen erfundenen Verlauf beliebiger Länge senden. Den Verlauf auf dem Server halten, mit der Gesprächs-ID als Schlüssel, und auf eine feste Zahl von Zügen oder Tokens kürzen. Der Token-Counting-Endpunkt von Anthropic ist kostenlos, hat ein eigenes, von der Nachrichtenerstellung getrenntes Rate Limit und liefert eine Schätzung der Eingabe-Tokens, das genügt für eine Obergrenze.
Die Ausgabe deckelt max_tokens, gesetzt auf dem Server. Wichtig ist, was es tut und was nicht: Für Anthropics Rate Limits werden Ausgabe-Tokens gezählt, während sie entstehen, und max_tokens fließt nicht in die Berechnung der Ausgabe-Tokens pro Minute ein. Es ist eine Kostenobergrenze pro Anfrage, keine Ratensteuerung, das Budget aus dem nächsten Abschnitt braucht es trotzdem.
// server/api/chat.post.ts (illustrative)
import { z } from 'zod'

const Body = z.object({
  conversationId: z.string().uuid(),
  message: z.string().min(1).max(4000),
})
const MAX_INPUT = 12_000   // tokens, after history trimming
const MAX_OUTPUT = 800     // the server decides, never the client

export default defineEventHandler(async (event) => {
  const { user } = await requireUserSession(event)          // 401 without a session
  const body = await readValidatedBody(event, Body.parse)    // 400 on bad or long input

  const history = await loadHistory(user.id, body.conversationId, { maxTurns: 10 })
  const messages = [...history, { role: 'user', content: body.message }]

  const { input_tokens } = await anthropic.messages.countTokens({ model: MODEL, system: SYSTEM, messages })
  if (input_tokens > MAX_INPUT) throw createError({ statusCode: 413, statusMessage: 'Conversation too long' })

  const reserved = input_tokens + MAX_OUTPUT
  const key = await reserveTokens(user.id, reserved)          // null when the daily budget is spent
  if (!key) throw createError({ statusCode: 429, statusMessage: 'Daily limit reached' })

  let used = 0
  try {
    const res = await anthropic.messages.create({ model: MODEL, system: SYSTEM, messages, max_tokens: MAX_OUTPUT })
    const u = res.usage
    used = u.input_tokens + (u.cache_creation_input_tokens ?? 0) + (u.cache_read_input_tokens ?? 0) + u.output_tokens
    await saveTurn(user.id, body.conversationId, body.message, res.content)
    return res.content
  } finally {
    await settleTokens(key, reserved, used)                   // refund the unused part
  }
})
Wie setzt man Token-Budgets pro Nutzer durch?
Ein Budget ist die Maßnahme, die Kosten tatsächlich begrenzt: Tokens pro Nutzer und Tag oder pro anonymer Session und Stunde. Mein Muster ist Reservieren, dann Abrechnen. Vor dem Aufruf den schlimmsten Fall reservieren, also gezählte Eingabe plus max_tokens. Würde die Reservierung das Budget überschreiten, mit 429 ablehnen. Nach dem Aufruf mit dem tatsächlichen Verbrauch aus der Antwort abrechnen und die Differenz gutschreiben. Parallele Anfragen desselben Nutzers können dann nicht überziehen, weil jede ihren Anteil schon beansprucht hat.
Der Zähler muss atomar sein. Ein getItem gefolgt von setItem über den Nitro-Speicher ist ein Read-Modify-Write, zwei parallele Anfragen können beide den alten Wert lesen. Redis INCRBY liefert die neue Summe in einem Schritt, Prüfung und Reservierung können sich also nicht überholen:
// server/utils/budget.ts (illustrative, ioredis)
const DAILY_TOKENS = 200_000

export async function reserveTokens(userId: string, n: number) {
  const key = `llm:budget:${userId}:${new Date().toISOString().slice(0, 10)}`
  const total = await redis.incrby(key, n)
  if (total === n) await redis.expire(key, 60 * 60 * 48)
  if (total > DAILY_TOKENS) { await redis.decrby(key, n); return null }
  return key
}

export async function settleTokens(key: string, reserved: number, used: number) {
  if (reserved > used) await redis.decrby(key, reserved - used)
}
Beim Abrechnen alle Eingabe-Tokens zählen. Mit Prompt Caching umfasst Anthropics input_tokens nur die Tokens nach dem letzten Cache-Breakpoint; die gesamte Eingabe ist cache_read_input_tokens + cache_creation_input_tokens + input_tokens. Ob man gecachte Tokens zum niedrigeren Preis gewichtet, ist eine Produktentscheidung; ein schlichtes Token-Budget ist Nutzern leichter zu erklären. Zur Kostenseite von Caching und Routing siehe Prompt Caching und Model Routing.
Wo passen CAPTCHAs und Turnstile hin?
Eine Bot-Prüfung verteuert Automatisierung; sie deckelt keine Kosten. Ich setze sie dort ein, wo eine Identität entsteht, etwa bevor eine anonyme Chat-Session ausgegeben wird, nicht bei jeder Nachricht. Bei Cloudflare Turnstile ist die serverseitige Validierung über die Siteverify-API Pflicht, denn das Client-Widget allein schützt nichts: Tokens lassen sich fälschen, jedes Token ist 300 Sekunden gültig und kann nur einmal validiert werden, eine Wiederverwendung wird als timeout-or-duplicate abgelehnt.
// server/api/session/anonymous.post.ts (illustrative)
export default defineEventHandler(async (event) => {
  const { token } = await readBody<{ token: string }>(event)
  const r = await $fetch<{ success: boolean }>('https://challenges.cloudflare.com/turnstile/v0/siteverify', {
    method: 'POST',
    body: { secret: useRuntimeConfig().turnstileSecret, response: token, remoteip: getRequestIP(event) },
  })
  if (!r.success) throw createError({ statusCode: 403 })
  await setUserSession(event, { user: { id: crypto.randomUUID(), tier: 'anonymous' } })
  return { ok: true }
})Was fangen Spend Limits beim Anbieter ab?
Beide großen Anbieter erlauben eine monatliche Ausgabengrenze, und man sollte sie unter dem Betrag setzen, der weh täte. Aber man sollte das Verhalten kennen: Diese Limits stoppen sämtlichen Verkehr in ihrem Geltungsbereich, für alle Nutzer, bis der Monat zurückgesetzt wird oder man sie anhebt.
| Aspekt | Claude API (Anthropic) | OpenAI API |
|---|---|---|
| Selbst gesetztes Limit | Spend Limit pro Organisation unter der Tier-Grenze; eigene Spend- und Rate Limits pro Workspace | Hard Spend Limit pro Organisation oder Projekt; Spend Alerts, die nur benachrichtigen |
| Antwort beim Erreichen | HTTP 400 invalid_request_error, „You have reached your specified API usage limits“ | HTTP 429 mit organization_spend_limit_exceeded oder project_spend_limit_exceeded |
| Eingebaute Obergrenze | Monatliche Tier-Grenze: Start 500, Build 1.000, Scale 200.000 USD; 429 enforced_spend_limit_reached ohne retry-after | Monatliche Nutzungslimits pro Usage Tier |
| Einschränkung | Für den Default-Workspace lassen sich keine Workspace-Limits setzen | „Enforcement is not instantaneous“; die erfasste Ausgabe kann das Limit leicht überschreiten |
Zwei praktische Folgen. Jeder öffentlichen Funktion einen eigenen Anthropic-Workspace oder ein eigenes OpenAI-Projekt mit eigenem Schlüssel und Limit geben, damit ein außer Kontrolle geratener Chatbot nicht Ihre internen Werkzeuge stoppt. Und die Spend-Limit-Antworten ausdrücklich behandeln: Die SDKs wiederholen 429er automatisch, und laut Anthropic schlagen Wiederholungen fehl, bis der Zugang zurückkehrt. Auf einen freundlichen Zustand „vorübergehend nicht verfügbar“ abbilden und jemanden alarmieren.
Was sollte man überwachen und alarmieren?
Zu den Maßnahmen von OWASP gehören umfassendes Logging mit Anomalieerkennung und Graceful Degradation. In einer Nuxt-App heißt das einige Kennzahlen pro Funktion, protokolliert mit Nutzer-ID und Gesprächs-ID:
- Tokens pro Nutzer und Tag, mit Alarm, wenn der Spitzennutzer weit über dem Median liegt. Trittbrettfahrer tauchen hier zuerst auf.
- Ablehnungen pro Schicht: 401, 413 und 429 pro Stunde. Ein plötzlicher Anstieg der Budget-429er heißt, dass jemand sondiert.
- Eingabe-Tokens pro Anfrage als Verteilung, nicht als Durchschnitt. Ein langer Ausläufer bedeutet zu lockere Verlaufs- oder Größenlimits.
- Tageskosten pro Funktion gegen eine Baseline, mit einem Spend Alert beim Anbieter deutlich unter dem Hard Limit.
Abstufen, bevor man abschaltet. Überschreiten die Ausgaben eine Schwelle, zuerst anonyme Nutzer abschalten, dann eingeloggte Nutzer auf ein kleineres Modell umstellen und die Funktion für zahlende Kunden am Leben halten. Das ist ein weit besserer Ausfallmodus, als wenn das Anbieterlimit alles auf einmal abschaltet. Zum Tracing der Aufrufe hinter diesen Zahlen siehe Observability für LLM-Agenten.
Checkliste für eine öffentliche LLM-Route
- Der API-Schlüssel liegt nur in der Server-Runtime-Config; der Client sieht ihn nie.
- Die Route verlangt eine Session; anonyme Sessions gibt es nur nach serverseitig geprüfter Bot-Kontrolle.
- Modell, System-Prompt, Tools und
max_tokenssind auf dem Server festgelegt. - Anfragelimits pro IP an der Edge und pro Nutzer im Handler, in einem gemeinsamen Speicher.
- Body-Limit, Schema-Validierung, serverseitiger Verlauf und Token-Obergrenze vor dem Aufruf.
- Ein tägliches Token-Budget pro Nutzer mit atomarem Reservieren und Abrechnen.
- Begrenzte Retries, Tool-Schritte und Timeouts, damit der eigene Code nicht in Schleifen gerät.
- Ein eigener Workspace oder ein eigenes Projekt beim Anbieter pro Funktion, mit Spend Alert und Hard Limit.
- Alarme bei Token-Ausreißern pro Nutzer, Ablehnungsspitzen und Tageskosten, dazu ein Abstufungsplan.
Kostenmissbrauch ist die eine Hälfte des Risikos; die andere ist, was das Modell mit feindlicher Eingabe macht. Dazu siehe Abwehr von Prompt Injection.
Quellen
- OWASP GenAI Security Project: LLM10:2025 Unbounded Consumption
- Nuxt Security: Rate Limiter middleware
- Nuxt Security: Request Size Limiter middleware
- nuxt-auth-utils: README (GitHub)
- h3: request utilities (getRequestIP, readValidatedBody)
- Upstash: Ratelimiting algorithms
- Cloudflare Turnstile: Validate the token
- Claude Platform Docs: Rate limits and spend limits
- Claude Platform Docs: Token counting
- OpenAI API Docs: Spend limits
- OpenAI API Docs: Rate limits
Häufige Fragen
Was ist Denial of Wallet?
Denial of Wallet ist ein Angriff auf einen nutzungsbasiert abgerechneten Dienst, bei dem es um Kosten statt um Ausfall geht. OWASP nennt ihn als Beispiel für LLM10:2025 Unbounded Consumption: Ein Angreifer erzeugt so viele Operationen, dass die Rechnung für den Betreiber untragbar wird.
Reicht der Rate Limiter von nuxt-security für einen LLM-Endpunkt?
Er ist eine gute erste Schicht, aber laut eigener Dokumentation ist der eingebaute Rate Limiter nicht für komplexe Produktionsanwendungen geeignet. Er zählt Anfragen, keine Tokens, und sein Standard-LRU-Cache gilt pro Serverinstanz. Kombinieren Sie ihn mit einem Limit an der Edge und einem Token-Budget pro Nutzer in einem gemeinsamen Speicher wie Redis.
Soll ich nach IP oder nach Nutzer limitieren?
Beides. IP-Limits schützen die Routen, die vor dem Login funktionieren, und bremsen einfache Fluten. Für die Kosten zählen die Limits pro Nutzer, denn viele legitime Nutzer können sich eine IP teilen, und ein Angreifer kann viele IPs durchwechseln.
Wie begrenze ich die Länge von Prompts?
Die Größe des Request-Bodys begrenzen, die Nachrichtenlänge mit einem Schema prüfen, den Gesprächsverlauf auf dem Server halten statt ihn vom Client anzunehmen, und vor dem Modellaufruf die Token-Zahl prüfen. max_tokens auf dem Server setzen, um die Ausgabe zu deckeln.
Schützen mich Spend Limits des Anbieters vor Missbrauch?
Nur als letzte Instanz. Hard Limits bei OpenAI und Spend Limits bei Anthropic stoppen beim Erreichen den gesamten Verkehr der Organisation, des Projekts oder Workspaces, ein Angreifer legt die Funktion damit für alle lahm. OpenAI weist außerdem darauf hin, dass die Durchsetzung nicht sofort erfolgt und die Ausgaben das Limit leicht überschreiten können.