Tools/LLMOps & Evals
DeepEval-Test: pytest für LLM-Ausgaben, samt Richter-Rechnung
DeepEval führt LLM-Prüfungen als pytest-artige Tests aus, mit eingebauten Richter-Metriken. Die Bibliothek ist frei; Richter-Aufrufe und Datenfluss kosten.
- Art
- Evaluation framework
- Preis
- Apache-2.0 · free; Confident AI from $0, Starter $200 a month
Balázs Csorba··8 Min. Lesezeit
- LLM evaluation
- pytest
- LLM-as-a-judge
- Red teaming
- Open source
Das Wichtigste in Kürze
- DeepEval ist ein Apache-2.0-Framework für Python, das LLM-Prüfungen als Unit-Tests ausführt, und die Bibliothek funktioniert ohne Konto.
- Die meisten vordefinierten Metriken nutzen ein anderes Modell als Richter, daher kann jeder Lauf Token kosten und einen anderen Wert liefern.
- Mit den Standardeinstellungen ist der Richter OpenAI, Testfälle verlassen also dein Netz. Ein lokaler Richter wie Ollama hält sie drinnen, mit einer Qualität, die du messen musst.
- Confident AI hat einen kostenlosen Tarif, Starter für $200 im Monat und Team für $2.000 im Monat, mit einem AVV für jeden Kunden und einer EU-Region in jedem Tarif.
- Wähle Ragas, Promptfoo oder Braintrust für ein Apache-2.0-Metrik-Toolkit, eine deklarative CLI mit Red Teaming oder eine gehostete Oberfläche mit eigener Abrechnung.
DeepEval ist ein Open-Source-Framework für Python, das LLM-Prüfungen als Unit-Tests ausführt, mit mehr als dreißig eingebauten Metriken und einer optionalen Cloud-Plattform namens Confident AI. Das Urteil vorweg: Nimm es, wenn deine Entwickler:innen Python schreiben, Tests schon in der CI laufen lassen und das Verhalten des Modells bei jedem Pull Request prüfen wollen. Lass es weg, wenn der Standard-Richter OpenAI für deine Daten nicht akzeptabel ist oder wenn Nicht-Entwickler:innen zuerst einen gehosteten Arbeitsbereich brauchen.
Es steht neben Ragas, Promptfoo und Braintrust, die ich separat besprochen habe. Zum Prozess rund um die Tests, vom Lesen der Traces von Hand bis zu einem Gate in der CI, siehe LLM-Evals für Produktfunktionen.
Was es ist
DeepEval ist die Apache-2.0-Bibliothek hinter Confident AI, das sich selbst als Plattform für KI-Evals und Observability in Unternehmen beschreibt. Die Bibliothek läuft auf deinem Rechner und braucht kein Konto. Die aktuelle Version auf PyPI ist 4.2.8, veröffentlicht am 2. Oktober 2026, und sie braucht Python 3.9 oder neuer. Installiere sie mit pip install -U deepeval.
- Metriken. Mehr als dreißig benannte Metriken in neun Gruppen, von G-Eval und Agenten-Metriken bis zu Retrieval-, Mehrfach-Gesprächs-, Sicherheits- und Bildprüfungen.
- Richter. Fast alle vordefinierten Metriken nutzen ein LLM als Richter, und du kannst sie auf OpenAI, Azure OpenAI, Anthropic, Gemini, Ollama oder LiteLLM richten.
- Red Teaming. Ein eigenes Apache-2.0-Paket, DeepTeam, deckt Angriffe und Schwachstellen ab.
So funktioniert es
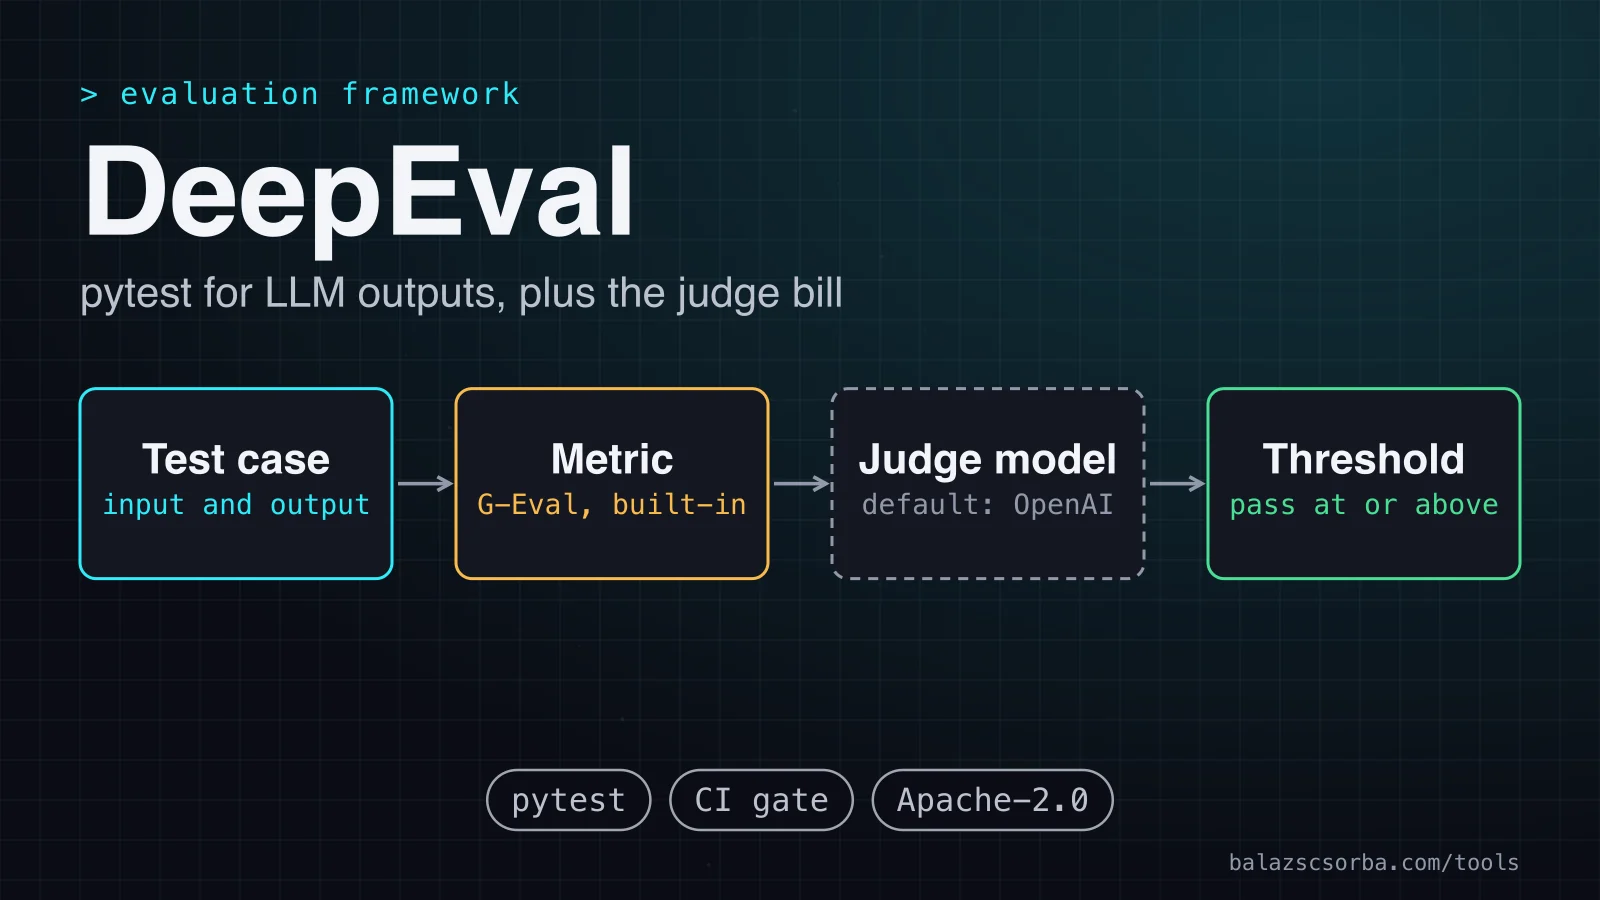
Ein Test ist gewöhnliches Python. Jede Metrik bekommt einen Testfall, der Eingabe, tatsächliche Ausgabe und je nach Metrik die erwartete Ausgabe, den Retrieval-Kontext oder die Werkzeuge enthält, die der Agent aufgerufen hat. Bei einer richterbasierten Metrik gehen Testfall und Kriterien an das Richtermodell, das einen Wert von 0 bis 1 und eine Begründung zurückgibt. Der Schwellenwert macht daraus Bestanden oder Nicht bestanden, und assert_test lässt den Test fehlschlagen, wenn der Wert darunter liegt.
Der Richter ist der Teil, der bei Kosten und Verlässlichkeit zählt. Die Metrikseite sagt, dass fast alle vordefinierten Metriken ein LLM als Richter nutzen und dass jeder Richter verwendet werden kann, darunter OpenAI, Azure OpenAI, Ollama, Anthropic, Gemini und LiteLLM. Du kannst auch dein eigenes Modell einbinden, indem du von DeepEvalBaseLLM ableitest. Die FAQ sagt, dass der Richter standardmäßig OpenAI ist, wenn du kein Modell angibst.
Erste Schritte
Setze einen OpenAI-Schlüssel für den Richter, installiere das Paket und schreibe den Test in eine Datei wie test_example.py. Das Beispiel prüft eine Antwort mit G-Eval, bei dem du die Kriterien in einfacher Sprache beschreibst und DeepEval daraus die Bewertungsschritte erzeugt. Starte es mit deepeval test run test_example.py. Der Test schlägt fehl, wenn der Korrektheitswert unter 0,5 liegt.
# test_example.py
from deepeval import assert_test
from deepeval.metrics import GEval
from deepeval.test_case import LLMTestCase, SingleTurnParams


def test_refund_answer():
    correctness = GEval(
        name='Correctness',
        criteria='Is the actual output a correct answer to the input, consistent with the expected output?',
        evaluation_params=[
            SingleTurnParams.INPUT,
            SingleTurnParams.ACTUAL_OUTPUT,
            SingleTurnParams.EXPECTED_OUTPUT,
        ],
        threshold=0.5,
    )
    test_case = LLMTestCase(
        input='Can I return shoes after 30 days?',
        actual_output='You can return them within 30 days of delivery, if they are unworn.',
        expected_output='Returns are accepted within 30 days of delivery if the item is unworn.',
    )
    assert_test(test_case, [correctness])
Metriken und was der Richter kostet
Die Wahl der Metrik entscheidet über die Rechnung. Faithfulness extrahiert die Behauptungen in einer Antwort, prüft jede gegen den Retrieval-Kontext und bewertet den Anteil der Behauptungen, die dem Kontext nicht widersprechen, mit einem Standard-Schwellenwert von 0,5. Der Richter hat mehr zu lesen, wenn eine Antwort viele Behauptungen macht, also wächst die Rechnung mit der Länge der Antwort. evaluate() bringt Caching, Parallelisierung, Kostenverfolgung und Fehlerbehandlung mit, während ein einzelner measure()-Aufruf diese Optimierungen verliert. Die Doku warnt außerdem, dass viele Metrikaufrufe gleichzeitig Rate-Limit-Fehler auslösen können, deshalb begrenze die Parallelität auf das Limit deines Anbieters.
| Gruppe | Benannte Metriken |
|---|---|
| Benutzerdefiniert | G-Eval, DAG, Arena G-Eval, JevEval und eigene Code-Metriken wie BLEU oder ROUGE |
| Agenten, Verlauf | Task Completion, Step Efficiency, Plan Adherence, Plan Quality |
| Agenten, Komponenten | Tool Correctness, Argument Correctness |
| Retriever | Contextual Relevancy, Contextual Precision, Contextual Recall |
| Generator | Answer Relevancy, Faithfulness |
| Mehrfach-Chatbots | Knowledge Retention, Role Adherence, Conversation Completeness, Conversation Relevancy |
| Sicherheit | Bias, Toxicity, Non-Advice, Misuse, PIILeakage, Role Violation |
| Bild | Image Coherence, Image Helpfulness, Image Reference, Text-to-Image, Image-Editing |
| Sonstige | Hallucination, JSON Correctness, Summarization, Ragas |
Goldens, Red Teaming und CI
Handgeschriebene Testfälle gehen schnell aus, deshalb kann DeepEval sie erzeugen. generate_goldens_from_docs nimmt eine Liste von Dokumentpfaden, liest .txt-, .docx-, .pdf- und Markdown-Dateien, legt die Abschnitte in chromadb ab und lässt ein Kritikermodell jeden Abschnitt von 0 bis 1 bewerten. Standardmäßig bekommt jedes Golden auch eine erwartete Ausgabe. Ohne OpenAI-Schlüssel musst du ein eigenes Embedding-Modell und ein eigenes LLM stellen, denn der Standard-Embedder ist text-embedding-3-small. Die Doku beschreibt keinen Prüfschritt, also lass jemanden eine Stichprobe lesen, bevor ein erzeugter Satz zur Regressionssuite wird.
Red Teaming ist ein eigenes Paket. DeepTeam ist ein Apache-2.0-Framework, um LLMs und KI-Agenten im Red Teaming zu prüfen, mit mehr als 50 fertigen Schwachstellen und mehr als 20 forschungsbasierten Angriffsmethoden, mit Einzel- und Mehrfachgesprächen. Seine richterbasierten Metriken laufen auf deinem Rechner und liefern Bestanden oder Nicht bestanden mit Begründung. Es ordnet seine Prüfungen den OWASP Top 10 für LLMs 2025, den OWASP Top 10 für Agenten 2026, dem NIST AI RMF und MITRE ATLAS zu, und es wird mit pip install -U deepteam installiert. Das KI-Red-Teaming-Modul der Plattform liegt laut Preisseite im Tarif Enterprise ++.
Das CI-Muster in der Doku ist kurz. Lege den Richter-Schlüssel als OPENAI_API_KEY in den Secrets ab, füge CONFIDENT_API_KEY nur hinzu, wenn die Ergebnisse auf der Plattform landen sollen, und führe deepeval test run aus. Ohne den Schlüssel laufen dieselben Tests trotzdem lokal. Mit --official (oder -o) markierst du einen Lauf als offizielle Baseline auf Confident AI.
- name: Run LLM tests
  env:
    OPENAI_API_KEY: ${{ secrets.OPENAI_API_KEY }}
    CONFIDENT_API_KEY: ${{ secrets.CONFIDENT_API_KEY }}
  run: poetry run deepeval test run test_llm_app.py
Kosten und Betrieb
Die Bibliothek kostet außer dem Richter nichts im Betrieb. Die Plattform hat vier Tarife, monatlich je Organisation abgerechnet, und die Preisseite trägt kein Datum, also prüfe sie erneut, bevor du planst.
| Tarif | Preis | Enthalten | Was dazukommt |
|---|---|---|---|
| Free | $0 | 2 Plätze, 1 Projekt, 1 GB-Monat Trace-Daten | 5 Testläufe pro Woche |
| Starter | $200 im Monat | Unbegrenzte Plätze, 5 Projekte, 5 GB-Monate, danach $1 pro GB-Monat | Online-Evals, Annotations-Warteschlangen, Echtzeit-Warnungen |
| Team | $2.000 im Monat | Unbegrenzte Plätze und Projekte, 75 GB-Monate, danach $1 pro GB-Monat | SOC 2, SSO, eigene Rollen, individuelle Verträge und SLAs |
| Enterprise | Individuell | Unbegrenzte Nutzung | On-Prem, eigene Datenresidenz, 24x7-Support, Red-Teaming-Modul (Enterprise ++) |
Zum Vergleich: Die Starter-Stufe von Braintrust ist kostenlos mit 14 Tagen Aufbewahrung, und der Pro-Tarif kostet $249 im Monat, mit verarbeiteten Daten zu $3 pro GB und Scores zu $1,50 pro 1.000 über den enthaltenen Mengen. Der Starter-Tarif von Confident AI kostet pauschal $200 im Monat ohne Gebühr pro Platz und enthält Online-Evals und Annotations-Warteschlangen.
Es gibt drei getrennte Datenflüsse, die verschiedene Fragen beantworten. Der Richter bekommt den Testfall, also geht ohne konfiguriertes Modell dieser Inhalt an OpenAI, von deinem Laptop oder vom CI-Runner aus. Confident AI bekommt Ergebnisse nur, wenn CONFIDENT_API_KEY gesetzt ist, und die GitHub-README sagt, dass bei Nutzung der Cloud-Plattform alle Testfälle automatisch protokolliert werden. Telemetrie ist der dritte Fluss: Standardmäßig sendet DeepEval grundlegende, nicht identifizierende Zählwerte, etwa wie viele Auswertungen liefen und welche Metriken genutzt wurden, und die Datenschutzseite nennt PostHog als einziges Ziel. Mit DEEPEVAL_TELEMETRY_OPT_OUT=1 schaltest du das ab.
Auf der Plattform speichert die FAQ die Daten in einer privaten AWS-Cloud, auf die nur deine Organisation zugreifen kann. Die Standardregion sind die Vereinigten Staaten, und die EU ist in jedem Tarif verfügbar. Wähle sie beim Login oder bei der Anmeldung, oder führe deepeval set-confident-region EU aus, was nur DeepEval konfiguriert. Die Regionsseite ergänzt, dass ein API-Schlüssel allein nicht bestimmt, wohin die Daten gehen, also setze auch die beiden Endpunkte.
deepeval set-confident-region EU
export CONFIDENT_BASE_URL=https://eu.api.confident-ai.com
export CONFIDENT_OTEL_ENDPOINT=https://eu.otel.confident-ai.com/v1/traces
Für den Vertrag gilt: Die Liste der Unterauftragsverarbeiter, zuletzt geändert am 18. Februar 2026, sagt, dass jeder Kunde einen Auftragsverarbeitungsvertrag (AVV) bekommt. Personenbezogene Daten bleiben in der gewählten Region, außer sie müssen aus Gründen der Leistung oder Verfügbarkeit oder nach Vereinbarung verschoben werden. Die Liste nennt OpenAI für die Ausführung von KI-Modellen, nur USA, und AWS, ClickHouse, Supabase und PostHog als USA und Europa. Eine Aufbewahrungsfrist für die Cloud habe ich auf keiner der geöffneten Seiten gefunden, also verlange sie schriftlich, bevor Produktionsdaten hineinkommen. Selbst hosten ist eine Enterprise-Option, und die On-Prem-Variante richtet dieselben zwei Variablen auf deine eigenen Hosts.
Wo es zu kurz greift
Drei Schwächen wiegen am schwersten. Erstens sind die Werte nicht wiederholbar: Die G-Eval-Doku sagt, die Metrik sei nicht deterministisch, also kippt ein Wert nahe am Schwellenwert gelegentlich, und der Richter begrenzt die Qualität alles, was du mit ihm misst. Zweitens ist die Oberfläche groß. Die Metrikliste ist lang, der Dokumentweg für erzeugte Goldens braucht chromadb und mehrere LangChain-Pakete, und die Doku zeigt einen TypeScript-Befehl neben dem Python-Befehl, obwohl alles, was ich für diese Rezension geprüft habe, Python ist. Drittens sind die Preisstufen grob. Der Free-Tarif mit fünf Testläufen pro Woche trägt keine stark genutzte Pipeline, und der Sprung von $200 auf $2.000 im Monat ist groß für ein Team, das nur einen gemeinsamen Verlauf will.
Fazit
DeepEval ist der richtige Standard für ein Python-Team, das LLM-Verhaltenstests im selben Runner und im selben Pull Request wie den Rest seiner Suite haben will. Bibliothek und DeepTeam sind beide Apache-2.0, die Metrikliste deckt Agenten, Retrieval, Gespräche und Sicherheit ab, ohne dass du eigene Richter schreibst, und der lokale Modus funktioniert ohne Konto. Ich würde es nicht einsetzen, wenn die Testdaten keinen Richter erreichen dürfen, dem du vertraust, oder wenn Nicht-Entwickler:innen vom ersten Tag an einen gehosteten Arbeitsbereich brauchen. Wähle in diesen Fällen eine Alternative.
- Ragas, wenn du ein Apache-2.0-Toolkit mit vorgefertigten Metriken und Testdaten-Generierung willst und die Plattform von Confident AI nicht brauchst.
- Promptfoo, wenn du deklarative Konfigurationen willst, die Prompts und Modelle in der Kommandozeile und in der CI vergleichen, mit Red Teaming im selben Werkzeug. Das MIT-lizenzierte Repository sagt jetzt, dass Promptfoo Teil von OpenAI ist, also wäge das gegen deine Anbieter-Regeln ab.
- Braintrust, wenn du eine gehostete Oberfläche und einen Klick-AVV im Pro-Tarif willst und du seine Abrechnung akzeptierst, bei der Nutzung über die enthaltenen Daten und Scores hinaus zusätzlich zu den $249 im Monat berechnet wird.
Quellen
- DeepEval-Dokumentation: Erste Schritte
- GitHub: confident-ai/deepeval, README und Lizenz
- PyPI: deepeval, neueste Version und Python-Anforderung
- DeepEval-Dokumentation: Einführung in die Metriken
- DeepEval-Dokumentation: G-Eval
- DeepEval-Dokumentation: Faithfulness
- DeepEval-Dokumentation: Tool Correctness
- DeepEval-Dokumentation: Goldens aus Dokumenten erzeugen
- DeepEval-Dokumentation: Unit-Tests in CI/CD
- DeepEval-FAQ
- DeepEval-Dokumentation: Datenschutz
- GitHub: confident-ai/deepteam, das Red-Teaming-Framework
- Confident AI: Preise
- Confident AI-Dokumentation: Datenresidenz
- Confident AI: Liste der Unterauftragsverarbeiter
- GitHub: explodinggradients/ragas, README
- GitHub: promptfoo/promptfoo, README
- Braintrust: Preise
Häufige Fragen
Sendet DeepEval meine Daten irgendwohin?
Ja, an das Richtermodell, das du konfigurierst. Ohne gesetztes Modell gilt laut FAQ OpenAI als Standard. Ergebnisse gehen nur an Confident AI, wenn du einen Schlüssel setzt, und der Standard-Speicherort sind die Vereinigten Staaten; die EU ist in jedem Tarif verfügbar.
Was kostet DeepEval?
Die Bibliothek ist unter Apache-2.0-Lizenz kostenlos. Confident AI hat einen kostenlosen Tarif mit zwei Plätzen und fünf Testläufen pro Woche, dazu Starter für $200 im Monat und Team für $2.000 im Monat, monatlich je Organisation abgerechnet. Richter-Aufrufe kommen extra hinzu und hängen vom Modell ab, das du wählst.
Sind die Werte wiederholbar?
Nicht genau. Die G-Eval-Doku sagt, die Metrik sei nicht deterministisch. Gib Schwellenwerten also etwas Spielraum und wiederhole einen fehlgeschlagenen Fall, bevor du ihn als Regression wertest. Tool Correctness ist anders, weil der Kernwert deterministisch ist.
Kann ich ein lokales Modell als Richter nutzen?
Ja. Die Metrikseite nennt Ollama unter den Richtern, und jedes andere Modell kannst du einbinden, indem du von DeepEvalBaseLLM ableitest. Prüfe den Richter an Fällen, die du selbst beschriftet hast, denn ein schwächerer Richter verschiebt jeden Wert.