Tools/LLMOps & Evals
DSPy im Test: Prompts gegen eine Metrik kompilieren, nicht von Hand
DSPy erzeugt Prompts aus Signaturen, einer Metrik und Beispielen. Was Optimierer an Modellaufrufen kosten und wann ein handgeschriebener Prompt besser ist.
- Art
- Prompt optimisation framework
- Preis
- MIT · free, you pay the model API
Balázs Csorba··8 Min. Lesezeit
- Prompt optimisation
- LLM programs
- MIPROv2
- GEPA
- Python
Das Wichtigste in Kürze
- DSPy ersetzt handgeschriebene Prompts durch Signaturen, Module und Optimierer, die anhand einer Metrik, die du schreibst, bessere Prompts suchen.
- Ein Optimierungslauf wird in Modellaufrufen bezahlt. Bei MIPROv2 mit light macht ein Programm mit einem Prädiktor etwa 750 davon, vor dem Bootstrapping.
- Schreibe zuerst die Metrik. Ein Optimierer kann nur verbessern, was die Metrik misst, und genau dort steckt der meiste Aufwand.
- Ein kompiliertes Programm ist eine JSON-Datei mit Anweisungen und Demonstrationen. Sie gehört unter Versionskontrolle, und ihre Demonstrationen sind deine Trainingsdaten.
- Für einen Prompt auf einem stabilen Modell sind ein geprüfter Prompt und eine Eval-Suite einfacher. DSPy lohnt sich bei mehrstufigen Pipelines, die sich ändern.
DSPy ist ein quelloffenes Python-Framework, das eine LLM-Pipeline wie Code behandelt. Du deklarierst Ein- und Ausgaben, wählst ein Modul und lässt einen Optimierer nach den Anweisungen und Beispielen suchen, die auf deiner Metrik am besten abschneiden. Das Urteil vorweg: Nimm es für eine Pipeline mit mehreren Modellaufrufen, die du messen kannst und die sich ändern wird. Lass die Finger davon bei einem einzelnen Prompt auf einem stabilen Modell – ein geprüfter Prompt und eine Eval-Suite sind einfacher.
Was es ist
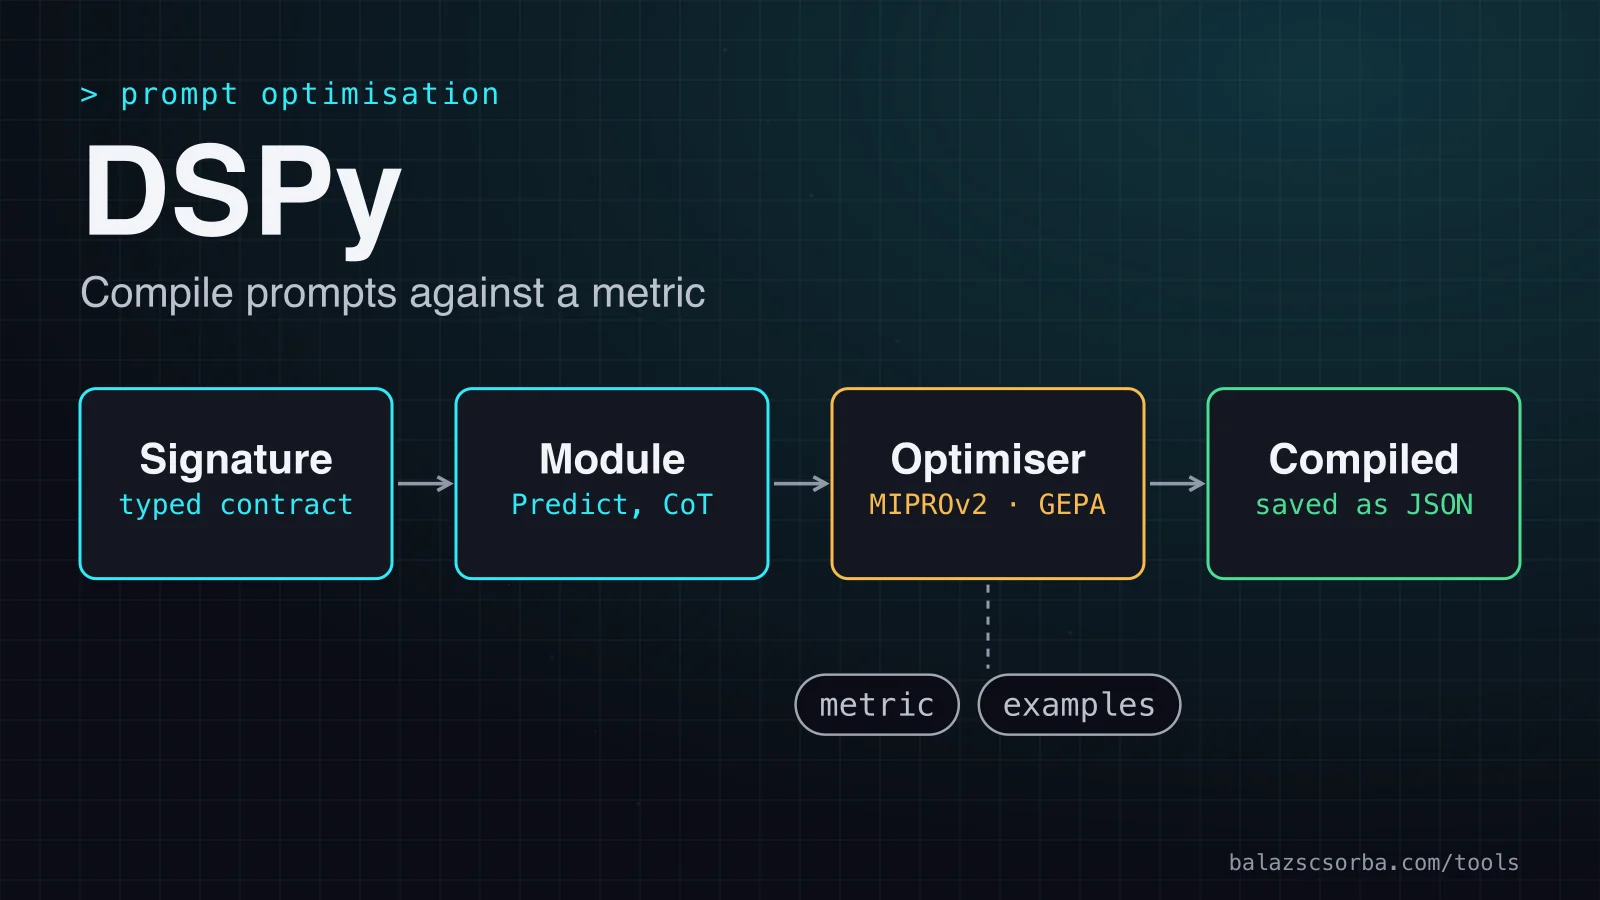
DSPy nennt sich das Framework zum Programmieren, nicht zum Prompten, von Sprachmodellen. Signaturen beschreiben, was hineingeht und was herauskommt. Module entscheiden, wie das Modell gefragt wird, von einer einfachen Vorhersage bis zu schrittweiser Begründung oder einer Tool-Schleife. Optimierer kompilieren ein Programm gegen eine Metrik, indem sie Anweisungen und Few-Shot-Beispiele ändern. Es liegt zwischen Prompt Engineering und Feintuning: Der Prompt wird zu einem Artefakt, das der Optimierer schreibt. Für die größere Entscheidung lies meinen Entscheidungsleitfaden zu Prompting, Retrieval und Feintuning.
- MIT-Lizenz, kostenlos nutzbar. Installation mit
pip install dspy, Python 3.10 oder neuer. - Neueste Version 3.4.0, veröffentlicht am 25. September. Das Repository zeigte bei meiner Prüfung 38.6k Sterne.
- 14 Optimierer in der API-Referenz, von BootstrapFewShot über MIPROv2 und GEPA bis BootstrapFinetune.
- Kein gehosteter Dienst, den ich finden konnte. Er läuft in deinem Prozess und ruft den Provider auf, den du einrichtest.
So funktioniert es
Ein Modul baut auf einer Signatur auf. Zur Laufzeit macht der Adapter aus der Signatur die Systemnachricht, das Modell antwortet, und DSPy zerlegt die Antwort in die Ausgabefelder. Ohne Optimierer ist das Programm nur so gut wie seine Formulierung. Der Optimierer bekommt eine Metrik dazu, eine Python-Funktion, die eine Vorhersage bewertet, meist von 0.0 bis 1.0, dazu Beispieleingaben. Er lässt das Programm über die Beispiele laufen, schlägt neue Anweisungen und Demonstrationen vor, behält die beste Kombination und gibt ein kompiliertes Programm zurück.
Erste Schritte
import os
import dspy

lm = dspy.LM("openai/gpt-5-nano", api_key=os.environ["OPENAI_API_KEY"])
dspy.configure(lm=lm)


class ExtractIntent(dspy.Signature):
    """Classify the customer's intent in one short email."""

    email: str = dspy.InputField()
    intent: str = dspy.OutputField(desc="one of: order, return, invoice, other")


extract = dspy.ChainOfThought(ExtractIntent)


def intent_metric(example, prediction, trace=None):
    return float(prediction.intent.strip().lower() == example.intent.strip().lower())


trainset = [
    dspy.Example(email="Where is my parcel 4411?", intent="order").with_inputs("email"),
    dspy.Example(email="I want my money back for the shoes.", intent="return").with_inputs("email"),
    # more labelled emails from your own inbox
]

optimizer = dspy.MIPROv2(metric=intent_metric, auto="light")
compiled = optimizer.compile(extract, trainset=trainset)
compiled.save("intent_v1.json")
Die Metrik vergleicht das vorhergesagte Label mit dem gelabelten, deshalb braucht dieses Beispiel Labels. Der compile-Aufruf ist die Stelle, an der die Kosten entstehen: light macht Hunderte Modellaufrufe. Lauf ihn also zuerst auf einem kleinen Satz, prüfe die gespeicherte Datei und skaliere erst dann.
Signaturen und Module
Eine Signatur ist der Vertrag. Die Stringform, etwa question -> answer, ist eine Kurzschreibweise. Die Klassenform ergänzt einen Docstring, der zur Anweisung wird, und typisierte Felder. Die Reihenfolge zählt, denn das Umsortieren von Ein- oder Ausgaben ändert den Prompt. Behandle jede Änderung an einer Signatur wie eine Prompt-Änderung und teste sie.
- dspy.Predict bildet Eingaben mit einem Sprachmodell auf Ausgaben ab. Seine Schlüsselwortargumente gehen an das Modell.
- dspy.ChainOfThought begründet zuerst Schritt für Schritt. Es ergänzt ein Begründungsfeld, das du anpassen kannst.
- dspy.ReAct führt eine Schleife aus Denken und Handeln über Tools aus. Sein max_iters ist standardmäßig 20.
Die Startseite fasst das als „gleiche Schnittstelle, andere Strategie“ zusammen. Die Strategie bestimmt auch die Rechnung: Begründungsfelder fügen jedem Aufruf Ausgabe-Tokens hinzu, und jeder ReAct-Schritt ist ein weiterer Modellaufruf.
Optimierer und was sie brauchen
DSPy liefert 14 Optimierer, von BootstrapFewShot, das Demonstrationen sammelt, bis GEPA, das Anweisungen aus dem Feedback der Metrik neu schreibt. Alle brauchen eine Metrik. Die FAQ verlangt eine Aufgabe, eine Metrik und einige Beispieleingaben, Labels nur dort, wo die Metrik sie braucht. Die Tabelle vergleicht die vier Optimierer, die ich am genauesten angeschaut habe.
| Optimierer | Ändert | Braucht | Hauptkosten |
|---|---|---|---|
| BootstrapFewShot | Few-Shot-Demonstrationen | Metrik und Trainingsbeispiele | Programmläufe, ein Versuch pro Beispiel |
| MIPROv2 | Anweisungen und Demonstrationen | Metrik und Trainingsset | Versuche mit 35 Beispielen, dazu volle Validierungsläufe |
| GEPA | Anweisungen, neu geschrieben von einem Reflexionsmodell | Metrik mit Feedback und Reflexionsmodell | Budget nach Validierungsgröße und Anzahl der Prädiktoren |
| BootstrapFinetune | Feinabgestimmtes Modell pro Prädiktor | Traces und ein Modell, das du feinabstimmen kannst | Ein Job pro Modell oder pro Prädiktor |
MIPROv2 ist der übliche Einstieg, deshalb lohnt sich ein Blick auf die Rechnung. Die auto-Einstellung legt die Suche fest. Bei einem Programm mit einem Prädiktor und Few-Shot laufen bei light etwa zehn Versuche, validiert wird an höchstens 100 Beispielen. Medium macht 18 Versuche auf 300 Beispielen, heavy 27 auf 1.000. Jeder Versuch bewertet ein Minibatch aus 35 Beispielen, und ein voller Validierungslauf kommt bei jedem sechsten Versuch, beim letzten Versuch und für das unoptimierte Programm.
- light: etwa 750 Läufe, 350 für Versuche und 400 für volle Läufe.
- medium: etwa 2.100 Läufe, 630 für Versuche und 1.500 für volle Läufe.
- heavy: etwa 7.900 Läufe, 945 für Versuche und 7.000 für volle Läufe.
Tokens folgen den Aufrufen. Die FAQ, die als möglicherweise veraltet für DSPy 2.5 und 2.6 markiert ist, nennt etwa sechs Minuten, 3.200 Aufrufe, 2,7 Millionen Eingabe-Tokens und 156.000 Ausgabe-Tokens, für etwa 3 $ zum damaligen OpenAI-Preis. Das sind rund 850 Eingabe- und 50 Ausgabe-Tokens pro Aufruf, also kommen die 750 Aufrufe eines light-Laufs auf etwa 0,6 Millionen Eingabe- und 40.000 Ausgabe-Tokens. Das aktuelle Beispiel auf der Startseite, GEPA mit auto auf medium über 200 Beispiele mit gpt-5.4-mini, wird mit 2,18 $ angegeben.
GEPA geht mit seinem Budget anders um. Seine Metrik liefert eine Punktzahl und Feedback-Text, und ein Reflexionsmodell liest die Beispiele und ihre Punktzahlen und schlägt neu geschriebene Anweisungen vor. Der Leitfaden empfiehlt für die Reflexion ein größeres Modell als das, das du optimierst, und der Konstruktor verlangt eines, außer du übergibst einen eigenen Vorschlagsgeber. Light zielt auf etwa sechs Kandidaten-Prompts, und der Code macht daraus ein Budget an Metrikaufrufen, in dem mehrere volle Validierungsläufe stecken.
Die Veröffentlichungen liefern das stärkste Argument, und jede stützt sich auf die eigenen Aufgaben der Autoren. Das DSPy-Paper berichtet, dass Pipelines den Standard-Few-Shot-Prompt um generell über 25 % bzw. 65 % schlagen, für GPT-3.5 bzw. llama2-13b-chat. Das MIPROv2-Paper berichtet Erfolge bei fünf von sieben mehrstufigen Programmen, mit Gewinnen von bis zu 13 % Genauigkeit. Das GEPA-Paper berichtet im Schnitt 6 % Vorsprung vor GRPO, einer Verstärkungslern-Baseline, mit bis zu 35-mal weniger Rollouts.
Kosten, Betrieb und Daten
| Posten | Preis | Was er abdeckt |
|---|---|---|
| DSPy-Bibliothek | MIT · kostenlos | Mit pip installiert, läuft in deinem Prozess |
| Modellaufrufe zur Laufzeit | Tarif deines Providers | Jeder Aufruf des Programms, nach Tokens abgerechnet |
| Optimierungslauf, Beispiel des Anbieters | 2,18 $ | GEPA, auto medium, 200 Beispiele, gpt-5.4-mini |
| Älterer FAQ-Lauf | etwa 3 $ | 3.200 Aufrufe, 2,7 Mio. Eingabe- und 156.000 Ausgabe-Tokens |
Behandle das kompilierte Programm wie ein Build-Artefakt. Speichere es als JSON, das die Doku als sicherer und lesbarer beschreibt, neben den Signaturen im selben Repository, mit einer Version im Dateinamen und der gepinnten DSPy-Version. Die Datei enthält Signatur, Demonstrationen und das Modell je Prädiktor. Zum Laden musst du zuerst dasselbe Programm im Code aufbauen.
Ein Modellwechsel löst ein Neukompilieren aus, weil der Compiler das Programm auf neue Prompts für das neue Modell abbildet. Behalte die alte Datei, lass die Metrik auf beiden laufen und übernimm die neue nur, wenn sie gewinnt. Pinne auch die Version: Die LM-Seite beschreibt eine auto-Engine, die ein neueres Backend bevorzugt, ein Upgrade kann also das Verhalten ändern.
Der Datenweg ist der, den du konfigurierst, deshalb entsprechen die Fragen nach Auftragsverarbeiter und Region denen jeder Modell-API. Drei Dinge halten zusätzlich Kopien deiner Daten. Der LM-Cache ist standardmäßig an, im Speicher und auf der Festplatte. Ein gespeichertes Programm trägt Demonstrationen aus deinen Trainingsdaten mit sich, die JSON-Datei kann also personenbezogene Daten enthalten. Ein GEPA-Reflexionsmodell liest deine Beispiele und ihre Punktzahlen, es ist also ein zweiter Auftragsverarbeiter. Für EU-Optionen siehe meinen DSGVO-Artikel zur EU-Datenresidenz.
Wo es zu kurz greift
Die meisten Aufgaben brauchen keinen Optimierer. Die FAQ räumt ein, dass bei extrem einfachen Aufgaben ein schlichter Prompt durchaus reichen kann, und du schreibst trotzdem die Tools, Wiederholungen und das Parsing selbst. Wenn du keine Metrik schreiben kannst, die dem entspricht, was ein Nutzer als richtig bezeichnen würde, verbessert der Optimierer genau das, was du gemessen hast, und das ist nicht dasselbe.
Gegenüber handgeschriebenen Prompts gewinnt es am deutlichsten, wenn mehrere Aufrufe voneinander abhängen, sich das Modell oft ändert und sich die Ausgabe bewerten lässt. Gegenüber Feintuning ist es für die meisten Teams die günstigere und leichter rückgängig zu machende Option. BootstrapFinetune kompiliert das Programm zu Feintuning-Jobs, aber dann musst du feinabgestimmte Modelle betreiben und versionieren, eines pro Modell oder pro Prädiktor.
Die Rechnung und die Metrik sind die anderen Schwachstellen. Ein light-Lauf macht Hunderte Aufrufe, heavy-Läufe Tausende, und die Validierungsmenge bestimmt den größten Teil des Preises. Die Herstellerbehauptung, ein kleines, günstiges Modell könne ein handgeprompteltes Spitzenmodell oft erreichen oder übertreffen, ist eine Hypothese, die du an deinen eigenen Daten prüfen musst.
Die API bewegt sich noch. Die Versionshinweise zu 3.4.0 listen eine Breaking Change an rlm(...) und entfernen die alten Exporte dspy.LMRequest und dspy.LMResponse, lies sie also vor jedem Upgrade.
Fazit
Nimm DSPy, wenn eine Pipeline mehrstufig, messbar und im Wandel ist. Für einen einzelnen Prompt auf einem Modell, das du nie wechselst, reichen ein geprüfter Prompt und eine Regressionssuite. Wenn du die Metrik nicht schreiben kannst, kompiliere noch nichts.
- Nimm es, wenn mehrere Modellaufrufe zusammenpassen müssen und ihre Ausgabe automatisch bewertbar ist.
- Nimm es, wenn sich das Modell oder die Daten oft ändern, denn Neukompilieren schlägt das Neuschreiben von Prompts.
- Lass es, wenn die Aufgabe ein einzelner Prompt auf einem stabilen Modell ist.
- Lass es, wenn niemand die Metrik schreibt und pflegt.
Drei Alternativen decken den Rest weitgehend ab. Wenn du Prompts im Code halten und Änderungen durch Evals absichern willst, passt Promptfoo besser. Wenn das Problem expliziter Zustand und Ablaufsteuerung ist, schau dir LangGraph an und kombiniere beides, wenn du beides brauchst. Wenn das Modell ein Format oder einen Stil lernen muss, ist Feintuning der Hebel, wie der Entscheidungsleitfaden erklärt.
Quellen
- DSPy-Startseite und Kostenbeispiel
- DSPy-Installation
- DSPy: Programm statt Prompt
- DSPy-Signaturen
- DSPy-Metriken
- DSPy Example-API
- DSPy Predict-API
- DSPy ChainOfThought-API
- DSPy ReAct-API
- DSPy-Optimierer-Übersicht
- DSPy MIPROv2-API
- MIPROv2-Quellcode
- DSPy BootstrapFewShot-API
- DSPy BootstrapFinetune-API
- DSPy GEPA-Leitfaden
- GEPA-Quellcode
- DSPy: Programme speichern
- DSPy: Cache
- DSPy LM-API
- DSPy-FAQ
- DSPy-GitHub-Repository
- DSPy 3.4.0 Release
- DSPy-Paper, arXiv
- MIPRO-Paper, arXiv
- GEPA-Paper, arXiv
Häufige Fragen
Ist DSPy kostenlos?
Die Bibliothek ist MIT-lizenziert und kostenlos. Du zahlst jeden Modellaufruf, auch die Aufrufe, die der Optimierer bei der Suche macht. Die Beispielläufe der Doku kosteten einige Dollar.
Wie viele Beispiele braucht DSPy?
Ich habe in der Doku kein festes Minimum gefunden. Die FAQ verlangt einige Beispieleingaben, Labels nur, wenn die Metrik sie braucht. MIPROv2 mit light nutzt höchstens 100 Beispiele zur Validierung.
Kann ich DSPy auf ein lokales Modell richten?
dspy.LM nimmt Provider- und Modellnamen im LiteLLM-Format. Ein lokaler Endpunkt kann funktionieren, wenn LiteLLM ihn ansprechen kann. Ich habe für diese Kritik keinen getestet, prüfe das also zuerst in deinem Setup.
Muss ich neu optimieren, wenn ich das Modell wechsle?
Ja. Die FAQ nennt den Wechsel des Ziel-LM als Grund zum Neukompilieren, weil der Compiler das Programm auf neue Prompts abbildet. Behalte die alte kompilierte Datei, um vergleichen und zurückrollen zu können.