Tools/LLMOps & Evals
llama.cpp im Test: die lokale Engine unter Ollama und LM Studio
llama.cpp führt offene Modelle in reinem C und C++ auf Metal, CUDA, Vulkan oder der CPU aus. Ich zeige GGUF-Quants, llama-server und die Grenzen.
- Art
- Local inference runtime
- Preis
- MIT · free
Balázs Csorba··8 Min. Lesezeit
- llama.cpp
- GGUF
- Quantisation
- Local inference
- llama-server
Das Wichtigste in Kürze
- llama.cpp ist die MIT-lizenzierte Engine unter Ollama und LM Studio. Nimm sie direkt, wenn du Modelldatei, Quant und jedes Serverflag selbst bestimmen willst.
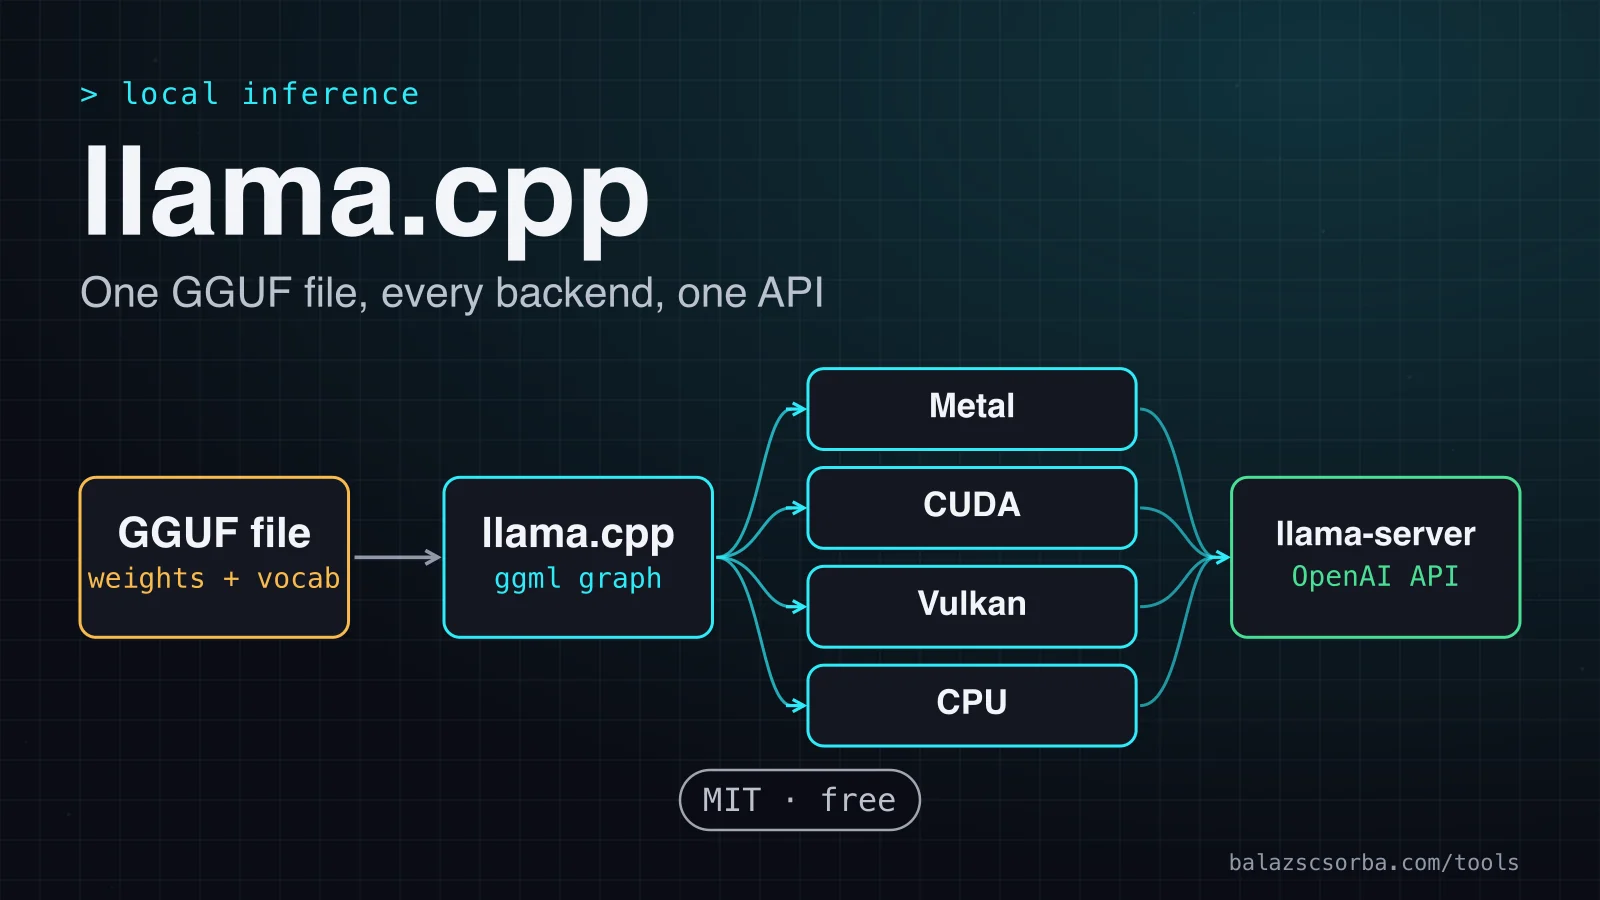
- Eine GGUF-Datei enthält Gewichte, Tokenizer und Metadaten. Das Build-Flag wählt das Backend, sodass dieselbe Datei auf Metal, CUDA, Vulkan oder der CPU läuft.
- Q4_K_M ist ein sinnvoller Startpunkt. Die Quantisierungstabelle misst aber nur Größe und Geschwindigkeit, die Qualitätsprüfung musst du selbst durchführen.
- Die Geschwindigkeit auf Apple-Chips folgt der Speicherbandbreite, aber nicht linear. Ein High-End-Chip erzeugt bei einem 7B-Modell zweistellige Tokens pro Sekunde, eine Rechenzentrums-GPU ist im selben Testtyp grob dreimal so schnell.
- Lokale Inferenz hält Prompts auf deiner Hardware und nimmt damit einen Auftragsverarbeiter aus dem Inferenzschritt, aber die DSGVO-Pflichten für Logs, Zugriff und Aufbewahrung bleiben bestehen.
llama.cpp ist die C- und C++-Engine, die offene Sprachmodelle auf Hardware ausführt, die du kontrollierst. Mehrere komfortablere lokale Werkzeuge setzen darauf auf, darunter Ollama und LM Studio. Das Urteil vorweg: Nimm es direkt, wenn du Modelldatei, Quantisierung und jedes Serverflag selbst festlegen willst, auf einem Laptop oder einem Server, den du betreibst. Lass die Finger davon, wenn du einen einzigen Befehl willst, der Modelle für dich lädt und verwaltet. Ebenso wenig eignet es sich als Serving-Schicht für einen stark genutzten GPU-Dienst mit vielen Nutzern, dafür ist vLLM die bessere Wahl.
Was es ist
Das Projekt nennt als Ziel LLM- und VLM-Inferenz mit minimalem Aufwand und Spitzenleistung auf einer breiten Palette an Hardware. Es ist eine schlanke C- und C++-Implementierung ohne externe Abhängigkeiten und baut auf der Tensor-Bibliothek ggml auf. Der neueste Build auf der Releases-Seite ist b11541, veröffentlicht am 10. Oktober 2026.
- MIT-Lizenz für das ganze Projekt, du kannst es also ohne Lizenzgebühr nutzen und ausliefern.
- Backends für Apple Metal, NVIDIA CUDA, AMD HIP, Vulkan, OpenCL, SYCL und WebGPU, dazu x86- und ARM-CPU-Pfade.
- llama-server, ein OpenAI-kompatibler HTTP-Server mit eingebauter Web-Oberfläche.
- Quantisierung von 1,5 bis 8 Bit, mit GGUF als Modellformat.
- Hugging-Face-Unterstützung über das Flag -hf, dazu Konvertierungsskripte wie convert_hf_to_gguf.py.
So funktioniert es
Die GGUF-Datei erledigt den größten Teil der Arbeit. Die Spezifikation beschreibt GGUF als Dateiformat zum Speichern von Modellen für die Inferenz mit GGML und darauf aufbauenden Ausführungsumgebungen, ausgelegt auf schnelles Laden und Speichern. Jede Datei hat einen Header mit den Zählern für Tensoren und Metadaten, typisierte Schlüssel-Wert-Metadaten, eine Beschreibung jedes Tensors (Name, Form, Typ und Offset) und die Tensordaten, aufgefüllt auf eine Ausrichtungsgrenze. Die Spezifikation nennt Speicher-Mapping als Ziel, sodass das Betriebssystem die Gewichte einblenden statt kopieren kann. Auch der Tokenizer steckt in der Datei, unter den Schlüsseln tokenizer.ggml. Die Spezifikation warnt, dass das eingebettete Vokabular ungenauer sein kann als der Original-Tokenizer. Prüfe deshalb nach jeder Konvertierung die Ausgabequalität.
Erste Schritte
Die Build-Dokumentation aktiviert Metal auf macOS standardmäßig, ein schlichter Build auf dem Mac enthält das Apple-Backend also schon. Die übrigen Backends brauchen beim Konfigurieren ein Flag, wie die Tabelle zeigt.
| Backend | Hardware | Aktivierung |
|---|---|---|
| Metal | Apple Silicon | Standardmäßig auf macOS aktiv |
| CUDA | NVIDIA-GPUs | -DGGML_CUDA=ON |
| Vulkan | GPUs mit Vulkan-Treiber | -DGGML_VULKAN=ON |
| CPU | x86 (AVX2, AVX512, AMX) und ARM (NEON) | Im Standard-Build enthalten |
# macOS includes Metal by default; for NVIDIA GPUs use cmake -B build -DGGML_CUDA=ON
cmake -B build
cmake --build build --config Release
./build/bin/llama-server -m models/Llama-3.1-8B-Instruct-Q4_K_M.gguf -c 8192 -np 4 --host 127.0.0.1 --port 8080
Drei Flags entscheiden das meiste. -m nennt die GGUF-Datei, -c legt die Kontextgröße in Tokens fest (0 bedeutet den Wert aus dem Modell) und -np die Zahl paralleler Slots. Der Server lauscht standardmäßig auf 127.0.0.1, andere Rechner erreichen ihn also erst, wenn du --host änderst.
Quantisierung und Geschwindigkeit
Ein Quant ist die Zahl der Bits pro Gewicht, abgewogen gegen Dateigröße und Qualität. Die _K-Namen kennzeichnen k-Quants, die IQ-Typen sind i-Quants, die bis etwa 2 Bit pro Gewicht reichen; IQ1_S steht in der Tabelle der README bei 2,00 Bit. Das Beispielkommando der README ist eine naive Q4_K_M-Quantisierung mit Standardeinstellungen, deshalb ist Q4_K_M der vernünftige Startpunkt.
| Quant | Bit pro Gewicht | Größe (GiB) | Generierung (Tokens/s) |
|---|---|---|---|
| Q2_K | 3,16 | 2,95 | 79,85 |
| Q4_K_M | 4,89 | 4,58 | 71,93 |
| Q5_K_M | 5,70 | 5,33 | 67,23 |
| Q6_K | 6,56 | 6,14 | 58,67 |
| Q8_0 | 8,50 | 7,95 | 50,93 |
| F16 | 16,00 | 14,96 | 29,17 |
Lies die Tabelle als Abwägung. Die Größe sinkt mit der Bitzahl, und die Generierung wird schneller, wenn die Datei kleiner wird, weil jedes Token die Gewichte erneut lesen muss. F16 erzeugt 29,17 Tokens pro Sekunde gegenüber 71,93 bei Q4_K_M und braucht mehr als das Dreifache an Speicher. Die README misst Llama 3.1 8B, sagt aber nicht, welche Maschine die Zahlen erzeugt hat, lies sie also als relative Werte. Die Tabelle hat keine Qualitätsspalte, denn die README nennt weder Perplexität noch KL-Divergenz. Ich würde vor der Wahl denselben Evaluationssatz für jeden Kandidaten laufen lassen, wie ich in meinem Beitrag zu Evals für LLM-Produktfunktionen beschreibe.
Auf Apple-Chips folgt die Geschwindigkeit der Speicherbandbreite. Im Apple-Silicon-Thread erzeugt LLaMA 7B mit Q4_0 auf dem M4 Max 83,06 Tokens pro Sekunde bei 546 GB/s Speicherbandbreite, auf dem M1 Pro 36,41 bei 200 GB/s. Der M2 Ultra erreicht 94,27 bei 800 GB/s. Der Zusammenhang ist nicht linear: Der M1 Pro hat ein Viertel der Bandbreite des M2 Ultra und erreicht weniger als die Hälfte von dessen Tempo.
Der CUDA-Thread sammelt llama-bench-Ergebnisse für Llama 2 7B mit Q4_0: 186,21 Tokens pro Sekunde für eine RTX 4090, 267,81 für eine H100 mit 80 GB und 290,02 für eine RTX 5090. Für die Planung heißt das: Ein Nutzer auf einem High-End-Apple-Chip bekommt bei einem 7B-Modell zweistellige Tokens pro Sekunde, und eine Rechenzentrums-GPU ist im selben Testtyp grob dreimal so schnell. Modelle und Builds unterscheiden sich zwischen den Threads, vergleiche also Größenordnungen. Keiner der beiden Threads testet einen Server unter gleichzeitiger Last, und genau dort zahlt sich eine GPU-Maschine aus.
llama-server: API, Slots und strukturierte Ausgabe
llama-server ist die Stelle, an der die meisten Anwendungen auf llama.cpp treffen. Seine OpenAI-kompatiblen Routen liegen unter /v1: Chat-Completions, Completions, Responses, Modelle und Embeddings. Native Routen decken Tokenisierung, Template-Rendering, den Slot-Zustand und den Health-Check ab. Ein Prometheus-Metrik-Endpunkt existiert, bleibt aber aus, bis du --metrics setzt, was du wissen solltest, bevor du einen Port veröffentlichst.
Parallele Slots funktionieren so: Steht -np auf dem Standardwert auto, teilen sich die Slots einen KV-Cache-Puffer, den die README in diesem Modus standardmäßig einschaltet. Eine lange Anfrage kann so Speicher nutzen, den ein untätiger Slot sonst belegen würde. Kontinuierliches Batching ist ebenfalls standardmäßig aktiv. Die README dokumentiert den Schalter (--kv-unified) und ein Limit pro Slot (--kv-unified-per-slot), erklärt aber nicht genau, wie sich das Budget aufteilt, wenn du die Slot-Zahl von Hand setzt. Miss deshalb den Speicher, bevor du einen Server für mehrere Nutzer dimensionierst.
Strukturierte Ausgabe läuft über zwei Wege. --json-schema begrenzt die Generierung auf ein JSON-Schema, --grammar nimmt eine BNF-ähnliche Grammatik; die README beschreibt beides als Wege, Generierungen einzuschränken. Der Chat-Endpunkt akzeptiert außerdem ein response_format vom Typ json_schema, wie in dieser Anfrage.
curl -s http://127.0.0.1:8080/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{"messages": [{"role": "user", "content": "Extract the author from: Written by Balázs Csorba."}], "response_format": {"type": "json_schema", "schema": {"type": "object", "properties": {"author": {"type": "string"}}, "required": ["author"]}}}'
Kosten und Betrieb
| Kostenposten | Was du zahlst | Hinweis |
|---|---|---|
| llama.cpp | Nichts | MIT-Lizenz, keine Nutzungsgebühr |
| Eigene Hardware | Anschaffung und Strom | Der Speicher bestimmt das größte Modell und Quant, das du laden kannst |
| Gemieteter GPU-Server | Preis des Anbieters | EU-Region wählen und einen Auftragsverarbeitungsvertrag abschließen |
| Modellgewichte | Die eigenen Bedingungen des Modells | Die Modellkarte nennt die Lizenz |
Datenschutz ist das stärkste Argument für lokale Inferenz. Läuft das Modell auf eigener Hardware, bleiben Prompts, abgerufene Dokumente und Antworten auf dieser Maschine, und kein Modellanbieter erhält sie. Der Inferenzschritt hat dann keinen Auftragsverarbeiter. Artikel 28 DSGVO verlangt, dass die Verarbeitung durch einen Auftragsverarbeiter durch einen verbindlichen Vertrag geregelt wird, der ihn an dokumentierte Weisungen bindet. Ein gemieteter GPU-Host, der personenbezogene Daten für dich verarbeitet, ist ein Auftragsverarbeiter, egal wo er in der EU steht, und braucht diesen Vertrag.
Lokal heißt nicht automatisch konform. Artikel 32 verlangt von Verantwortlichen und Auftragsverarbeitern angemessene technische und organisatorische Maßnahmen und nennt Verschlüsselung und Pseudonymisierung als Beispiele. Auf einem llama.cpp-Server zählen vor allem diese Einstellungen: die Bindungsadresse (127.0.0.1, außer du änderst --host), der API-Schlüssel (--api-key akzeptiert einen oder mehrere Schlüssel), der Metrik-Endpunkt (aus, außer du setzt --metrics) und deine eigenen Logs, für die dieselben Aufbewahrungsregeln gelten wie für jeden Prompt-Speicher. Die Notizen zu DSGVO und Datenresidenz bei LLM-APIs decken den Rest der Checkliste ab.
Wo es an Grenzen stößt
- Es ist eine Laufzeit, keine Plattform. Du wählst Datei, Quant, Kontextgröße und Flags und aktualisierst das Binary selbst. Das Tempo gehört dazu: Die Releases-Seite zeigte allein am 9. und 10. Oktober 2026 vier Builds.
- Keine Modellverwaltung. Die GGUF-Datei lädst du selbst herunter. Das Flag -hf holt ein Hugging-Face-Repository und nimmt standardmäßig Q4_K_M oder die erste Datei des Repos, wenn dieser Quant fehlt.
- Keine Qualitätsmessung. Die Quantisierungstabelle zeigt nur Größe und Geschwindigkeit, die Qualitätsprüfung bleibt also bei dir.
- Parallelität ist eine Speicherfrage. Slots und kontinuierliches Batching gibt es, aber die Benchmark-Threads testen keinen Server unter gleichzeitiger Last, und die README erklärt die Speicheraufteilung bei handgesetzter Slot-Zahl nicht genau.
- GGUF in vLLM ist kein Abkürzungsweg für den Betrieb. vLLM nennt seine GGUF-Unterstützung stark experimentell und nicht ausreichend optimiert und sagt, GGUF sei derzeit vor allem ein Weg, den Speicherbedarf zu senken.
Fazit
Nimm llama.cpp, wenn du die Engine selbst willst, mit Datei, Quant und Flags unter deiner Kontrolle, und wenn die Daten die Maschine nie verlassen sollen. Es ist eine gute Basis für eigene Werkzeuge und einen kleinen privaten Server. Wer nur einen Befehl zum Laden eines Modells sucht, fängt besser woanders an, und als Serving-Schicht für einen stark genutzten GPU-Dienst taugt es nicht. Wenn du zwischen lokalen Optionen wählst: LM Studio führt llama.cpp auf Mac, Windows und Linux aus und nutzt auf Apple Silicon MLX. Es passt also zu Leuten, die eine App mit Oberfläche wollen.
- Nimm es, wenn du Datei, Quant und jedes Flag auf deiner eigenen Hardware bestimmen willst.
- Nimm es, wenn du einen Server willst, den du Zeile für Zeile nachvollziehen kannst, mit jeder Einstellung im eigenen Befehl sichtbar.
- Nimm es nicht, wenn du einen Befehl willst, der Modelle lädt und verwaltet. Dann nimm Ollama, das llama.cpp unter seinen unterstützten Backends aufführt.
- Nimm es nicht für einen gemeinsamen GPU-Dienst mit vielen Nutzern gleichzeitig. Teste zuerst vLLM, denn sein Kern sind PagedAttention und kontinuierliches Batching.
Quellen
- llama.cpp-Repository: Ziele, Backends, Lizenz
- llama.cpp-Releases: Builds b11538 bis b11541
- llama.cpp-Build-Dokumentation: CMake-Flags
- llama.cpp-Server-README: Endpunkte, Slots und Grammatiken
- llama.cpp-Quantisierungs-README: Bits, Größe und Geschwindigkeit
- GGUF-Spezifikation im ggml-Repository
- Leistung von llama.cpp auf Apple Silicon (M-Serie)
- Leistung von llama.cpp auf Nvidia CUDA
- Ollama-README: unterstützte Backends und REST-API
- LM-Studio-Dokumentation: Übersicht der App
- vLLM-README: Funktionen, Hardware und Lizenz
- vLLM-Dokumentation: GGUF-Unterstützung
- DSGVO Artikel 28: Auftragsverarbeiter
- DSGVO Artikel 32: Sicherheit der Verarbeitung
Häufige Fragen
Ist llama.cpp kommerziell kostenlos nutzbar?
Das Projekt steht unter der MIT-Lizenz, du kannst es also ohne Lizenzgebühr nutzen und ausliefern. Die Modellgewichte behalten ihre eigenen Lizenzen, die kommerzielle Nutzung einschränken können. Prüfe deshalb jede Modellkarte, bevor du ein Produkt darauf aufbaust.
Was ist der Unterschied zwischen llama.cpp und Ollama?
Ollama führt llama.cpp unter seinen unterstützten Backends auf und bringt eine REST-API zum Ausführen und Verwalten von Modellen mit. llama.cpp ist die Engine selbst: Du wählst die GGUF-Datei, den Quant und jedes Flag und aktualisierst das Binary selbst.
Mit welchem GGUF-Quant sollte ich anfangen?
Mit Q4_K_M. Die Quantisierungs-README verwendet eine naive Q4_K_M-Quantisierung als Beispiel. Steige auf Q5_K_M oder Q6_K um, wenn deine eigenen Evals eine Qualitätslücke zeigen, denn die Geschwindigkeitstabelle sagt nichts über die Qualität.
Hilft ein lokaler llama.cpp-Server bei der DSGVO?
Es hilft, weil kein Modellanbieter die Prompts erhält und dieser Auftragsverarbeiter aus der Kette fällt. Zugriffskontrolle, Aufbewahrung der Logs und eine Rechtsgrundlage gelten weiter. Ein gemieteter GPU-Host, der personenbezogene Daten für dich verarbeitet, ist ein Auftragsverarbeiter und braucht einen Vertrag nach Artikel 28.